88%企业试用AI Agent,不到10%完成规模化部署——工程化落地难在哪
88%在用,不到10%完成规模化部署——AI Agent落地差在哪里
据MarketsandMarkets预测,全球AI Agent市场规模将从2025年的78.4亿美元增长到2030年的526.2亿美元,年复合增长率高达46.3%。但另一边,麦肯锡2025年底的调研却揭示了一个刺眼的事实:88%的组织已在尝试AI Agent,但能在任一业务模块实现规模化部署的不足10%。
市场在狂奔,落地却卡壳。问题出在哪?答案往往不在算法或模型层面,而在工程化能力。
很多团队用Python快速跑通一个Demo,对话流畅、功能完整,但一旦接入真实流量,系统就频繁崩溃、响应延迟飙升、成本失控。这是因为“能跑”和“能扛”之间,隔着一整套生产级工程体系:高并发承载、多Agent调度、长对话状态管理、线上问题排查、安全与成本控制……这些在原型阶段几乎不会暴露的问题,到了生产环境才集中爆发。
Python跑通Demo,上生产就崩——为什么转向Go?
Python在AI原型开发中确实高效:丰富的库、灵活的语法、快速验证想法。但它的短板在规模化场景下非常明显:
- GIL限制并发:即使多线程,CPU密集型任务也无法真正并行;
- 动态类型隐患:代码规模扩大后,类型错误难以追踪,维护成本陡增;
- 依赖链复杂:虚拟环境、C扩展、版本冲突等问题让部署变得脆弱。
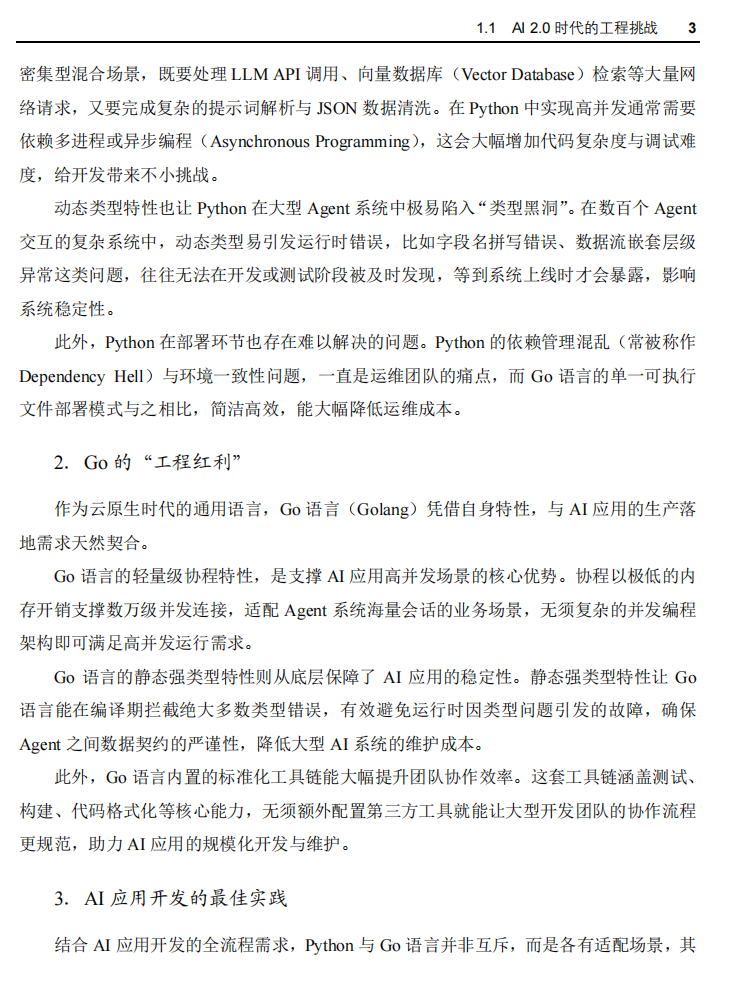
相比之下,Go语言在高并发服务场景中优势突出。有实测数据显示,在同等算力下,Go实现的Agent服务内存和CPU占用稳定在Python方案的50%左右。当并发量达到200时,Python服务已出现明显卡顿,而Go仍保持流畅响应。
更重要的是,Go的静态类型、编译型特性、轻量级协程(goroutine)和简洁的部署方式(单二进制文件),天然适合构建稳定、可维护的生产系统。
工程化不是调参,而是搭建完整链路
真正的工程化落地,需要一套贯穿始终的技术栈。以CloudWeGo生态为例:
Hertz:高性能HTTP框架,处理外部请求入口;
Eino:专为Agent设计的开发框架,支持行为编排、工具调用、状态管理;
Thrift IDL:定义服务接口,驱动前后端协作;
K8s + Docker:标准化部署与扩缩容。
这套组合不是为了炫技,而是解决实际问题。比如,Hertz网关层要处理JWT鉴权、SSE(Server-Sent Events)流式协议、连接池调优;Eino层则负责Agent逻辑编排、上下文传递、工具抽象。
Agent行为不可控?用图编排代替“拼提示词”
很多团队写Agent的方式是“拼提示词+调API”,结果导致行为完全不可预测。今天能正常问答,明天换个输入就乱跑。这种做法缺乏结构化控制。
更可靠的做法是引入行为编排模式:
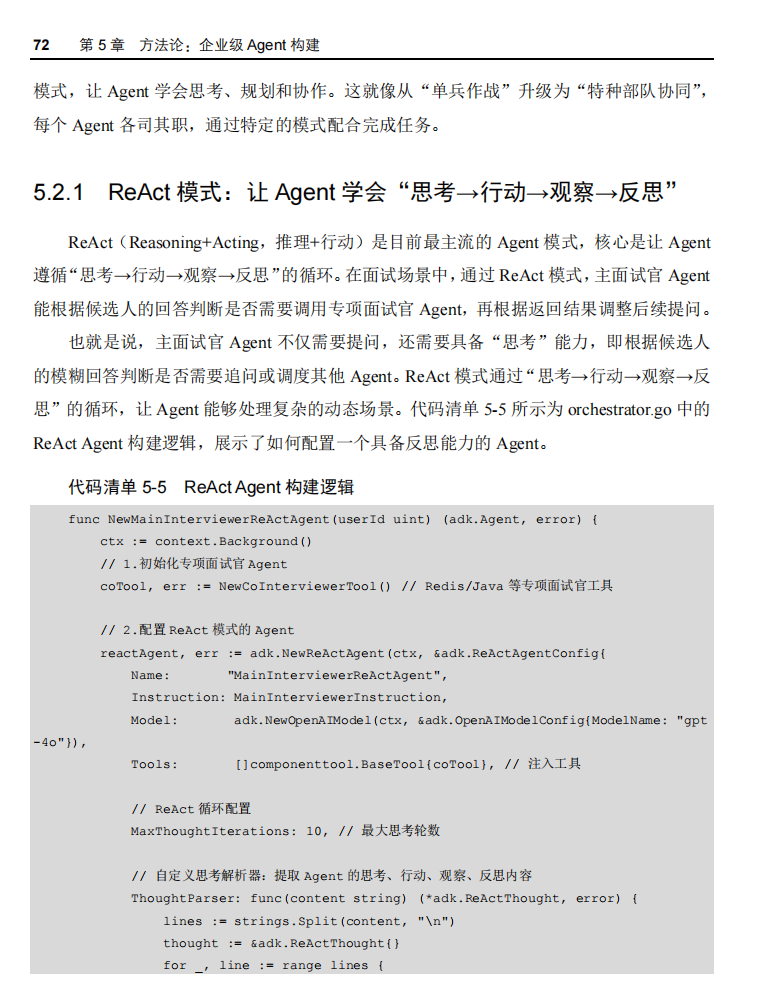
ReAct模式:让Agent按“思考→行动→观察→反思”循环决策,每一步都可记录、可干预;
路由模式:识别用户意图,动态分发到不同处理模块;
计划与执行模式:对复杂任务先拆解子目标,再逐个执行。
这些模式通过Eino的图编排能力落地——不是画流程图,而是写可执行的代码节点。例如,一个简历解析Agent可能只用ReAct;而一个面试系统则需要路由识别岗位类型,再调用对应的技术面或项目面Agent。
多Agent协同:避免“群面变吵架”
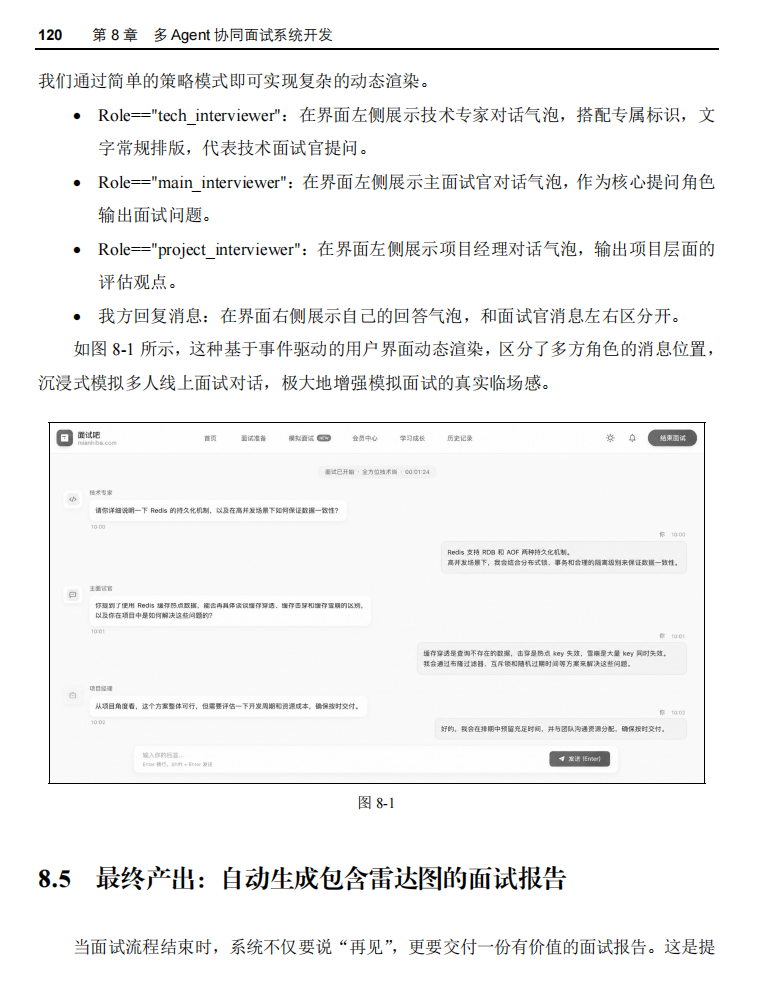
当多个Agent同时在线,最大的问题是话语权冲突。比如模拟一场三人面试:主面试官、技术面试官、项目面试官。候选人回答完一个问题,谁该接话?如果没有调度机制,可能出现两种极端:要么多个Agent同时抢答,输出混乱;要么互相等待,陷入沉默。
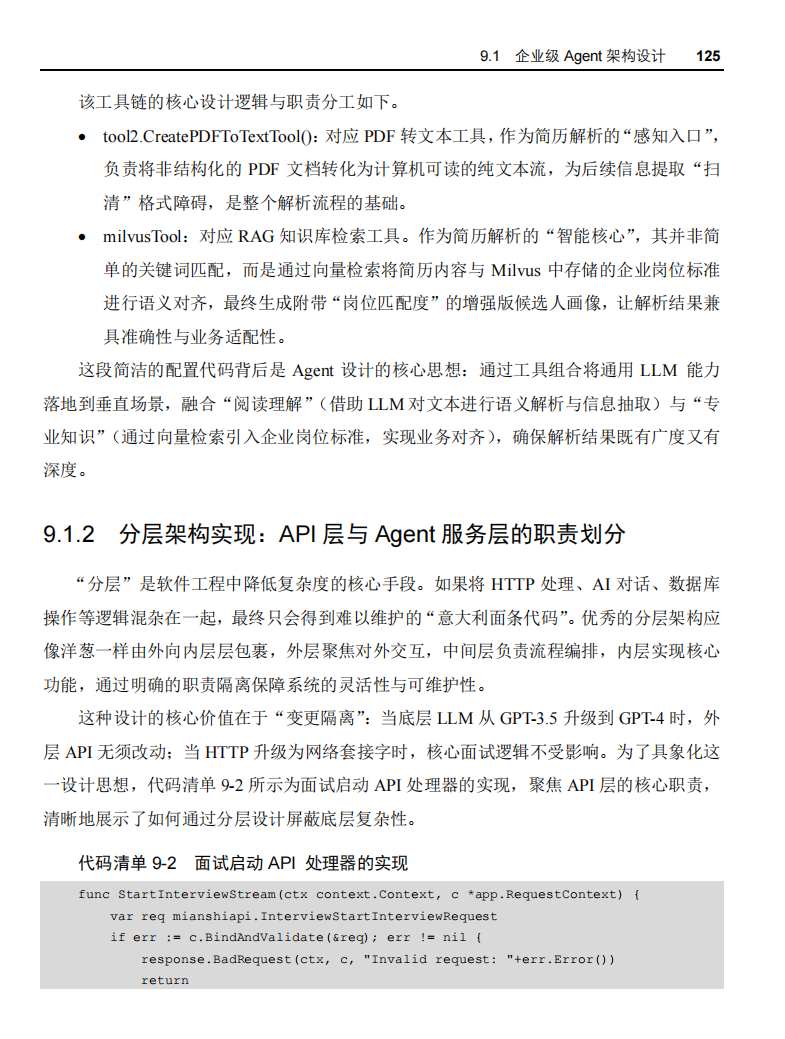
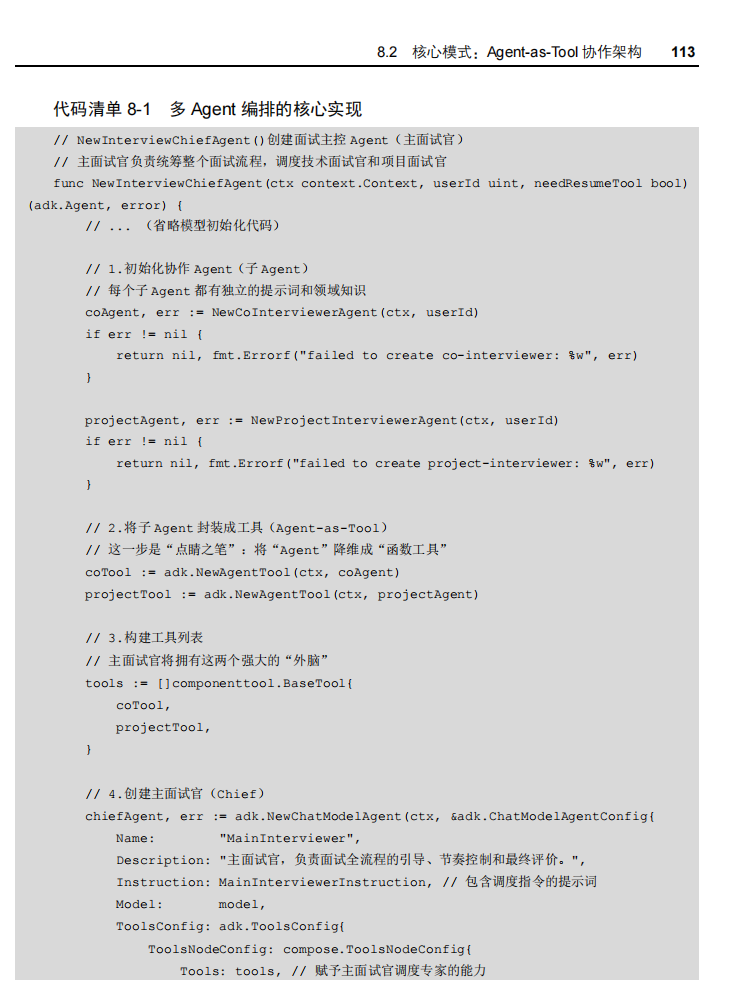
书中提出的解决方案是Agent-as-Tool模式:
将技术面试官、项目面试官封装为标准函数工具;
主面试官作为唯一决策中枢,按需调用其他角色;
调用时自动传递上下文,确保信息一致;
通过Redis Stream实现同步对话与异步任务解耦;
使用SSE协议将多角色消息流式推送给前端,实时渲染。
这样,整个系统既有分工,又有统一指挥,避免了无序竞争。
高并发优化:不止是“加机器”
并发上来就卡,往往是因为忽略了细节优化。书中将高并发拆解为两个层面:
Hertz网关层优化:
调整KeepAlive和IdleTimeout,复用TCP连接;
配置Netpoll网络模型,减少系统调用开销;
设置分布式限流,防止单点过载拖垮整个集群。
Eino Agent层优化:
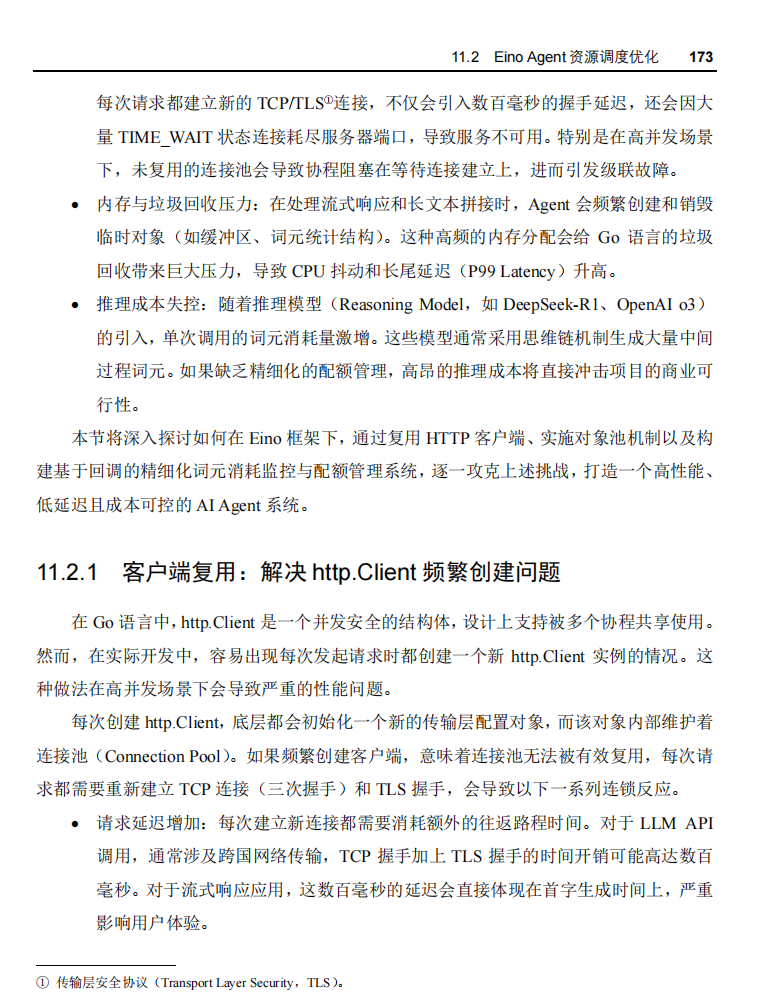
复用http.Client,避免频繁创建连接;
使用sync.Pool缓存临时对象,减少GC压力;
监控词元(token)消耗,设置配额防止推理成本失控。
每一项优化都来自真实生产事故的复盘,不是理论调参。
Agent不能是黑盒:构建可观测性
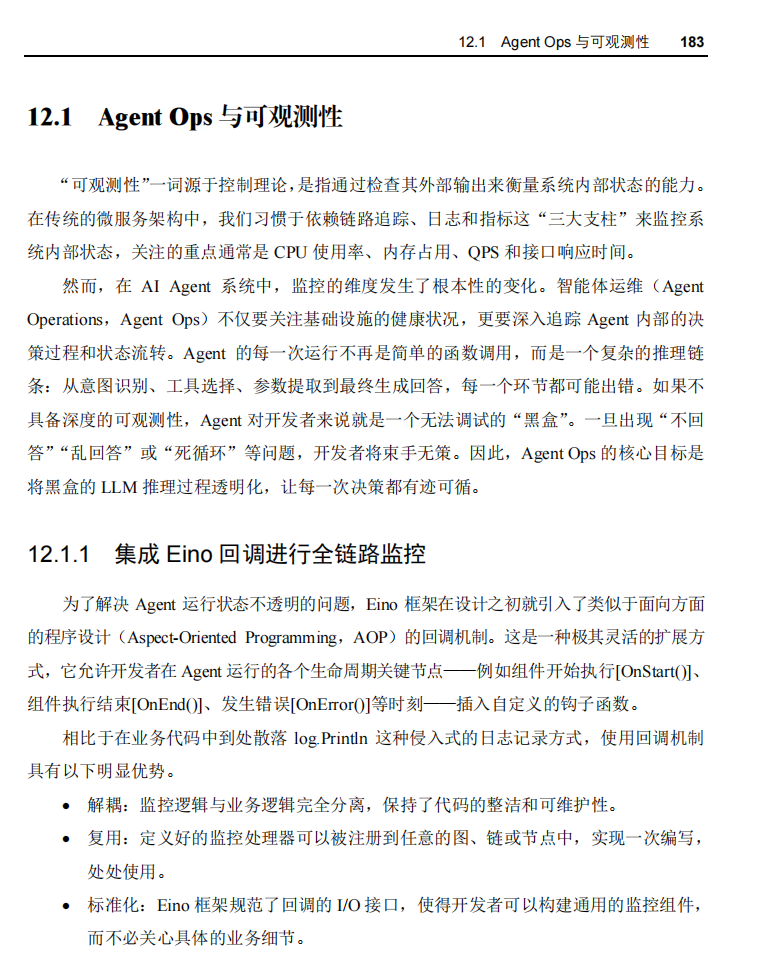
AI系统最怕“跑起来但看不懂”。第12章专门讲Agent Ops(智能体运维):
通过Eino回调机制,记录Agent每一步的决策路径;
可视化回溯对话历史,定位逻辑偏差;
统计关键节点耗时、模型调用次数、词元消耗;
集成Lark/飞书告警,但加入降噪策略,避免半夜被无效通知吵醒;
提供单元测试框架和自动化评估脚本,确保迭代不退化;
安全层面实现敏感数据脱敏和内容安全围栏,防止越界输出。
这些能力让Agent从“神秘黑盒”变成“透明服务”,运维和产品团队都能参与优化。
从Demo到生产:一条清晰的迁移路径
对于不同背景的开发者,落地路径也不同:
Go开发者想切入AI:可从环境搭建、RAG知识库接入、工具抽象开始,建立Agent开发基础;
已有Python原型:重点参考分层架构设计、Hertz网关集成、SSE流式对话实现,完成语言迁移;
正在搭建多Agent系统:直接借鉴Agent-as-Tool模式和Redis Stream异步架构;
负责线上运维:关注高并发优化、监控告警、K8s部署清单等章节。
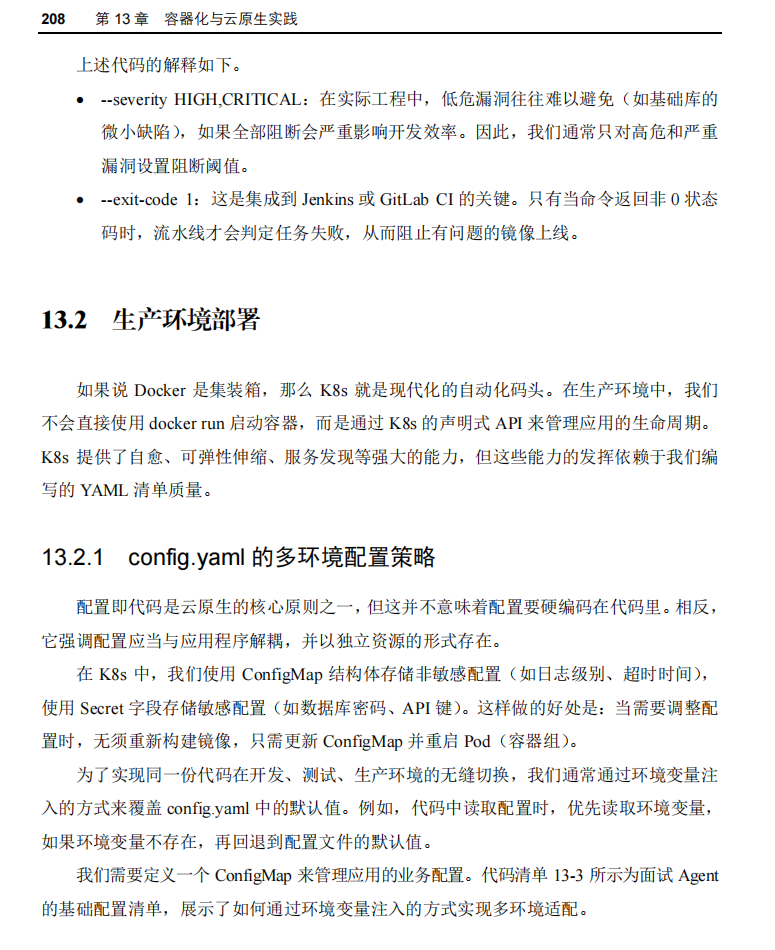
最终,第13章用多阶段Dockerfile和完整的K8s YAML收尾,配套源码已在GitHub开源,真正实现“开箱即用”。
落地成败,不在模型,在工程
Gartner预测,到2027年,超过40%的agentic AI项目将因无法交付业务价值而失败。失败的原因很少是模型不够强,更多是工程能力跟不上。
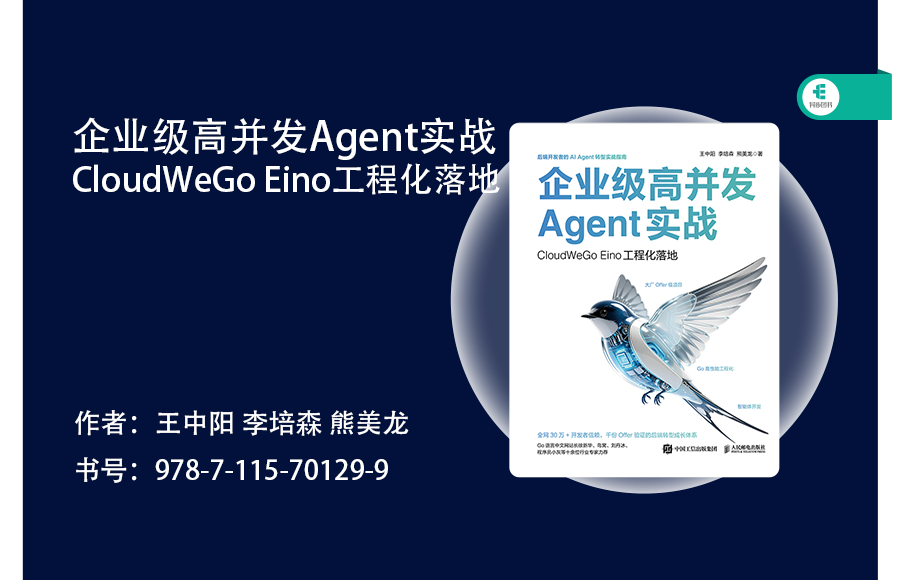
AI Agent的真正挑战,是如何把一个“能对话”的Demo,变成一个“能扛流量、能协同、能运维、能控成本”的生产系统。这条路没有捷径,但有清晰的工程方法论可循——用合适的语言(如Go),沿着成熟的生态(如CloudWeGo),一步步补全从原型到生产的每一环。
只有这样,那88%的尝试者,才有可能成为那10%的成功者。