Meta新方法:用字节级蒸馏训练小模型,能力上限反超Token方案
字节也能当老师?Meta的新蒸馏思路
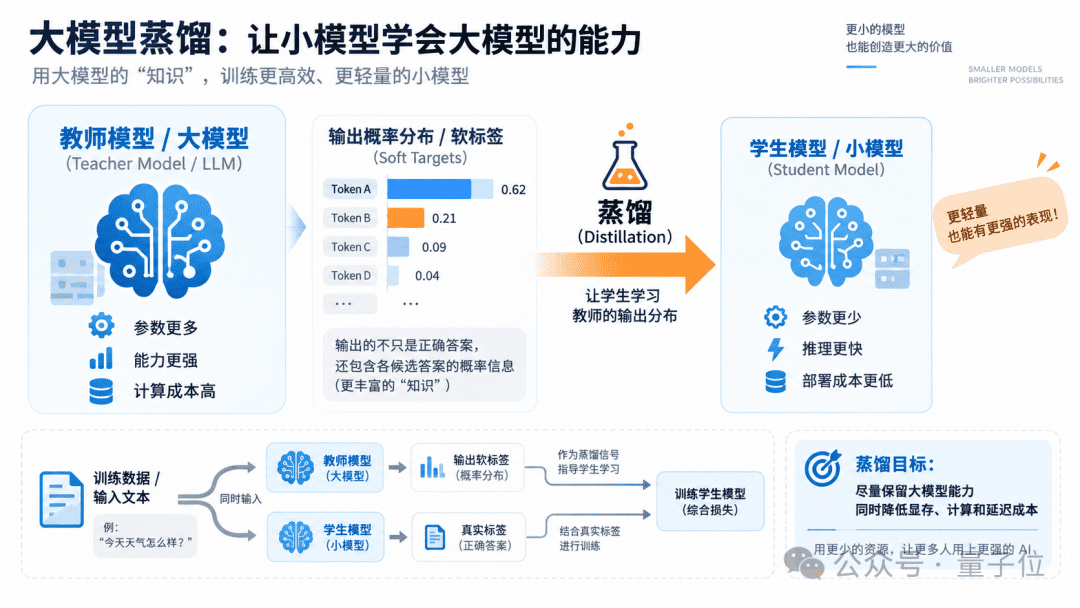
大模型越来越强,但部署成本也水涨船高。于是,模型蒸馏成了热门解法——让大模型当“老师”,把知识传给更小的“学生”。
传统做法里,学生学的是老师对每个Token(词元)的概率判断。可问题来了:主流模型的词表动辄十几万个Token,保存完整概率分布太占地方,实际操作往往只能截取top-k,丢掉大量信息。
最近,Meta FAIR和华盛顿大学的研究者换了个思路:干脆让学生直接学字节(byte)级别的预测。他们的论文《突破Token天花板:蒸馏出更小、更强的字节模型》发现,这么一改,小模型的能力上限反而更高了。
为什么是字节?
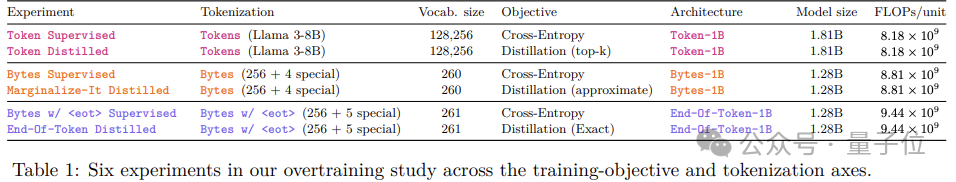
字节只有256种可能取值(0–255),加上少量特殊符号也不过两三百个。相比Llama 3-8B那128256个Token的词表,预测空间小了两个数量级。
这意味着什么?
- 存储压力骤降:完整保存每个位置的概率分布变得可行,不用再做top-k截断。
- 分词器无关:字节是底层表示,不依赖特定tokenizer,模型学到的知识更通用。
- 基础单位更细:虽然单步预测更简单,但累积起来反而能捕捉更细微的模式。
不过,老师输出的是Token概率,学生要学的是字节概率,两者怎么对齐?这正是论文的核心挑战。
把Token概率“拆”成字节
研究团队提出了两种转换方法:Marginalize-It 和 End-Of-Token。
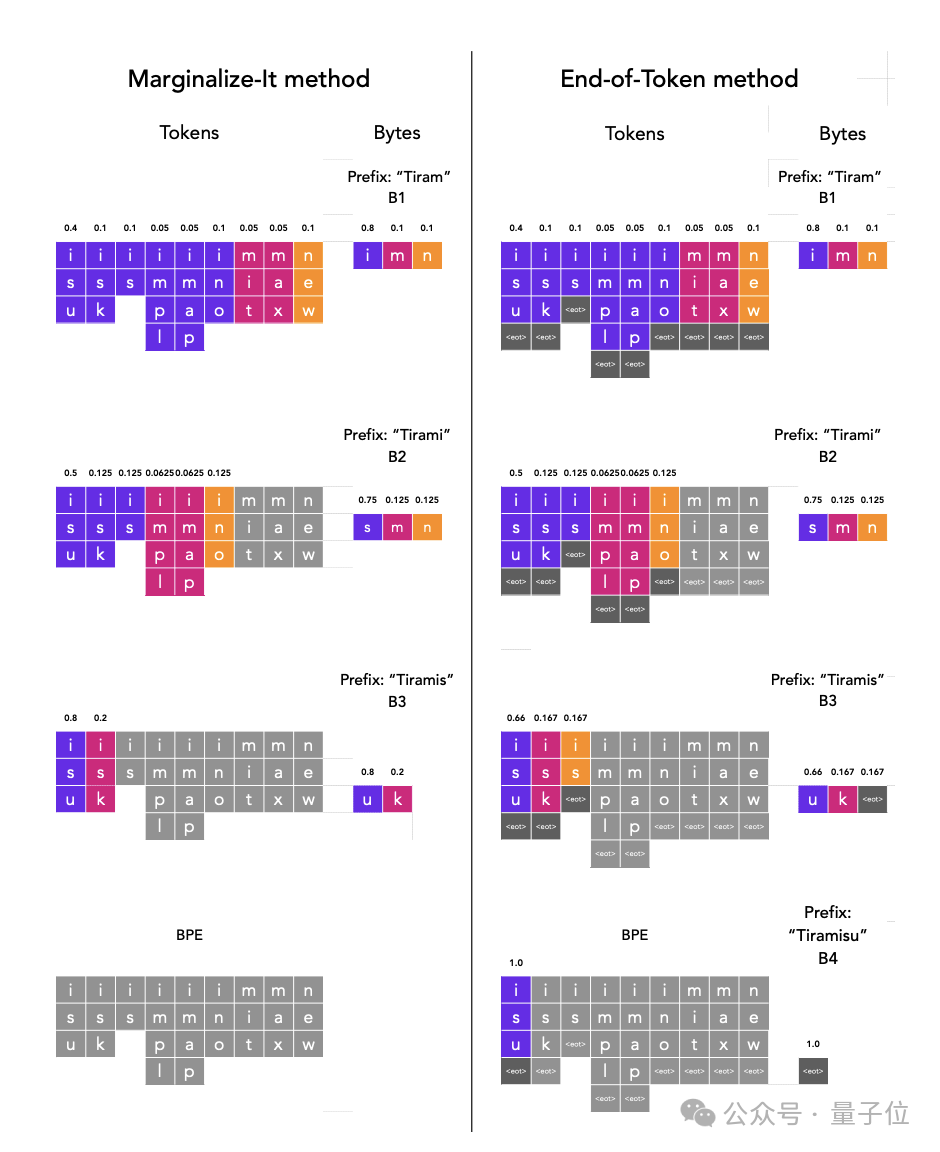
先说共同点:它们都沿着真实文本的字节序列,逐步把老师对不同Token的概率分解到对应字节位置上。
举个例子。假设老师预测下一个Token可能是 “isu”、“isk” 或 “is”。这三个都以字节 ‘i’ 开头,那么第一个字节的预测目标就是这三个Token概率之和。等前缀确定为 ‘i’ 后,再只考虑剩下候选的第二个字节,依此类推。
Marginalize-It:简单粗暴的近似
这种方法的问题出现在Token长度不一致时。比如走到前缀 “is”,“isu” 和 “isk” 还有后续字节,但 “is” 已经结束了。这时如果还想预测 “is” 之后的内容,就得查老师在该Token结束后的下一个预测——而不同路径的后续分布可能完全不同,计算量爆炸。
Marginalize-It 的解法很直接:一旦Token结束,就不再往后追,只把剩余未结束候选的概率重新归一化。这样只需一次老师前向计算,效率高,但代价是丢掉了已结束Token的后续信息,属于一种近似。
End-Of-Token:给“结束”一个名分
第二种方法更巧妙:在每个Token末尾显式加入一个结束标记(比如 ⟨/tok⟩)。于是原来的三个候选变成 “isu⟨/tok⟩”、“isk⟨/tok⟩” 和 “is⟨/tok⟩”。
这样一来,当学生走到 “is” 时,下一步既可以预测 ‘u’、‘k’,也可以预测 ⟨/tok⟩ 表示当前Token结束。那些因长度不同而“悬空”的概率,现在有了明确归属。
关键优势在于:它能在保留Token边界的同时,更完整地传递老师的概率分布,而且同样只需一次老师前向计算。
实验:字节模型后劲更足
团队用Llama 3-8B当老师,训练了三类学生模型:
- Token模型(词表128K)
- 普通字节模型
- 带结束标记的字节模型(End-Of-Token)
每类又分监督训练和蒸馏训练,共六组。学生Transformer主体参数均为12.8亿,总参数因词表大小略有差异。
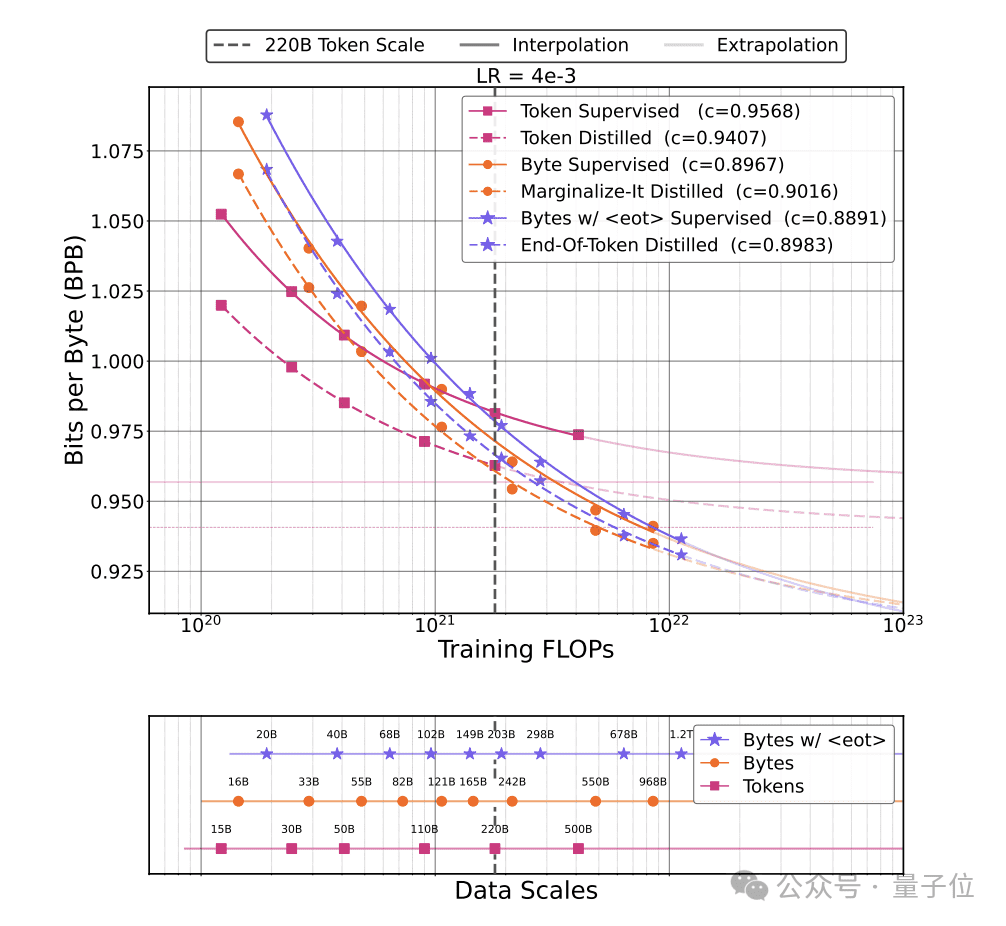
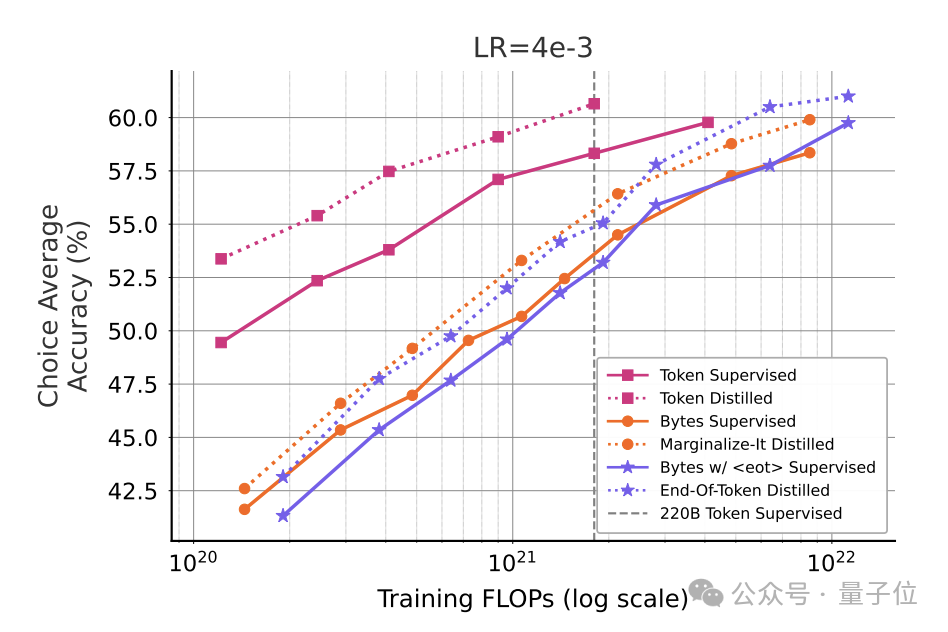
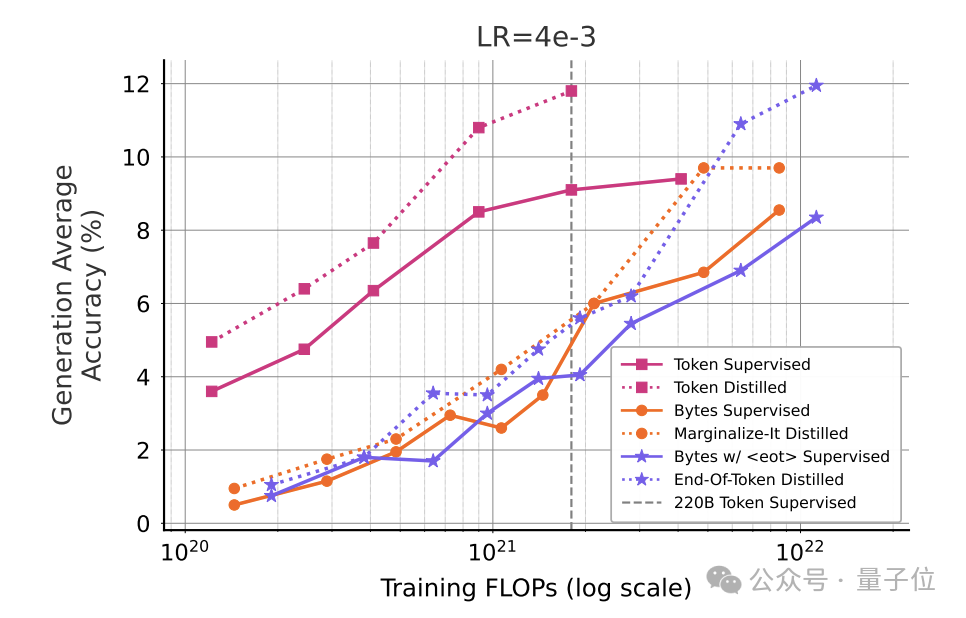
训练数据规模逐步扩大,最终字节模型覆盖约1万亿字节。评测在八项任务上进行,涵盖选择题问答、语言生成和机器翻译。
训练动态:前期慢,后期猛
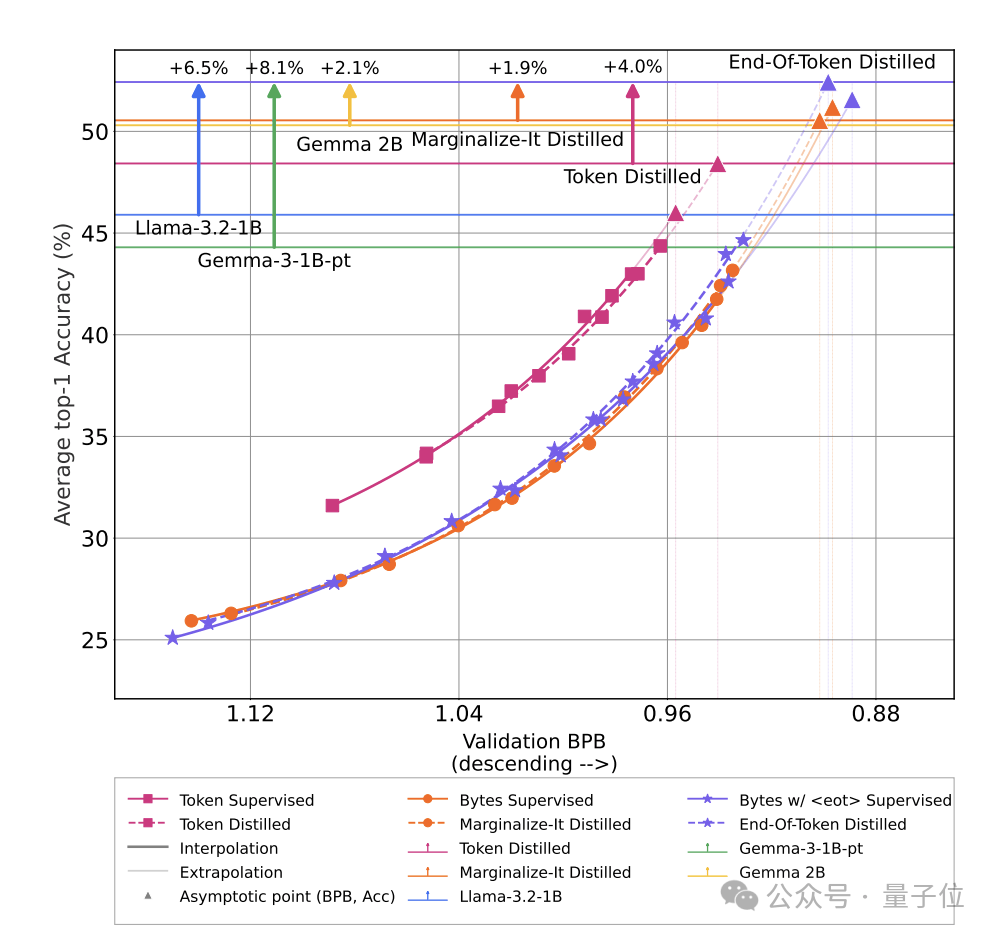
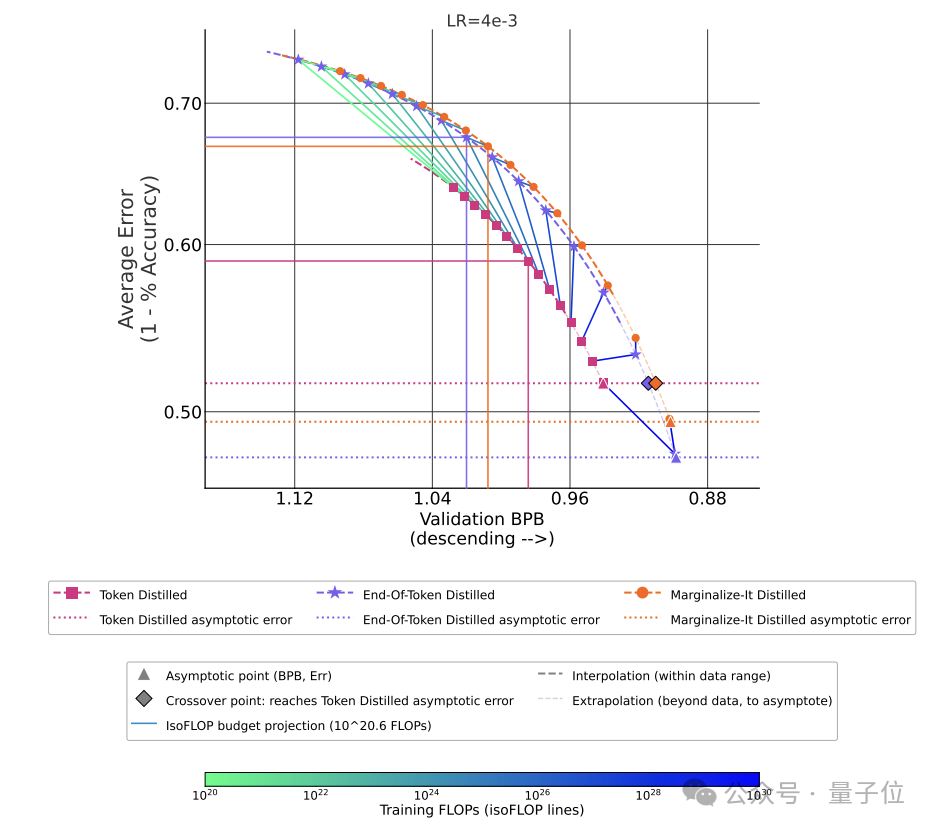
Token模型起步快,但很快撞上平台期;字节模型初期学习慢,却随计算量增加持续进步。这说明字节模型的scaling潜力更大。
有趣的是,如果只看BPB(每字节预测损失),字节模型很早就优于Token模型。但下游任务成绩却仍落后——因为BPB衡量的是文本预测准不准,而任务成绩看的是最终答案对不对,两者并不完全等价。
能力上限:End-Of-Token领先4个百分点
团队拟合了“训练计算量 → BPB → 下游准确率”的关系,外推各方案的能力上限:
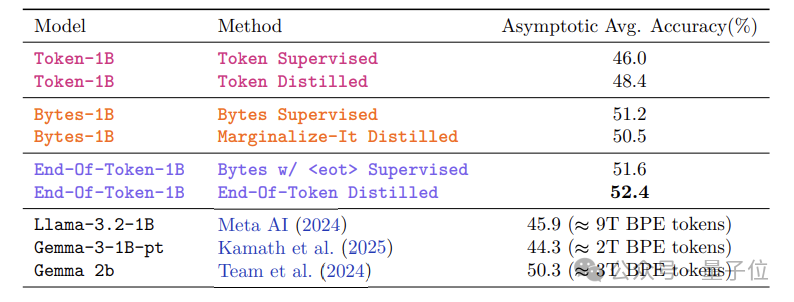
- Token蒸馏:48.4%
- Marginalize-It蒸馏:50.5%
- End-Of-Token蒸馏:52.4%
End-Of-Token不仅超过传统Token蒸馏4个百分点,也是所有方案中最高的。更值得注意的是,普通字节监督模型的预测上限(51.2%)甚至高于Marginalize-It蒸馏(50.5%),印证了后者因信息丢失导致的性能折损。
按scaling曲线推算,End-Of-Token在约6.33×10²² FLOPs时就能追平Token蒸馏的上限。
成本与权衡
字节级蒸馏的优势不止于性能。
- 数据效率高:达到相同能力上限,End-Of-Token所需训练文本量约为Token方案的六分之一。
- 存储开销低:在Token只存top-600、字节存完整分布的设定下,存储量仅需五分之一。
但天下没有免费午餐。
- 计算量更高:因每个Token后加了结束标记,End-Of-Token处理相同文本的训练计算量比普通字节模型高约30.94%。
- 推理成本未比:论文未在等计算成本下比较推理性能,这是未来工作方向。
总的来说,这项研究开辟了一条新路径:用更小的预测空间、更少的数据,换取更高的能力天花板。End-Of-Token在这组实验中表现最佳,但要兑现潜力,仍需持续投入算力。
谁在做这件事?
论文一作Kalyani Marathe是华盛顿大学博士生,曾在Meta AI Research实习。共同作者包括Artidoro Pagnoni(QLoRA核心作者)、Tomasz Limisiewicz(专注tokenization与低资源语言)、Margaret Li(研究高效训练与安全),以及Meta FAIR的Mike Lewis(Llama 3预训练负责人)和Luke Zettlemoyer(FAIR Seattle负责人)。
他们的背景横跨模型架构、scaling、高效训练和tokenization,正好覆盖了这项工作的技术全貌。
这项研究提醒我们:有时候,退一步到更基础的表示单位,反而能打开新的可能性。Token虽好,但未必是蒸馏的唯一答案。