智象发布首款物理规律导向视频模型,登全球AI视频榜单前列
智象发布首款物理规律导向视频模型
智象未来(HiDream.ai)近日正式推出其首款原生全模态视频生成模型 HiDream-O1-Video-1.0(简称 HD-V1)。这款模型支持文本、图片、视频等多种输入方式,能一键生成5到20秒的1080p高保真视频。与当前主流视频生成模型不同,HD-V1从架构设计之初就将物理规律、用户意图和音画一体化作为核心考量,试图解决AI视频中常见的“动作不合理”“镜头跳戏”“音画错位”等问题。
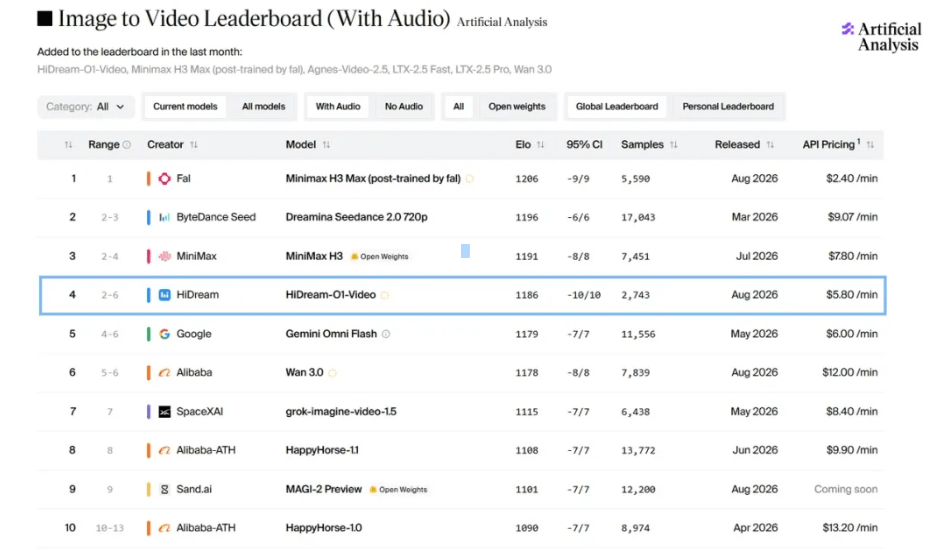
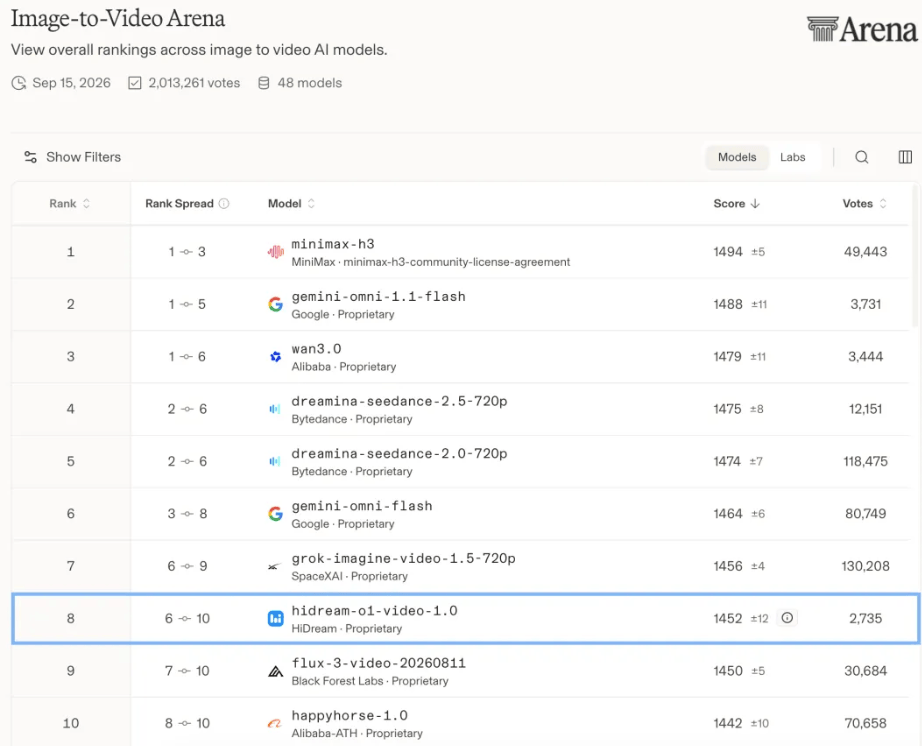
在发布同期,HD-V1 登上了两个国际权威评测榜单:在 Artificial Analysis 的 Image to Video Leaderboard(含音频)中排名全球第四;在 Arena.ai 的 Image-to-Video 盲测评测中位列第八。这两个平台被广泛视为衡量AI视频模型综合能力的重要参考。值得注意的是,这两项成绩并非仅靠单点优化获得,而是基于智象提出的“原生全模态世界模型”技术路线。
更懂意图:从模糊指令到结构化规划
AI视频生成的一大痛点,是用户输入往往口语化、碎片化,甚至自相矛盾。比如一句“拍一个女孩轻轻拉线,线绷紧但没断”,如果模型只盯着关键词“拉线”“绷紧”,很容易忽略“轻轻”这个力度限定,导致动作夸张或物理失真。
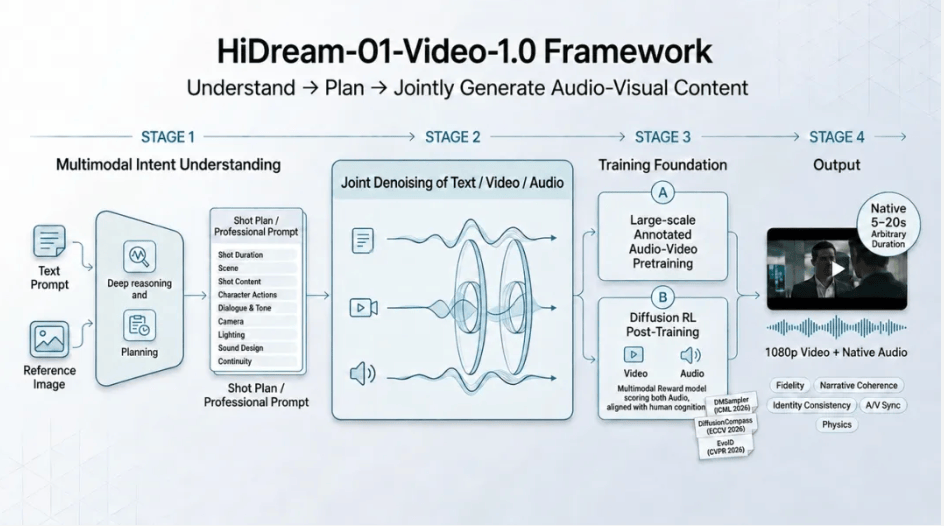
为应对这一问题,HD-V1 在生成前引入了一个多模态意图理解模块。这个模块会把用户的自然语言输入拆解成一系列结构化字段,包括镜头时长、场景地点、角色状态、动作细节、景别构征、运镜方式、台词内容、背景音效等。换句话说,它先把“人话”翻译成“导演分镜脚本”,再交给生成引擎执行。
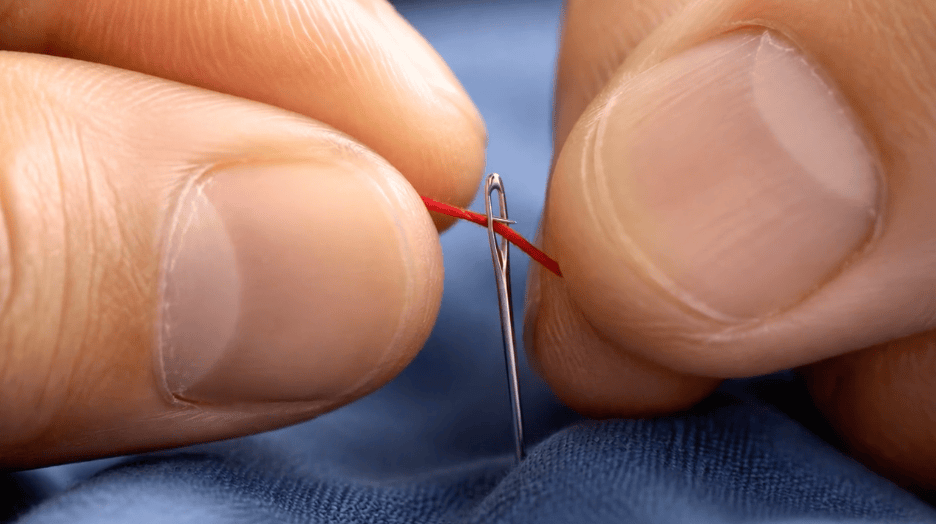
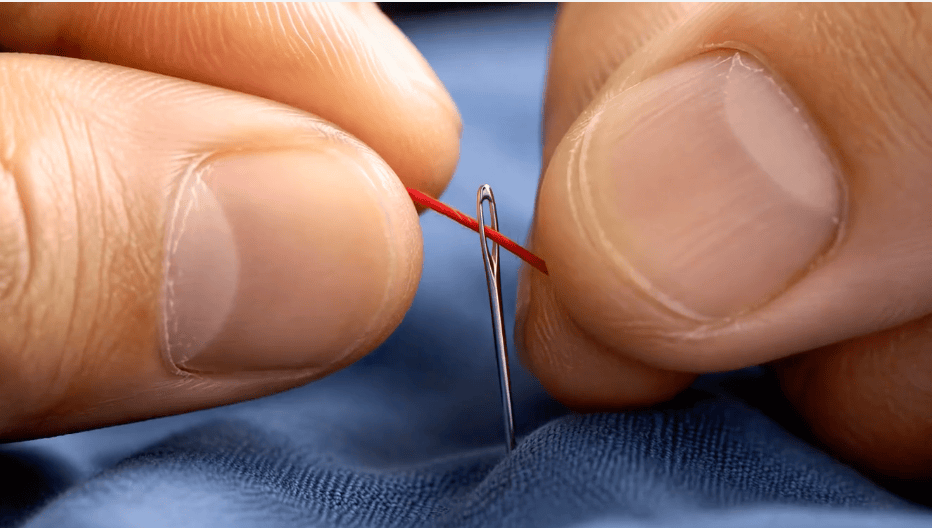
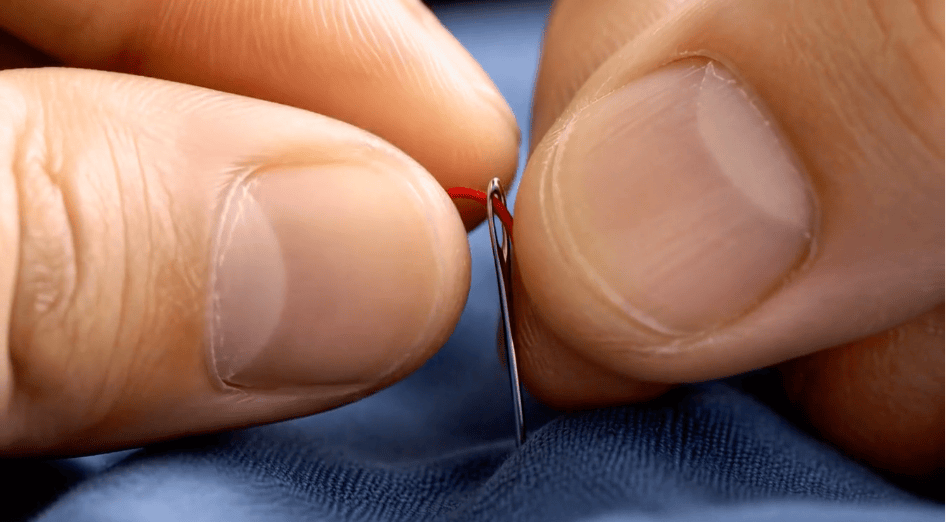
这种“先理解、再规划”的做法,显著降低了生成过程中的随机性。测试显示,在复杂提示下,HD-V1 的镜头连贯性和角色一致性明显优于同类模型。例如,在一段“双手拉红线”的演示中,其他模型要么让红线反向缩短,要么凭空变出一根针;而 HD-V1 能准确还原手指发力时红线的隆起、延展和张力变化,甚至指甲纹理和金属针的反光都高度逼真。
更懂物理:让AI视频“符合常识”
除了理解意图,HD-V1 的另一大突破是对物理规律的建模。传统视频生成模型大多依赖数据驱动,通过海量视频学习“看起来像”的动作,但缺乏对重力、碰撞、惯性、光影衰减等底层机制的理解。这导致生成内容常出现“苹果抛出后悬停三秒”“水花向上飞溅”等违反常识的画面。
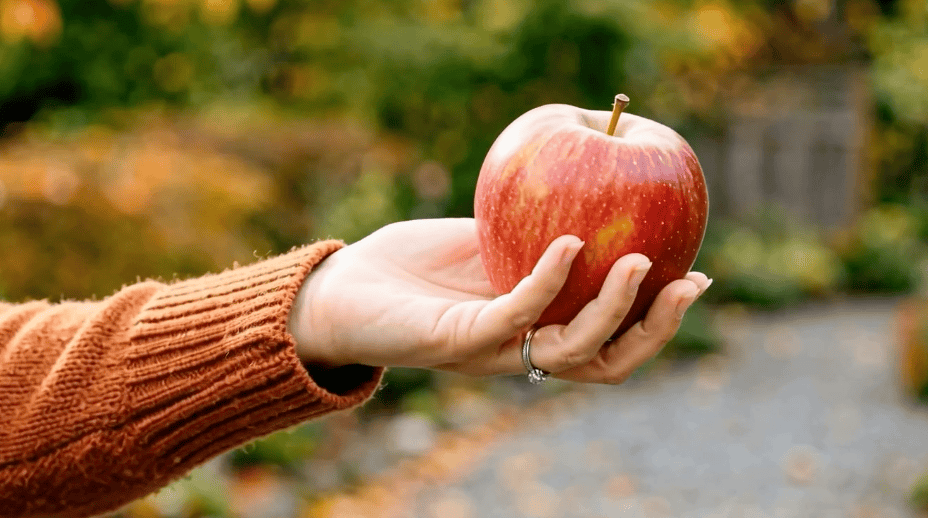
HD-V1 则尝试将物理规则嵌入生成逻辑。它不是简单地模仿表象,而是让模型在生成每一帧时,都考虑物体之间的相互作用是否符合现实世界的因果链。比如在“抛接苹果”的对比测试中,两款竞品模型为了填满10秒时长,要么让手长时间静止握果,要么用慢动作硬撑时间;而 HD-V1 根据动作本身的节奏,只生成了约3秒的合理过程——抛出、接住、稳定,动作自然流畅,没有多余填充。
这种对物理的尊重,不仅提升了真实感,也增强了用户对生成结果的信任。毕竟,当AI开始“讲道理”,人们才敢把它用在需要可靠输出的场景里。
音画原生一体化:告别后期拼接
音画不同步是当前AI视频的通病。多数模型采用“先生成画面,再配音效”的后期拼接策略,导致口型对不上台词、撞击声滞后于动作、环境音与场景割裂。
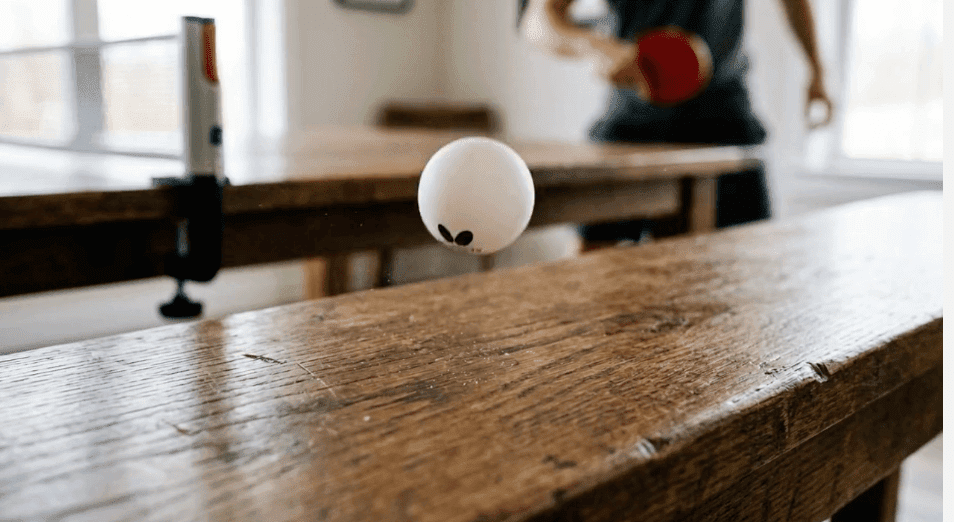
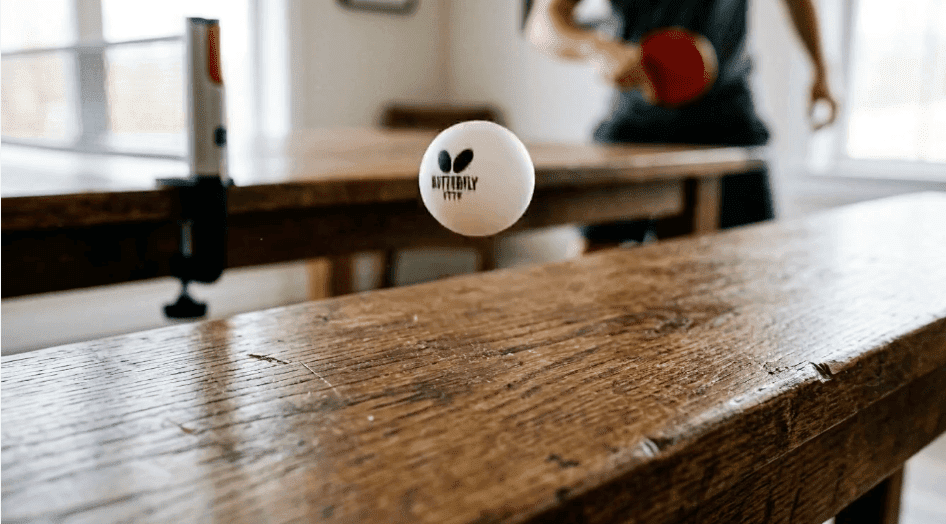
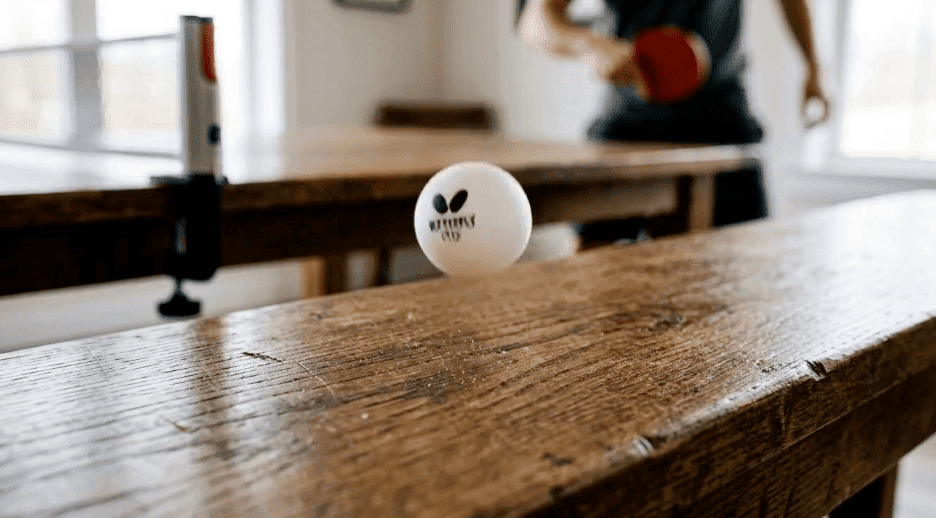
HD-V1 改变了这一流程。它采用原生全模态架构,在生成过程中同步处理文本、视频和音频信号。三者不再是先后关系,而是相互约束、共同演化的整体。例如,在乒乓球弹跳的演示中,HD-V1 不仅让球的运动轨迹符合物理规律,还让每次撞击桌面的声音随高度衰减而变化——高处落下声音清脆响亮,低处轻触则细弱短促,完全贴合现实听感。
这种一体化生成依赖于多模态 Reward 模型的引导。在后训练阶段,智象团队引入了 Diffusion Reinforcement Learning(扩散强化学习),并设计了一套与人类感知对齐的评估机制,从画面质感、动作连贯、声音匹配等多个维度对生成结果打分,从而让模型学会“像人一样感受”音视频的一致性。
技术闭环:四大模型同源演进
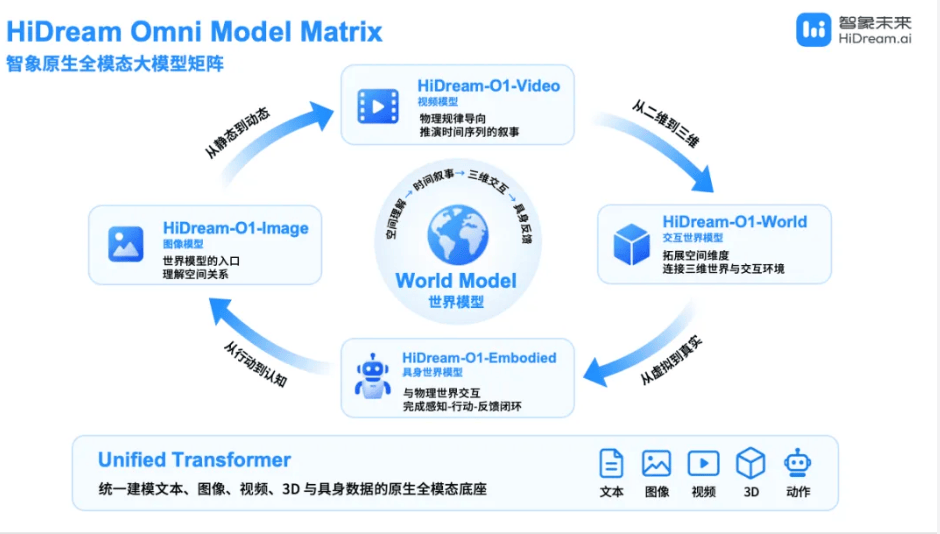
HD-V1 的发布,标志着智象“原生全模态世界模型”矩阵初步成型。自今年4月推出基础架构 HiDream-O1 以来,智象已陆续发布多个子模型:
- HiDream-O1-Image:文生图模型,在 Artificial Analysis 榜单中获中国第一、全球第二;
- HiDream-O1-World:交互式世界模型,在 WBench 基准测试中综合排名第一;
- HiDream-O1-Embodied:具身世界模型,在 RoboColiseum 的扰动适应和空间推理子榜登顶;
- HiDream-O1-Video:即本次发布的 HD-V1,补齐了动态内容生成的关键一环。
这四个模型并非独立开发,而是共享同一套底层架构,实现“同源演进”。图像、视频、3D交互与具身动作在统一框架下交汇循环,形成一个可自我增强的世界模型闭环。智象创始人梅涛博士表示,他们的目标不是堆砌多个单项冠军,而是构建一个能持续进化的原生全模态体系。
C+轮融资落地,产业资本加码
伴随 HD-V1 发布,智象同时宣布完成 C+ 轮融资,投资方包括新微资本、交子资本和工银资本。这三家机构均具有深厚的产业背景,而非纯财务投资者。
新微资本由上海新微科技集团与上海科创投共同发起,管理基金近百亿元,重点布局集成电路与人工智能交叉领域。其投资逻辑在于:智象的模型矩阵“向上连接算力基础设施,向下延伸至智能终端”,与新微在芯片制造端的能力形成协同。
交子资本则是成都交子金控集团旗下的国有股权投资平台,管理规模超1700亿元。其负责人指出,智象围绕统一架构推动四大模型同源演进的路线“在行业中具有鲜明稀缺性”,而 HD-V1 的发布进一步验证了技术落地能力。未来,交子资本希望借助国有资本的长期陪伴属性,推动智象在西部建立AI产业生态。
不只是排名,更是技术路线的验证
回到最初的问题:为什么 HD-V1 能在全球榜单中跻身前列?答案或许不在某个单一指标,而在于其整体技术哲学——以人的感受为尺度,让AI视频不仅“好看”,更要“合理”“可信”“可用”。
当行业还在比拼分辨率、时长或特效炫技时,智象选择回归基础:理解用户真正想表达什么,尊重物理世界的运行规则,并让声音与画面真正融为一体。这种看似“笨拙”的路径,反而可能更接近通用视频生成的终极目标。
随着原生全模态闭环的成型,智象的下一步或许不再是单点突破,而是如何将这套体系规模化落地到影视、游戏、教育、机器人等具体场景。毕竟,世界模型的意义,不在于模拟世界,而在于改变世界。