一道题训练大模型300步,效果竟接近17000道题?OPD新研究揭示数据与算法的真相
一道题能训出多强的模型?
通常我们认为,训练大模型需要海量数据。但清华大学联合中国科学院大学、东北大学及多所海外高校的新研究提出了一个反直觉的现象:在 On-Policy Distillation(在线策略蒸馏,OPD)中,只用一道题反复训练,模型性能竟能逼近使用17000道题的全量训练效果。

实验设置很简单:固定其他所有参数,仅将数学训练集从 DAPO-Math-17K 缩减为单道题。学生模型初始得分为59.1。训练到300步时,单题设置下的验证分数达到68.5,而全量17000题训练同期为69.8——单题已恢复了全量OPD增益的87%,同时缩小了69%的初始师生差距。
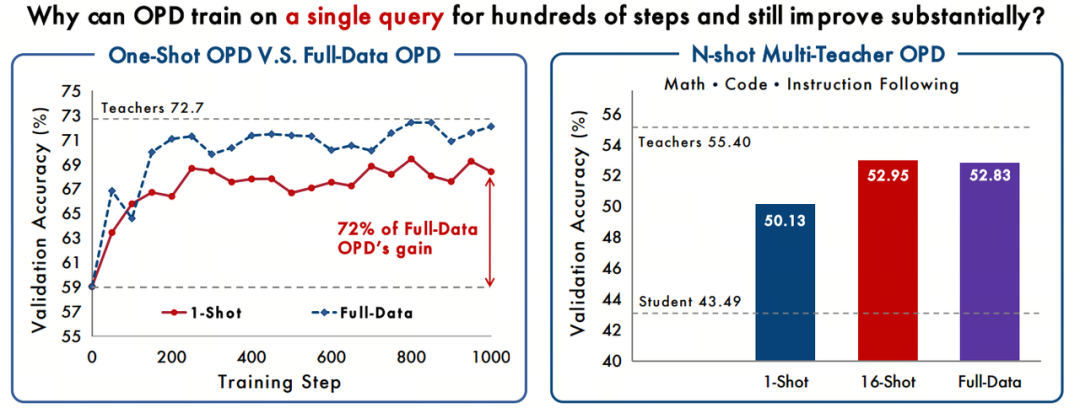
即使继续训练到1000步,单题得分68.4虽略低于全量的72.1,但差距稳定在约3分左右。这意味着,一道题足以带来大部分收益,但无法完全替代多样化的数据。
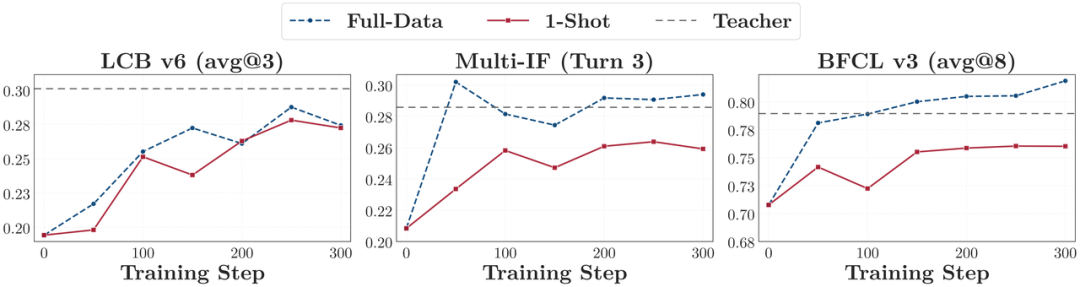
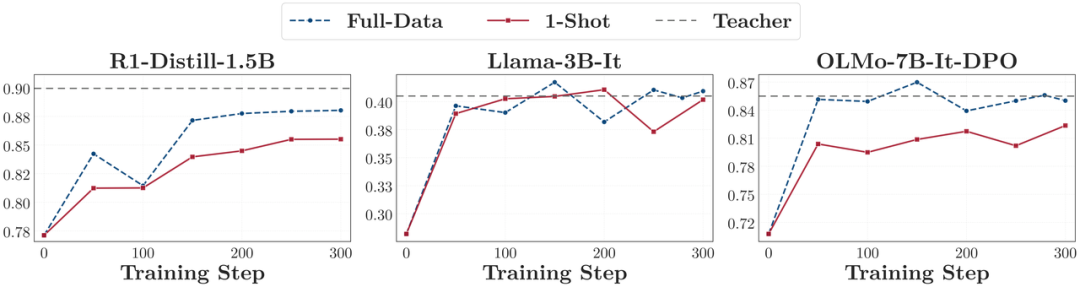
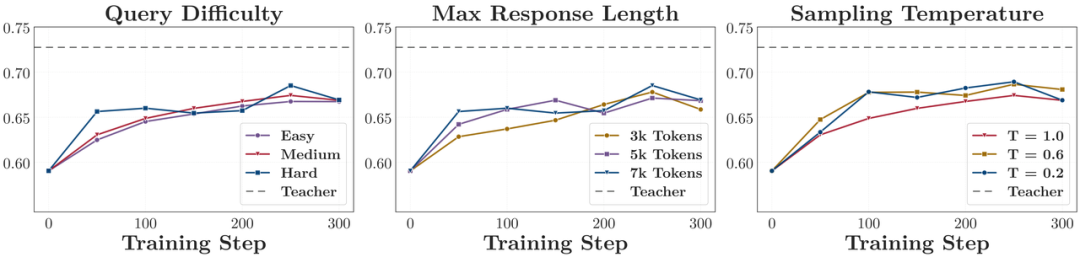
更令人意外的是,这种效果对题目难度几乎不敏感。研究者尝试了三道不同难度的数学题,包括一道学生始终未能解出的难题,结果都观察到了相近的性能提升。调整回答长度上限或采样温度,也未显著改变这一趋势。
学习单位不是题,而是“状态”
为什么一道题能产生如此大的训练效果?关键在于 OPD 的学习单位并非题目本身,而是“状态”(state)。
所谓状态,指的是题目加上模型已经生成的部分回答所构成的上下文。每一步生成,模型都会面对一个新的状态,并接收教师模型在该状态下给出的目标分布作为监督信号。因此,即使输入题目不变,每次 rollout(即模型生成完整回答的过程)都会产生多个带监督的 token 位置。
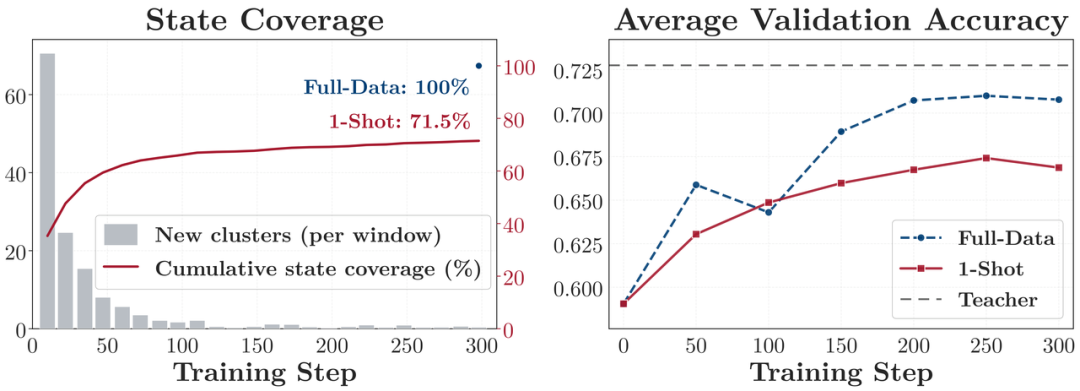
研究团队定义了“状态覆盖率”来量化这一现象:将全量 OPD 访问过的状态聚类为200个簇,单题训练在100步时已覆盖65.9%的簇,300步时达到71.5%。后200步仅新增5.6个百分点,说明大部分状态在早期就被探索到了。
为了验证状态覆盖与性能提升的因果关系,研究者做了两组控制实验。
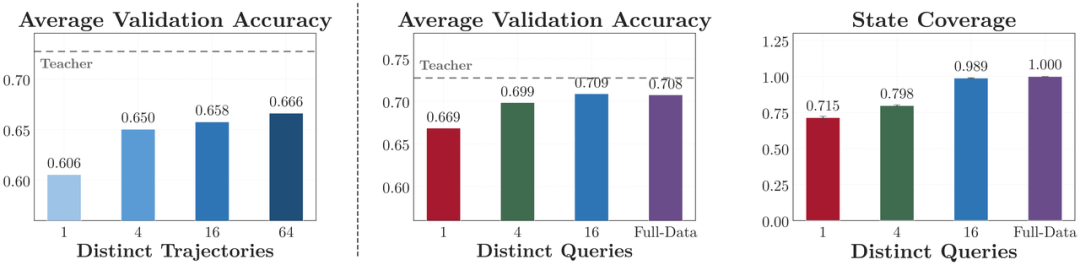
在 rollout 侧,他们固定初始学生模型对同一题生成的64条轨迹,分别只保留1、4、16或全部64条用于训练。结果显示,保留轨迹越多,验证准确率越高(从0.606升至0.666),说明更多样化的生成路径带来了更强的学习信号。
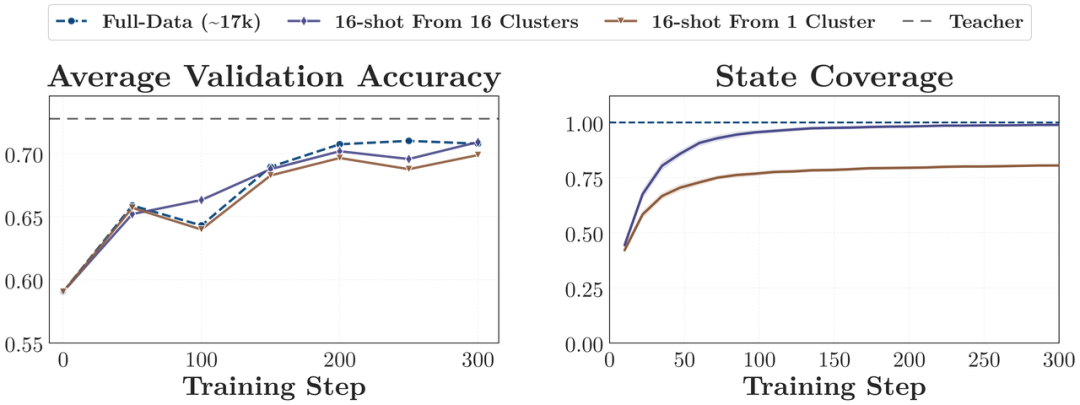
在题目侧,他们从不同语义簇中选取1、4、16道题构建训练集。16道多样化题目的状态覆盖率达98.9%,验证结果与全量数据基本相当。相比之下,若16道题来自同一语义簇,覆盖率在100步后就停滞在76.8%左右,性能提升也明显受限。
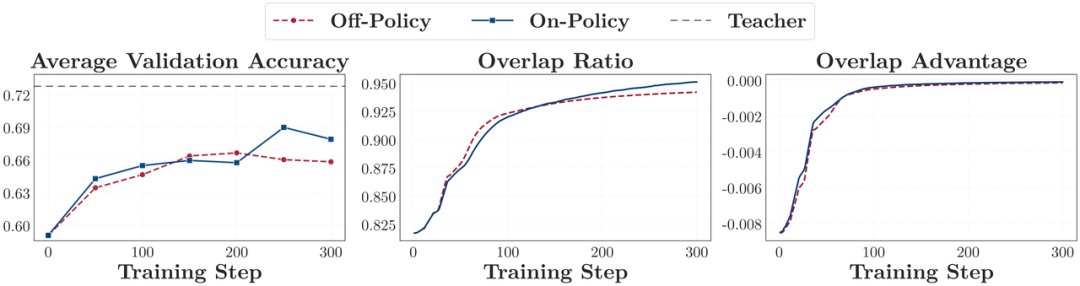
这些实验共同指向一个结论:在 OPD 中,题目的价值不在于其数量,而在于它能否引导模型进入新的、教师仍有指导能力的状态。只要状态覆盖足够广,极少量题目也能发挥巨大作用。

为什么还要训练几百步?

既然一道题能覆盖大部分状态,为何性能提升仍需数百步?问题出在算法侧——模型“吃”监督信号的速度太慢。

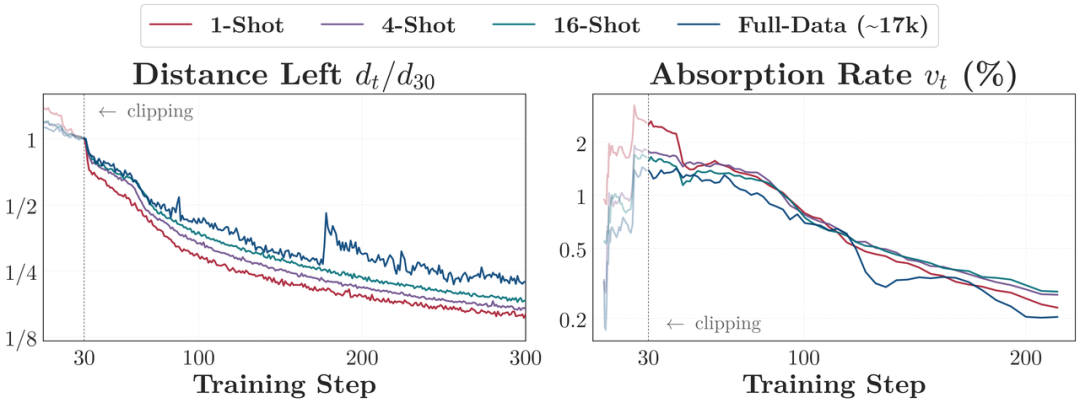
研究者定义了两个动态指标:“距离 d”衡量学生与教师在已生成 token 上的 log 概率差异,“吸收率 v”则表示一次更新能消除多少剩余距离。
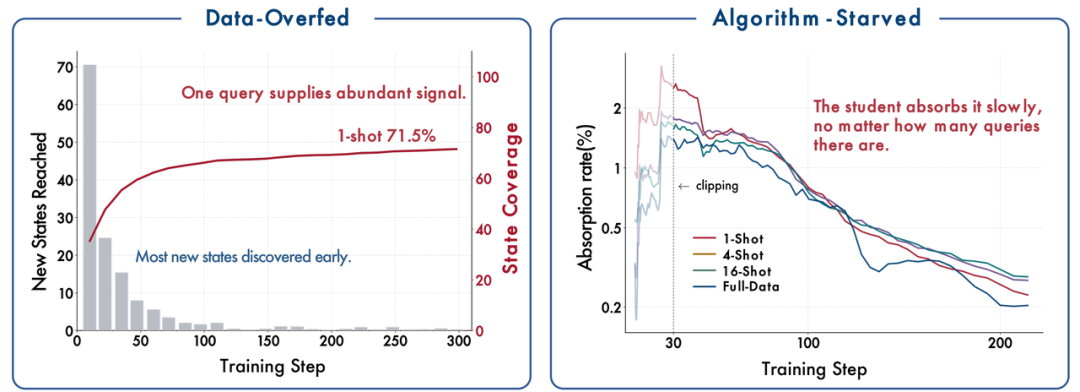
观察发现,距离在整个训练过程中持续下降,但吸收率却不断降低。这意味着模型一直在进步,只是越往后进步越慢。更关键的是,这一趋势与训练集大小几乎无关:无论是1题、4题、16题还是17000题,到300步时各自都吃掉了自身初始距离的78%–84%。
这说明,对齐的节奏不由题目数量决定,而由模型吸收监督的能力决定。
有人可能怀疑是学习率设置不当导致收敛慢。研究者在四倍范围内测试了不同学习率,发现提高学习率确实能缩短训练步数,但将横轴按学习率缩放后,三条距离曲线几乎重合。也就是说,学习率只改变时间尺度,不改变吸收速度递减的本质规律。
此外,即使固定 rollout 轨迹(不再采样新状态),模型在约200步内仍能持续提升。这表明,长训练曲线不仅源于新状态的生成,也源于对已有监督的反复消化。
综合来看,OPD 面临的是“数据撑死,算法饿死”的局面:监督信号充足,但模型吞咽太慢。
扩展到多教师与极端输入
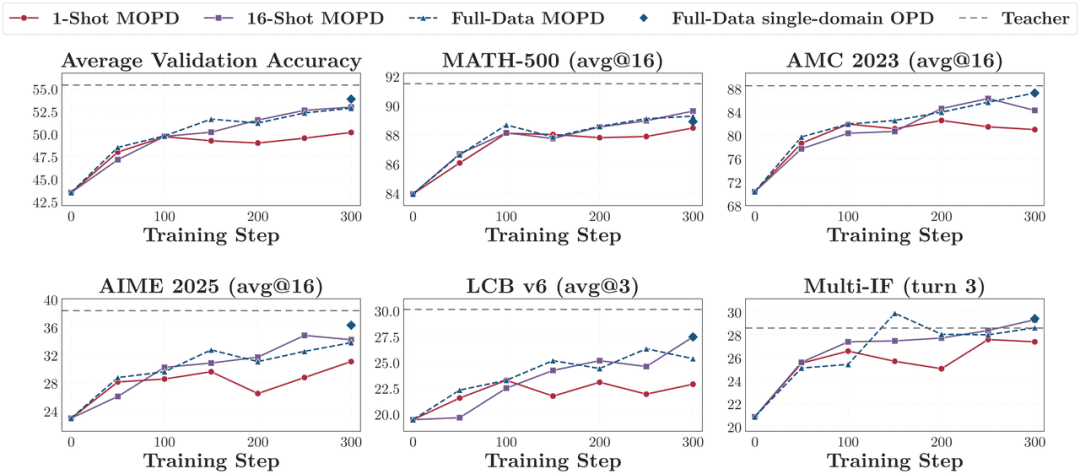
研究进一步将结论推广到更常见的 Multi-teacher OPD(MOPD)场景,即一个学生同时学习多个领域的教师模型。结果同样惊人:每个领域只需16道语义不同的题,就能打平全量 MOPD 的效果。
初始平均分为43.5,300步后,单题/16题/全量 MOPD 的得分分别为50.1/52.9/52.8,而三位教师的平均分为55.4。这再次证明,数据多样性比数量更重要。
更激进的实验甚至尝试了“不成题的题”:
- 空模板:用户输入为空,直接跟
<think>标记; - 系统模板:仅包含一行领域指令;
- WildChat 提示:19万条真实闲聊数据,其中仅0.17%与数学相关。
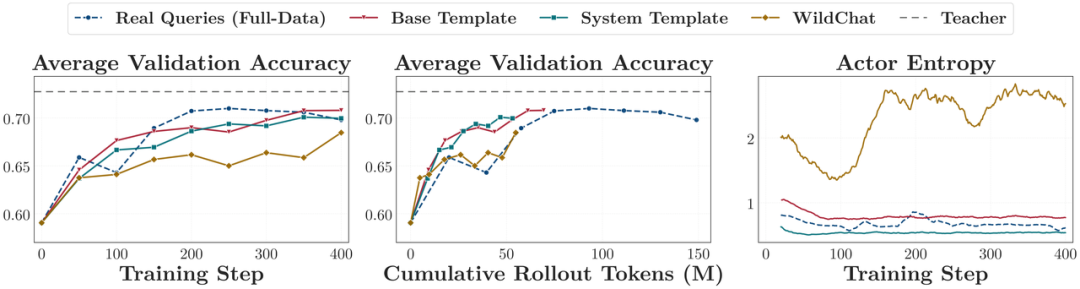
令人惊讶的是,这三种条件下的训练效果紧贴真实数据基线,且仅消耗了三分之一到一半的 rollout token。例如在代码域,真实数据500步消耗277M token,空模板仅需18M。
不过,并非任意文本都有效。如果模板在 <think> 后立即闭合,模型只会生成简短元回复,无法形成有效训练轨迹。这说明,输入的关键作用在于引导模型进入可被教师有效监督的状态,而非提供明确任务内容。
与强化学习的对比
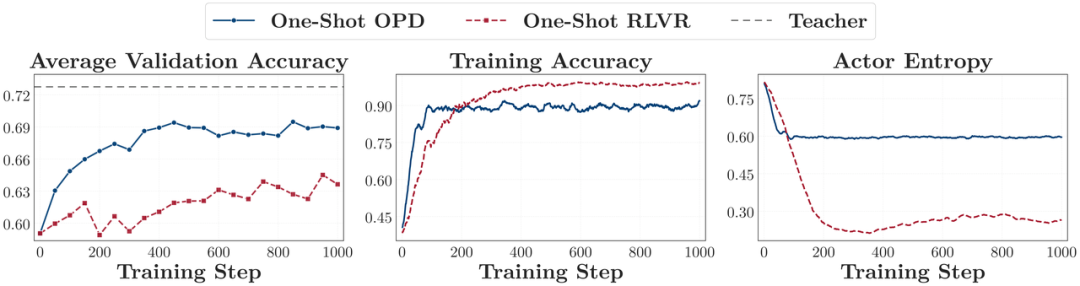
研究还将 OPD 与基于结果的强化学习方法 RLVR 在同一道题上进行对比。结果发现,1000步内 OPD 的验证集涨幅是 RLVR 的两倍多,并缩小了72%的师生差距。
但这并不意味着 OPD 全面优于 RLVR。两者受限于不同因素:RLVR 受限于数据能提供的结果差异(即奖励信号的多样性),而 OPD 受限于吸收密集监督的速度。OPD 被教师分布“拴住”,无法超越教师;RLVR 则可能突破教师上限,但需要足够多样的成功/失败案例。
实践启示:别再盲目堆数据
这项研究并非否定数据的重要性,而是重新定义了“有效数据”的标准。在 OPD 中,题目数量不是衡量监督量的合适尺度。真正重要的是:
- 这道题能否把学生带到未访问过的新状态?
- 在这些状态中,教师是否还有新东西可教?
- 给定当前吸收速度,几百步内能否消化这些监督?
这为数据筛选提供了新视角:与其追求海量干净数据,不如关注状态空间的覆盖效率。模型面前的数据已经够多,问题是它“咽得太慢”。
结合该团队此前关于“高分教师未必更适合教学”的发现,Rethinking OPD 系列的核心观点逐渐清晰:在稠密监督范式下,稀缺的从来不是供给,而是匹配与吸收的能力。
“贪多嚼不烂”这句老话,在大模型训练中似乎同样适用。而“状态”这一视角,或许不仅能解释 OPD,还能为其他 on-policy 训练方法提供新的分析框架。