WorldRoamBench:用千条长时漫游评测世界模型的四大短板
可交互世界模型的“真实考验”才刚开始
过去几个月,Genie 3 的发布让“可交互世界模型”这个概念真正火了起来。用户不再只是看一段 AI 生成的视频,而是能输入“前进”“左转”等指令,实时改变一个持续演化的虚拟世界。听起来很酷——但能走进去,不等于经得起探索。

问题在于:模型能否在长时间交互中持续响应控制?画面会不会中途崩坏?它是否遵守基本的物理规则?当你绕一圈回来,世界还是原来的样子吗?这些才是决定一个世界模型能不能用于游戏、仿真或具身智能的关键。可惜,现有评测大多只比 5 到 10 秒的短视频,根本看不出分钟级交互中的隐患。
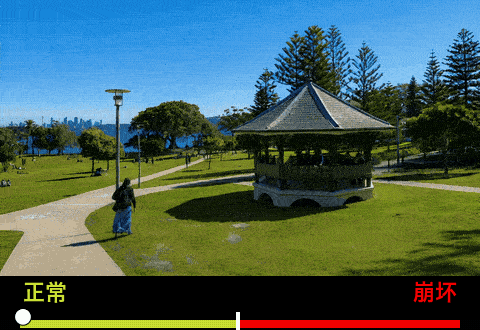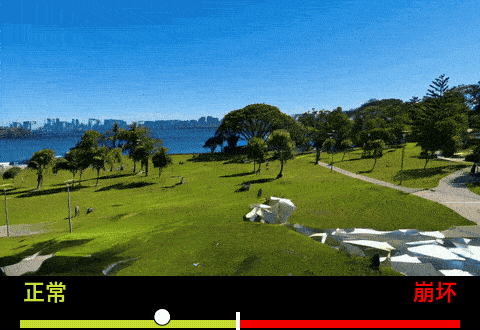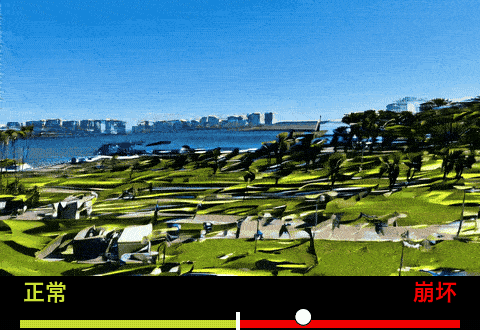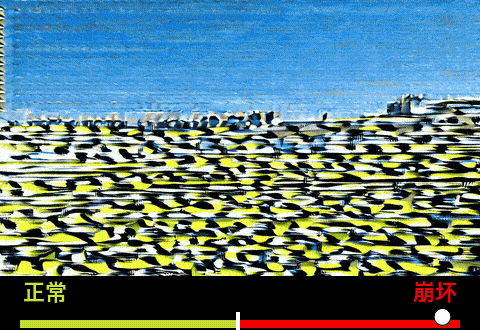
比如,一段 30 秒的漫游视频,在加速播放下明显看到画面从某个时间点开始扭曲、模糊,最终结构崩解。但在常规评测里,这种“渐进式崩溃”很容易被平均画质分数掩盖,因为开头和结尾看起来还行。
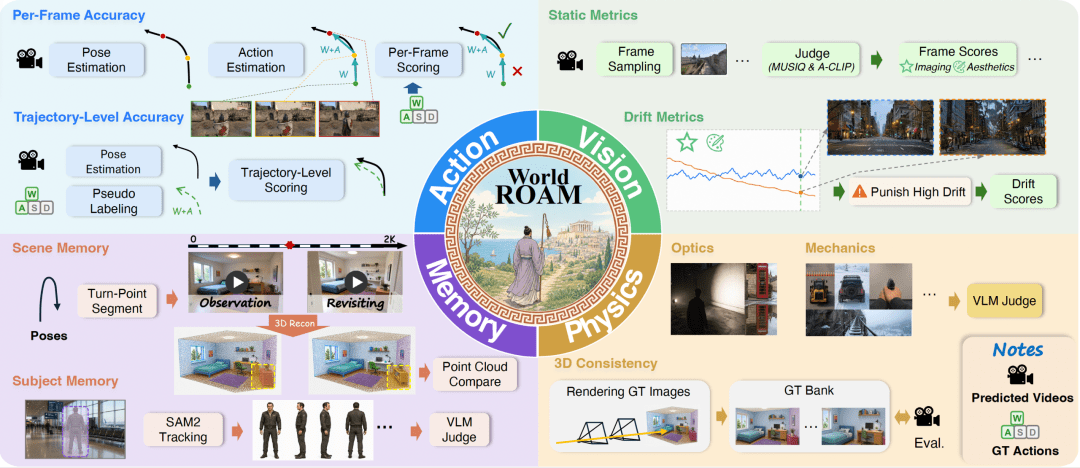
为了解决这个问题,高德视觉技术中心联合南京大学、清华大学、北京大学推出了 WorldRoamBench——一个专门针对长时交互稳定性的开放评测基准。它用超过 1000 个长达数十秒的漫游样例,系统测试 12 款主流交互式世界模型,试图回答一个更贴近落地的问题:这些模型,真的能在用户长时间操作下保持可靠吗?
四大维度拆解:长时交互到底难在哪?
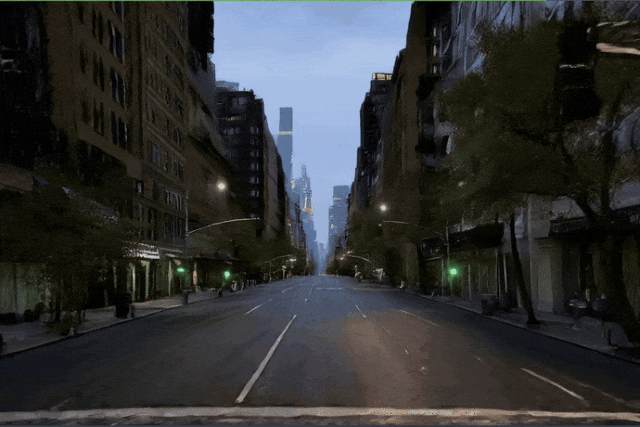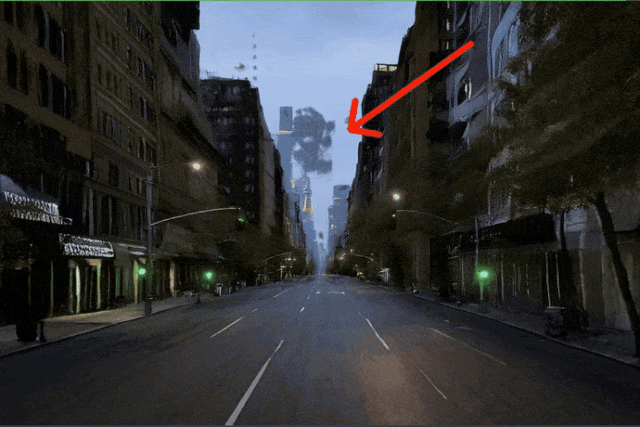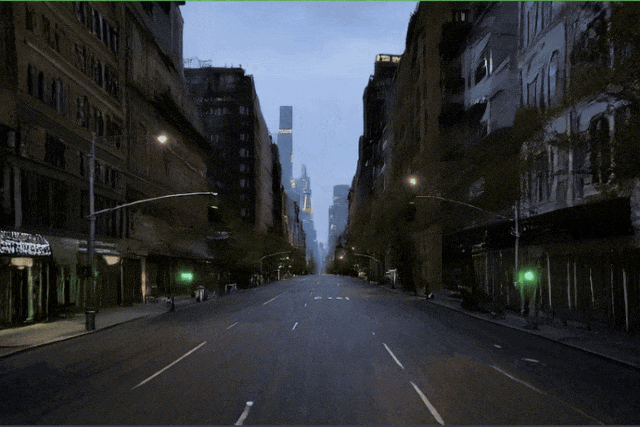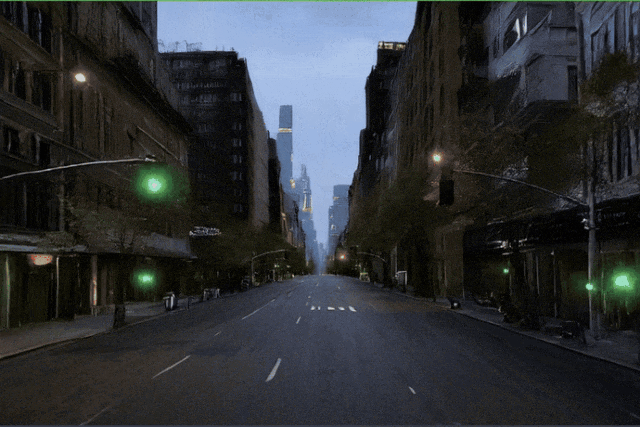
WorldRoamBench 的核心思路是:别只给总分,要拆开看。一段看似流畅的漫游,背后可能藏着四种不同类型的失败。于是,他们把评测拆成四个维度:动作、视觉、物理、记忆。
动作轨迹会“骗人”:走对了路,不代表听指挥
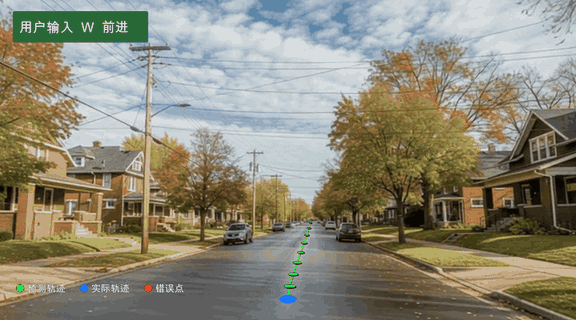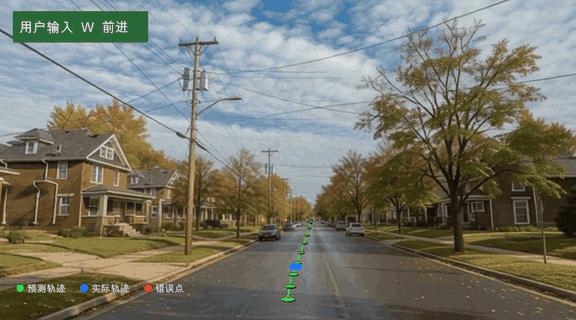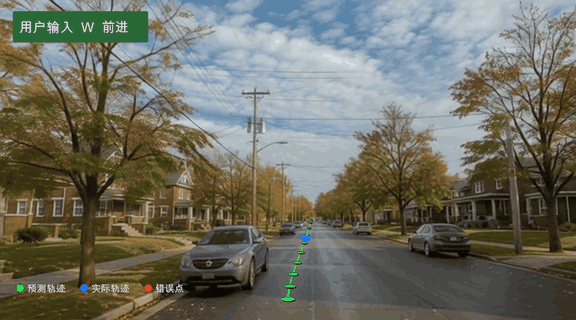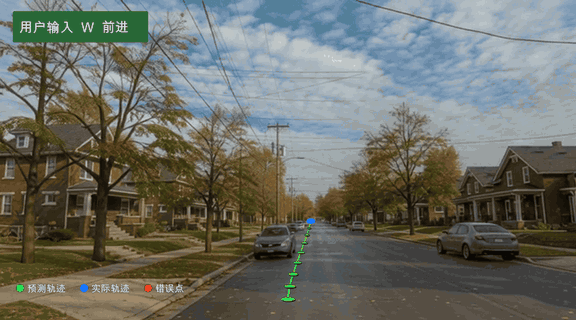
很多评测只看最终轨迹是否匹配用户意图。比如用户一直按“前进”,模型最后确实往前走了——看起来没问题。但细看过程,画面其实在中途多次反向后退,或者延迟响应。由于整体路径没偏太多,这类局部错误就被忽略了。
WorldRoamBench 认为,交互式模型的关键不是“走到哪”,而是“每一步是否准确响应”。他们通过逐帧比对用户输入与模型输出的动作变化,识别出延迟、误触发、方向反转等问题。结果显示,不少模型在轨迹上得分不错,但在动作遵循的细节上漏洞百出。
画面何时开始“漂”:不能只看首尾帧
长时生成容易累积误差。一开始画面清晰稳定,但随着交互时间拉长,物体位置偏移、建筑变形、纹理错乱等问题逐渐出现。有些模型甚至会在中途“漂移”几秒后又恢复,导致首尾帧对比完全看不出异常。
但对用户来说,哪怕只有一次明显的画面抖动或结构崩坏,沉浸感就断了。WorldRoamBench 引入了视觉漂移检测机制,不仅计算平均画质(如 FID、CLIP Score),还追踪整个生成过程中是否存在显著的视觉不连续或结构失真。这比传统视频质量评估更能反映真实体验。
世界会“穿帮”:物理规律要在交互中检验
很多模型能生成看起来合理的静态场景,但一互动就露馅。比如角色走到墙前,模型没让它停下,而是直接穿墙而过;或者扔个球,它穿过桌子掉到地下,而不是弹跳或滚动。
WorldRoamBench 设计了一系列主动触发式物理测试:先确认交互确实发生(比如主体已接触障碍物),再判断响应是否符合物理常识。评测覆盖碰撞检测、重力反馈、遮挡关系、光影一致性等多个方面。只有真正“撞上去”,才能看出世界是不是纸糊的。
“死亡旋转”之后,模型也会“失忆”
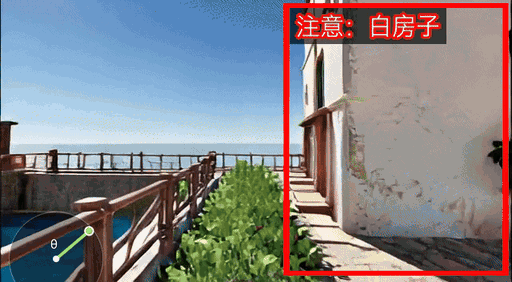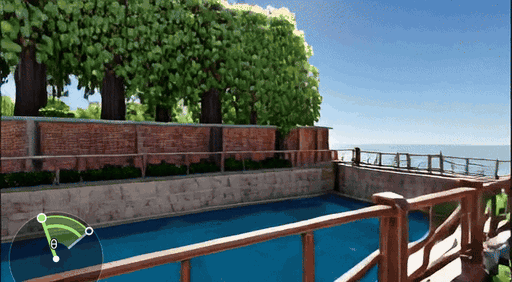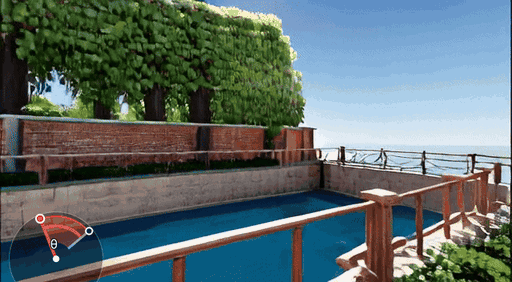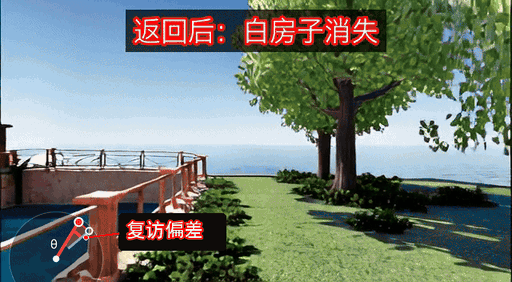
所谓“死亡旋转”,是指让模型先原地旋转一圈,再沿反方向转回原位,看场景是否一致。这是测试长期记忆的经典方法。但有个陷阱:如果返回时位置有微小偏差,画面自然不同,但这不一定是“忘记”,而是定位不准。
WorldRoamBench 的做法是:先通过几何对齐排除位置偏差,再比较对应区域的内容变化。比如,原本有一栋白房子在视野左侧,返回后那个位置空了,且对齐后确认视角无误——那就是真正的“失忆”。评测发现,多个模型在复访时会凭空删除或新增物体,说明它们并没有维护一个连贯的世界状态。
测评实战:Genie 3 也“偏科”
基于这套四维体系,团队在统一条件下测试了包括 Genie 3、Happy Oyster、LingBot-World 等在内的 12 款模型。测试场景涵盖第一人称/第三人称视角,以及自然、城市、室内等多种环境,并通过任务设计尽量减少维度间的相互干扰(比如避免因动作错误导致物理测试失效)。
结果令人意外:没有一个模型是全能选手。
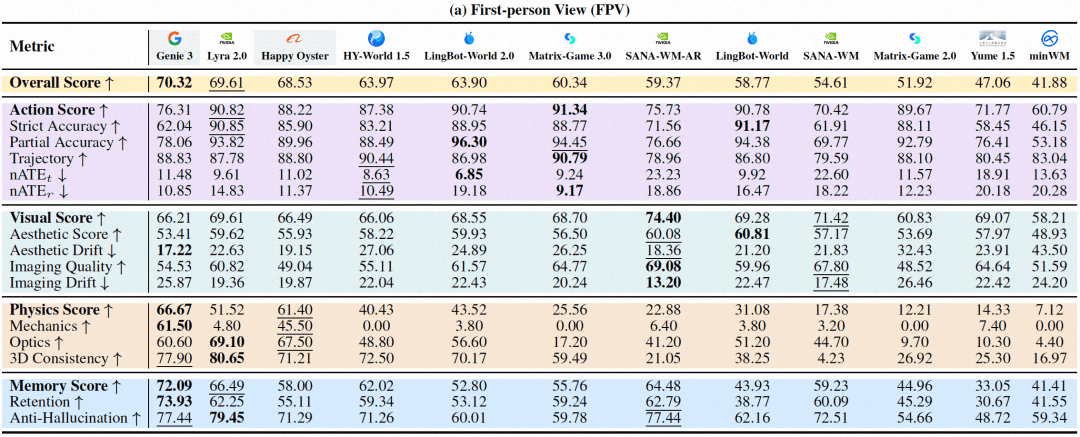
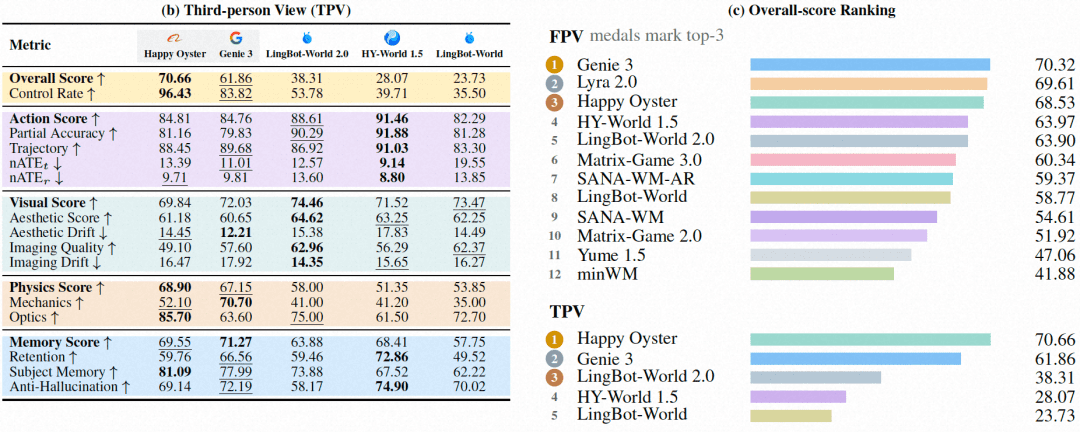
在第一人称综合榜上,Genie 3 排名第一,Lyra 2.0 和 Happy Oyster 紧随其后。但在细分维度上,Genie 3 的表现两极分化严重:它的记忆能力和物理一致性在所有模型中排名第一,说明它能较好维持世界状态并响应基本物理规则。然而,它的动作遵循仅排第八,视觉稳定性更是跌到第九——意味着用户操作经常得不到及时准确反馈,画面也更容易中途崩坏。
第三人称榜单中,Happy Oyster 综合第一,Genie 3 居次。这说明不同模型在不同视角下的优化策略差异很大,也反映出当前技术路线尚未收敛。
开源共建:让评测跟上模型进化
WorldRoamBench 并不打算止步于这 12 个模型。目前,官网已开放评测入口(https://worldroam.amap.com/),研究者可以下载测试样例,运行自己的模型,并上传结果参与打榜。未来,评测代码和执行脚本也将逐步开源。
更重要的是,WorldRoamBench 提出了一种新思路:世界模型的竞争,正从“能否生成一段可控视频”转向“能否支撑长时间可信交互”。短时动作遵循只是起点,真正的挑战在于分钟级甚至更长的稳定演化。
毕竟,一个世界如果只能让你逛十秒钟,那它再漂亮也只是橱窗;只有当你能自由探索、反复验证、长期停留时,它才算得上“可交互”。而这条路,所有模型都还在摸索中。