不更新模型参数,RSIAgent 如何靠自主探索让开源 Agent 超过 GPT-6 Astra
模型部署后的问题:聪明但不懂因果
过去几年,大模型的能力跃迁几乎都围绕一个词:Scaling——更大的参数、更多的数据、更强的算力。Agent 也从“会聊天”逐渐走向“能干活”。
但问题往往出现在部署之后。
当一个 Agent 第一次进入某个企业内部系统、专业软件或全新工具时,它面对的是一套陌生的交互逻辑:按钮在哪里、API 怎么调、哪些操作会触发隐藏限制、什么情况下会突然报错。即便底层模型足够聪明,它也可能完全搞不清这个环境里的因果结构:哪个操作真正导致了结果?改变什么变量才能让任务成功?
传统做法是:遇到新环境,就收集一批交互数据,再微调、强化学习或人工反馈重新训练。但这在现实中很难持续。企业软件的数据不能公开,私人工作流无法标准化,而且每次换环境都重训成本太高。
于是问题变成:如果不更新模型参数,Agent 能不能像人一样,自己探索、试错、总结规律,并持续变强?

Aether AI 最近提出的 RSIAgent 正是尝试回答这个问题。他们想走另一条 Scaling 路线:不 Scale Model,而是 Scale Experience。
RSIAgent:让 Agent 自己学,自己验证,自己记住
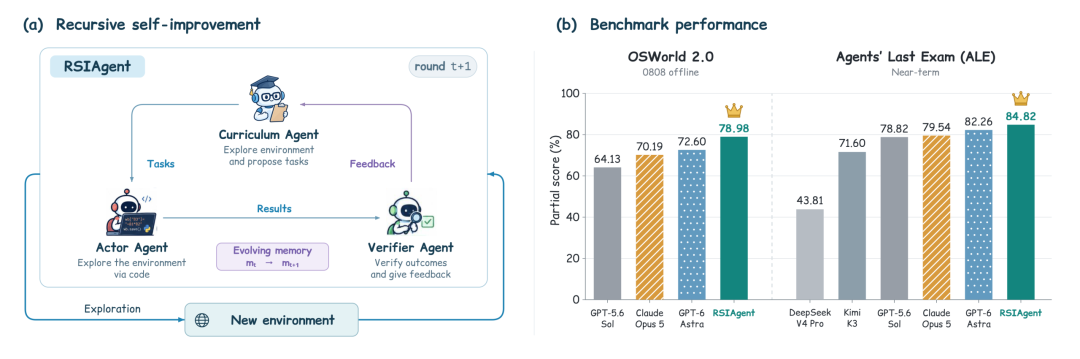
RSIAgent 的核心是一个名为 Autonomous Exploration for Recursive Self-Improvement(RSI,递归自我提升) 的框架。它的目标很直接:让 Agent 在不改动模型参数的情况下,通过与环境的持续交互,自主发现稳定的因果关系,并将这些知识沉淀进一个可演化的记忆(evolvable memory)中,供后续任务复用。
整个系统由三个角色协同工作:
- Curriculum Agent:决定下一步该探索什么;
- Actor Agent:进入环境执行操作,尝试完成任务;
- Verifier Agent:根据真实环境反馈判断结果是否可靠。
三者形成一个闭环:Curriculum Agent 提出探索任务 → Actor 执行并记录经验 → Verifier 验证结果 → 有效知识写入 Memory → Curriculum 基于新记忆生成下一轮任务。
这样,Agent 不再只是被动响应指令,而是主动选择学习方向,像人类实习生一样,在真实软件中边做边学。
Broad-to-Deep:先铺开,再深挖
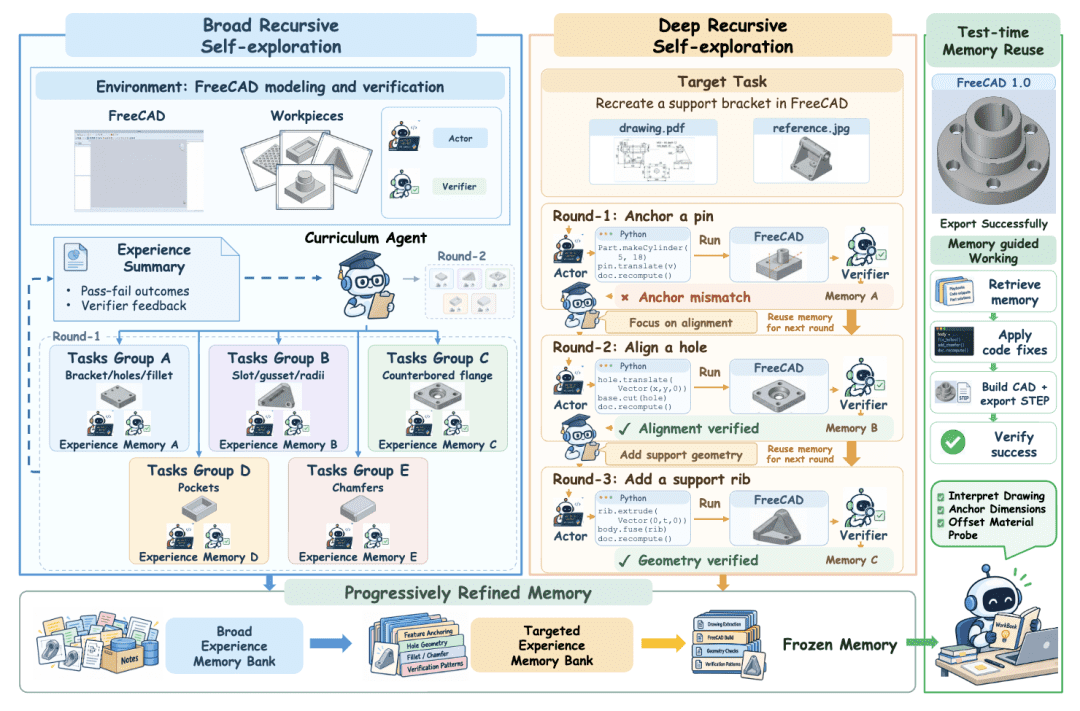
RSIAgent 采用 Broad-to-Deep 两阶段探索策略,思路类似大模型的 Pre-training → Post-training。
第一阶段:Broad Recursive Self-exploration(广度优先)
这一阶段的目标是快速建立对环境的整体认知。Curriculum Agent 会同时生成多个方向不同的探索任务——比如尝试不同菜单路径、不同输入格式、不同工具组合。多组 Actor 和 Verifier 并行执行与验证,有效经验汇总进共享 Memory。
然后,基于当前已知的知识,Curriculum 再生成下一批覆盖新区域的任务。整个过程形成一个并行递归链:
多方向任务 → 并行执行 → 并行验证 → 汇总更新 Memory → 新一轮多方向任务
通过这种方式,系统能在短时间内摸清常见操作流程、高频失败模式和基本约束,画出一张初步的“环境知识地图”。
第二阶段:Deep Recursive Self-exploration(深度攻坚)
有了基础地图后,系统转向攻克难点。Curriculum Agent 会刻意设计困难任务,把 Agent 推向容易出错的边界场景:比如极端输入、罕见状态、隐藏依赖或异常中断。
Actor 尝试完成任务,Verifier 检查结果,Curriculum 则根据暴露出的脆弱点,设计一个更难的任务。整个过程变成顺序递归链:
困难任务 → 执行 → 验证 → 更新 Memory → 更困难任务
这就像自动化的“压力测试”,不断挑战 Agent 的知识边界,逼它发现那些只有在复杂组合下才会暴露的隐藏规则。
最终,两阶段积累的 Memory 被冻结,直接用于后续任务执行。此时,Agent 已经具备了对新环境的可复用理解,而模型参数从未改动。
实验结果:开源模型反超闭源巨头
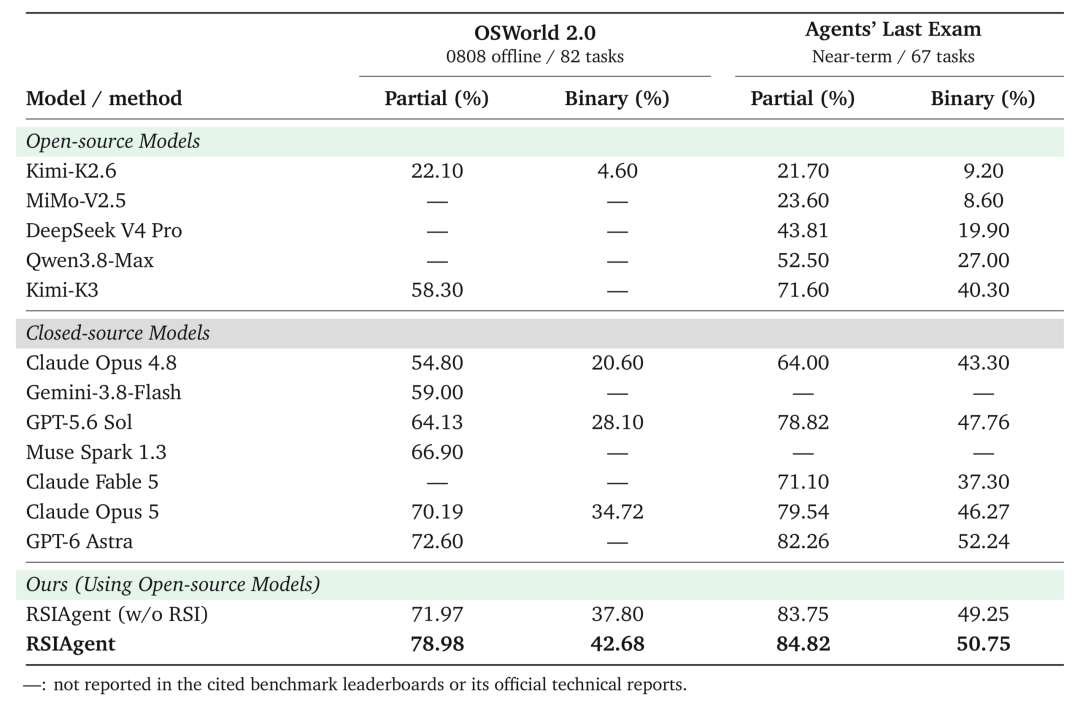
在 OSWorld 2.0 和 Agents’ Last Exam 两个主流 Agent 基准上,RSIAgent 的效果相当直接。
- 在 OSWorld 2.0(0808 offline)上,基于 GLM-5.3 的 RSIAgent 将 Partial Score 从 71.97% 提升至 78.98%;
- 在 Agents’ Last Exam(Near-term)上,基于 Kimi-K3 的版本达到 84.82%。
这两个成绩均大幅超过 GPT-6 Astra(72.60% 和 82.26%),也优于 Claude Opus 5 等闭源模型。
这意味着,即使底层模型不如对手,只要给 Agent 足够的自主探索能力,它就能通过经验积累实现“弯道超车”。
泛化能力:不止于操作系统
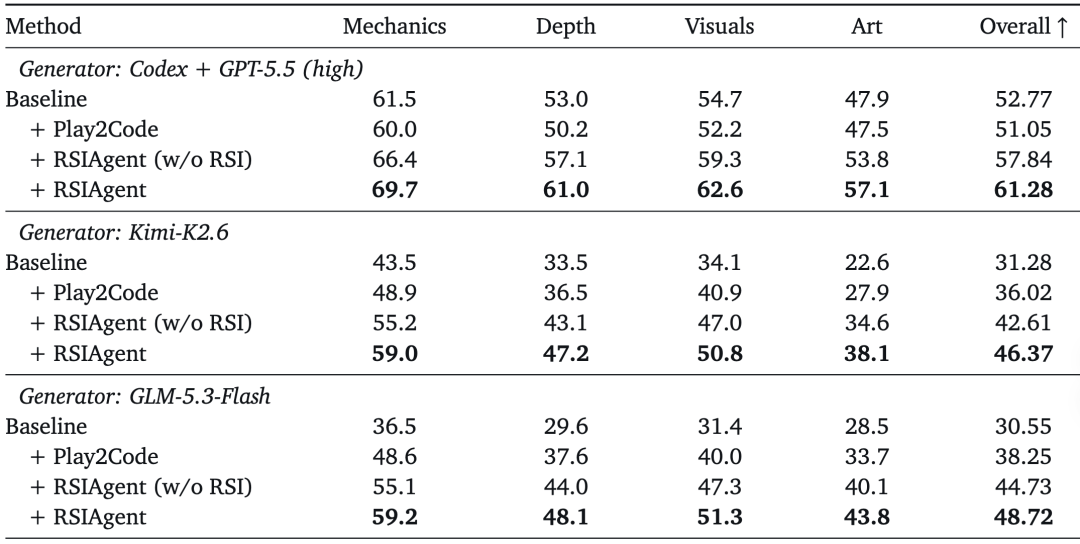
团队还将 RSIAgent 应用于 GameCraft-Bench 的自主游戏开发任务。结果显示,在 mechanics(机制)、depth(深度)、visuals(视觉)、art(美术)和 overall quality(整体质量)等多个维度,RSIAgent 都带来了进一步提升。这说明其“主动探索—自我进化”机制可以迁移到不同类型的交互环境,不只是桌面软件。
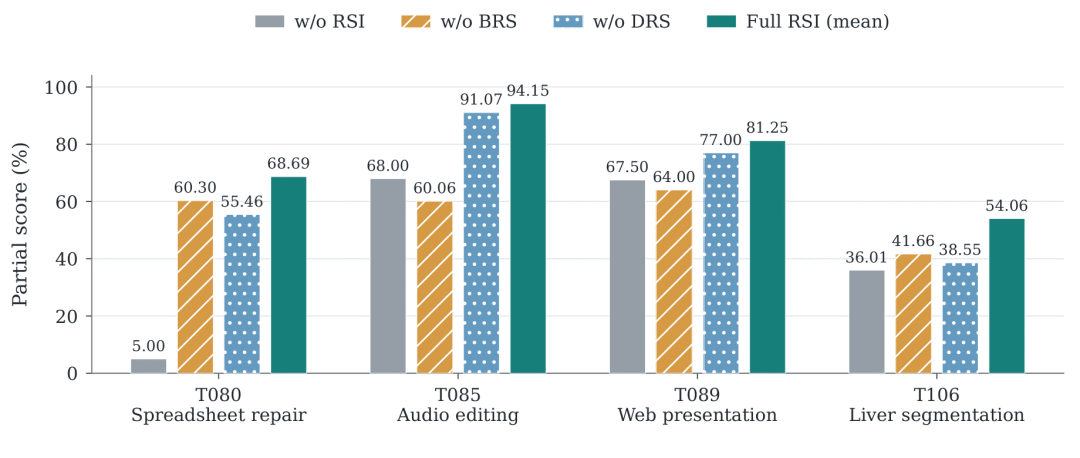
消融实验:Broad 和 Deep 缺一不可
移除 Broad 阶段后,系统难以覆盖足够多的操作路径,容易遗漏基础规则;移除 Deep 阶段后,则无法攻克隐蔽的失败模式。两者结合,才能既快又稳地构建完整的环境理解。
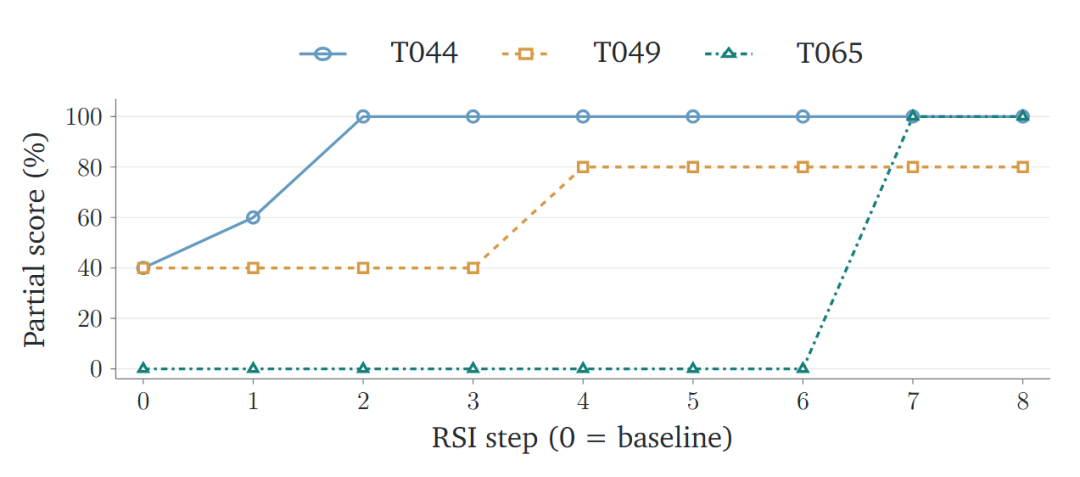
RSI 轮次越多,能力越强
随着 RSI 轮次增加,Agent 表现持续提升。简单任务可能几轮就收敛到高分,复杂任务则需要更多轮探索。一些初始成功率仅为 0–40% 的任务,经过多轮 RSI 后最终达到 100%。这种渐进式提升,很像人类在陌生软件中从“手忙脚乱”到“得心应手”的过程。
背后的路线:从 Scaling Model 到 Scaling Experience
过去几年,AI 的进步主要依赖 Scaling Model——更大的模型、更多的预训练数据。但这种范式本质上是“先训练,再部署”,一旦进入新环境,模型就变成了“聋子”和“瞎子”,无法自主形成新知识。
Aether AI 的因果智能路线试图改变这一点。他们认为,真正的智能体不应只记住“什么通常有效”,而要理解“什么改变会导致什么结果”。
RSIAgent 正是这条路线在数字环境中的具体实践。它推动 Agent 从被动训练走向主动因果发现:
- 不是记录轨迹,而是主动干预环境;
- 不是预测相关性,而是验证因果性;
- 不是依赖外部标注,而是靠自身验证闭环。
Memory 也因此不再是简单的经验回放池,而逐步成为对环境因果结构的可复用认知。每一次探索,都是对“动作—条件—结果”链条的一次检验和固化。
更大的图景:通用因果智能
对 Aether AI 来说,RSIAgent 处理的桌面软件只是载体。无论是数字智能体调用 API,还是机器人在物理世界抓取物体,本质问题相同:一次行动如何改变环境?这些变化由哪些因果机制决定?
团队此前的工作已经铺垫了这条路径:
- Causal-Copilot 让 Agent 自主完成因果分析,识别关键影响因素;
- C-World 构建开放式工具使用环境,支持复杂交互与数据生成;
- Auto-scaling Continuous Memory 和 Hybrid Self-Evolving Structured Memory 研究如何将经验沉淀为可扩展的长期记忆;
- StructAgent 则将这些能力统一到长程数字智能体中,用因果结构组织状态、执行与验证。
RSIAgent 把这些想法整合进一个可运行的框架,证明了:Agent 的能力上限,不仅取决于模型有多强,更取决于它能否通过主动干预,持续完成因果发现、验证与积累。
未来,或许我们不再需要为每个新软件重新训练模型,而是让同一个 Agent 进入环境后自己“摸清楚门道”。它会像老员工一样,知道哪个按钮不能乱点,哪个流程必须按顺序走,甚至能预判失败并提前规避。
而这,可能才是 Scaling Experience 的真正意义——让智能体在真实世界中,靠自己的经验长大。