DM0.5 横扫六大量具身智能榜单,靠的不是刷题而是真泛化
六张榜,六个第一:不是刷题,是换题
最近具身智能圈又多了一张新榜单——RoboColiseum。这套由智元机器人发起的评测,专门从四个维度“折腾”机器人:指令跟随、空间理解、扰动适应和通用操作。说白了,就是看它听不听得懂人话、能不能看明白环境、外部一乱会不会懵,以及最后到底能不能把活干完。
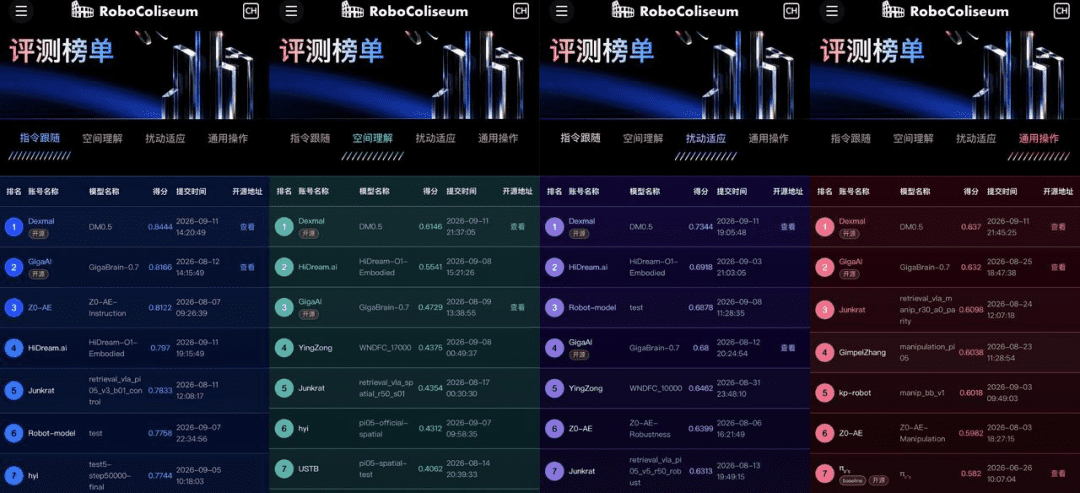
结果很干脆:DM0.5 在这四个子项上全部排第一,成为目前 RoboColiseum 中唯一一个包揽全部榜首的模型。

但这还不是全部。往前倒两周,它刚在 RoboDojo 拿下综合第一;再往前,LIBERO、RoboTwin 2.0、VLA-Arena、RoboChallenge Table30 V2……截至目前,DM0.5 已经把自己公开参与的六套评测全部跑到了第一名。

乍看之下,这像是又一个“刷榜机器”。但细看就会发现,这六套评测根本不是同一类题。它们考察的目标、环境、机器人本体甚至任务形式都大相径庭。换句话说,这不是反复做同一道题,而是题型一直在变,第一名却没怎么换。

题目千差万别,能力却要连贯

具体来看这些榜单的差异:

- LIBERO 聚焦通用操作能力,在标准化环境中测试模型完成日常任务的稳定性;
- RoboTwin 2.0 则引入更复杂的场景组合,要求模型在动态变化的上下文中执行多步任务;
- VLA-Arena 把难度分层递进,从简单指令到需要推理的复合目标逐步加码;
- RoboChallenge Table30 V2 直接上真机,让同一模型同时适配 ARX5、UR5、ALOHA、Dexmal-Mirror 四种异构机器人本体,面对30个高复杂度任务;
- RoboDojo 重点考察泛化、记忆、精细操作、长程执行和开放语义理解,其中“Memory”维度尤其苛刻;
- 而最新的 RoboColiseum,则把原本混在一起的能力拆开,单独测试指令、空间、抗干扰和操作四个基础模块。
成绩也印证了这种差异性下的稳定性:
- LIBERO 综合成功率 99.0%;
- RoboTwin 2.0 简单与复杂场景分别达 93.6% 和 93.3%;
- VLA-Arena 三档难度下为 89.0%、53.6%、44.1%;
- RoboChallenge Table30 V2 真机测试中,整体成功率 43.0%,综合得分 54.42;
- RoboDojo 的 Memory 维度,DM0.5 得分 47.74(成功率 47.44%),而第二名仅 13.37 分(12.11%)。
这些数字背后透露出一个关键信号:DM0.5 的优势不在某一项特别突出,而在能力覆盖相对完整。过去很多具身模型容易陷入“Demo 很强,换题就掉”的困境——可能特别会叠衣服,也可能专精抓杯子,但在新任务或新机器人上立刻失效。真正难的,从来不是把一道题做对,而是换题之后还能继续做对。而这六套榜单,本质上就是从不同角度给模型找短板。DM0.5 到目前为止,把这些不同类型的“考试”都接住了。
真实世界比榜单更“刁难”
当然,Benchmark 再多,最终还是要回到真实环境。因为现实世界根本不会按排行榜出题。
它不会等你准备好,也不会保证每次输入都长得差不多:相机会突然被动、物体会被人挪走、零件会卡住、柔性物体会变形、传送带更不会因为机器人没想明白就停下来。这些,恰恰是具身模型进入工厂、仓库或家庭后必须处理的问题。
DM0.5 的真机演示展示了它如何应对这些“意外”:
- 相机视角突变:即使外部视点发生明显变化,机器人仍能基于新观测继续完成原任务,而不是直接崩溃或重复无效动作;
- 人为打断:当人伸手移动目标或中断动作时,它不会机械地沿原轨迹执行,而是重新理解当前状态,修正后续动作;
- 微型积木拼装:最小组件宽度不到1厘米,抓取与扣合需控制在0.1–1毫米尺度。由于存在工艺公差,直接硬压极易错位卡死。DM0.5 会先对准,再通过细微震动与下压力完成扣合;若失败,还能自主识别、重新调整姿态并再次尝试;
- 削黄瓜:柔性物体操作更难。力大了切坏,力小了切不动,且表面形状持续变化。DM0.5 通过关节电机电流值实时感知作用力,在接触过程中动态调整力度。搭载高自由度灵巧手的人形机器人经针对性后训练后,可控制58个自由度完成长程厨房任务;
- 高速物流分拣:传送带不停,包裹尺寸、材质、姿态随机变化,机器人仅有几秒时间完成识别与动作。DM0.5 不依赖预设脚本,靠实时视觉识别与决策,平均约3秒一单,准确率超99%。
这些 Demo 和前面的六套 Benchmark 其实在回答同一个问题:换了情况以后,模型还能不能继续做? 只不过现实世界的题目更复杂、更不可控,容错空间也更小。
为什么换题不用从头学?
这次 RoboColiseum 有个细节值得注意:DM0.5 并没有为四张子榜单分别设计复杂方法,而是通过常规监督微调,将已有能力迁移到新机器人构型和新任务上。这意味着,它的表现主要依赖预训练阶段已形成的能力,而非临时“特训”。
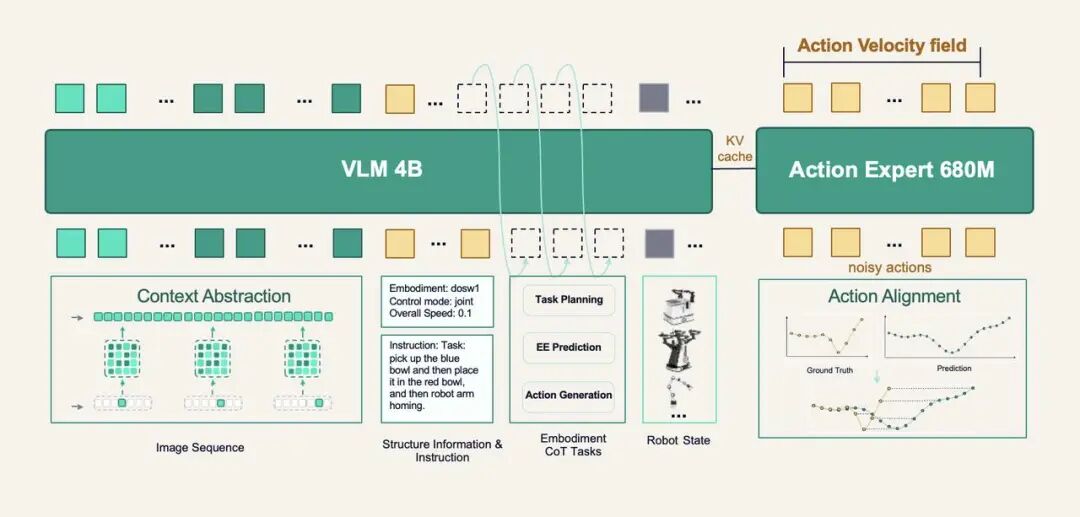
从架构上看,DM0.5 学的不只是“看到这个画面,机械臂该怎么动”。它同时压缩并保留历史视觉信息,将任务指令、机器人当前状态和任务进度一起纳入判断,再由动作模块生成最终控制信号。简单说,它试图理解的不仅是“怎么动”,还有“现在发生了什么、做到哪一步、接下来该做什么”。
这种设计让它在面对新任务时,有机会复用预训练中学到的通用策略,而不是每换一道题就从零开始。
一个直接体现是记忆能力。DM0.5 原生支持最长60秒的历史信息回溯,能把之前的观测和动作带入当前决策,而不是每一步都只看眼前帧。这正好解释了它在 RoboDojo Memory 维度上的碾压式表现。
数据层面也支撑了这种泛化能力:预训练数据覆盖导航、抓取和全身控制,包含六类机器人本体,总计有5万小时真机高精度操作数据、10万小时第一视角场景视频和100万平方米空间重建数据。
此外,速度也是关键。DM0.5 将核心推理延迟从 534.04ms 压至 57.49ms,在基本保持精度的前提下实现 9.29 倍加速。对机器人而言,这不只是性能优化——慢半拍,结果可能就是撞上障碍、抓空目标,或者错过传送带上的包裹。
下一张成绩单,不在榜单上
不过,对具身智能来说,Benchmark 终究只是模拟考。真正的终局考试,是生产环境。
目前,DM0.5 已全面开源,包括模型权重、训练框架,以及 LIBERO、RoboTwin2、SO101 等多个下游任务的工作流,并已向 LeRobot 社区提交核心代码。
更重要的是,它已经开始落地:
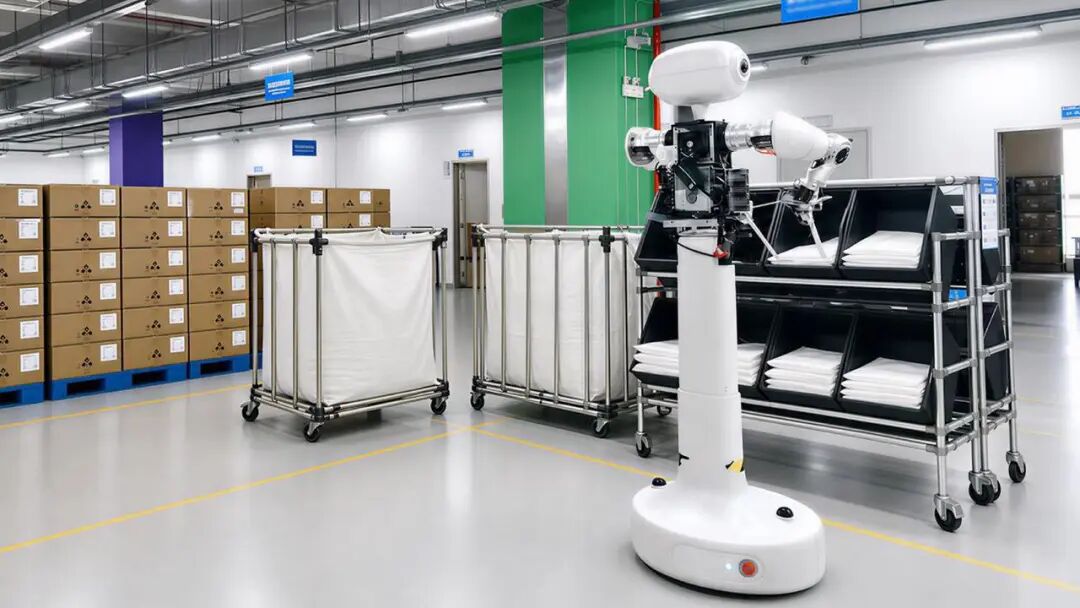
- 在某大型国际零售商的仓储中心,多台搭载 DM0.5 的机器人正与其他类型机器人协同完成商品搬运与分拣;
- 在某大型 3C 制造商的工厂里,DM0.5 正参与产品包装与废料回收流程。
今天的具身智能评测正在发生明显转向:大家不再只问“这个动作做得多精准”,而是不断换任务、换场景、换本体、加干扰,看模型能否在变化中保持能力。对所谓“通用具身模型”而言,这反而是一场更接近真实需求的考试。
题型一直在变,DM0.5 仍然站在榜首。但真正的考验,才刚刚开始。