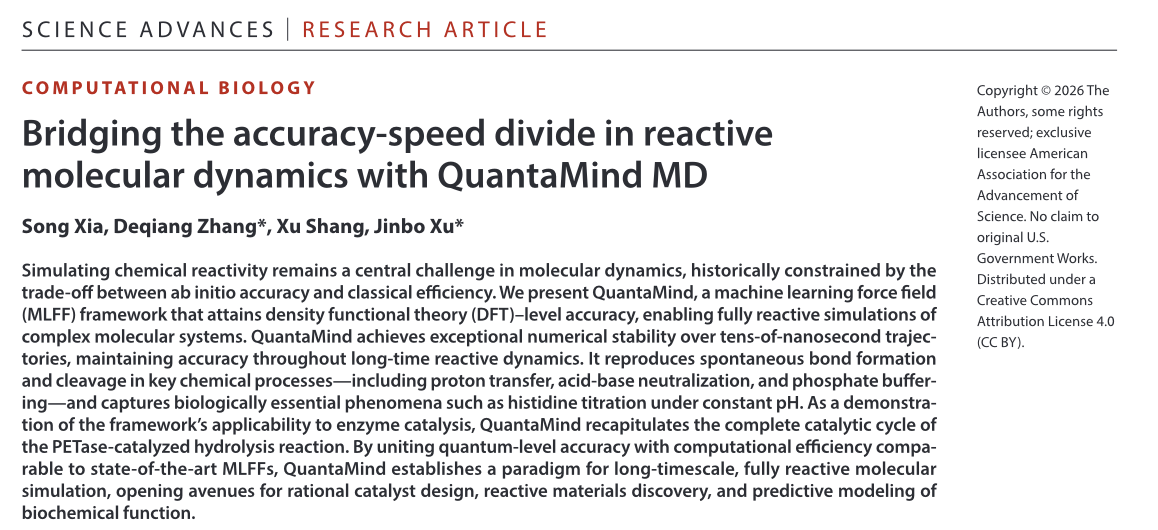
分子之心QuantaMind登Science Advances,实现十万原子级反应性分子动力学模拟
精度、速度与尺度的“不可能三角”被打破
要真正理解一个蛋白质“怎样工作”,光知道它长什么样远远不够。关键在于捕捉那些发生在纳秒时间尺度、原子级别上的动态过程:质子怎么跳?化学键如何断开又形成?药物结合后蛋白构象怎么变?这些才是决定分子功能的核心。
传统方法一直卡在一个死结里:量子化学计算(比如DFT)精度高,但算不动大体系;经典分子动力学能跑大体系长时间,却没法描述化学反应;现有的机器学习力场在小分子上还行,一放到大型生物体系里跑长一点,就容易崩。
分子之心最近在《Science Advances》发表的QuantaMind研究,第一次把这三个维度——精度、体系规模和模拟时长——同时推到了生物研发真正能用的程度。论文里验证的最大体系是24,001个原子,最长跑了20纳秒;而论文提交后的内部测试已经做到十万原子级和百纳秒尺度。
在近1.8万原子的酶里“跑完”一次完整催化
最硬核的验证是在一个包含17,792个原子的PET水解酶体系上。QuantaMind跑了6纳秒的反应性分子动力学模拟,完整重现了酶催化的整个循环过程。这意味着它不只是看蛋白骨架晃来晃去,而是真正在追踪催化中心发生的化学反应。
光能跑完还不够,得算得准。研究团队从这段轨迹里抽了342个瞬间构型,拿去用标准DFT方法单独算了一遍力。结果发现,QuantaMind给出的原子力和DFT结果的相关系数全都超过0.99。换句话说,在这个复杂的反应过程中,它的精度几乎和第一性原理计算一样可靠。
其他验证也覆盖了不同尺度:
- 质子扩散:在24,001个原子的水盒子中,模拟出的质子扩散系数是0.87±0.10 Ų/ps,和实验值0.94–0.96非常接近;
- 水自解离:在近万个原子的水体系里跑3纳秒,成功捕获了多次水分子自发解离事件,算出的pH是6.34±0.06,对标实验值6.13±0.03;
- 蛋白残基pKa:把溶菌酶放进含磷酸盐的缓冲液环境模拟20纳秒,估算出第15位组氨酸的pKa约为5.81,和核磁测得的5.5基本吻合。
这些结果说明,QuantaMind不是简单地让大体系“动起来”,而是在更大更复杂的环境中,持续准确地描述那些和生物功能直接相关的反应性事件。
计算效率:从“理论可行”到“实际可用”
再好的方法,如果算得太慢也没法落地。QuantaMind在效率上也有实质性突破。论文报告,在A100 80GB GPU上,它的推理速度是4.2×10⁻⁶秒/原子/步。对于一个1.8万原子的PETase体系,跑1纳秒大约需要20小时。
而最新的内部优化把速度又提了一倍,达到2.1×10⁻⁶秒/原子/步。按这个速度,模拟一个十万原子的反应体系,每一步的时间步长只需要0.25秒。这个效率已经足够支撑一些实际研发场景的探索。
产业应用:从“盲目试错”转向“先算再测”
当这种高精度的动态轨迹能稳定产出,它对研发流程的改变是直接的。过去很多机制问题只能靠一轮轮实验去碰运气,现在可以先在计算端分析清楚,再有针对性地做实验。
在药物研发方面,静态对接很难处理pH变化带来的影响。QuantaMind能模拟关键氨基酸残基在不同pH下的质子化状态切换,从而分析电荷分布、构象变化和相互作用的动态调整。在一个pH敏感抗体项目中,团队用QuantaMind辅助设计的候选分子,在pH 6.0下的解离速率达到了pH 7.4下的62倍——这种效果以往往往要靠大量湿实验筛选才能偶然撞上。
在酶工程领域,传统改造依赖“表达-纯化-测活”的循环,成本高、周期长。QuantaMind能直接重现催化机理,帮研究人员锁定真正关键的突变位点。分子之心已经在多个复杂酶项目中用它探明反应路径,大幅缩小了后续实验的搜索空间。
补齐AI分子研发的动态拼图
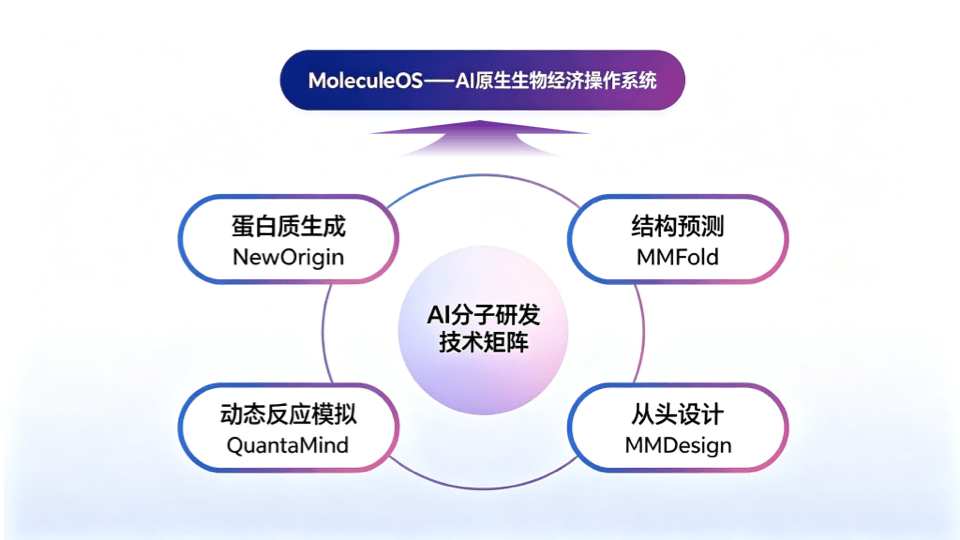
QuantaMind的出现,标志着分子之心的技术矩阵完成了关键一环。从生成模型NewOrigin、结构预测工具MMFold,到从头设计平台MMDesign,再加上现在的动态模拟引擎QuantaMind,他们已经串起了“生成—设计—预测—机理理解”的完整链路。
这些能力未来都会集成到他们的MoleculeOS操作系统里。论文通讯作者、分子之心创始人许锦波说:“过去AI学会了回答分子‘长什么样’,下一步我们要回答它‘为什么这样运动、这样反应’。QuantaMind希望成为连接设计、模拟和实验的关键基础设施。”
这确实是个转折点。AI蛋白质设计不再只是输出一个静态结构,而是能在设计阶段就预演它的动态行为和反应机制。当分子世界能被“拍成电影”而不是只拍一张快照,研发的确定性就大大增加了。