PhAI Labs 发布 DFM 技术报告:让 AI 在科学发现中形成经验闭环
从 Chat 到 Discovery:AI 的下一个跃迁
成立才一个多月,Jeff Dean 的新公司 Discovery Loop 估值传闻已冲到 500 亿美元。资本押注的逻辑很简单:如果 AI 能加速 AI 自身的研发,那被加速的就可能是整个技术演进的速度。
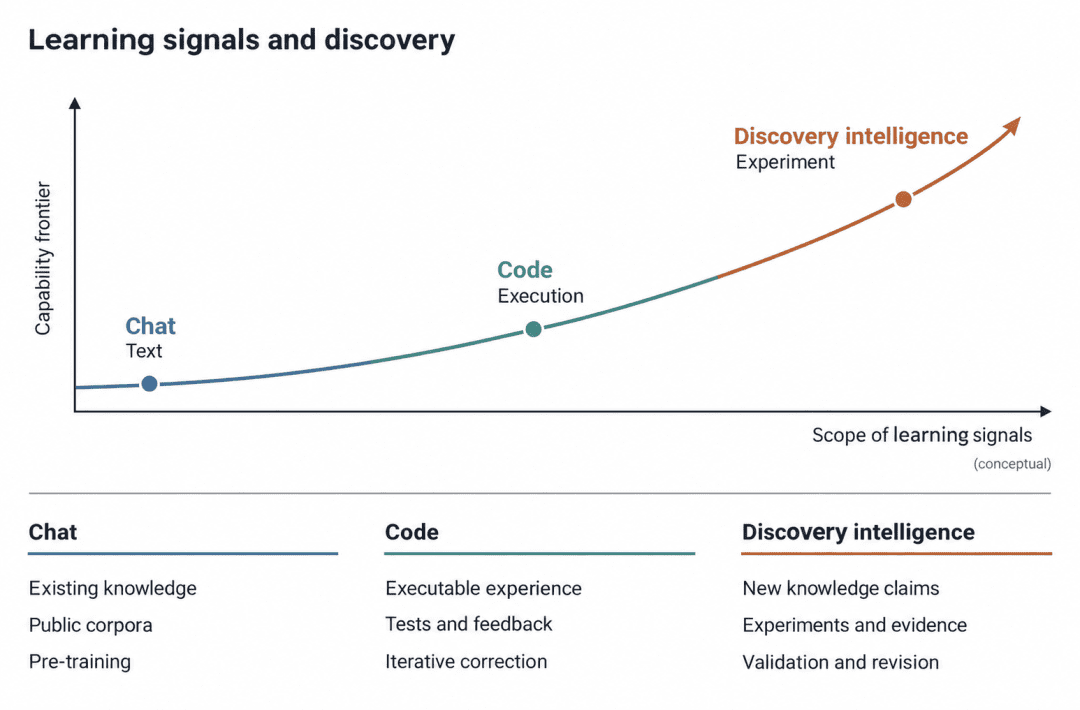
这背后反映了一个更深层的趋势。2022 年底 ChatGPT 刚出现时,人们惊讶于 AI 能写文章、回答问题;随后它开始写代码、调模型;如今,最前沿的实验室正尝试让 AI 参与科学发现——创造连人类也不知道的新知识。
OpenAI 今年 5 月公布了一项由模型完成的数学证明,推翻了近 80 年未解的埃尔德什单位距离猜想。Anthropic 让一群 Agent 自主提出思路、运行实验、比较结果,最终找到的方法甚至超过了人类调优的基线。Google DeepMind 的 Demis Hassabis 更是直接称当下为“科学发现的新黄金时代”。
从 Chat 到 Code 再到 Discovery,变化的不只是任务复杂度,更是 AI 所接触的经验类型:从静态文本,扩展到包含行动、结果与反馈的交互式 experience。但越往未知处走,AI 就越难依赖现成的任务说明。当人类也不知道答案时,AI 该如何选择下一步?又怎样把一次探索中获得的经验,用到下一次研究?
9 月 15 日,新型研究组织 PhAI Labs 发布《Discovery Foundation Models: Toward Open-Ended Discovery Intelligence》技术报告,试图回答这个问题。
科研卡在哪里?
让 AI 进入科学研究,第一个难题就是:真实研究往往没有一套预先写好的任务说明。
Karpathy 今年 3 月开源的 autoresearch 能在明确训练环境中自动修改代码、运行实验,并根据固定指标判断修改是否有效。但在真实科研中,研究者可能连该研究什么、该测量哪些变量都需要反复斟酌。一次实验失败,有时是方法问题,有时是问题本身问错了——而区分这两种失败,恰恰是科研中最难也最有价值的判断。
这些判断很少完整出现在论文里。人们通常只能看到最终结论,却看不到一个假设为何被放弃、一次实验为何失败,以及哪条新证据改变了研究方向。而这些“没被写下来的过程”,正是 AI 学会做科研最需要的学习材料。
目前,产业两端资源其实已经存在:一端是 AI 实验室,提供通用模型、算力和工具;另一端是科学家和自动化平台,拥有真实问题、专业数据和实验条件。但两者之间仍有巨大 Gap:
- 用通用大模型,经验留不下来。科学家会不断追问、修改或否定 AI 建议,但这些反馈散落在聊天记录里,后续实验结果没有返回系统,AI 无法知道自己的哪项建议被证伪。
- 用 AI Scientist,领域换不动。自动研究 Agent 能在计算环境里连续实验,但每换一个领域,工具、数据接口和验证流程都要重配;涉及细胞培养、分子合成等湿实验时,还要解决仪器接入和真实反馈问题。
- 用专用科学模型,预测接不上决策。AlphaFold 能预测蛋白质结构,分子生成模型能设计候选分子,但预测准确不代表能自动回答“改变一个分子会带来什么影响”这类后续问题。
- 就算建起自动化平台,经验也复用不了。哪些方案可先用计算筛选,哪些必须请科学家判断,哪些假设值得投入湿实验——这些选择如何配合,一次研究积累的经验怎样用于其他项目,仍需人工组织。
四个问题指向同一件事:AI 不缺工具,缺的是让判断、证据和经验持续积累的闭环。
构建承载科研经验的基础设施
PhAI Labs 的核心判断是:要让 AI 参与科学发现并实现规模化,缺的不只是更强的模型,还需要一套能够承载科学研究经验的基础设施。
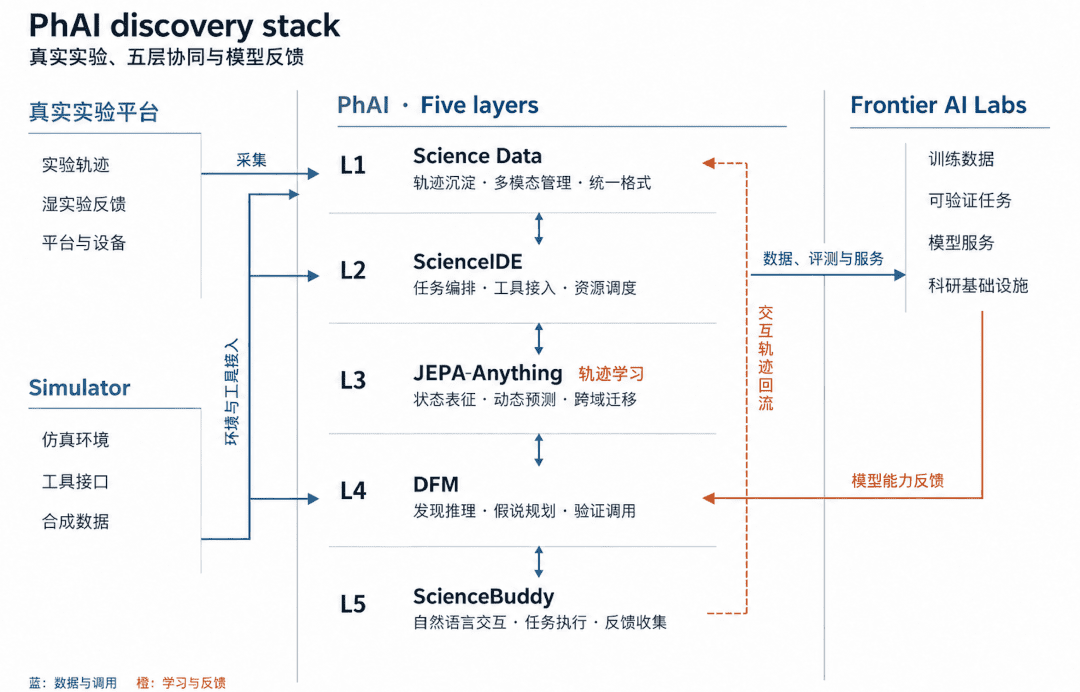
模型会迭代,但研究过程中产生的判断、证据与反馈,需要一个地方沉淀下来。为此,他们提出了一个五层能力体系:
最底层是 Science Data,负责整理科研数据和研究过程。科学家的修改、工具运行结果、真实实验反馈,都需要保留来源和上下文,才能成为后续研究与模型训练可用的材料。
第二层是 ScienceIDE,把科学代码、工具、任务目标和验证标准组织成可执行、可验证、可复用的研究环境,让研究者进入新任务时不必每次从零搭建流程。
第三层是 JEPA-Anything,探索如何预测科学系统在不同条件下的状态变化。例如,采取一种干预或改变实验条件后可能发生什么?这类预测可帮助快速筛选方案,再把更值得验证的假设交给成本更高的湿实验。
第四层是 DFM 核心推理系统,通过多模型协同组织研究过程。它结合基座模型、当前研究状态、记忆和验证机制,决定下一步是修改假设、调用工具、进行预测,还是寻求专家判断与实验验证。
第五层是 ScienceBuddy,负责与科学家的实时交互。研究者的追问、修改、采纳和否定,都可以成为系统改进的依据,并进一步返回数据层。
从数据、环境、预测、推理到交互,这五层让不同速度、不同成本、不同可靠性的反馈得以彼此结合,共同支持一项研究持续推进。
DFM:不只是回答问题,而是学会改变方向
如果说五层体系回答的是基础设施如何组织,那么处于核心的 DFM(Discovery Foundation Models)则回答一个更具体的问题:拿到新证据后,研究该继续往前走,还是回头调整方向?
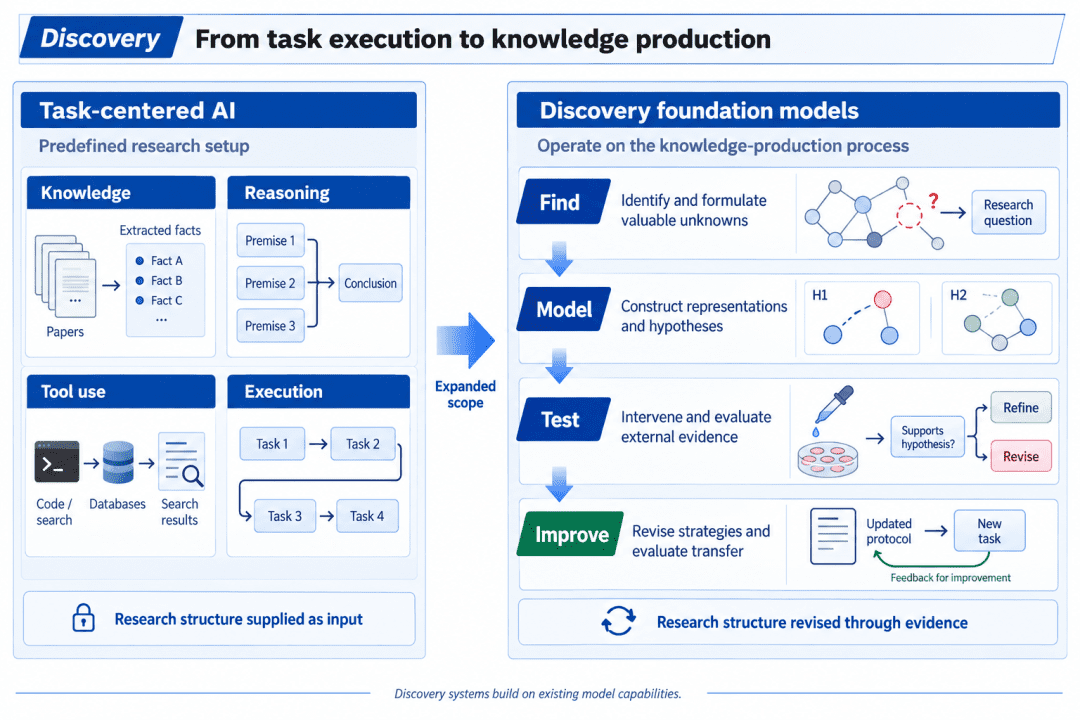
PhAI Labs 将 DFM 定义为一类面向科学发现的通用模型系统。与现有 LLM 不同,DFM 要让 AI 逐步参与三类工作:
- 识别值得研究的未知:把尚未解释的现象转化为可着手研究的问题;
- 构造与修订科学表征:用哪些变量、哪些关系描述研究对象,本身也需要随研究调整;
- 提出假设并调用实验检验:根据证据更新判断,而非仅生成文本答案。
一个完整的 DFM 由基座模型、研究状态、记忆、科学工具、实验环境、验证机制和人类监督共同构成。它不仅学习“得出了什么结果”,也学习“结果是如何被产生和验证的”。这些连续的研究过程被组织为 research trajectory,成为后续形成可复用发现技能的基础。
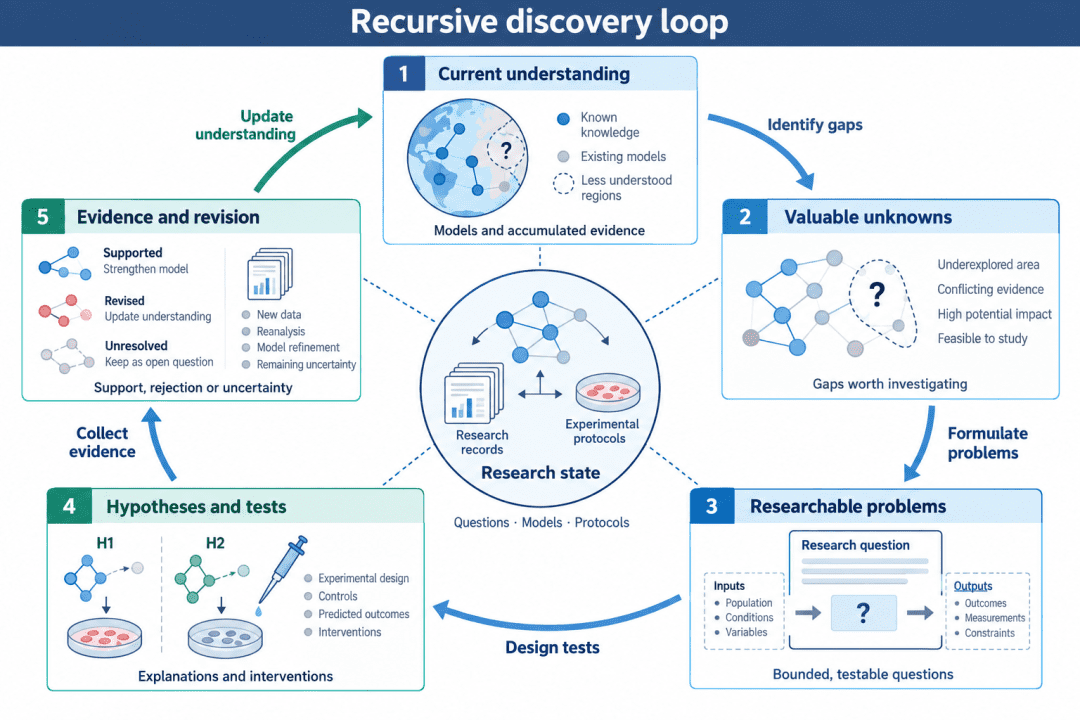
为此,PhAI Labs 提出了 Zetema 参考架构,将当前问题、描述问题的变量与关系、候选假设、已有证据、实验行动和可用资源,组织成一个可持续更新的“研究状态”。
Zetema 想让 AI 学会的,是根据证据改变研究方向。系统可以同时保留几种解释,比较各自依据,再选择最有助于分辨这些解释的下一步实验。当结果与预期不符时,系统不仅要重新生成答案,还需决定是继续收集证据、放弃某个假设,还是重新定义问题。
验证贯穿始终。关键行动需经过逻辑核对、证据来源审查、工具和仿真验证,系统还需主动寻找可能推翻假设的证据,必要时交由人类审批。由此构成一个递归发现循环(Recursive Discovery Loop):新证据改变现有认识,新的认识又影响下一轮提问和实验。
五轮实验里被重新打开的研究方向
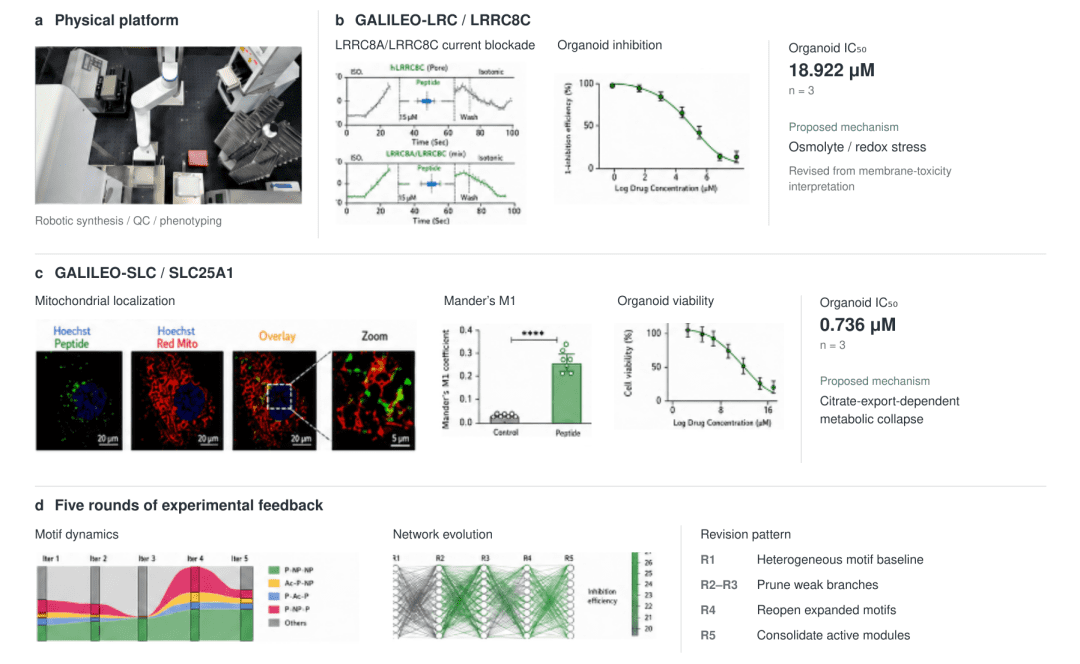
这种“根据证据改变方向”的能力并非纸上谈兵。在一项治疗肽设计实验中,PhAI Labs 的 GALILEO 系统就实际做出过这样的调整。
肽是由氨基酸连接成的短链,其性质取决于选用哪些氨基酸及排列顺序。研究任务是从海量组合中找到具有治疗潜力的候选分子。
GALILEO 先基于已有生物数据选择方向,再检索、修改并设计候选肽。随后,机器人将这些分子实际合成出来,人类团队检查质量并通过成像实验观察作用。实验结果返回后,系统据此调整下一轮设计——哪些值得继续,哪些应放弃,对分子作用方式的解释是否成立,都要重新判断。
在连续五轮设计与实验中,系统先逐步缩小探索范围,放弃了一批缺少证据支持的组合。但到了第四轮,随着对分子作用方式的假设发生变化,系统重新审视了那些早先被排除的设计思路,并将其中一部分重新纳入考虑。换言之,它放弃的不是某条路本身,而只是当时证据下的结论;当证据更新,判断也随之更新。
研究团队还开展了类器官实验——用细胞在实验室培养出的三维结构模拟真实组织,观察候选分子作用。经过五轮湿实验反馈,系统总结出一组用于后续肽设计的经验,涉及分子中亲水和疏水部分如何搭配及平衡。这些经验不是某次实验的结果,而是整个探索过程的产物。
GALILEO 仍是特定领域的案例,但它给出了一个具体起点:AI 提出方案,真实实验提供反馈,系统再从反馈中修改判断、积累经验。接下来要看的,是这种能力能否应用于更多科学问题。
开放合作与下一步
PhAI Labs 已启动 DFM 科学家合作计划,希望与科学家、实验室、科研团队和产业研发团队一起,从真实研究问题出发,将各自领域的研究积累与 AI 研究工程能力结合,共同探索值得追问的问题,并在实际研究中完善工具与基础设施。
9 月 16 日至 18 日,团队还将依次发布 AI 科研搭档 ScienceBuddy、科学集成开发平台 ScienceIDE,以及跨领域统一科学世界模型 JEPA-Anything。
这些设想能走多远,将通过开源研究、科学实验和外部合作一步步验证。
科学有了新的学习者
回到最初的问题:当人类也不知道答案时,AI 该如何继续学习?
答案或许不是让 AI 给出更多答案,而是让它学会人类科学家最艰难的那项本领——根据证据,改变方向,并且让每一次这样的改变都被记录下来,成为下一次研究的起点。
科学本身,就是人类面对未知时发明的学习方法。而它第一次,有了新的学习者。