WorkBuddy 联网三件套:让 AI 助手自己上网查资料、抓数据
为什么 AI 需要“上网”能力
大模型的知识是静态的——它只记得训练截止前见过的内容。一旦你问“今天发布了什么”“这款手机现在多少钱”或者“帮我盯着这个页面有没有更新”,它就只能靠猜,甚至编造答案。这种局限带来三个实际问题:
- 时效性缺失:无法获取训练后的新事件、价格变动或政策更新。
- 事实不可靠:没有来源支撑的回答容易产生“幻觉”,一本正经地胡说八道。
- 无法动手操作:就算知道信息在哪,传统 AI 也打不开网页、填不了表单、抓不到动态加载的数据。
WorkBuddy 的思路不是给模型塞更多参数,而是给它配工具。当任务需要最新信息或交互操作时,AI 可以主动调用网络能力,完成从“查”到“做”的闭环。这套工具被拆成三层:WebSearch(搜)、WebFetch(读)、agent-browser(做)。
三件套能力地图
WebSearch:多引擎实时搜索
WebSearch 是最轻量的一层。它会根据当前时间自动带上上下文(比如年份),发起多引擎搜索,返回整理好的结果块,包含标题、摘要和链接。
适合用来:
- 查找最新行业动态、技术文档或政策文件
- 做竞品初步调研
- 验证某个说法是否有公开来源
它的优势在于快、广、成本低。一次调用就能覆盖多个角度,适合“先搜一轮看看”的宽泛问题。但要注意,它只提供线索,不深入内容。
WebFetch:把网页读成结构化信息
如果说 WebSearch 给你的是目录,WebFetch 干的就是精读。你给它一个具体 URL 和一段抽取提示,它会抓取页面、清理 HTML 噪声、转成干净的 Markdown,再用模型提炼出你要的关键信息。
典型场景包括:
- 从官方文档中提取安装步骤或系统要求
- 抓取商品页面的价格、参数或规格表格
- 对长文章做摘要,或把列表整理成结构化格式
它的特点是准、深、可定向。因为你明确告诉它“我要这个页面里的 X”,它就不会被广告、导航栏或推荐内容干扰。
agent-browser:控制浏览器做真人操作
前两层解决“读”,agent-browser 解决“做”。它内置 Chromium 内核,能让 AI 像真人一样操作浏览器:打开页面、滚动加载、点击折叠面板、翻页、填表、截图,甚至运行自动化测试。
适用情况有:
- 抓取需要登录或动态渲染的内容(比如 SPA 应用)
- 自动填写表单并提交
- 批量采集分页数据
- 需要“看到页面状态”才能继续的复杂任务
这是纯搜索或静态抓取做不到的能力——它真正让 AI 有了“手”。
三者的协作关系与典型工作流
这三层不是互相替代,而是分阶段配合:
先用 WebSearch 找到候选页面 → 再用 WebFetch 精读静态页面拿结构化信息 → 遇到需要交互/登录/动态渲染的,交给 agent-browser 动手操作。
举个例子:你想生成一份主流微服务框架的对比报告。
- WorkBuddy 先用 WebSearch 搜出 Nacos、Consul、etcd 等候选方案。
- 对每个项目的官方文档,用 WebFetch 提取特性、生态支持、适用场景等关键段落。
- 如果某个评测网站需要滚动加载或点击“展开详情”才能看到完整数据,就切换到 agent-browser,让它模拟用户操作,抓取完整内容。
- 最后汇总成一份带来源链接的 Markdown 报告。
整个过程无需人工干预,AI 根据任务复杂度自动选择合适的工具。
实战指令模板(直接复制用)
下面几段指令可以直接发给 WorkBuddy,覆盖三件套的核心用法。
模板一:实时资讯检索(WebSearch)
搜索今天 AI 行业的重要新闻,按“发布机构 + 核心事件 + 影响”整理成 5 条清单,
每条标注大致时间,不要编造来源。模板二:网页精读提取(WebFetch)
打开这个官方文档链接,提取“安装步骤”和“最低系统要求”两节,
整理成要点列表,保留关键参数(版本号、内存、磁盘)。模板三:浏览器自动化抓取(agent-browser)
打开这个竞品官网链接,滚动加载全部产品,提取产品名称、售价、核心功能,
剔除重复产品,整理成 Excel 保存到桌面,并截取产品页截图归档。如果你好奇 agent-browser 背后是怎么实现的,可以用 Playwright 写一个本地等价脚本:
from playwright.sync_api import sync_playwright
url = "https://example.com/products"
with sync_playwright() as p:
browser = p.chromium.launch(headless=True)
page = browser.new_page()
page.goto(url, wait_until="networkidle")
# 模拟向下滚动,触发懒加载
page.mouse.wheel(0, 3000)
page.wait_for_timeout(1500)
# 抽取页面可见文本
text = page.inner_text("body")
print(text[:2000])
browser.close()这段代码模拟了“打开页面→滚动→等待→提取文本”的完整流程。在 WorkBuddy 中,你不需要写代码,只需用自然语言描述目标,agent-browser 会自动完成这些底层操作。
避坑要点
虽然三件套很强大,但也有使用边界,注意以下几点能避免浪费时间和算力:
- 带登录或验证码的页面抓不了:银行、部分后台系统、需要短信验证的页面无法自动通过。遇到这类任务,建议手动提供数据或换用公开来源。
- 海量分页要限流:如果指令是“抓取所有产品”,而页面有上千条,任务可能长时间空转。最好加上限制,比如“最多抓 20 条”或“只抓第一页”。
- 复杂网页先切 Plan 模式:对于需要多步点击、容易加载失败的页面,让 AI 先规划操作步骤(比如“先点 A,再等 B 出现”),再执行,能降低页面状态错乱的概率。
- 抓完及时关浏览器:agent-browser 任务结束后会自动释放资源,但如果频繁调用,仍需留意内存占用。长期运行的任务建议定期重启会话。
- 信源要可追溯:对外输出的内容,尽量保留原始 URL。这样你后续可以快速核对信息真伪,避免被 AI 的幻觉误导。
不是万能,但足够实用
WorkBuddy 的联网三件套,本质上是给 AI 装上了“眼睛”和“手”:
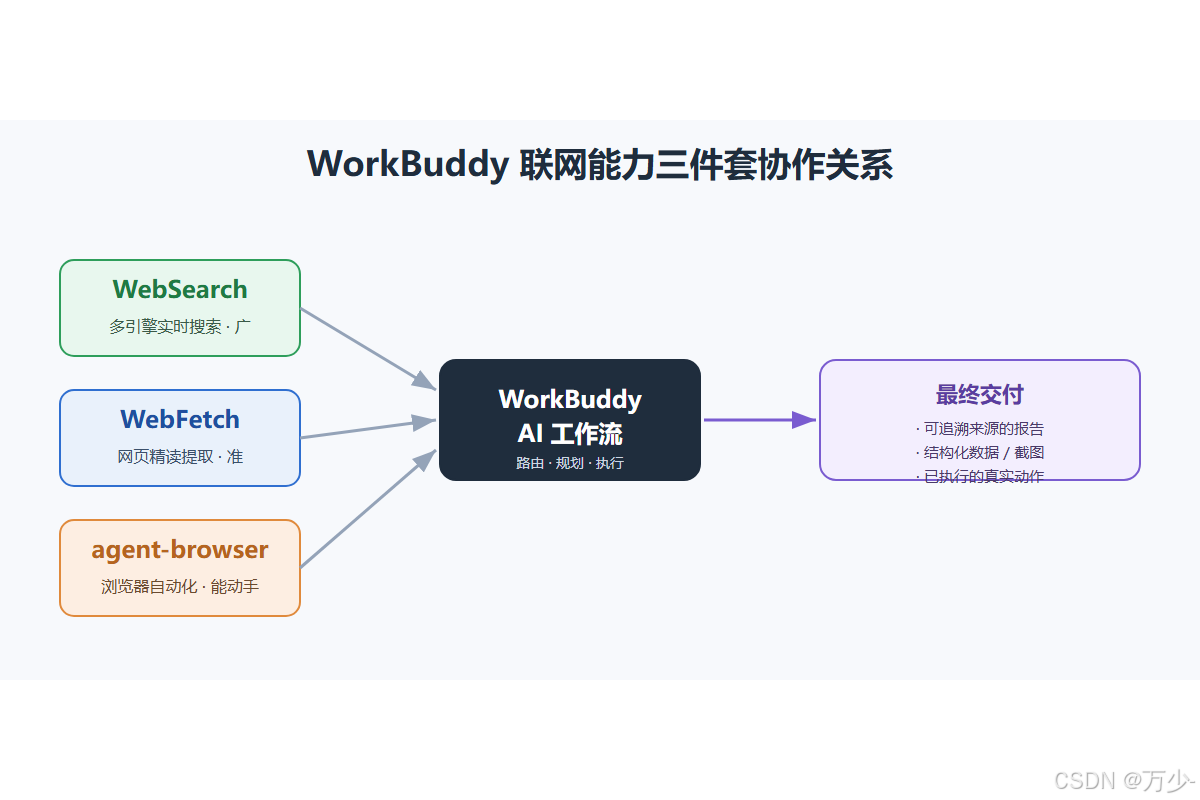
- WebSearch 负责“看得广”——实时、多角度地搜;
- WebFetch 负责“读得准”——从指定页面提取你要的结构化信息;
- agent-browser 负责“动得了”——像人一样操作浏览器完成真实任务。
三者配合,AI 不再只是个“背过书的聊天框”,而是一个能查证事实、能抓取数据、能执行动作的工作搭子。对于经常做调研、盯竞品、采数据或跑自动化的职场人来说,这套组合几乎天天用得上。
当然,它也不是万能的。遇到反爬严格、逻辑复杂的网站,依然需要人工介入。但至少,那些重复、枯燥、规则明确的上网任务,现在可以交给 AI 自动完成了。