2000多个真实场景搬进仿真,一个导航模型零样本适配四种机器人
具身智能的下一关:能力能不能规模化扩展
过去一年,机器人能做的事情明显变多了:走路、跑步、抓取、导航,甚至完成一些长程任务。但把这些能力放到真实开放环境中,一个更根本的问题浮现出来——
机器人“会做”一件事,和它能在各种变化条件下长期、稳定、泛化地把事情做成,其实是两回事。
能跨过固定高度的障碍,不代表换一种障碍还能成功;在一个房间能导航,不代表换一个场景或换一种机器人本体依然有效;正常状态下能行走,也不代表被撞倒或关节损坏后还能继续工作。
随着具身智能从演示走向真实部署,行业关注点正在转移:上一阶段看“会多少技能”,下一阶段则要看这些能力能否持续规模化扩展。
这里的“Scaling”不只是模型参数或数据量的增长,而是指模型能否覆盖更多环境、更多任务、更多机器人本体,并在进入物理世界后,还能适应训练时没见过的状态。
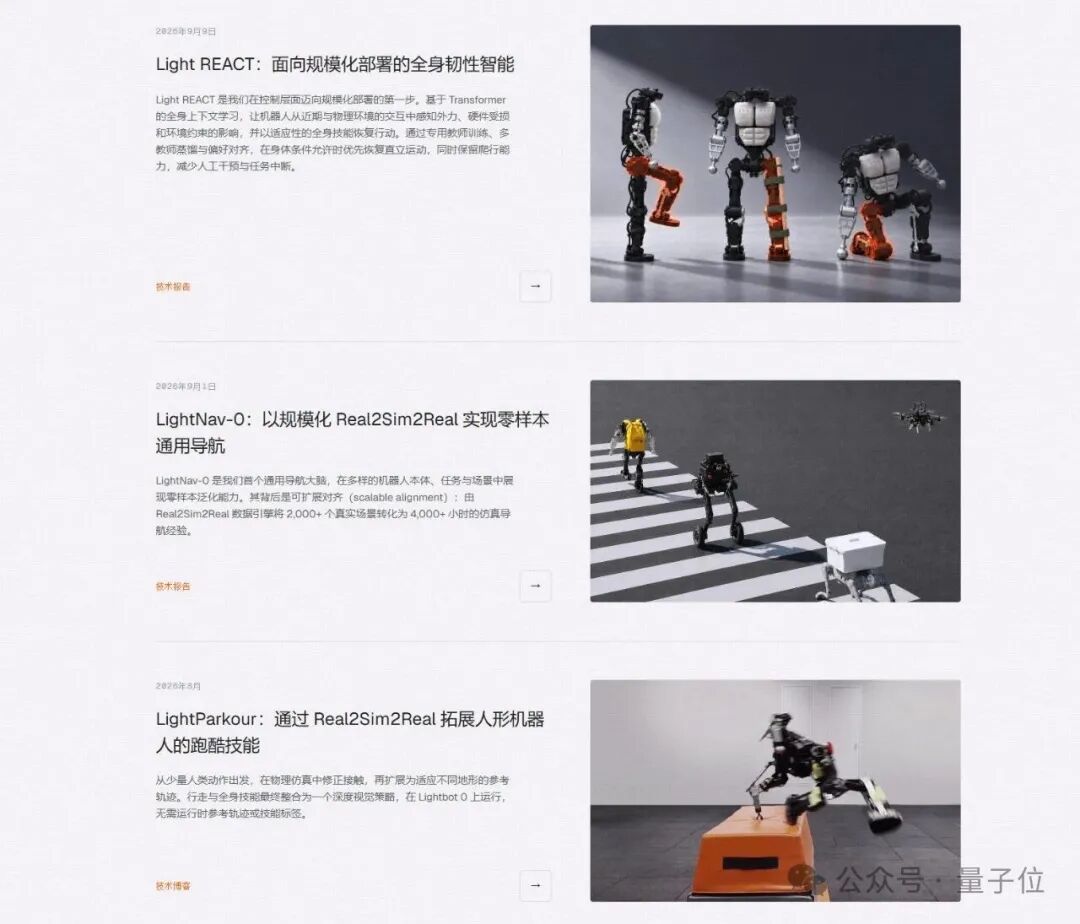
亮源新创在过去一个多月连续发布了三项技术:LightParkour、LightNav-0 和 Light REACT。表面看是跑酷、导航和韧性控制三个方向,实则都在回答同一个问题:如何让Physical AI从单点能力走向可规模化训练、对齐和部署的基础模型体系。
LightNav-0:把2000多个真实世界搬进仿真
导航是机器人进入开放环境的基础能力。但通用导航和传统导航有本质区别:传统系统可以提前建图、依赖高精度定位、针对特定摄像头标定;而面向基础模型的导航系统必须应对不同环境、不同任务、不同视角,甚至不同机器人本体。
问题在于,机器人没有“互联网级”的天然数据源。如果每个新环境、每种新本体都要靠真机遥操作采集数据,成本会线性增长。
LightNav-0的解法是:把互联网中的真实世界,变成机器人能反复经历的训练世界。
通过自研的Real2Sim2Real数据引擎,团队将2000多个来自互联网的真实室内场景(如房屋、办公室、商场)转换为可交互、可复用的物理仿真环境。在这些环境中,系统自动生成不同目标、不同路径、不同视角的导航轨迹,最终积累出4000多小时的视觉、语言与动作联合经验。
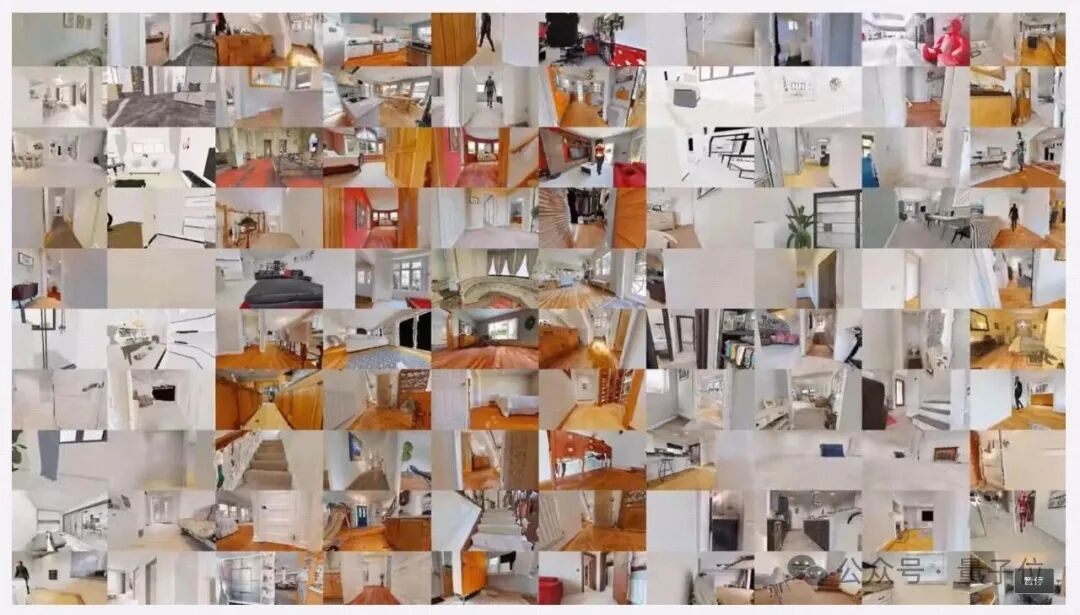
值得注意的是,实验发现:扩大环境覆盖度比在相同环境里堆砌轨迹数量更能提升泛化能力。这意味着Physical AI的数据Scaling不仅要看“量”,更要看“多样性”。
导航不是识别目标,而是理解空间后产生动作
有了大规模数据,下一步是如何把视觉和语言理解真正转化为行动。
比如指令是“走到沙发右边”,识别“沙发”不难,难点在于判断沙发在哪、右边是哪、哪里能走,以及生成合理的运动轨迹。
LightNav-0引入了Point CoT(Point Chain-of-Thought)机制。模型先在图像空间预测目标点和可通行区域,再基于这些空间信息生成后续动作。这一中间推理步骤让整个过程从“视觉+语言→动作”变为“视觉语言理解→空间推理→动作生成”。
在8项公开消融实验中,加入Point CoT后,平均任务成功率提升8.4个百分点,路径效率(SPL)提升5.7个百分点。
为了统一训练框架,团队还设计了RVQ动作编码器,将连续的机器人轨迹压缩为3个离散动作token。这样,视觉、语言、空间位置和动作就能进入同一个模型进行端到端训练——这本质上是在为Physical AI建立统一表示,就像大模型统一不同语言任务一样。
零样本迁移到四种机器人本体
真正的考验不在训练集,而在迁移能力。
LightNav-0在10个仿真设置中验证了指令跟随、目标导航和具身视觉跟踪等任务。更重要的是,在真实机器人部署中,同一个模型无需微调,直接零样本迁移到人形、四足、轮式和飞行机器人四种不同本体。
这意味着模型学到的不是某种特定机器人的运动模式,而是更底层的空间智能:理解环境结构、解析语言指令、推理可行路径,并输出适配当前本体的动作。
官方同步开源了模型、代码和技术报告,重点验证的就是这种跨环境、跨任务、跨本体的泛化能力。
LightParkour:从一个动作种子长出一类技能
如果说LightNav-0解决的是“去哪里”,LightParkour解决的则是“怎么动”。
跑酷涉及复杂接触:手撑桌面、脚蹬台阶、身体越过障碍。传统动作模仿的问题在于,人类视频只记录了“怎么动”,没说明“为什么这个动作在这个环境下成立”。直接重定向到机器人,容易出现手掌悬空、身体穿模或超出动力学极限。
LightParkour的做法很巧妙:只给一个起点,让技能自己生长。
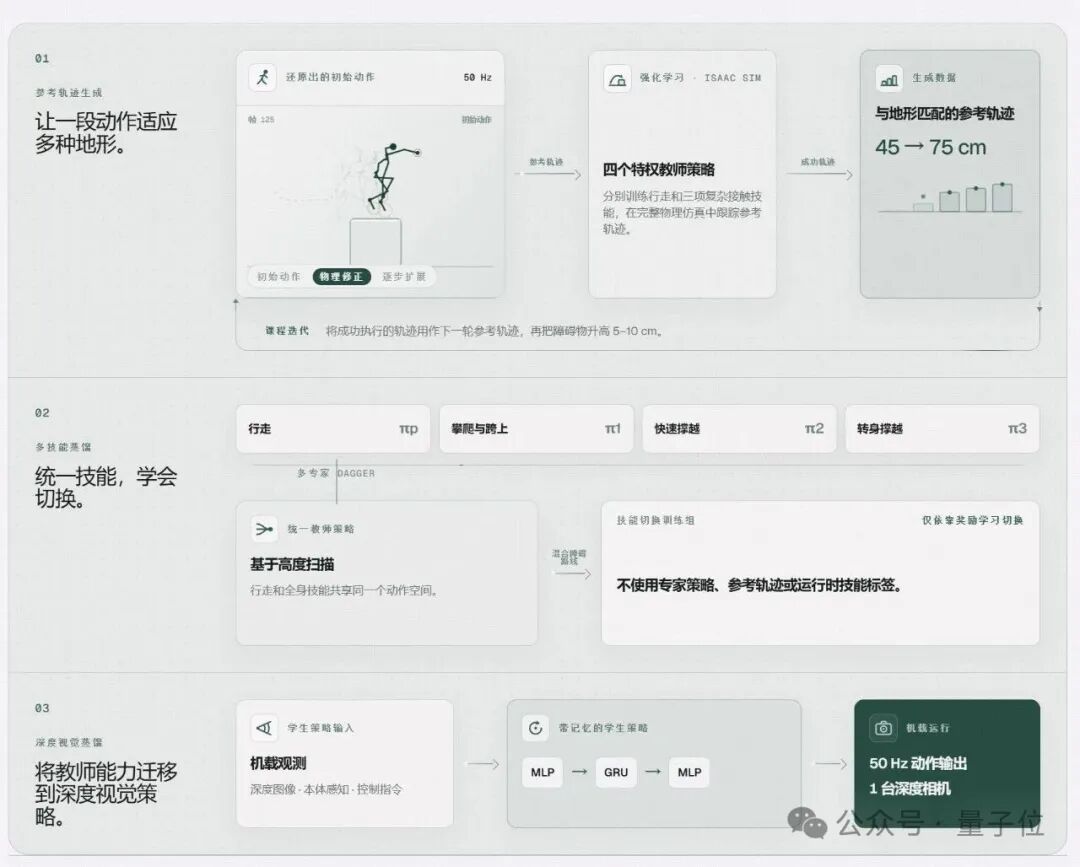
系统先从一段真实人类动作中提取简短的“动作种子”(比如跨越45厘米障碍),再将其与对应障碍物一起放入物理仿真。仿真负责重建动作、接触力、障碍几何与机器人执行器之间的物理一致性。一旦成功,系统自动提高障碍难度,并将成功轨迹作为下一轮训练参考。
最终,从45厘米的初始动作出发,模型学会了跨越高达75厘米的障碍(约为Lightbot 0身高的83%)。整个过程中,只有最初的动作需要人工对齐,后续扩展完全由物理仿真和课程学习驱动。
关键突破在于:一个动作样本变成了一个技能分布。能力不再和人工数据一一绑定,而是利用物理规律自动生成新经验。
统一策略:多个技能压进一个模型
会很多动作还不够,得知道什么时候用哪个。
如果行走、攀爬、撑越各是一个独立模型,机器人就需要上层调度系统决定调用哪个——这又回到了传统模块化架构的老路。
LightParkour通过多专家蒸馏,把行走和三项复杂接触技能整合进一个统一策略。更进一步,系统还训练了技能间的自主切换能力:模型自己判断何时保持行走、何时进入全身动作、何时退回常规运动。
部署时,不需要外部提供技能标签,也没有人工编写的状态机。最终运行的是一个统一的循环深度视觉策略,仅依赖胸前深度相机、本体感知和速度指令,在机载平台以50Hz实时运行,无需参考轨迹或外部状态估计。
这标志着能力从“会跑酷”升级为“能根据环境自主组合运动能力”。
Light REACT:当机器人自己也变了
即使技能和导航都解决了,真实世界还有最后一道坎:机器人自己的身体会变。
可能被撞、可能跌倒、关节可能锁死、执行器可能失效。这些异常在单次实验中不多见,但部署规模一大,发生频率就不可忽视。如果每次故障都要人工干预,运维成本会迅速失控。
Light REACT(REsilient humAnoid ConTrol)的目标不是维持标准步态,而是在身体受损后,尽可能利用剩余能力继续移动:能走就走,能跛行就跛行,单腿跳也行;实在站不起来,就用手臂支撑切换到爬行。核心目标始终如一:在当前身体条件下完成移动。
不靠故障标签,靠历史交互推断状态
传统做法是为每种故障预设控制器,但真实部署中,机器人往往不知道自己哪里坏了。
Light REACT的核心机制是全身上下文学习(Whole-Body In-Context Learning)。训练时,系统针对执行器失效、关节锁定、膝部折叠等三类损伤,分别训练多个“教师策略”。然后通过多教师蒸馏,将这些能力整合进一个“学生策略”。
但到了部署阶段,故障标签被拿掉。模型只能看到本体感知、动作指令和过去一段时间的身体响应。它必须从这些交互历史中推断:“我现在是不是腿坏了?还能不能站?”
团队比较了MLP、RNN和Transformer三种结构,发现使用64帧因果上下文窗口的Transformer能最充分覆盖教师策略的行为能力。
对齐:不只是会,还要用得合理
蒸馏之后又出现新问题:模型虽然会走、会跳、会爬,但不一定知道何时该用哪种方式。有时明明能站立,却直接趴下爬行——虽然能完成任务,但不符合真实场景的合理性。
于是团队引入偏好强化学习(Preference RL),对行为调用方式进行对齐。目标很明确:身体允许时优先直立运动,只有无法维持时才切换到爬行。
结果显著:公开实验中,直立行为比例从42%提升到76%,爬行行为从45%降至16%。
这一步很像大模型的对齐——预训练决定“会什么”,对齐决定“什么时候该怎么做”。在Physical AI中,这种对齐从语言偏好扩展到了空间、动作和身体状态。
三段范式:从技术判断到研发体系
回头看这三项技术,脉络清晰:
- LightParkour 解决技能Scaling:从单点动作扩展为环境自适应的技能分布,再蒸馏为统一策略;
- LightNav-0 解决经验Scaling:将2000+真实场景转化为4000+小时训练数据,实现跨本体零样本导航;
- Light REACT 解决部署韧性:在扰动和损伤下,基于历史交互调整行为,减少人工介入。
它们共享一个思路:扩大训练状态分布,用强化学习生成新经验,尽量减少部署时对人工规则和预定义标签的依赖。
这正对应亮源新创提出的“三段范式”:
- 规模化预训练:利用互联网视频、多模态数据和物理仿真,建立基础能力;
- 规模化对齐:通过强化学习、蒸馏和偏好优化,提升物理世界中的行动能力;
- 规模化部署:在真实环境中持续运行,并将产生的数据(包括异常)回流到训练体系。
三者形成闭环:部署产生的真实世界经验,反过来拓展训练数据的状态覆盖,推动模型迭代;模型能力提升后,又能部署到更多本体、更多场景,产生更多数据。
真正的竞争:谁能跑通这个闭环
现在评判一家Physical AI公司,不能只看它有没有炫技Demo,而要看背后的学习系统是否完整:
- 能不能把一个样本扩展成一类技能?
- 能不能把多个专家压缩成一个统一模型?
- 能不能跨环境、跨本体泛化?
- 能不能从自身行为结果中继续学习?
- 能不能在身体状态变化后仍完成任务?
- 最重要的是,能不能把真实部署的经验送回训练体系?
从LightParkour到LightNav-0再到Light REACT,亮源新创正在逐层验证这条路径。这不是在做一个功能叠加的机器人产品,而是在构建一个从数据、训练、对齐到部署的完整Physical AI能力栈。
大模型的竞争证明,智能可以随数据和算力持续增长。而Physical AI的挑战更难:当模型真正拥有身体、进入现实世界后,这套Scaling逻辑还能不能成立?
亮源新创的答案是:把闭环跑起来。