智谱335亿元融资押注GLM-6.0:完全自训练技术细节首度披露
335亿元砸向“完全自训练”
智谱还没发布GLM-6.0模型和论文,却先在财务公告里把技术路线剧透了个底朝天。
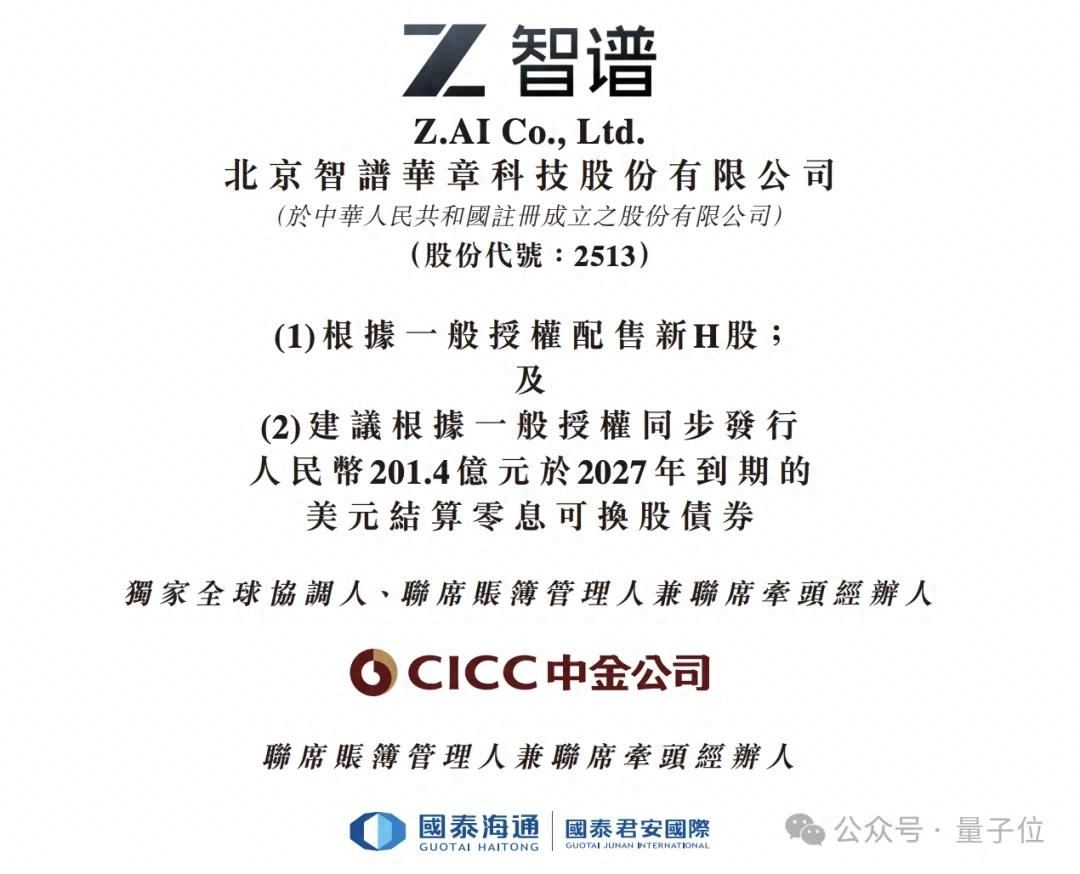
2026年9月12日,智谱在港交所发布公告,宣布通过配售新H股加发行201.4亿元人民币零息可转债,合计预计净募资约393亿港元(约合335亿元人民币)。这笔钱怎么花?公告写得明明白白:约60%——也就是235亿港元左右——将全部投向下一代GLM基础模型及其“完全自训练”体系的研发,并配套大规模训练、推理和算力基础设施的部署与升级。
“完全自训练”(Fully Self Training)是智谱对“递归式自我改进”(Recursive Self-Improvement, RSI)的具体技术表述。简单说,就是让模型自己养自己:上一代GLM搭建训练环境,下一代GLM就在这个环境里成长,形成一个闭环。这个闭环包含三个关键动作:数据自产、环境自造、基础设施自我优化。
数据不再靠人标,模型自己“生”
过去大模型训练严重依赖人类标注数据,成本高、规模有限、还容易引入偏见。智谱的“数据自产”方案试图绕开这条路。
具体做法是:让多个模型实例之间进行自我对弈,比如一个模型出题、另一个解题,再由第三个模型评审答案质量;或者让模型根据规则生成数据后自行校验逻辑一致性;还可以让模型执行某个任务(比如写一段代码),再自动验证这段代码是否能跑通。这些过程中产生的高质量样本,经过少量人工抽检确认后,就会回流到预训练、中训练和后训练的各个阶段。
这种方式的好处是数据可以无限扩展,而且天然贴合模型当前的能力边界——不会出现“教小学生微积分”那种错配。更重要的是,它让数据生产变成了一个可规模化、自动化的流程,而不是靠外包团队熬夜标注。
智能体自己造任务环境
光有数据还不够,模型需要在真实或模拟的任务环境中锻炼。传统做法是人工设计评测集或游戏环境,但覆盖面窄、更新慢。智谱提出“环境自造”:让智能体自己去采集和转化现实世界中的任务。
举个例子,一个智能体可能会尝试完成“预订下周三从北京到上海的 cheapest 航班”这个任务。它会自己调用航班查询API,解析结果,比较价格,甚至处理支付失败等异常情况。在这个过程中,它不仅完成了任务,还自动生成了一个结构化的任务描述、一套验证器(比如检查最终订单是否真实存在)、以及任务是否可解的判断标准。
这些任务单元会被积累下来,变成可复用的训练资源。随着时间推移,任务库会越来越丰富,覆盖金融、医疗、编程、客服等多个专业领域。智谱的目标是让任务环境像数据一样,成为“可规模化生产及复用的训练资源”。
连算力系统都让模型自己优化
最激进的部分是“基础设施自我优化”。既然现在的模型已经能写代码、调参、甚至设计简单算法,为什么不让它帮忙优化自己赖以运行的底层系统?
公告提到,智谱将利用模型在编码和系统工程方面的能力,协助开发和优化训练及推理系统的算子、内核、调度策略、缓存机制和服务栈。比如,模型可以自动为特定硬件(如国产AI芯片)生成高效的矩阵乘法算子,或者根据负载动态调整分布式训练的通信策略。
这种“模型参与基建”的思路,本质上是在构建一个正反馈循环:更好的基础设施 → 更快的训练速度 → 更强的模型 → 更优的基础设施代码 → …… 最终可能让整个AI研发链条的效率大幅提升。
模型能力方向也定了
除了训练方法,公告还预告了GLM-6.0的能力重点。
首先是提升“有效规模”——不是单纯堆参数,而是在不过度增加推理成本的前提下,加深有效计算深度。这意味着模型能处理更长链条的推理、规划和自我校验,比如一步步拆解复杂问题、中间结果反复验证、最后输出可靠结论。
其次是原生多模态统一建模。不是简单拼接文本和图像编码器,而是让模型在底层就共享同一套表示空间,实现真正的跨模态理解与生成。
第三是长程任务强化学习。智谱计划建设贴近真实专业工作的任务环境(比如完整的软件开发流程、科研文献综述、法律合同审查),训练模型学会拆解任务、调用工具、与环境交互、从错误中恢复、并验证最终结果是否达标。
算力:多元供给+自研引擎
钱要花,算力得跟上。公告特别提到,当前市场上“优质算力资源的供给及交付条件较为有利”,智谱将综合推进采购与租赁,同时投入芯片适配、算子开发、集群互联和性能调优,建立来源多元且可灵活调配的算力供给体系。
自研推理引擎也在投入清单里。这套服务栈将覆盖多模态编码、提示词预填充、逐Token解码、量化压缩、KV缓存管理、节点间通信及弹性扩缩容等环节。目标很直接:在同等硬件条件下,提升推理吞吐量,降低单位请求成本。
上市八个月,三轮融资755亿港元
这次融资不是孤立事件。回看时间线,智谱自2026年1月8日在港股上市以来,已经完成了三次大额募资。
首次是IPO,以每股116.20港元发行约4304万股H股,净募48.96亿港元。这笔钱到2026年8月底已全部花完。
第二次是2026年7月9日的配售,股价飙到1588港元(较IPO涨13.7倍),发行1978万股,净募313.75亿港元。截至8月底,已动用约109.55亿港元,剩余204.2亿。
第三次就是本次9月12日的融资。此时H股收盘价已回落至793港元,配售价定为714港元,明显低于7月高点。公告解释称,因业务进展加快,“原有募资计划下的资金使用节奏相应提速”,而算力从签约到部署需要周期,所以提前锁定资金以匹配扩张节奏。
三次合计,智谱上市后累计净募资已达约755亿港元(约646亿元人民币)。
A+H上市计划浮出水面
公告还有一个细节值得注意:可转债条款明确说明,“不会因本公司目前预期将于上海证券交易所科创板上市的股份的首次公开发行”而对换股价作出调整。
这等于间接承认了“A+H”双上市计划的存在。智谱可能正在筹备科创板IPO,而港股投资者无需担心A股发行稀释他们的权益。
钱怎么分?
除了60%投向核心技术,剩余资金也有明确用途:
- 约15%(59亿港元)用于业务拓展、战略投资和潜在并购。投资标的需满足:与AI技术强相关、有稳定用户群且经营满两年、具备成熟产品平台和持续研发能力。方向包括大模型、智能算法、算力运营、AI平台、智能体及AI赋能应用。
- 约25%(98亿港元)用于优化资本结构和补充运营资金。
全部募资预计在2028年6月30日前悉数动用。也就是说,未来不到两年,智谱要把近400亿港元花出去,压力不小。
技术豪赌还是务实布局?
“完全自训练”听起来很理想,但实际落地难度极高。数据自产如何保证质量不退化?环境自造能否覆盖足够多的真实场景?模型优化基础设施会不会陷入局部最优?这些都是未知数。
但换个角度看,智谱的选择也很务实。与其在人类数据红海里卷标注质量,不如开辟一条自动化飞轮的新路。如果真能跑通,不仅技术领先,成本结构也会大幅优化——毕竟人力是最不可控的变量。
现在的问题是,市场愿意给它多长时间验证?从股价从1588港元跌到793港元来看,投资者已经开始变得谨慎。好在智谱手握巨资,至少在未来两年内,不用为钱发愁。