浙大、上交团队提出 Deep Academic Survey:AI 一小时内自动生成可发表综述
高质量综述难写,AI 能帮上忙吗?
学术文献数量爆炸式增长,研究者想快速了解一个新领域,最高效的方式往往是读一篇好的综述。但写综述本身却是个苦差事——要读上百篇论文,理清发展脉络,还要准确归类、合理引用,最后组织成逻辑严密的长文。这个过程动辄数周甚至数月。

大模型出现后,不少系统开始尝试自动生成研究报告。它们能检索论文、提取信息、写出几万字内容,看起来效率很高。但仔细对照真正发表在期刊上的学术综述,就会发现差距不小:结构松散、分类模糊、引用堆砌、图表与正文脱节,更别提最终能否顺利编译成规范的PDF。
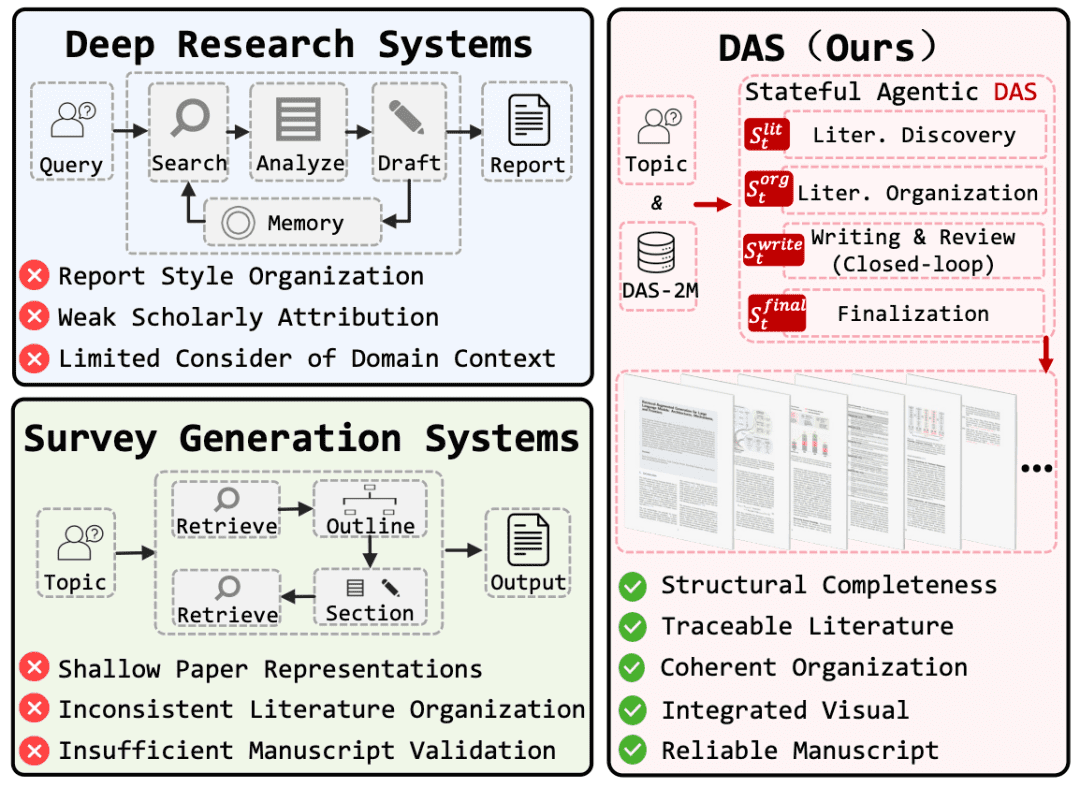
问题出在哪?关键在于,写综述不只是“多读多写”,而是一套严谨的知识组织工程。你需要决定怎么划分研究方向(Taxonomy),每篇论文该放在哪个章节,某个观点该由哪些文献支撑,以及如何保证全文引用、图表、交叉引用的一致性。
针对这些痛点,浙江大学 APRIL 实验室联合上海交通大学等团队提出了 Deep Academic Survey(DAS),目标很明确:让 AI 在 1 小时内自动生成一篇面向发表的学术综述。
先读懂200万篇论文,再谈写综述
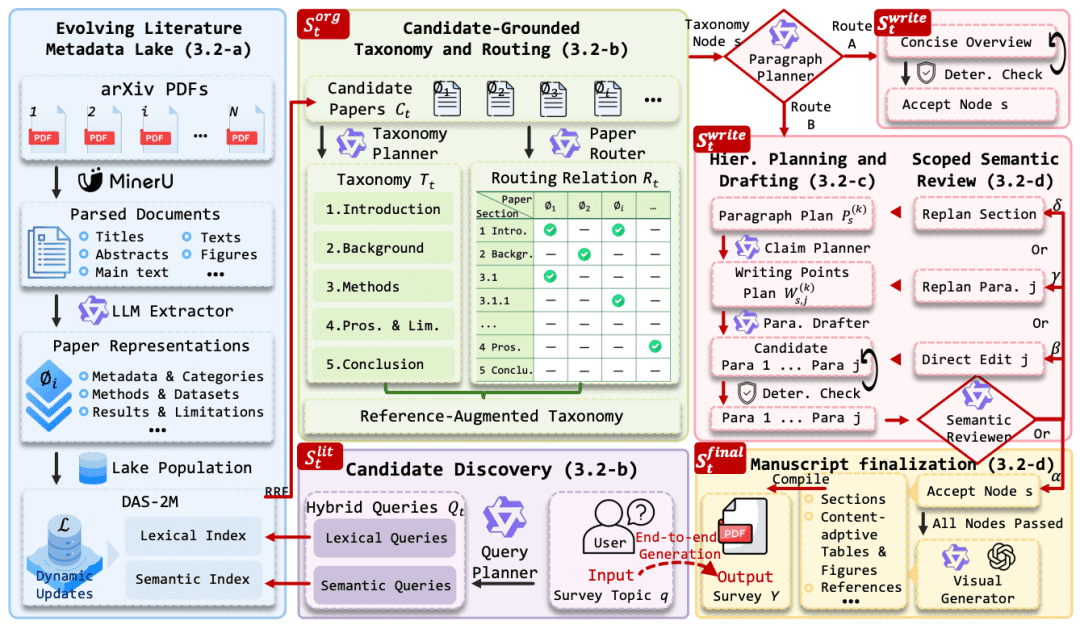
DAS 的第一步不是急着写,而是先建一个扎实的文献底座——DAS-2M Literature Metadata Lake。
团队对 2020 年 1 月以来近 200 万篇 arXiv 论文进行了全文解析,利用大模型提取结构化元数据,包括每篇论文的方法、使用的数据集、主要实验结果、创新点和局限性等。这些信息被整理成一个可查询、可复用的元数据湖,并已开源到 Hugging Face。
这相当于提前对海量论文做了一次“预理解”。相比传统方法只依赖标题和摘要,DAS-2M 能更精准地判断一篇论文到底讲了什么、适合用在综述的哪个部分。更重要的是,一篇论文只需解析一次,就能被多个不同主题的综述重复调用。随着新论文不断发布,系统还会持续更新这个元数据湖,确保 DAS 始终能追踪最新进展。
有了这个底座,DAS 才能进行下一步:当用户输入一个主题(比如“扩散模型在医学图像生成中的应用”),系统会从 DAS-2M 中检索出相关候选论文,然后基于这些论文构建一个有据可依的分类体系(Candidate-Grounded Taxonomy)。
不是流水线,而是闭环智能体
传统自动综述系统通常是“检索—分析—写作”的线性流程。DAS 则完全不同——它采用 Stateful Agentic Closed-Loop Manuscript Construction 框架。
简单说,整个过程围绕一个不断演化的 Manuscript State(手稿状态) 展开。这个状态包含候选论文集合、分类结构、每篇论文应归属的章节(通过 Reverse Paper-to-Section Routing 确定)、段落规划、观点主张(Claim)及其对应的引用组(Citation Group)。
写作不是从零开始,而是在这个共享状态下逐步细化。DAS 会先做分层规划:从整体 Taxonomy,到每个章节的段落大纲,再到每个段落要表达的核心观点,最后才确定每个观点该由哪几篇论文支撑。引用不是事后补的,而是在观点形成之初就绑定好。
写完初稿也不代表结束。系统内置两个审查模块:
- Semantic Reviewer:检查章节目标是否达成、逻辑是否连贯、引用是否充分支持论点;
- Deterministic Validation:验证引用标识符是否正确、交叉引用是否匹配、LaTeX 语法是否合规、能否成功编译。
如果发现问题,系统不会简单重写全文,而是根据问题粒度执行 Direct Edit(直接修改)、Paragraph Replan(段落重规划)或 Section Replan(章节重规划),然后再次审查。这个 Generation → Review → Repair → Re-evaluation 的闭环,确保最终输出的手稿在结构和细节上都足够可靠。
效果如何?220 篇综述已公开
光看指标不够直观。DAS 团队在 DAS-Bench 的 30 个综述主题上进行了评测,从 Citation、Taxonomy、Discourse 和 Manuscript Reliability 四个维度打分,DAS 平均得分为 4.34,显著高于最强基线(4.03)。在专家匿名偏好测试中,DAS 在 27/30 个主题上优于 Naive RAG,在 19/21 个计算机科学共享主题上优于 AutoSurvey。
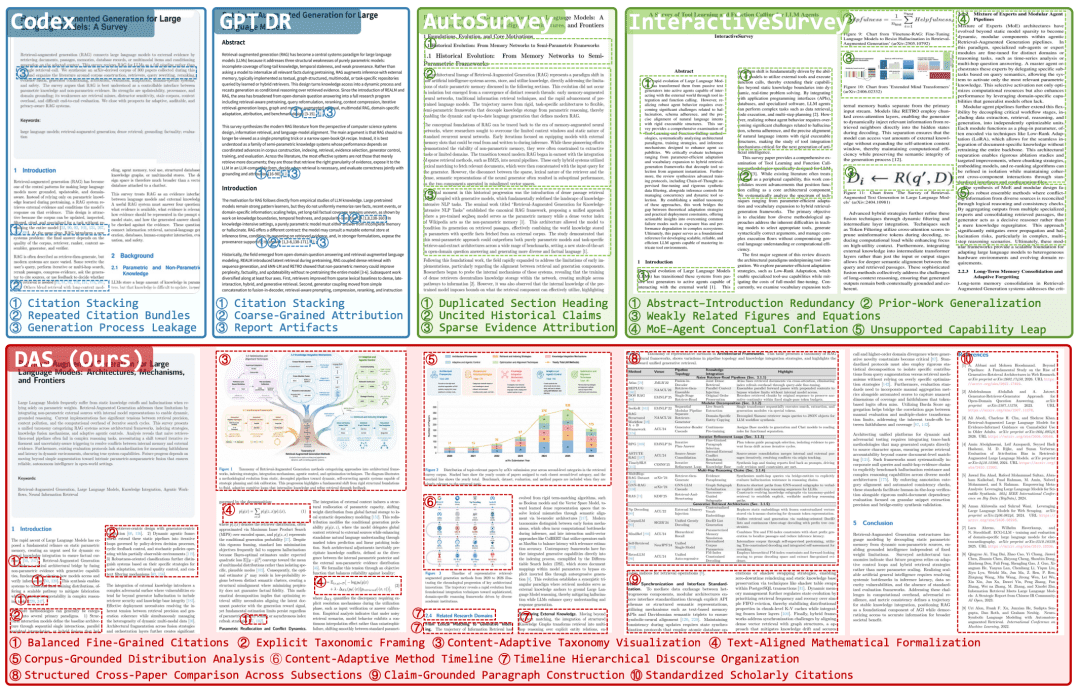
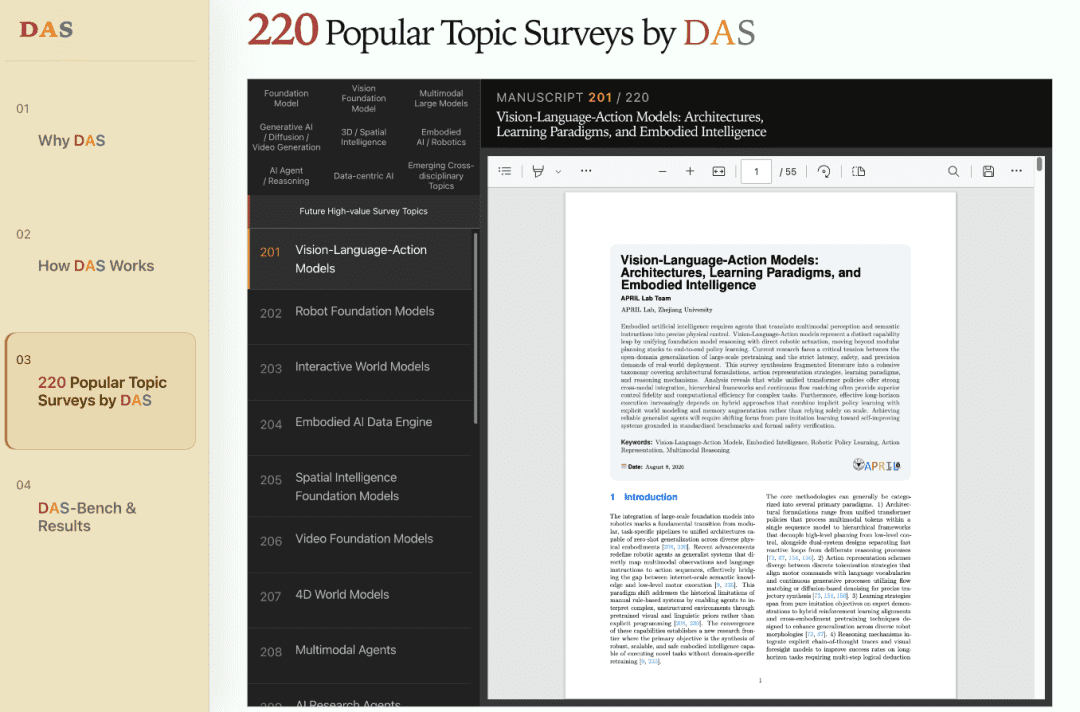
更实在的是,项目官网已经开放了 220 篇热门研究方向的完整综述 PDF,涵盖人工智能、机器学习、计算机视觉等多个领域。你还能在同一页面看到 Codex、GPT Deep Research、AutoSurvey 等其他方法的生成结果,直接对比差异。
比如,有些系统容易出现“引用堆砌”——一段话后面跟十几篇参考文献,但实际只有两三篇真正相关;或者图表是通用模板,和正文内容脱节;又或者整篇综述结构重复,每个小节都是“介绍—方法—实验”的固定套路。而 DAS 生成的综述在这些方面表现更接近人工撰写:引用精准、结构灵活、图表与论述紧密结合。
距离真正“写完”还有多远?
需要强调的是,DAS 的目标是“面向发表”,而不是“直接替代人类投稿”。生成的综述仍需研究者核验,尤其是在专业判断和批判性分析方面。此外,学术综述本身的评价标准也存在主观性,不同评审专家对同一份综述的细粒度打分可能有差异,论文中的跨评审实验也证实了这一点。
但 DAS 探索的方向很有价值:AI 不应只是生成长文本的工具,而应成为可追溯、可修正、可持续更新的知识组织助手。随着 DAS-2M 元数据湖不断扩充,未来还可以支持动态追踪新论文、人机协同修改综述,甚至构建“活”的综述文档——当领域有重大进展时,系统能自动提示更新相应章节。
说到底,DAS 想回答的问题不是“AI 能不能写出一篇很长的文章”,而是:面对指数级增长的学术知识,AI 能否帮研究者更快进入新领域,并持续、可靠地组织和理解这些知识?
目前,论文、代码、数据集和生成的综述均已公开,感兴趣的研究者可以直接访问项目网站体验。