小模型自己决定何时呼叫大模型,推理成本直降96%
小模型先干,干不动了再叫大模型帮忙
顶级 AI 越来越强,但账单也越来越吓人。以 Astra API 为例,标准模式下每百万 token 输入 10 美元、输出 50 美元;一旦请求超过 27.2 万 token,价格直接翻倍。相比之下,一个 4B 的小模型输出成本可能低至 0.08 美元——相差上千倍。
面对这种局面,火思动力(Pyromind)开源的 PyroDash 给出了一个反直觉的答案:让小模型自己决定什么时候该呼叫大模型。
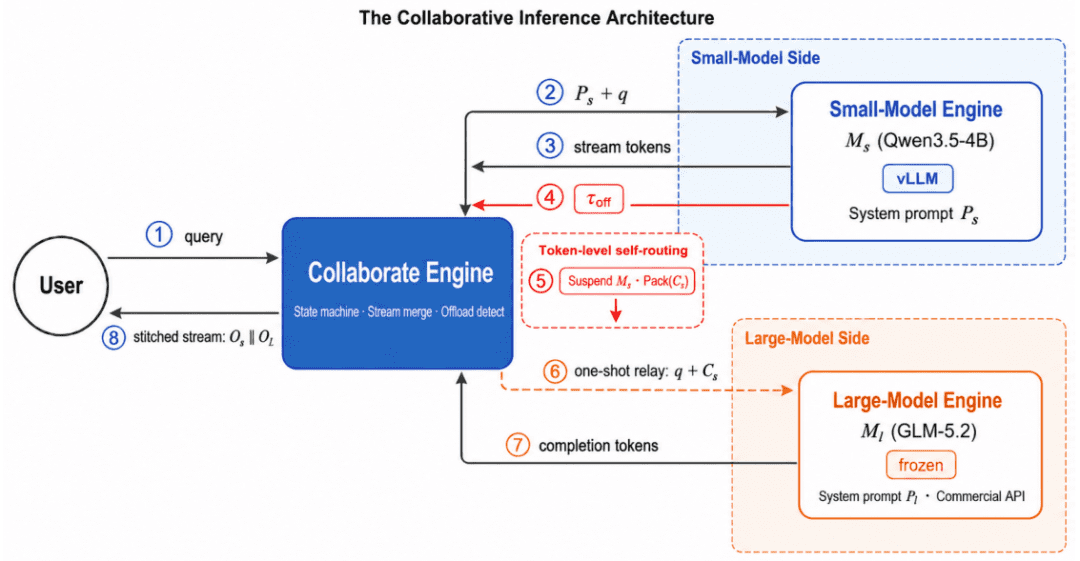
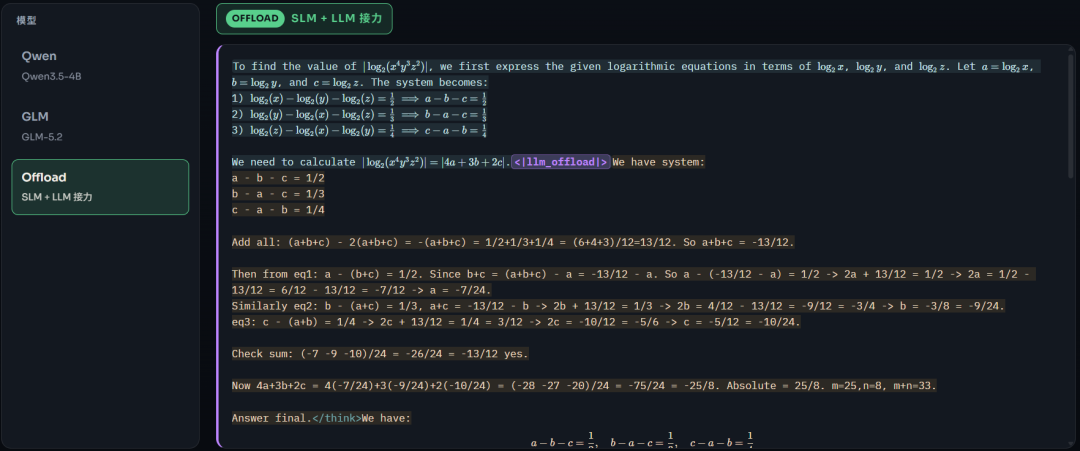
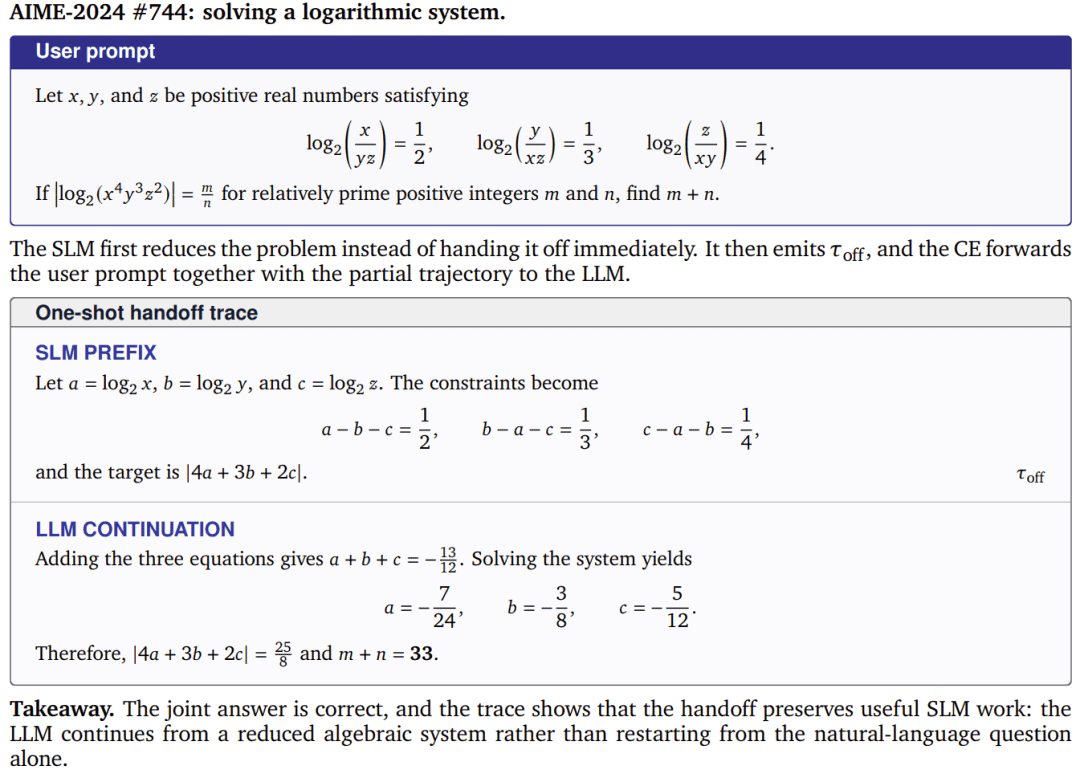
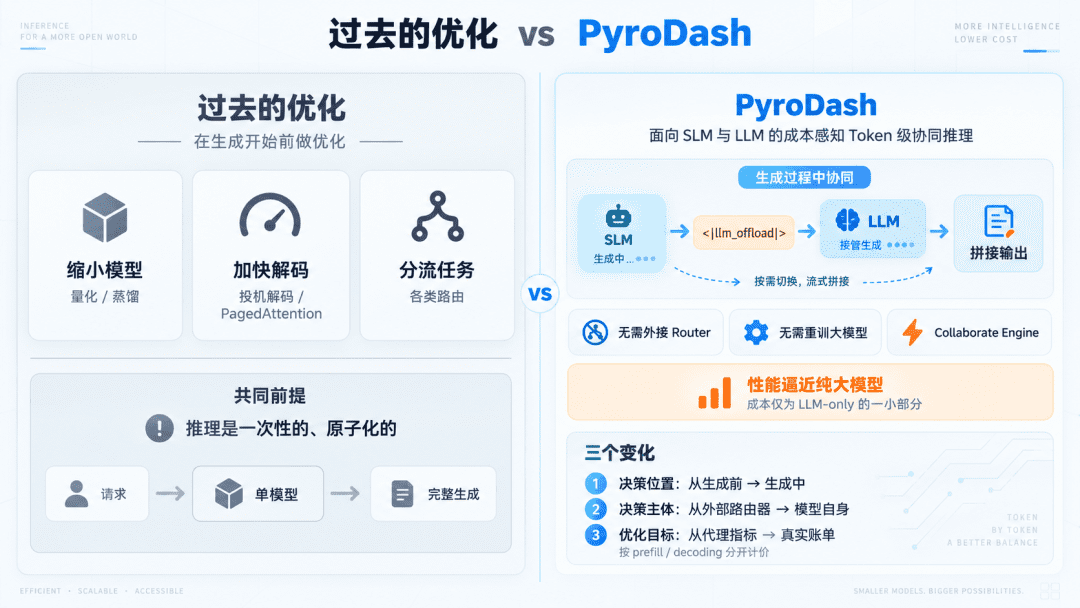
这套系统的核心逻辑很简单:小模型优先处理请求,如果它觉得自己搞不定,就发出一个特殊信号,把当前已有的推理轨迹交给大模型续写。整个过程单向、至多一次交接,且大模型全程冻结,无需额外训练。
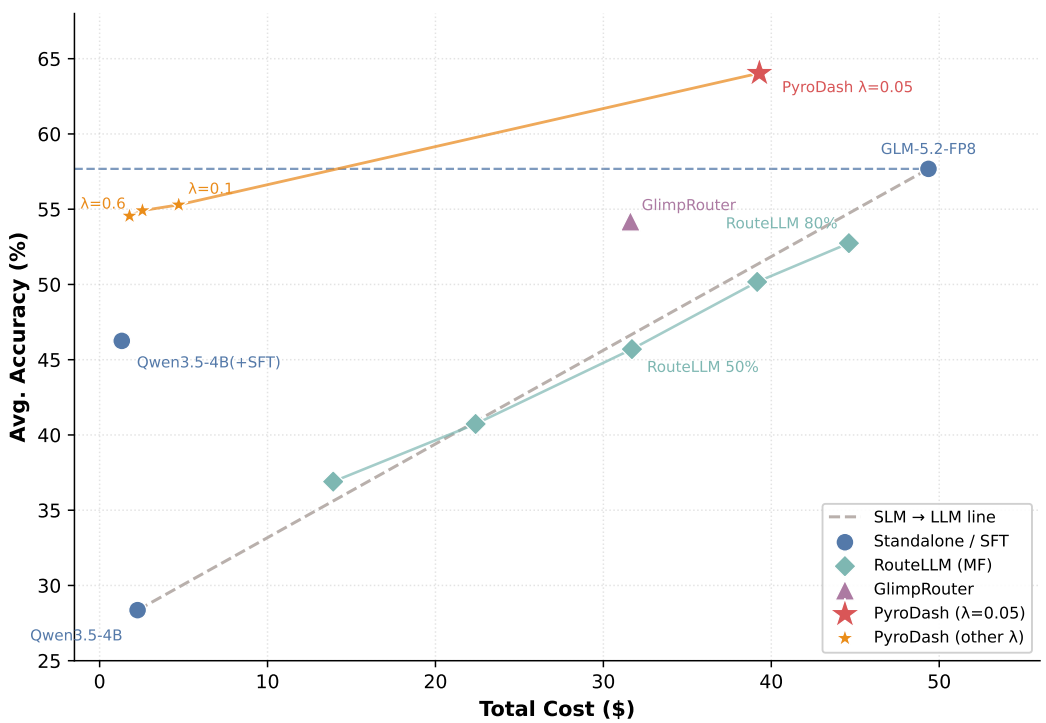
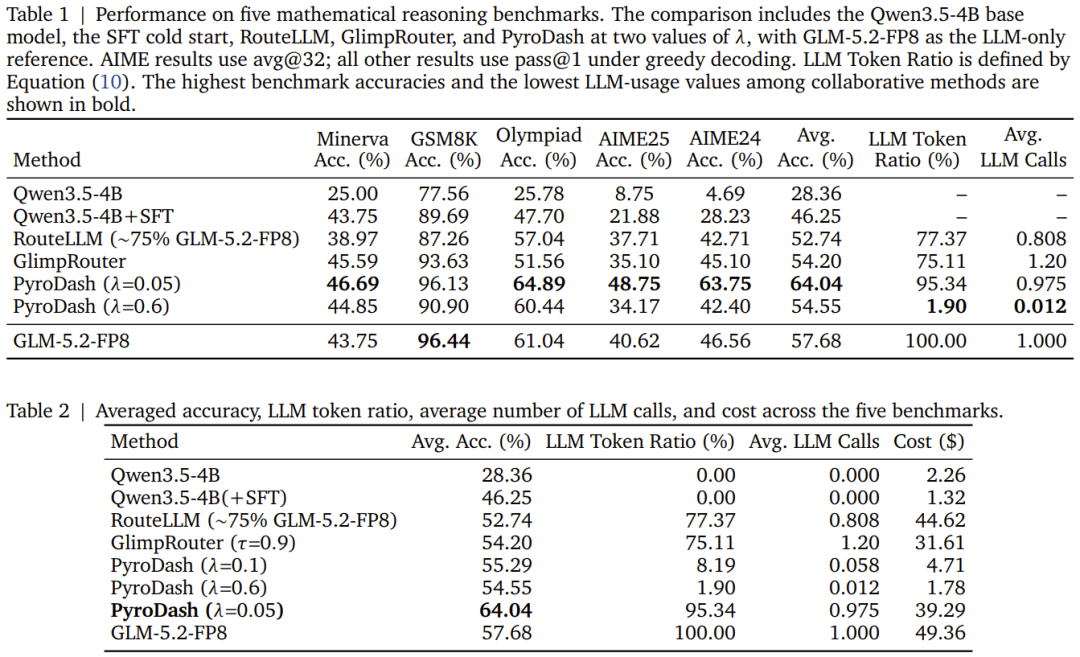
在五个数学推理基准测试中,这种策略效果惊人。当配置偏向节省成本时(λ=0.6),小模型平均每 100 道题才求助一次,总成本从纯大模型的 49.36 美元降到 1.78 美元,不到原来的三十分之一,准确率仅下降约 3 个百分点。而当配置偏向准确率时(λ=0.05),组合方案的平均准确率达到 64.04%,反而比纯大模型的 57.68% 高出 6.36 个百分点,同时成本还低了两成。
更重要的是,这些结果均优于 RouteLLM、GlimpRouter 等主流路由方案。
为什么不是一开始就选好模型?
传统做法是“请求级路由”:先分析输入难度,再决定交给哪个模型。但真实任务的难点往往藏在生成过程中。一道数学题开头可能只是简单信息提取,中途才出现复杂推导。如果在解码前就把整道题分配给小模型,它卡住时系统也无法调整。
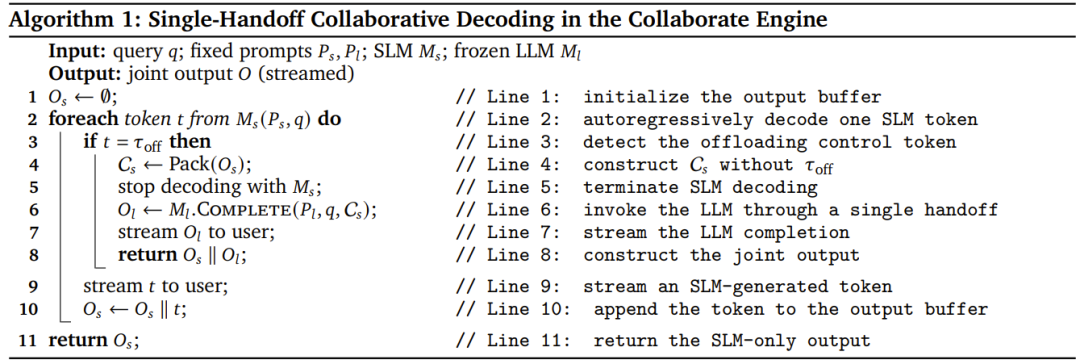
级联方案虽可在打分后升级调用大模型,但意味着从头重新生成,浪费已有的正确推理步骤。而 PyroDash 的交接不是放弃,而是接力——小模型已完成的工作会作为上下文传给大模型,后者在此基础上续写。
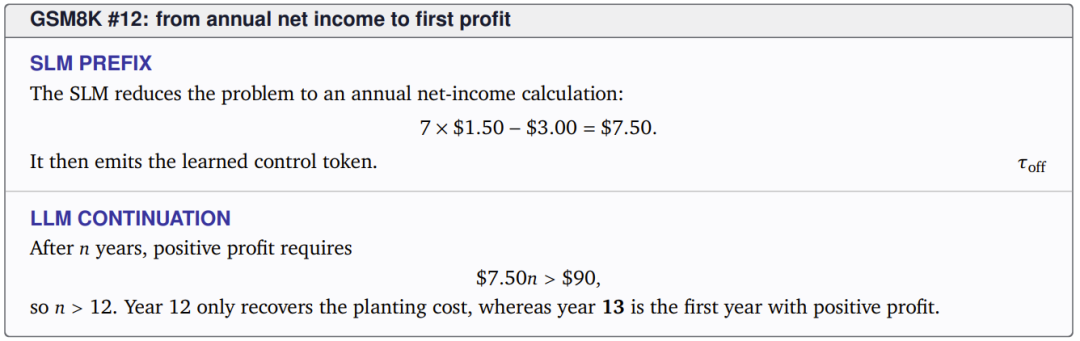
例如,一道柠檬树盈利题,小模型先算出年净收入 7.5 美元,然后发出求助信号。大模型接手时看到的不再是原始题干,而是一个已化简的算式,只需解 7.5n > 90 即可。这样既节省了大模型的计算量,又保留了小模型的有效劳动。
把账单写进奖励函数
关键问题来了:小模型怎么知道自己该在哪一步举手?
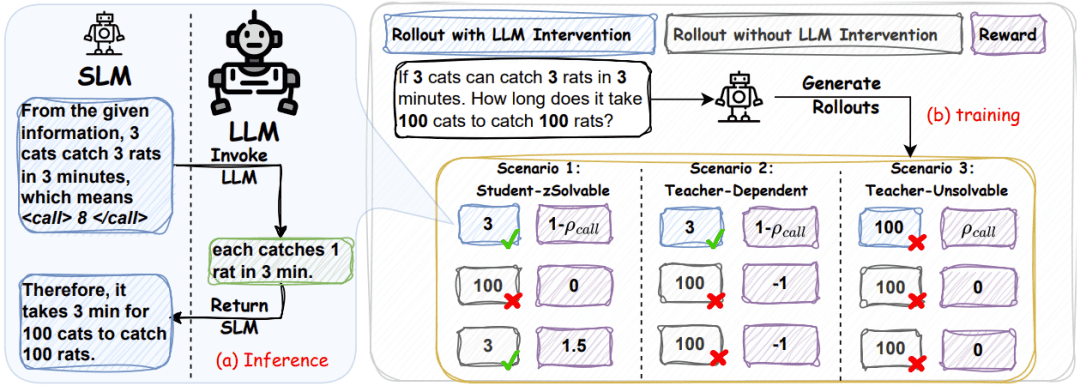
原始小模型根本不认识那个代表“我搞不定了”的控制 token(记作 τ_off)。Pyromind 的解决方案是一套三阶段渐进式训练流程,全程只训练小模型。
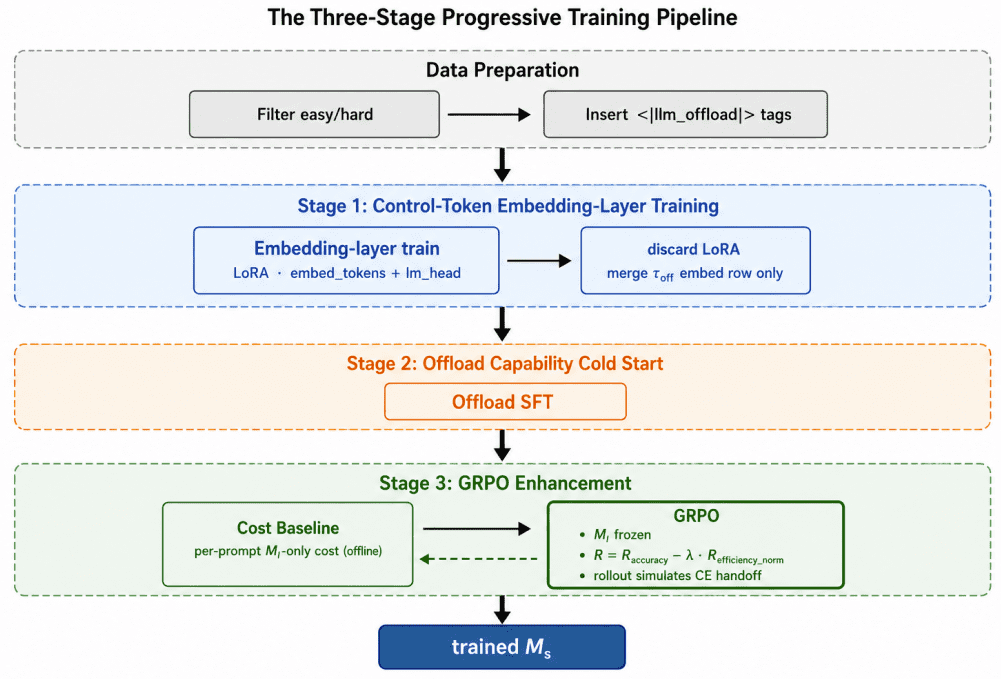
首先,他们构建了 EasyHard-24k 数据集。这个数据集的“难易”不是静态标签,而是相对于目标小模型定义的:用基础小模型跑一遍所有样本,答对的归为 easy,答错但能重构出正确推理链的归为 hard。这种“模型相对难度”更贴合实际协同场景。
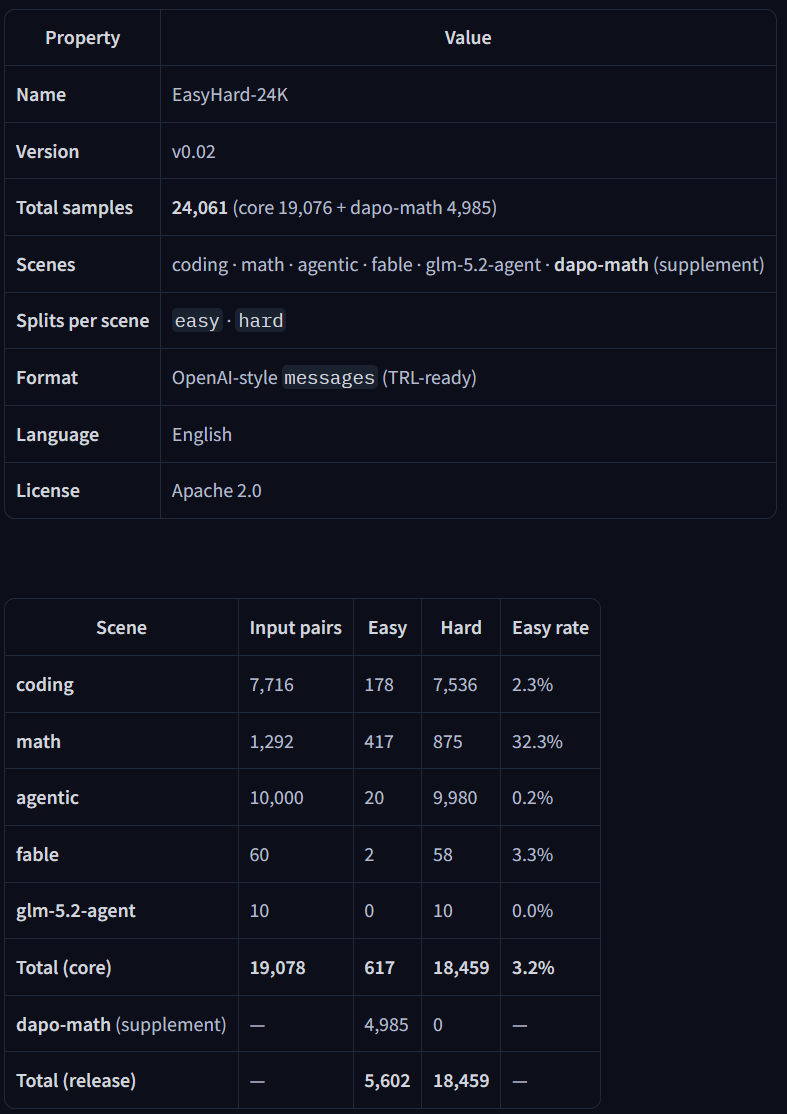
对于 hard 样本,团队用大模型重构一条正确的思维链,并在其中动态插入一到四个候选交接点。数据被扩展成两种提示:一种不含协同指令,用于保持小模型独立推理能力;另一种包含协同提示,其中 easy 样本不加 τ_off,避免模型养成“有事没事都叫大模型”的坏习惯。
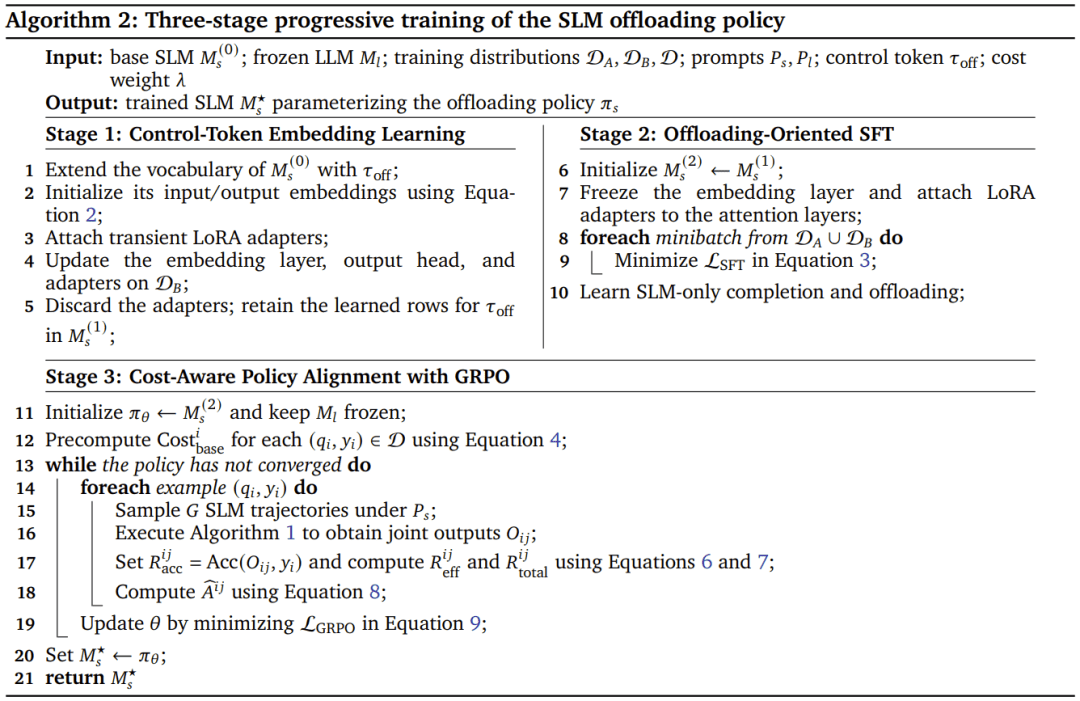
训练分三步走:
- 嵌入学习:将 τ_off 的嵌入初始化为句号、换行等自然断点标记的均值加噪声,让它天然处于“边界”位置。
- 行为冷启动:通过监督微调,让模型学会在有协同提示时,遇到难题可发出 τ_off。
- 成本感知对齐:使用 GRPO 强化学习算法,奖励 = 准确度 - λ × 归一化成本。这里的成本不仅包括小模型自己的 token 开销,还包括它作为大模型输入上下文的 prefill 成本,以及大模型后续解码成本。
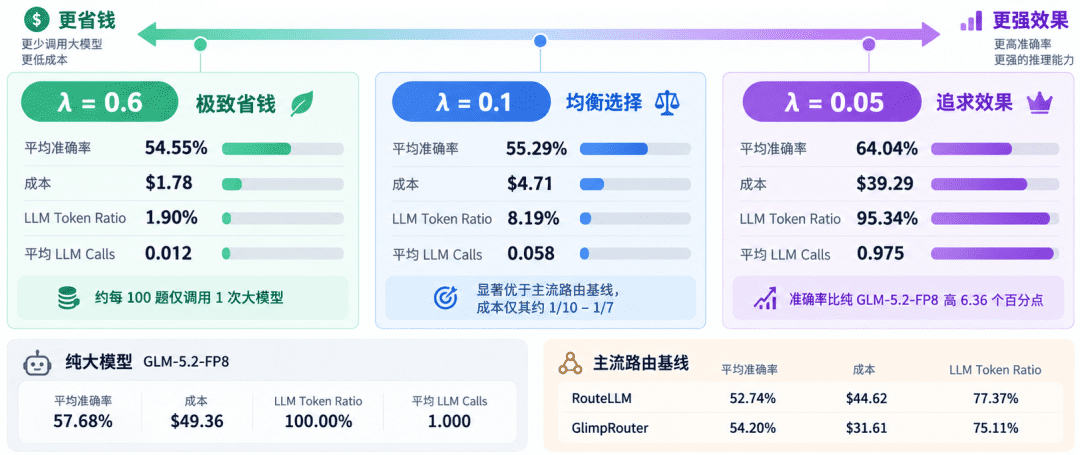
这意味着,小模型在求助前多写的每一个 token,都要在账单上被算两次。λ 是可调参数:值越大,系统越省钱;值越小,越追求准确率。
消融实验显示,只做完前两阶段的模型平均准确率仅 46.25%,加入第三阶段 GRPO 后跃升至 64.04%。这说明,冷启动教会的是行为,强化学习学到的才是判断。
协同引擎:对大模型几乎无要求
PyroDash 的架构对企业很友好。协同引擎(CE)只负责检测 τ_off、打包上下文、调用大模型续写。它不要求大模型开源,也不需要访问其内部 logits 或梯度——只要一个标准的文本补全 API 就够了。
大模型在这里只是一个“续写端点”,既不用重训,也不用暴露内部结构。而小模型选用 4B 规模,是因为它能在普通 Mac 上流畅运行,适合端侧部署。
这种设计也回应了 Pyromind 对 AI 下半场的判断。创始人 Kevin Ding 认为,未来不太可能由一个超级中心化模型解决所有问题,更可能是由大量不同能力层次的智能体组成“Agent 蜂群”。英伟达研究院、伯克利 BAIR 和 Gartner 的近期观点也支持这一方向:不存在一个可靠又经济的、适用于所有场景的模型。
推理的下半场:从选择模型到提升编排能力
PyroDash 动摇了传统推理的三个默认前提:
- 决策位置从请求开始前移到了生成过程中;
- 决策主体从外部路由器变成了模型自身;
- 优化目标从 token 占比、延迟等代理指标,换成了按 prefill 与 decoding 分开计价的真实账单。
这带来一个新范式:collaborative scaling(协同扩展)。当 scaling 的重点从“把单个模型做得更大”转向“如何编排异构模型服务”,算力和智能就能按需在一张模型网络里流动。
Hugging Face 上 100B 以下本地模型占据下载主流,也印证了需求的多元性。Kevin Ding 表示:“基座模型越强,反而会出现更多路由、协同和成本优化的强化学习需求。”
目前,PyroDash 的论文、模型、数据集与代码均已开源。基于 Qwen3.5-4B 的 PyroDash-4B-GRPO-Lambda-0.6 模型已在魔搭社区上线,开发者可直接拉取试用。团队下一步希望验证它在真实生产场景中的价值,而不仅是 benchmark 分数。
毕竟,AI 的下半场,或许不在于谁的模型最大,而在于谁的编排最聪明。