用大模型搭建自动化内容生产线:从提示词到第二收入
技术拐点:为什么现在能用AI搭内容生产线
2026年,用大模型做内容自动化的门槛被彻底打平。这背后有三个硬核变化。
首先是API成本暴跌。以gpt-4o-mini为例,每百万token价格从2024年的0.15美元降到2026年的0.03美元,降幅80%。生成一篇2000字文章的成本不到一分钱。这意味着批量生产的边际成本几乎为零。

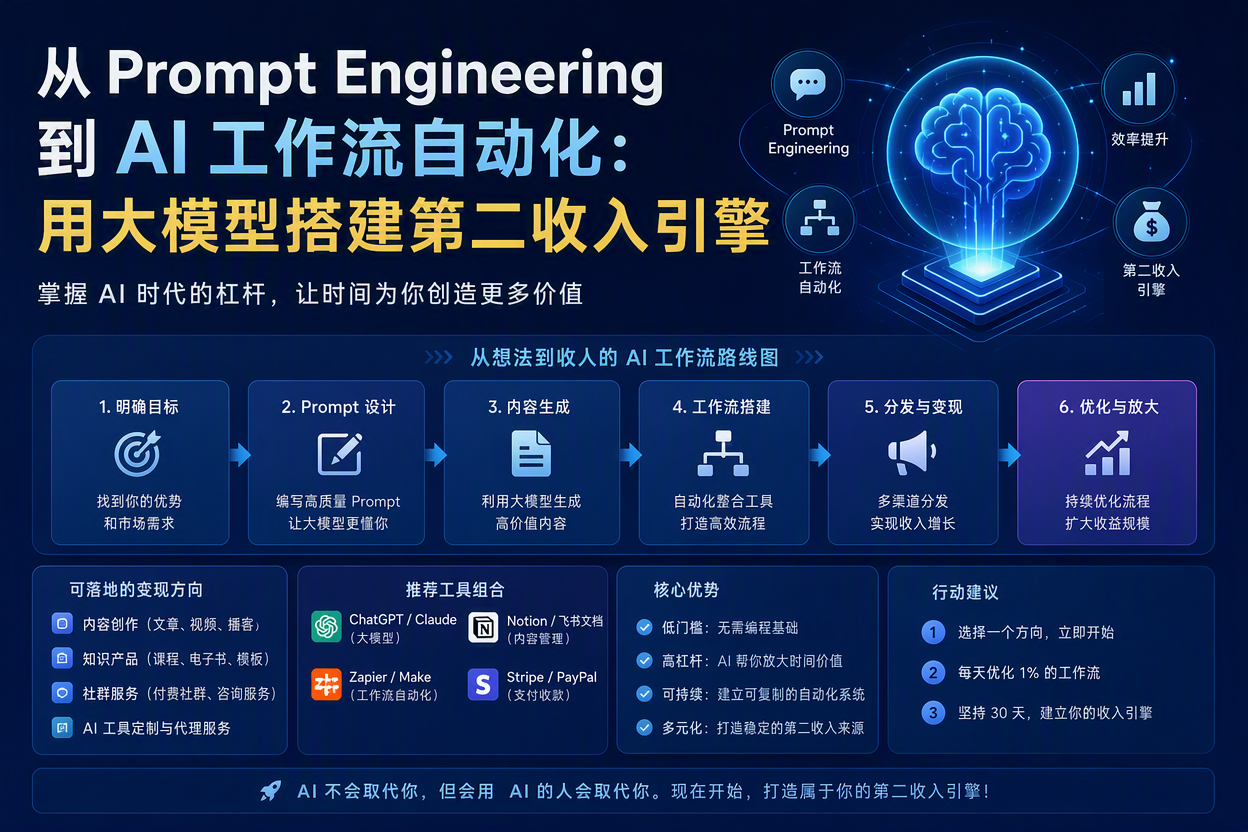
其次是工具链闭环。现在的AI已经覆盖内容生产的全链路:文本用LLM,图像靠扩散模型,音频走TTS,视频有生成工具,剪辑也能自动化。每个环节都有稳定API,串起来就是一条完整产线。
最后是Agent框架成熟。像LangChain、Coze、Dify这些工具,在2025到2026年间完成了从“玩具”到“生产级”的进化。拖拽几个模块就能跑通一个多步骤工作流,工程实施变得简单。
这三个变化叠加,让AI工作流自动化从技术探索变成了可落地的工程。
五种高阶提示词模式
所有自动化流程的起点都是提示词。这里拆解五种经过验证的模式,每种都附可复用模板。
角色锚定:缩小输出空间
给模型明确身份,能激活它在特定领域的知识分布。比如写向量数据库选型指南,弱提示是“帮我写一篇关于向量数据库的文章”,强提示则定义角色:“你是一位资深数据库架构师,10年分布式系统经验,擅长向量检索、ANN算法、RAG系统设计。”再配上受众、字数、对比要求等细节。角色锚定的本质是缩小输出空间,让内容集中在该角色的知识子集里。
结构化输出:为程序解析铺路
自动化流水线需要机器可读的输出。强制LLM返回JSON是最基础的做法。关键是在调用时加上response_format={"type": "json_object"}参数,并在提示词里严格定义字段。比如拆书解读任务,可以要求输出包含核心观点、解释、生活案例的数组,外加视频脚本和标签。这样下游程序直接解析JSON就能用,不用再做文本清洗。
Few-Shot:用例子代替描述
有时候光靠文字描述风格很难精准。这时候给两三个输入-输出示例更有效。比如生成小红书种草文案,先展示耳机和保温杯的例子,模型自己就能归纳出“感叹句开头+痛点解决+标签结尾”的模式。Few-Shot的精髓在于用实例代替抽象说明,尤其适合风格类任务。
Chain-of-Thought:让推理可审计
复杂分析任务需要分步推理。比如评估“用AI生成PPT模板在闲鱼售卖”的可行性,可以让模型按市场需求、竞争格局、AI优势、成本风险等步骤逐一分析,每步先写推理过程再给结论。这样做的好处是可审计——如果结果有问题,能回溯到具体哪一步出错,针对性修正。
自我迭代:低成本逼近高质量
让模型对自己的输出做评审和修改,形成“生成→评估→优化”闭环。实测发现,gpt-4o-mini经过三轮自我迭代,输出质量接近gpt-4o直接生成的水平,但成本只有十分之一。代码实现很简单:先生成初稿,再调用评估函数打分并指出问题,最后根据意见重写。循环几次就能显著提升质量。
多模型编排:每个环节用最合适的工具
没有哪个模型能在所有任务上都最优。工程化做法是按环节拆分,每个步骤选用最适合的模型。
比如选题分析用DeepSeek V3,因为中文理解强且成本低;大纲生成交给GPT-4o,逻辑推理能力突出;正文写作选Claude 3.5,长文连贯性好;配图用Midjourney V6,艺术质量最高;中文配音走通义TTS,自然度更佳。
编排的关键是统一调用接口。可以用一个llm_call函数封装不同模型的客户端,传入模型名和提示词就能返回结果。这样主流程代码干净,切换模型也方便。
选型不能凭感觉。建议对真实任务跑benchmark:选三个候选模型,各测十次,比较输出质量和API成本。比如结构化数据提取,gpt-4o-mini的JSON模式稳定且便宜,比强行用大模型更划算。
批量生产Pipeline:从单次到规模化
单次生成只是demo,批量生产才是工程。一个完整的Pipeline包含选题管理、内容生成、质量检测、分发四个核心模块。
选题库可以用CSV或数据库维护,每行一个主题和状态标记。内容生成引擎调用多模型编排流程,产出Markdown格式文章。质量检测模块用另一个提示词让AI从内容深度、逻辑结构等维度打分,平均分低于7就触发重写。通过检测的内容存入输出目录,同时记录质量分和重试次数。
成本控制很重要。以生产100篇2000字文章为例,内容生成和质量检测各调用约130次(含重试),总成本约5.2元,每篇5分钱。工程决策原则是:先用mini模型跑量,只有高质量需求才升级到gpt-4o。
定时发布也很实用。用schedule库设置每天固定时间拉取待处理选题,自动生成、检测、发布,形成持续产出节奏。
三种已验证的变现路径
技术Pipeline搭好后,要接上变现闭环。目前有三种跑通的模式。
第一种是平台流量分成。在头条号、百家号、知乎等平台发布AI生成内容,按阅读量获得收益。关键指标是日产量10-30篇,单篇阅读500-5000,月收入可达1000-5000元。需要配合数据监控,根据阅读量反馈迭代选题方向。
第二种是AI服务接单。在猪八戒、闲鱼接PPT制作、LOGO设计、文案撰写等订单。传统耗时2小时的PPT,用AI辅助20分钟就能交付,效率提升6倍。单价50-200元,利润空间可观。关键是把客户需求解析自动化——用结构化提示词把模糊brief转成明确规格,再调用对应工具链生成。
第三种是数字产品售卖。用AI批量生成PPT模板、提示词库、素材包等,在电商平台销售。这类产品的边际成本几乎为零,做一次能卖无数次。比如9.9元的提示词库,生产成本就是几毛钱API费,后续全是纯利。
工程化最佳实践
踩过坑后总结六条原则,能大幅提升Pipeline稳定性。
中间产物全部留存。大纲JSON、初稿Markdown、质量评分都要保存。调试时能快速定位问题,复用时直接修改中间文件,不用从头跑。
用JSON Schema约束输出。别信任LLM的格式稳定性。除了response_format参数,还要加try/except捕获解析错误,失败就重试。三次都失败再报错,避免整个流程中断。
限流与指数退避。API调用可能因网络或配额失败。用装饰器实现重试逻辑,失败后等待时间按指数增长(1s、2s、4s),减少连续冲击。
A/B测试提示词。同一任务写两三个提示词版本,各跑十次,比较平均质量和稳定性。用数据决定哪个版本上线,不凭主观感觉。
人工品控不可省。AI有幻觉和事实错误。建议设三级过滤:质量分低于7自动重写;7-8分进入人工抽检(抽检率20%);8分以上直接发布,但保留回溯能力。
数据驱动迭代。记录每篇内容的选题、提示词版本、质量分、阅读量。每周分析:哪个方向阅读量高?哪个提示词质量分稳?用数据持续优化整个流程。
这些实践看似琐碎,但正是它们把“能跑通的demo”变成“可长期运行的生产系统”。