OpenAI下线史上最快模型GPT-5.3-Codex-Spark,仅存活7个月
OpenAI史上最快模型悄然退场
9月13日,OpenAI Codex团队负责人Tibo在社交平台宣布:GPT-5.3-Codex-Spark将于下周正式下线。这款曾号称“每秒1200个Token”的极速模型,从今年2月12日发布到退役,仅存活了7个月。
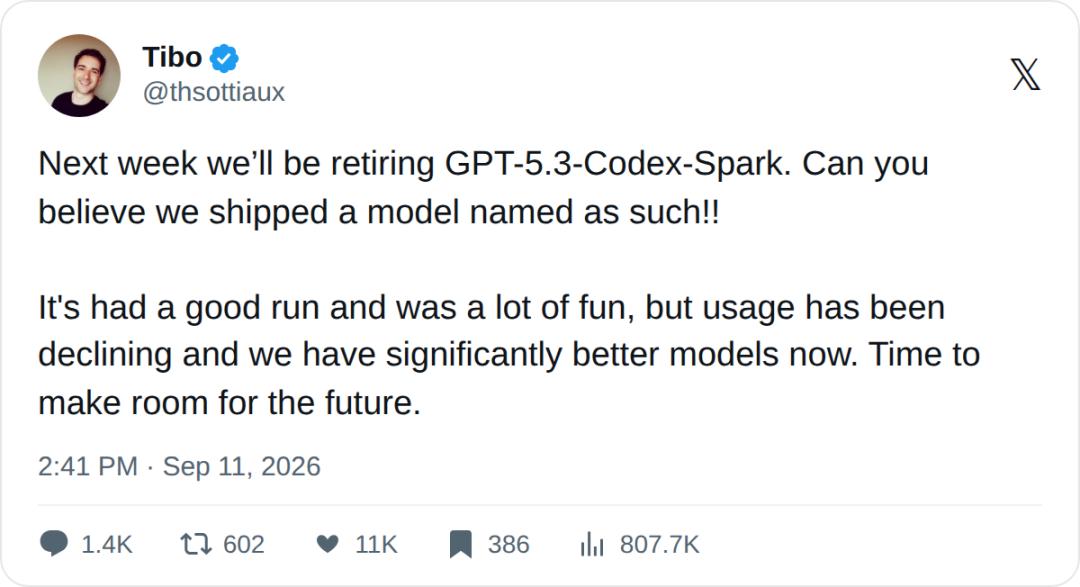
Tibo给出的理由很直接:使用量持续下滑,且团队已有明显更优的替代方案。“是时候给未来腾地方了。”他还调侃道:“真不敢相信我们居然发布过名字这么长的模型!”
这番轻松语气背后,是一次技术路线的快速试错与果断放弃。Spark曾承载着OpenAI摆脱英伟达硬件依赖的野心——它是首个运行在Cerebras晶圆级芯片WSE-3上的生产模型,也是那笔价值超200亿美元、750兆瓦算力大单的首份交付成果。但现实很快证明,极致速度若以牺牲智能为代价,终究走不远。
开发者怀念的不是模型,而是“备用额度”
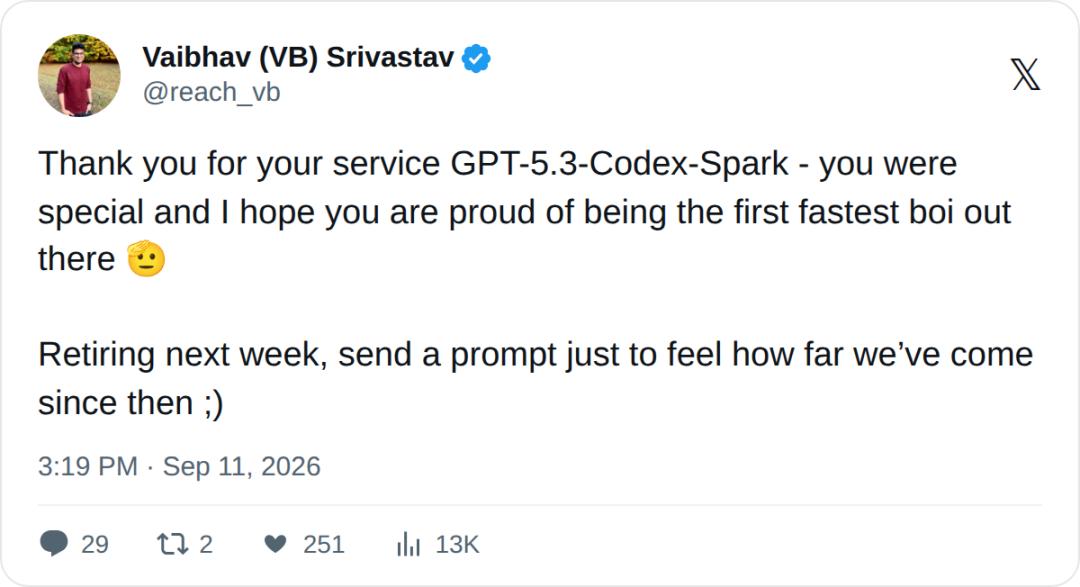
Spark的告别仪式显得有些冷清。Hugging Face工程师Vaibhav Srivastav试图在评论区营造温情氛围:“感谢服役,你很特别,希望你为自己是第一个‘最快的小子’而骄傲。”
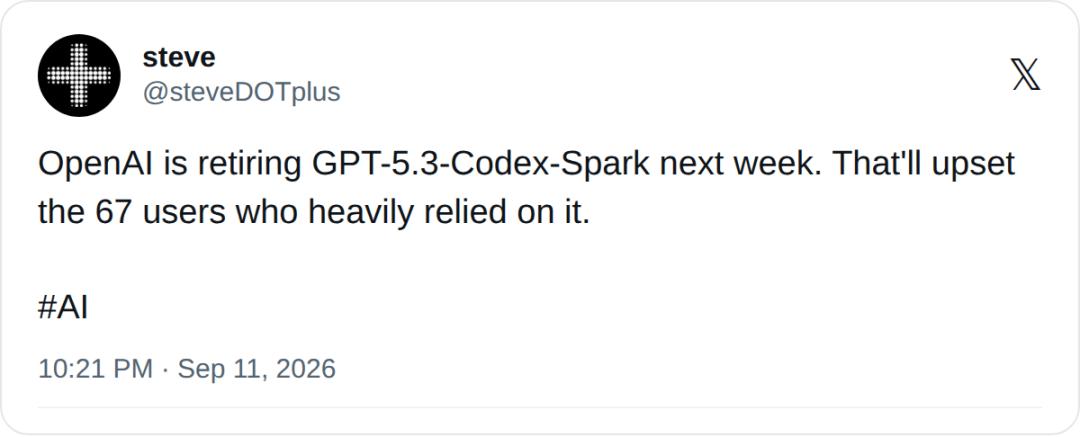
但紧随其后的热评迅速拉回现实:“所以它到底是干嘛用的?前两天我还在跟同事讨论这个问题。”另一条评论更扎心:“OpenAI要退役Codex-Spark了,那仅存的67个重度用户该伤心了。”
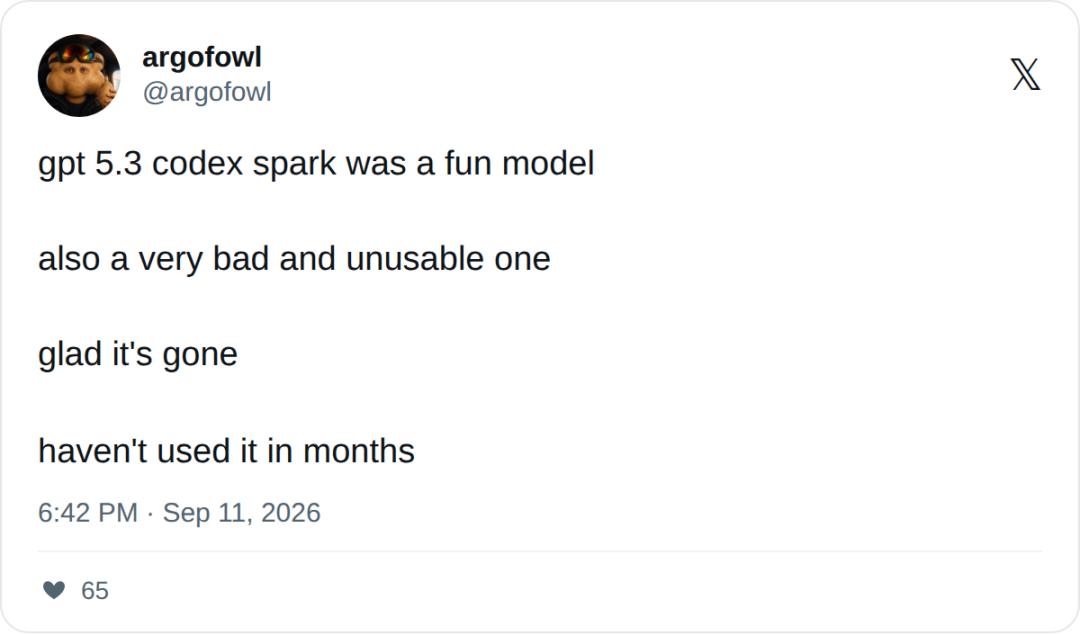
最尖锐的评价来自开发者argofowl:“Spark是个好玩的模型,也是个极度糟糕、根本没法用的模型。很高兴它走了,我好几个月没碰过了。”
多位开发者证实,在实际项目中,Spark连分析日志、理解上下文这类基础任务都难以胜任。它的上下文窗口虽标称128k,但处理稍复杂任务时极易“塞满”,迫使用户另开对话。更糟的是,它常凭空捏造API端点、输出格式不稳定的JSON,多步任务极易跑偏。
真正让部分人感到一丝惋惜的,并非模型本身,而是它附带的独立配额。知名开发者Chubby坦言:“我想要一个‘GPT-6-Spark’,因为Spark有一份不占主额度的独立套餐。”在当前Astra额度极其紧张的情况下,不少开发者把Spark当作主额度耗尽后的“备用油箱”应急使用。
“降智提速”的致命缺陷
回看2月12日Spark上线时的盛况,反差尤为强烈。当时OpenAI宣称,Spark专为实时编程设计,客户端与服务器往返开销降低80%,首Token延迟减半,代码“整块倾泻”而非逐行输出。
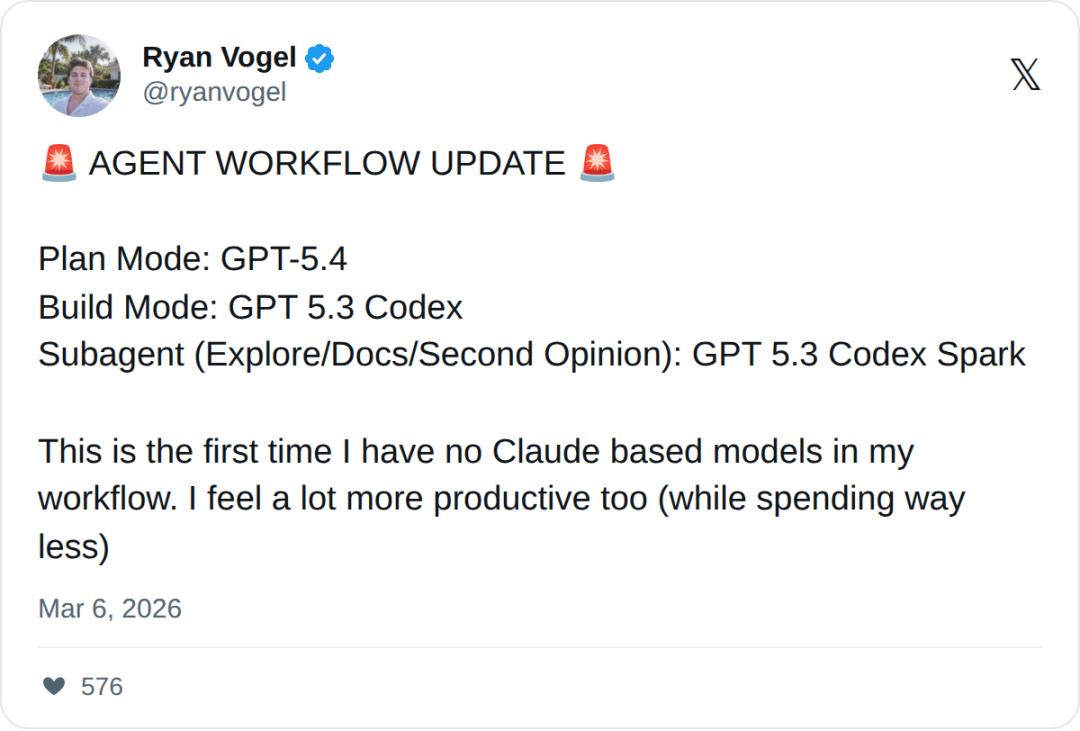
早期尝鲜者确实兴奋。开发者Ryan Vogel将其纳入正式工作流:GPT-5.4负责规划,GPT-5.3-Codex负责构建,Spark则用于探索代码库、查文档、提供第二意见。他称这是自己首次工作流中完全不用Claude,“效率更高,花得更少”。
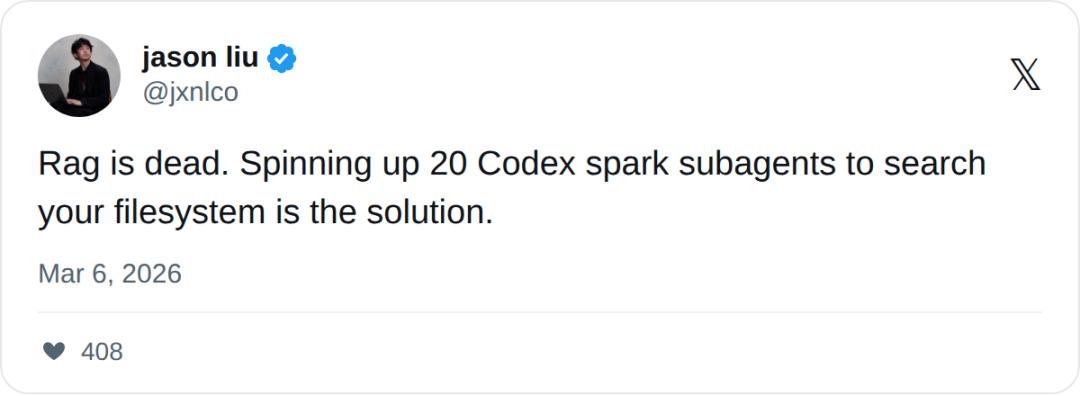
Instructor作者Jason Liu甚至同时启动20个Spark子代理搜索文件系统,高呼“RAG已死”——不久后他加入了OpenAI Codex团队。
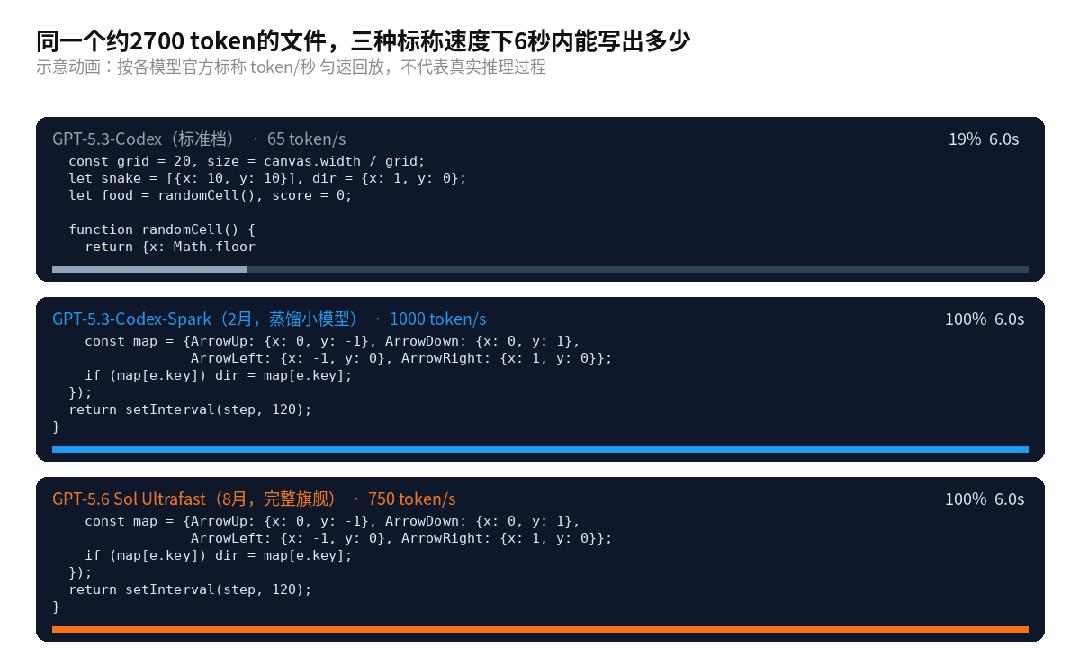
然而热度迅速消退。问题核心在于:Spark本质是一个为速度妥协的蒸馏版小模型。一块Cerebras晶圆无法容纳完整的旗舰模型,只能运行缩水版本。
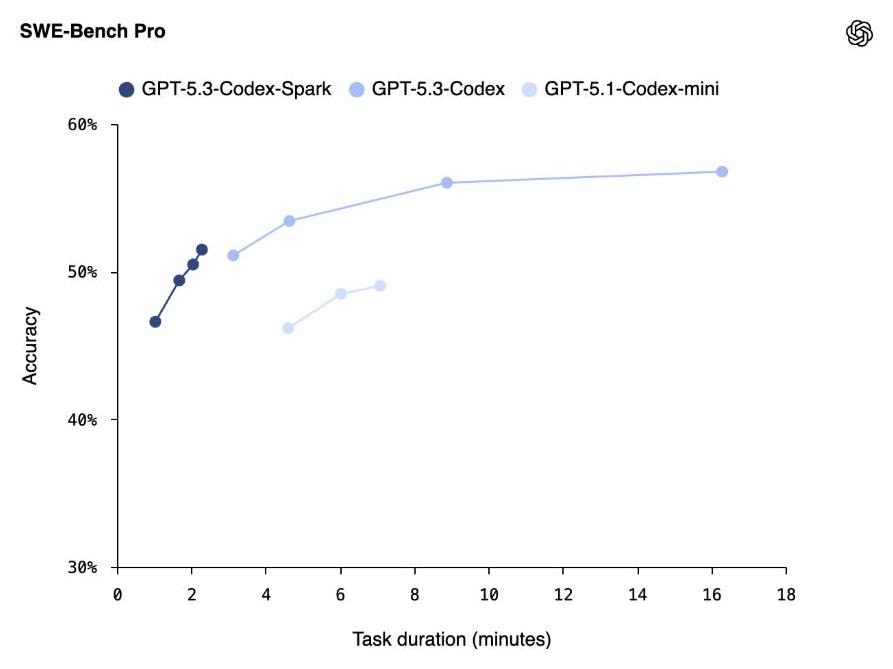
评测数据揭示了残酷真相。在Terminal-Bench 2.0中,Spark准确率仅58.4%,远低于完整版GPT-5.3-Codex的77.3%。OpenAI自家SWE-Bench Pro曲线显示:Spark虽能在1-2分钟内完成任务,但准确率卡在47%-51%;而完整版从3分钟起就是51%,16分钟可达57%。
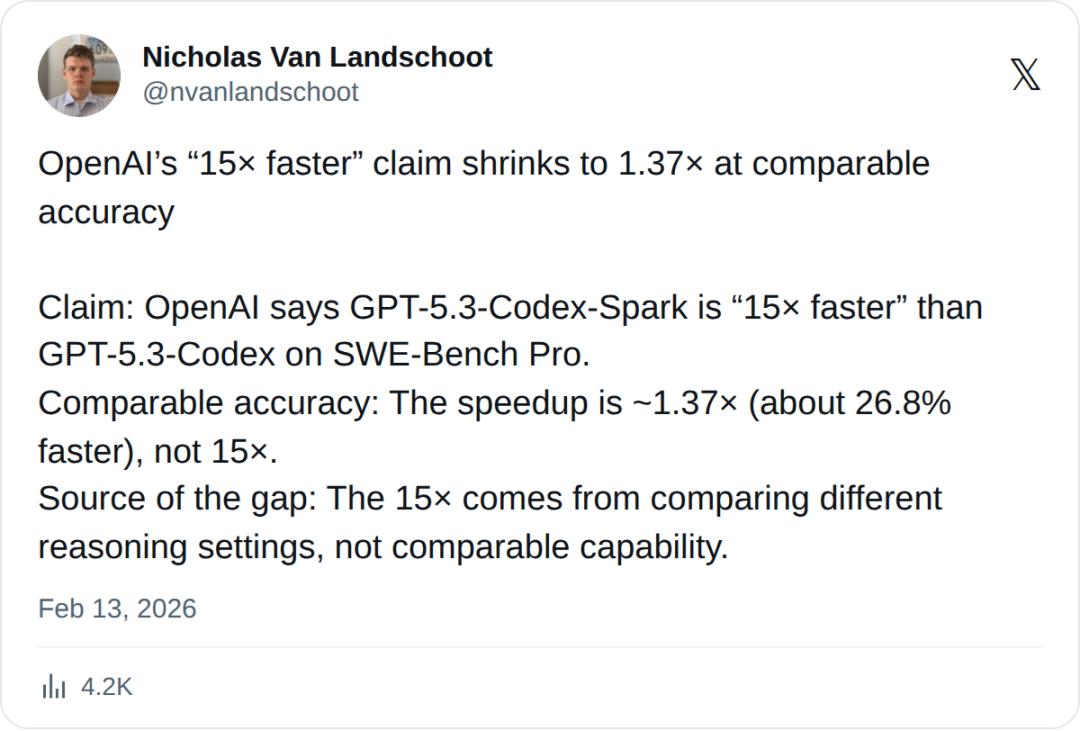
所谓“15倍提速”也被拆穿。开发者Nicholas Van Landschoot指出,该对比是拿Spark对阵开启最高推理强度的完整版。在同等准确率下,Spark实际仅快1.37倍。
培训机构Turing College的总结一针见血:“没有智能的速度,只是更快地失败。”对程序员而言,花17分钟等一个能跑通的代码,远比2分钟拿到一堆Bug划算。
旗舰本尊下场,终结“阉割版”时代
真正宣判Spark死刑的,是8月13日Cerebras发布的Ultrafast模式。这一次,跑在晶圆上的不再是缩水模型,而是GPT-5.6 Sol旗舰本尊。
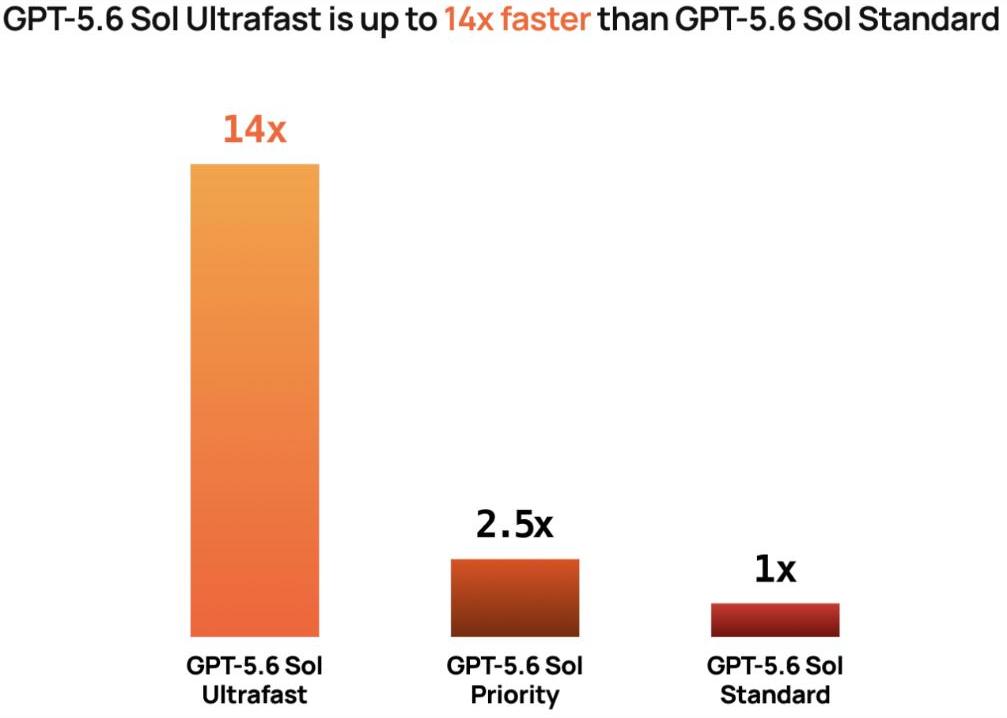
通过将庞大模型按层切分,铺设在多台CS-3节点形成流水线,Ultrafast在保持“与标准版同等智能”的前提下,实现每秒750个Token的速度。Cerebras CEO Andrew Feldman直言:“速度与智能,不再互斥。”
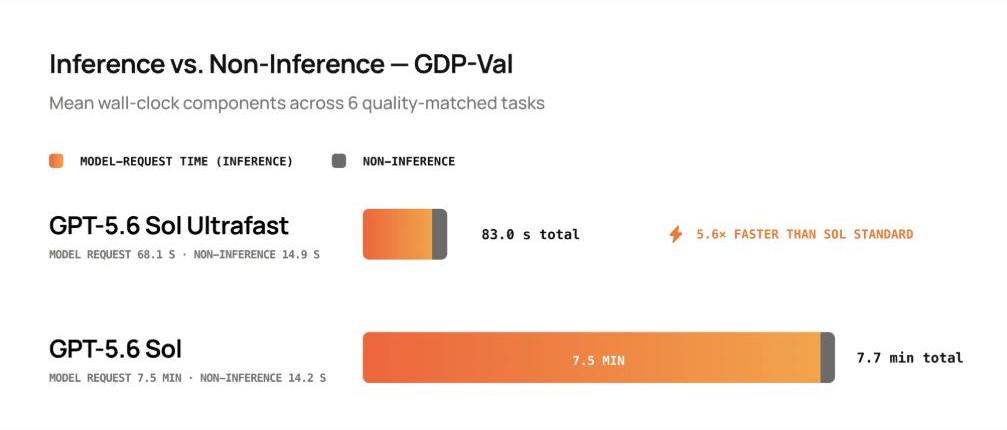
实测数据更具说服力。在GDP-Val的6个质量对齐任务中,标准档Sol平均耗时7.7分钟(其中7.5分钟为模型生成);Ultrafast总耗时83秒(模型生成68秒),端到端提速5.6倍,且回答质量几乎无损。
这一突破彻底抽干了Spark的存在意义。Spark的设计逻辑是“拿智能换速度”,而半年后,同一家公司的晶圆上已能运行完整旗舰模型——速度只慢约四分之一(1200 vs 750 Token/s),能力却一分不减。
Cerebras产能有限。当无人问津的“缩小版”与排队疯抢的“旗舰版”争夺晶圆资源时,谁该为未来腾地方,答案不言自明。
速度变成付费档位,专用模型成历史
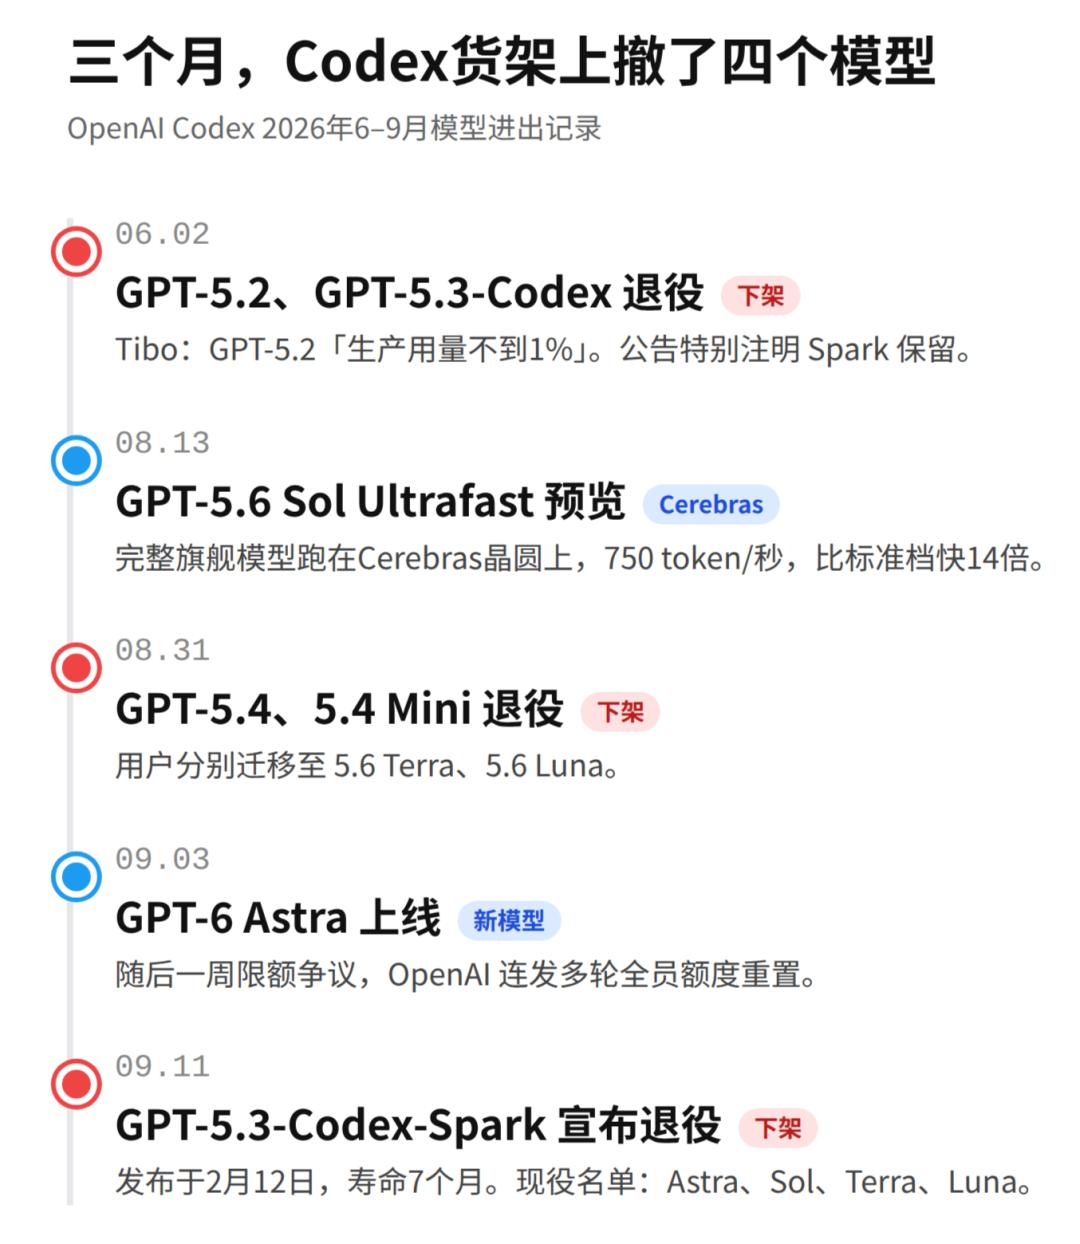
Spark并非孤例。过去三个月,OpenAI正对模型库进行激进“大换血”:
- 6月2日:GPT-5.2与GPT-5.3-Codex退役
- 8月31日:GPT-5.4与5.4 Mini退役,用户迁移至5.6世代
- 9月11日:GPT-5.3-Codex-Spark退役
伴随旧世代离场,Codex迎来以Sol(太阳)、Terra(大地)、Luna(月亮)、Astra(星辰)命名的新纪元。“GPT-5.3-Codex-Spark”这类冗长版本号,已成为上一个时代的遗迹。
更深层的变化在于:“快”正从独立专用模型,演变为旗舰模型的一项标配“档位”。就像推理强度分为Light到Max,如今速度也从Standard、Priority排到Ultrafast。速度与算力挂钩,按档付费的商业模式已然跑通。
回头看,Spark完美完成了历史使命:它验证了Cerebras晶圆能扛住生成式AI的生产级流量,也证明推理任务可脱离英伟达生态运行。当探路结束,大部队正式入驻,探路者自然退场。
“拿智能换速度”的歧途已被封死。随着各大平台竞逐底层硬件的极致利用率,下一轮军备竞赛的规则已然改写——比的不再是谁能做出最快的阉割版模型,而是谁能把最强的旗舰模型,跑出最极限的速度。