不靠堆数据,机器人也能举一反三:PhyFilter用物理滤波提升泛化能力
机器人泛化困局:数据堆不动了
过去十年,大语言模型的成功让“数据越多越聪明”成了默认逻辑。但当智能要落地到物理世界,这条路立刻卡壳——机器人没法像文本那样无限生成训练数据。
人工遥操作成本极高,特斯拉级别的工业尝试也受限于采集效率;仿真合成(如Isaac Lab、MuJoCo)虽能缓解,却始终跨不过sim-to-real的鸿沟。更麻烦的是,仿真环境需要大量手工调参做域随机化,本质上是用精度换鲁棒性,工程负担很重。
生物却不是这么干的。斑马鱼幼体没看过几万小时视频,照样能应对突发水流;人类婴儿摔倒几次就能调整步态。它们靠的不只是经验积累,更是身体自带的物理结构和实时反馈机制——比如小脑会不断更新内部模型,把前馈预测和感觉反馈结合起来,动态修正动作。
这启发了一个关键问题:既然机器人天生就有动力学方程、传感器和执行器,能不能把这些“现成的”物理信息用起来,而不是一味追求更多数据?
把学习误差当成可滤除的信号
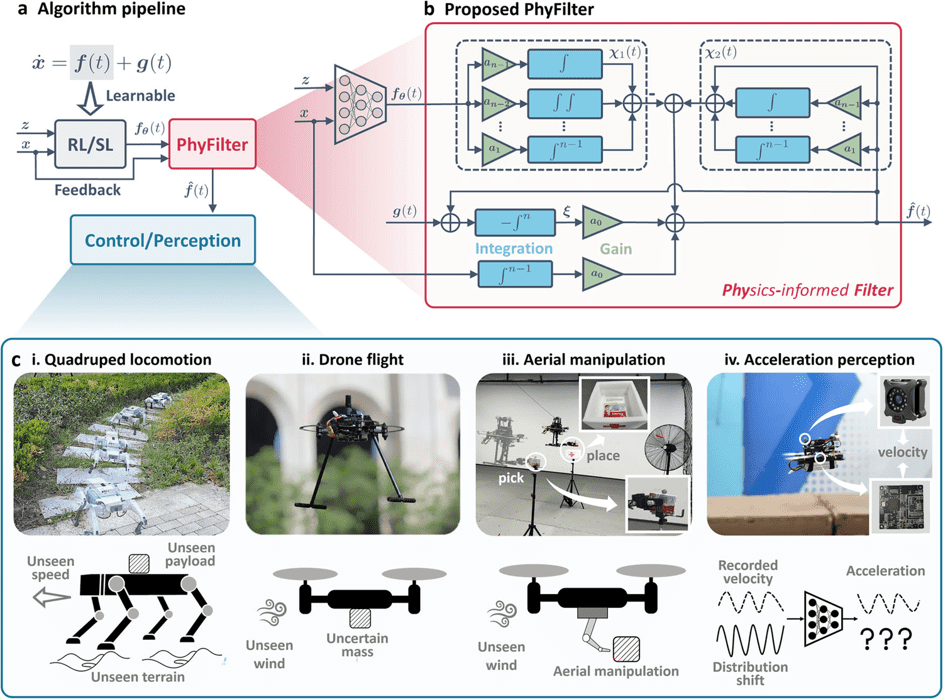
PhyFilter的核心思路很朴素:神经网络在新环境里出错,是因为它没学过那些扰动(比如风、沙地、额外负载)。这些错误表现为“学习残差”——真实系统行为和模型预测之间的差距。
传统做法要么重新训练模型,要么加复杂自适应控制器。PhyFilter另辟蹊径:它假设这个残差主要是低频的(比如风是缓慢变化的,不像高频噪声),于是设计一个高阶低通滤波器来捕捉并补偿它。
难点在于,部署时没有“真实值”做标签,残差无法直接测量。团队巧妙地绕开了这个问题:利用机器人已知的物理微分方程(比如牛顿第二定律)和可测的状态(位置、速度等),把原本需要高阶导数的滤波形式,重写成只依赖实测信号的等价表达。这样一来,连STM32这类微控制器都能以500Hz实时运行。
这个模块有三个突出特点:
- 即插即用:不用动原有模型,直接接在输出端就行,兼容强化学习或监督学习策略;
- 自动调参:传统滤波器靠工程师手工整定极点,高阶时极其繁琐。PhyFilter把参数看作控制输入,用伴随法+Adam自动优化,效果和人工调的一样好;
- 可退化可扩展:一阶时退化为经典扰动观测器,高阶则能处理更复杂的不确定性。
四类真机验证:从平地到碎石路,从无风到5m/s强风
四足机器人:仿真只训平地,真机直闯四种地形
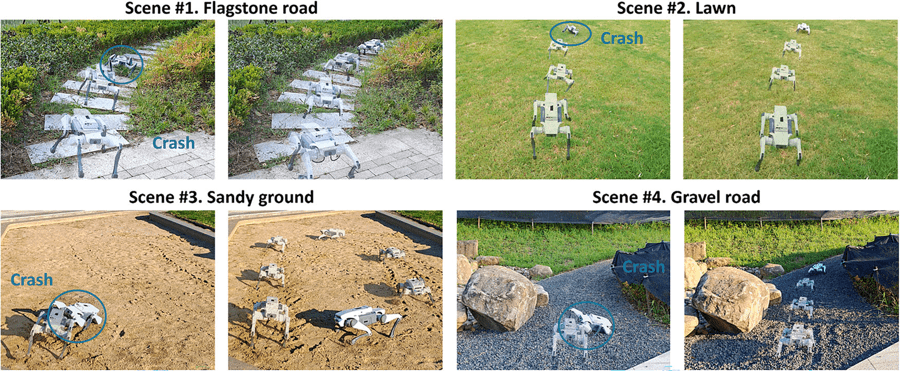
策略在仿真中仅用标准参数随机化训练平地行走,完全没接触过沙地、碎石等场景。部署时不做任何调参,结果令人意外:
- 基线策略在沙地和碎石路上几秒内就摔倒;
- 加入PhyFilter后,机器人稳定走完石板路、草地、沙地和碎石路;
- 更关键的是,即使在运行时关掉修正项,策略依然有效——说明PhyFilter在训练阶段就塑造了更鲁棒的底层控制,不只是运行时“打补丁”。
在高速(2.83m/s)和超重负载(超出训练上限137%)下,PhyFilter在五类未见地形的平均通过率达60%,而基线几乎全军覆没。
无人机:补上风扰这块短板
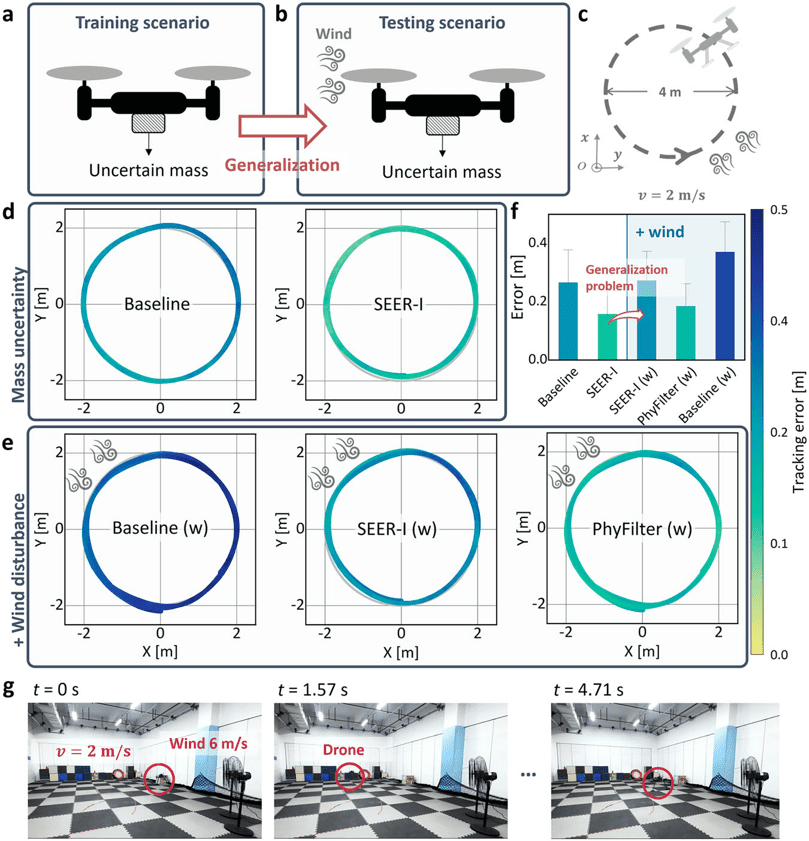
此前的SEER-I方法擅长处理质量不确定性,但遇到风扰就性能骤降。PhyFilter叠加后,在2m/s圆轨迹跟踪任务中,平均绝对误差比SEER-I降低30.22%。分析发现,SEER-I只能估计质量偏差,而PhyFilter同时辨识出了风致扰动和固有动力学误差。
空中机械臂:5m/s风中完成厘米级操作
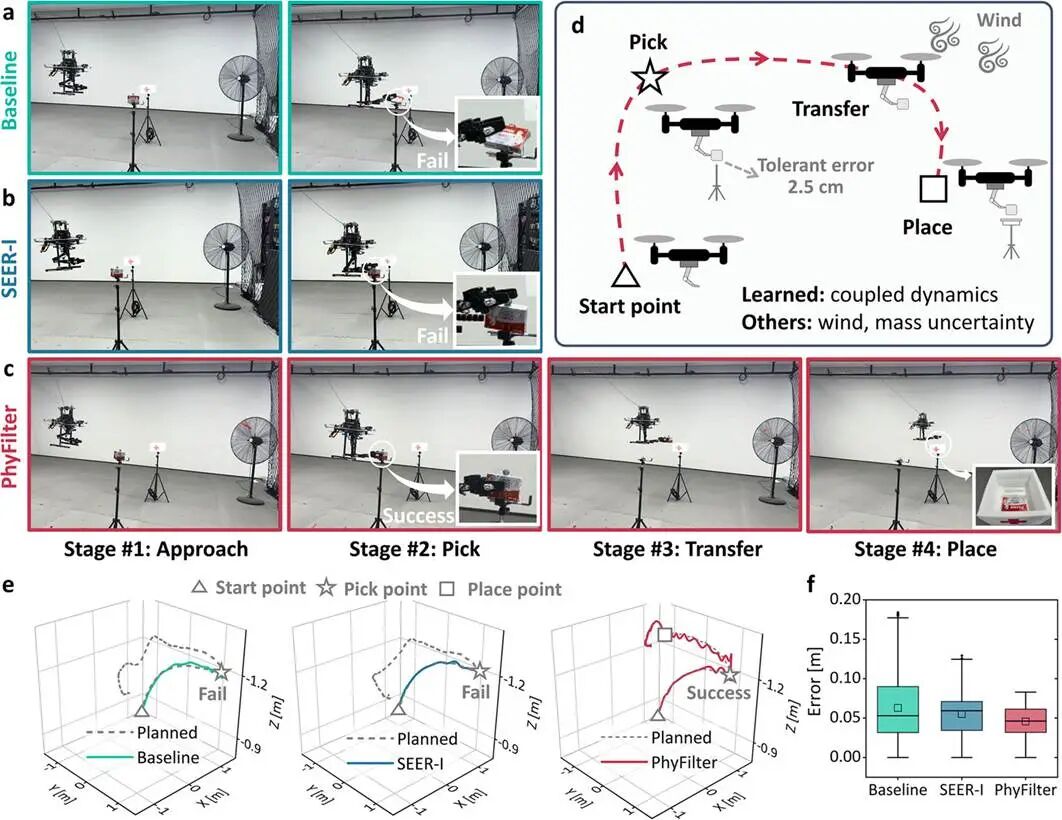
应急救援场景要求机械臂从三脚架取药放入指定区,允许误差仅2.5cm。实验用380W风扇制造5m/s阵风,并加0.3kg未建模负载。基线和SEER-I均失败,只有PhyFilter全程稳定执行,跟踪误差的均值和方差分别改善24%和55%。
加速度感知:分布外依然准
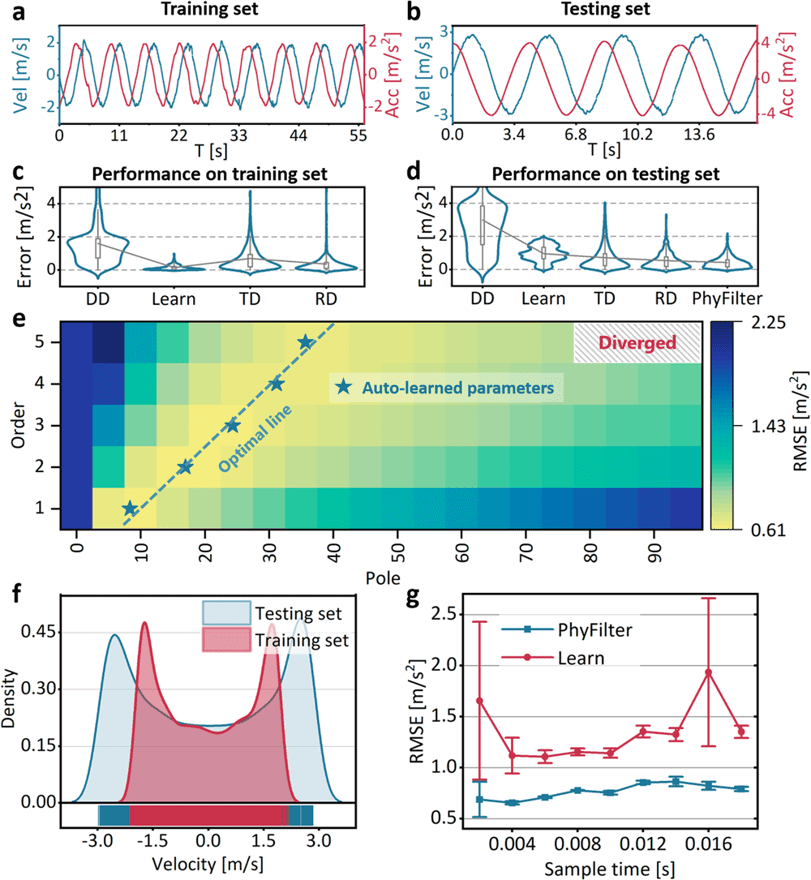
轻型无人机常缺高精度IMU,团队用神经网络从速度历史预测加速度。训练集速度0~2m/s,测试扩展到3m/s。纯学习模型明显失效,而引入运动学结构的PhyFilter在多种采样频率下都优于经典微分器(如TD、RD),且自动学到的滤波参数接近理论最优。
为什么这比“堆数据”更接近生物智能?
现有方法依赖域随机化——在仿真里塞进各种地形、风速、负载,试图覆盖所有可能。但这本质是“平均主义”,牺牲了特定场景的精度,还耗费大量调参人力。
PhyFilter则不同:在熟悉环境中,残差小,滤波干预自动衰减,保留原始策略的高精度;一旦进入未知场景,滤波被激活,动态补偿误差。它统一了精度与泛化,且训练阶段无需过度随机化。
更重要的是,它利用了机器人独有的优势:物理先验和实时反馈。LLM是纯数据驱动的“黑箱”,而机器人本就是个结构化的动力学系统。PhyFilter相当于给神经网络装了个“物理协处理器”,让它学会借助身体而非仅靠记忆。
局限与未来方向
目前PhyFilter只修正输出,没反哺回原网络。下一步可探索持续学习,用滤波获得的知识精化模型本身。
自动调参虽有效,但每次迭代需完整轨迹rollout,大规模应用效率低。截断式或并行化rollout可能是解。
此外,学习残差可能混杂多种不确定性(如建模误差+外部扰动)。如何解耦这些成分,或许需结合元学习。
总的来说,这项工作提醒我们:机器人不是缺数据的图像生成器。它的身体本身就是智能的一部分。与其无止境扩充数据集,不如好好利用那些现成的物理结构——这或许才是通往生物式泛化的捷径。