人工智能如何运行:从高维拟合到大模型推理的全链路解析
范式转移:从人工规则到数据驱动
传统软件依赖程序员编写的明确规则。比如银行转账逻辑,可以写成清晰的 if-else 分支。但面对图像识别这类任务,硬编码规则很快失效——猫的姿态、光照稍有变化,程序就无法判断。

人工智能换了一种思路:不写规则,而是喂给算法大量带标签的数据,让它自己找出输入和输出之间的映射关系。这个过程不是靠魔法,而是一套基于数学和统计的工程方法。
在数学上,AI 模型本质上是一个高维函数。一张图片被转成像素张量,一段文字被分词后映射为向量。模型的任务就是在高维空间里,找到一个能把输入坐标准确映射到输出坐标的函数。通用近似定理表明,只要参数足够多,带非线性激活的神经网络能逼近任意连续函数。
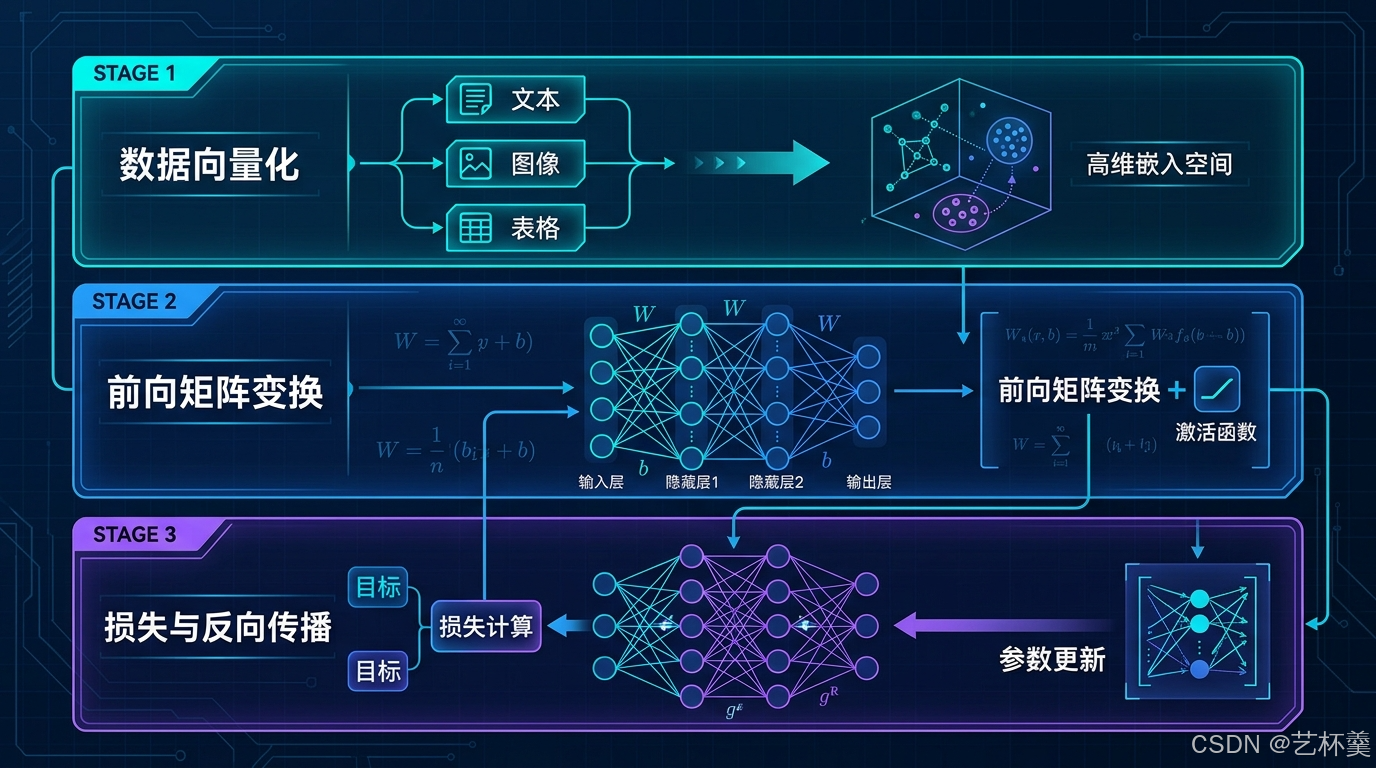
神经网络的核心运转机制
神经网络的训练依赖三个紧密耦合的环节:前向传播、损失计算和反向传播。
前向传播:矩阵运算与非线性激活
前向传播是数据流经网络完成一次预测的过程。输入向量与每层的权重矩阵相乘,加上偏置,再通过非线性激活函数(如 ReLU 或 GELU)。这一步打破了纯线性变换的局限,让模型能捕捉复杂模式。
举个简单例子:假设输入是二维向量,经过一个三层网络(输入→隐藏层→输出)。隐藏层的每个神经元计算输入的加权和,再用 sigmoid 函数压缩到 0-1 区间。输出层重复类似操作,最终得到预测值。
损失函数与梯度下降:参数的自动调整
初始模型的预测通常不准。损失函数(如均方误差或交叉熵)量化预测与真实值的差距。反向传播则利用链式法则,从输出层往回计算每个参数对总误差的贡献(即梯度)。
有了梯度,就能用梯度下降更新参数:新权重 = 旧权重 - 学习率 × 梯度。这相当于在误差曲面上一步步往下走,直到找到局部最低点。整个过程不需要人为干预,完全由数据驱动。
大语言模型的运作原理
现代大语言模型(LLM)延续了神经网络的基本框架,但在架构和生成方式上做了极致优化。
自回归生成:下一个词预测
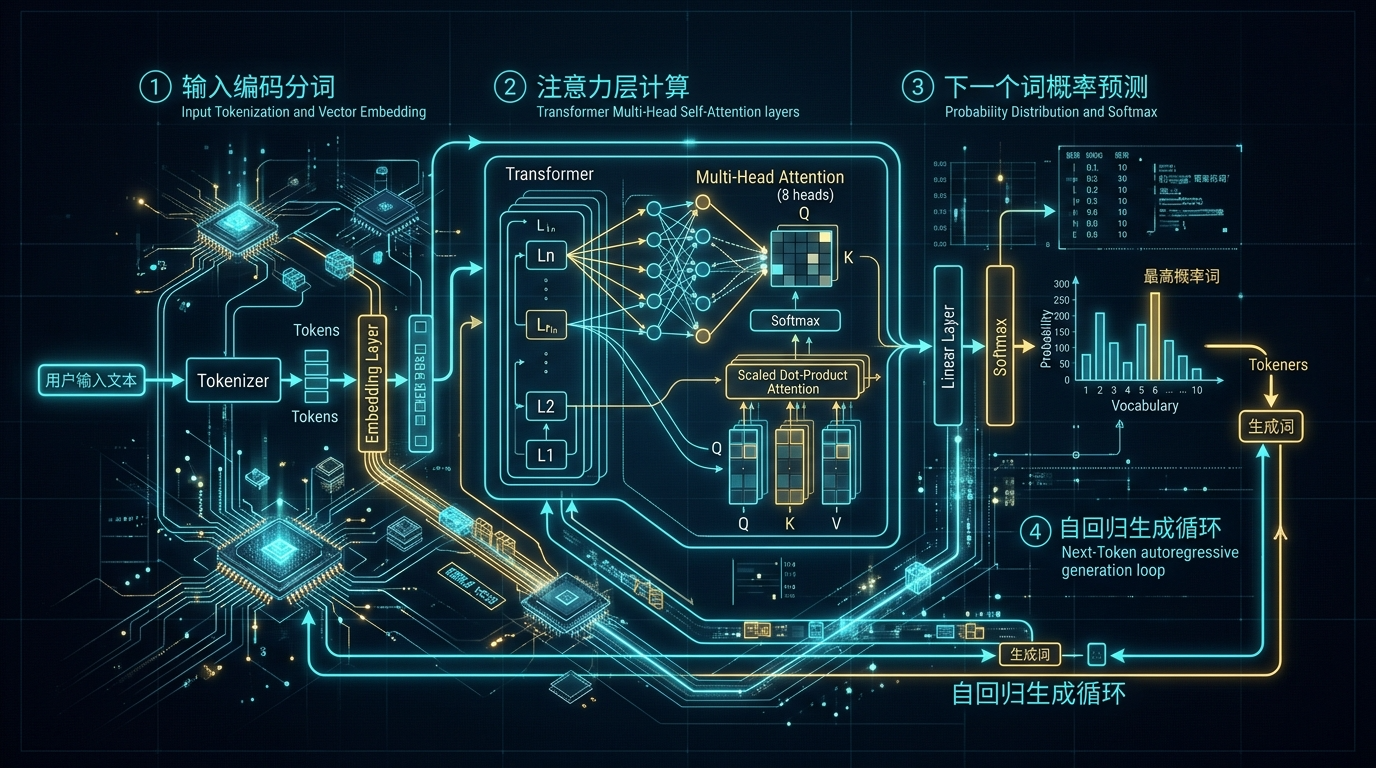
LLM 的核心任务很简单:给定前面的词序列,预测下一个最可能的词。比如输入“中国的首都是”,模型会输出一个覆盖整个词表的概率分布。采样算法按概率选中“北”,再把“北”加到序列末尾,继续预测“京”,如此循环直到结束。
为了控制输出风格,推理时会引入温度系数和 Top-p 采样。低温让模型更确定(倾向于高概率词),高温增加随机性;Top-p 则只保留累计概率达阈值的词,避免低质量长尾选项。
Transformer 与自注意力机制
LLM 强大的关键在于 Transformer 架构。它用自注意力机制让每个词都能关注上下文中的所有其他词。
具体来说,每个词被转换成三个向量:Query(查询)、Key(键)和 Value(值)。通过计算 Query 和所有 Key 的相似度,得到注意力权重,再对 Value 加权求和。这样,“苹果”在“吃苹果”和“苹果手机”中会获得不同语义,因为它吸收了“吃”或“手机”的上下文信息。
相比早期的循环网络(RNN),Transformer 能并行处理整个序列,大大提升了训练效率。
从训练到推理的工程落地
一个可用的大模型要经历多个阶段,每个阶段目标不同。
预训练、微调与对齐
首先是无监督预训练:在万亿级文本上做自回归预测,让模型掌握语言基本规律和世界知识。产出的是基座模型,能续写但不会对话。
接着是有监督微调(SFT):用高质量问答对教模型理解人类指令。比如“写一首诗”对应一首诗,而不是继续写无关内容。这一步让模型具备交互能力。
最后是强化对齐(如 RLHF 或 DPO):通过人类对多个回答的偏好排序,训练奖励模型,再用强化学习微调主模型。目的是减少幻觉、遵守伦理,产出更安全可靠的结果。
推理加速与硬件依赖
推理阶段模型权重固定,主要开销是矩阵乘法。GPU 比 CPU 更适合这项任务,因为 GPU 有数千个计算核心,能并行处理大规模矩阵运算。
此外,自回归生成有个特点:每次预测新词时,都要重新计算之前所有词的注意力。为了避免重复劳动,现代推理引擎采用 KV Cache 技术——把历史词的 Key 和 Value 向量缓存在显存里,下次直接复用。这显著降低了延迟,但也大幅增加了显存占用,尤其是处理长文本时。
结语
人工智能的运行没有神秘可言。它是一套结合了高维空间拟合、矩阵变换、梯度优化和注意力机制的工程体系。模型通过海量数据学习统计规律,在特定任务上表现出类人的能力,但并不具备意识或理解力。理解这些底层机制,有助于我们更理性地看待 AI 的能力和局限。