大语言模型里的文本生成策略:从贪心搜索到核采样
大语言模型怎么“写”出一句话?
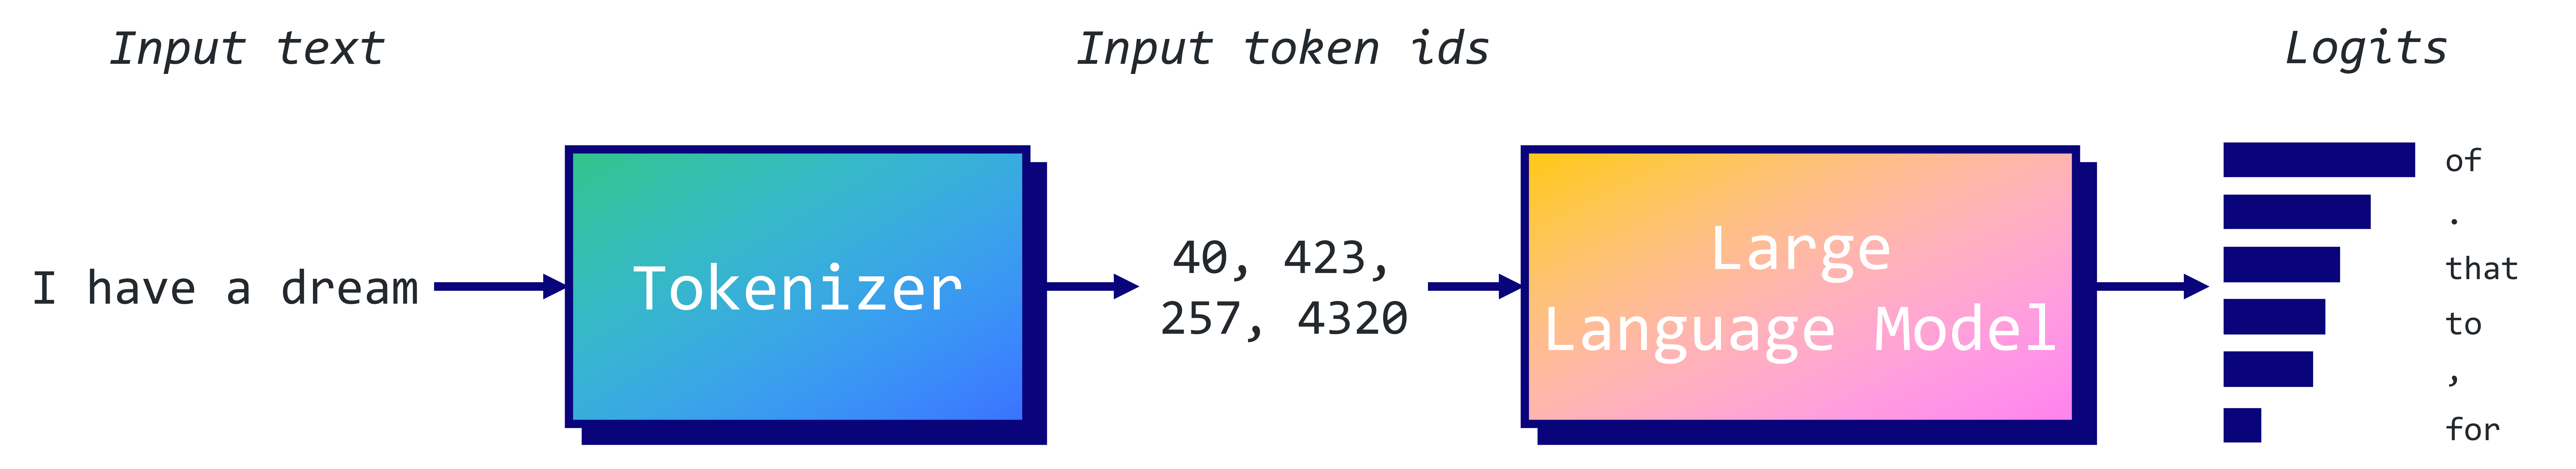
很多人以为像 GPT-2 这样的大语言模型是直接输出文字的。其实不是。它干的事更底层:给定前面的词,算出字典里每个可能的下一个词有多大概率出现。这个概率列表叫 logits,经过 softmax 转换后变成真正的概率分布。
比如输入“I have a dream”,模型会告诉你下一个词是“of”的概率是 17%,是“that”的概率是 8%,是“to”的概率是 5%……然后呢?选哪个?这就引出了解码策略的问题。不同的策略,决定了模型最终吐出哪句话。
本文用一个具体的例子——让 GPT-2 在“I have a dream”后面续写五个词——来拆解四种最常用的策略:贪心搜索、束搜索、Top-k 采样和核采样。你会看到它们各自的逻辑、结果差异,以及关键参数的实际作用。
贪心搜索:每次都选最可能的那个
贪心搜索(Greedy Search)是最简单的策略。它的规则就一条:在每一步,都选当前概率最高的那个词作为下一个词。
用我们的例子走一遍:
- 第一步:“I have a dream” → 最可能的词是 “ of”
- 第二步:“I have a dream of” → 最可能的词是 “ being”
- 第三步:“I have a dream of being” → 最可能的词是 “ a”
- 第四步:“I have a dream of being a” → 最可能的词是 “ doctor”
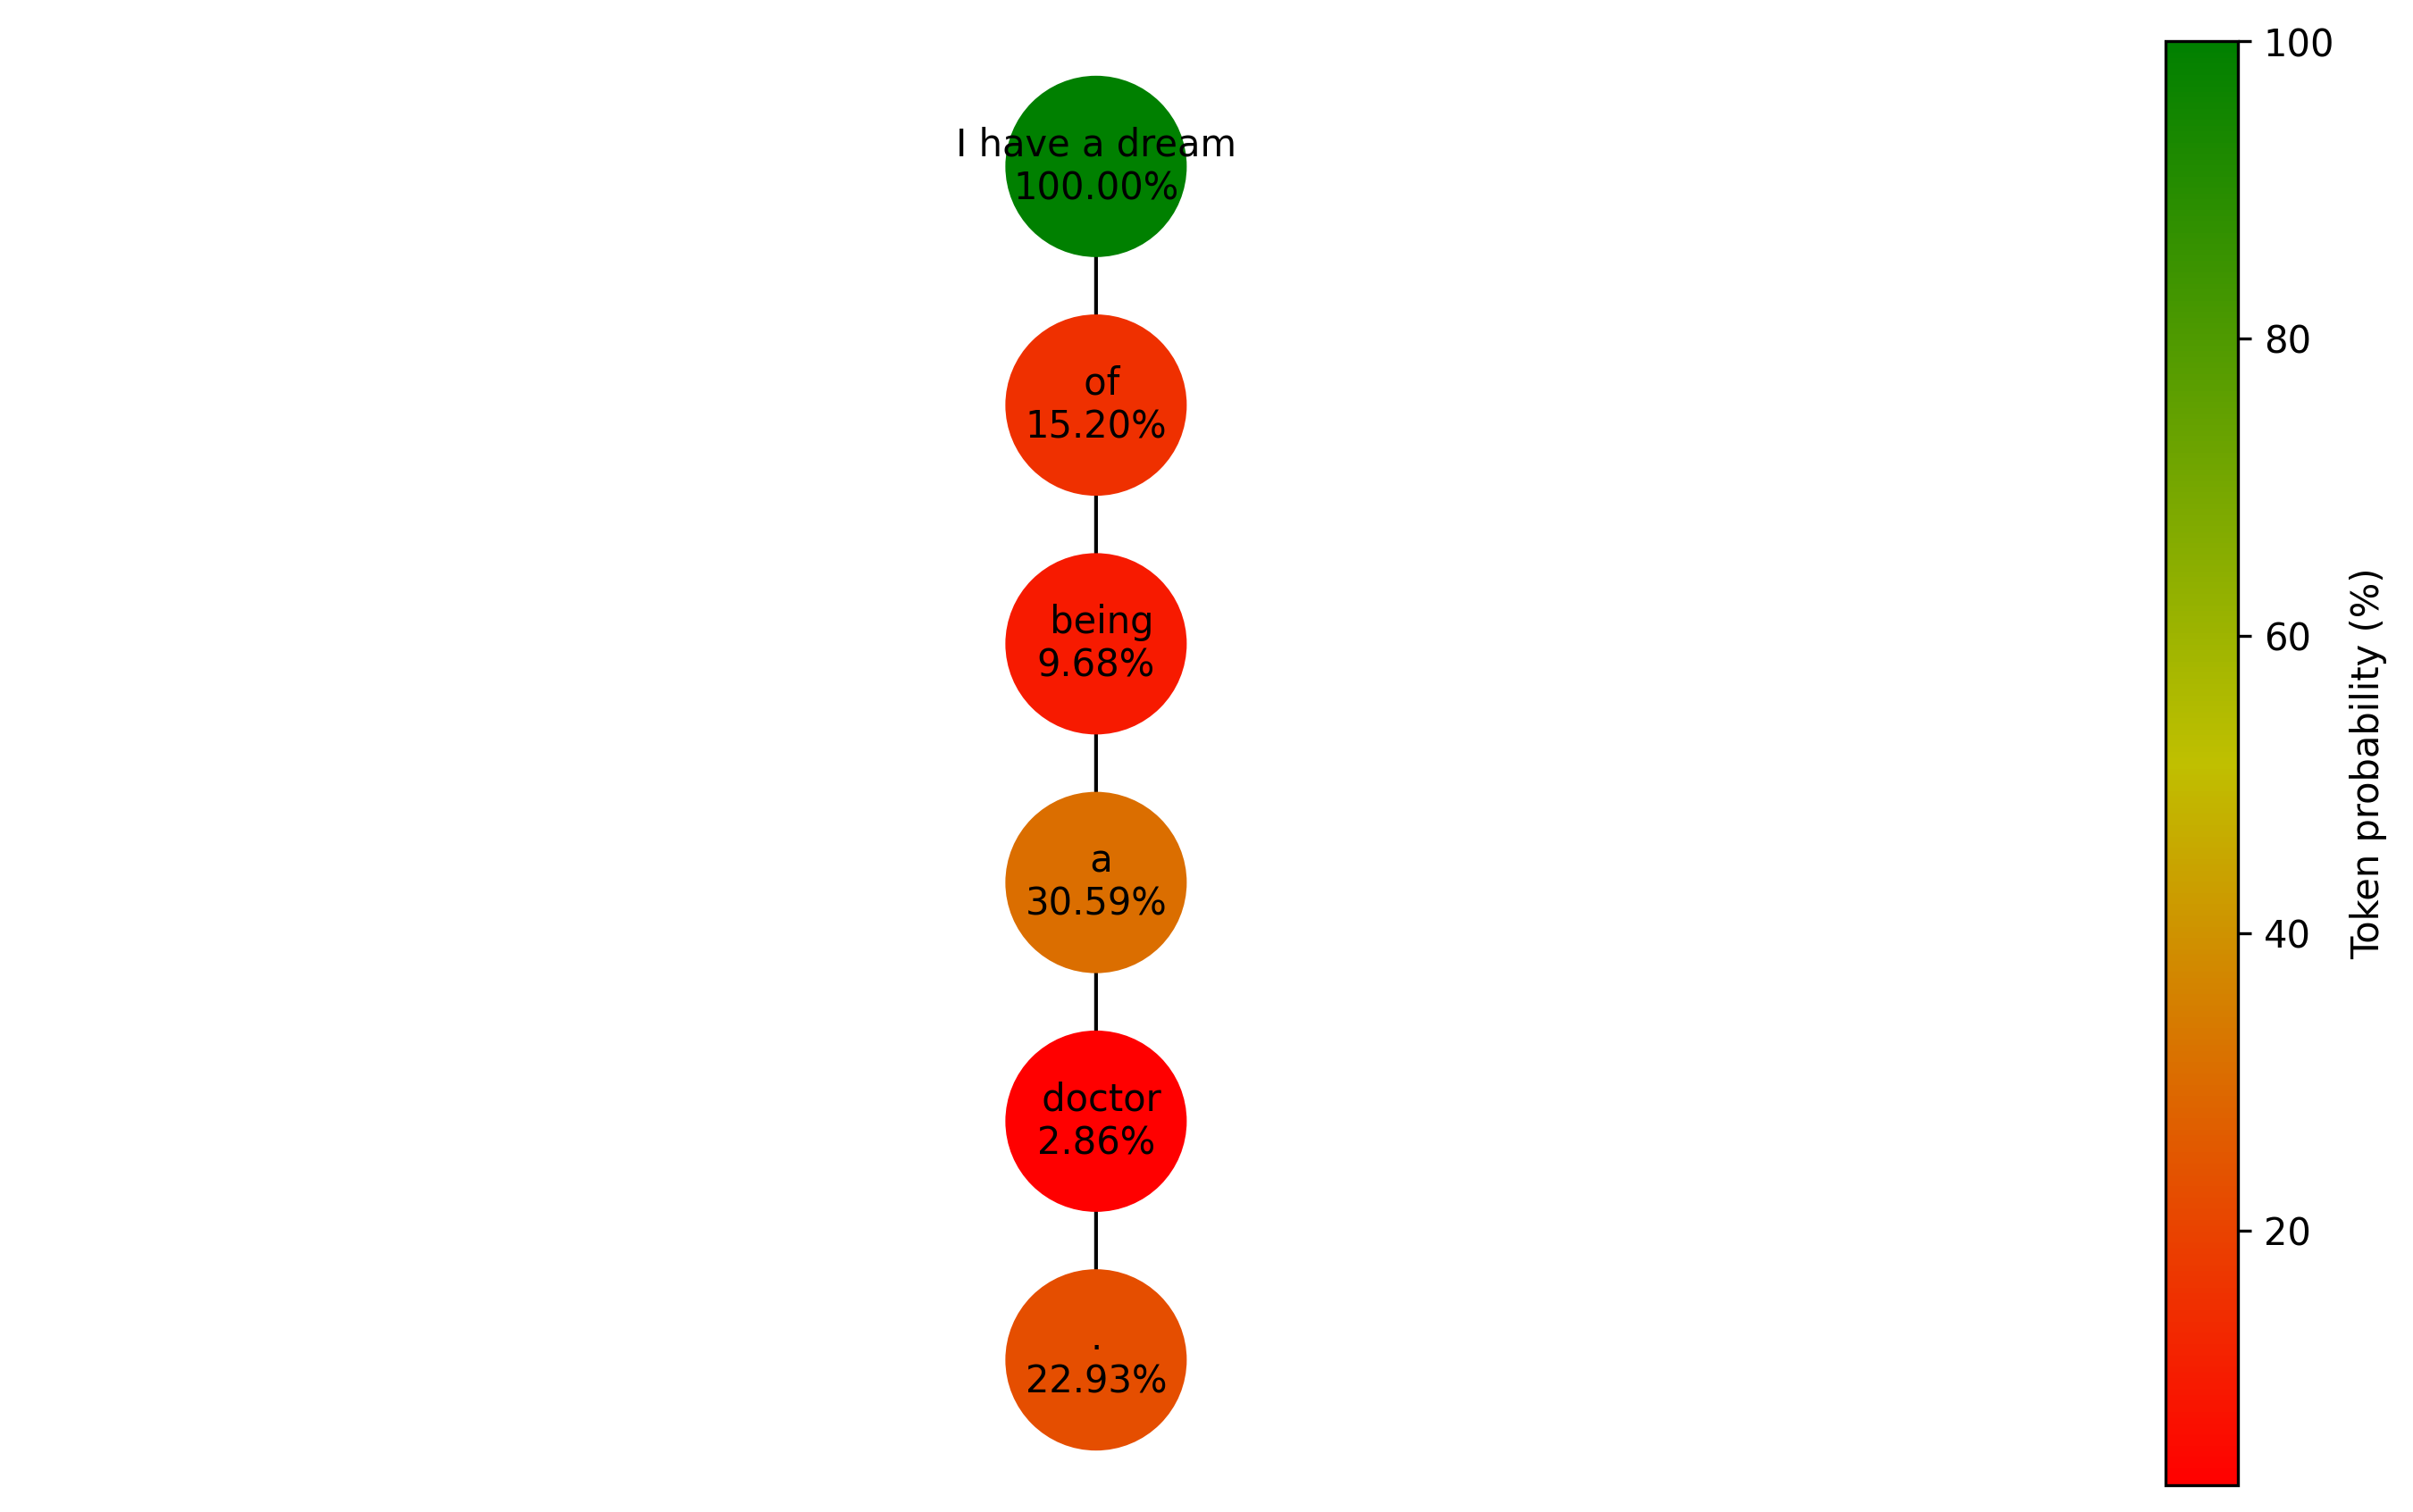
- 第五步:“I have a dream of being a doctor” → 最可能的词是 “.”
最终生成:“I have a dream of being a doctor.”
听起来很合理,对吧?但问题在于,贪心搜索是“短视”的。它只看眼前这一步,不考虑长远。虽然每一步都是局部最优,但组合起来未必是全局最好的句子。
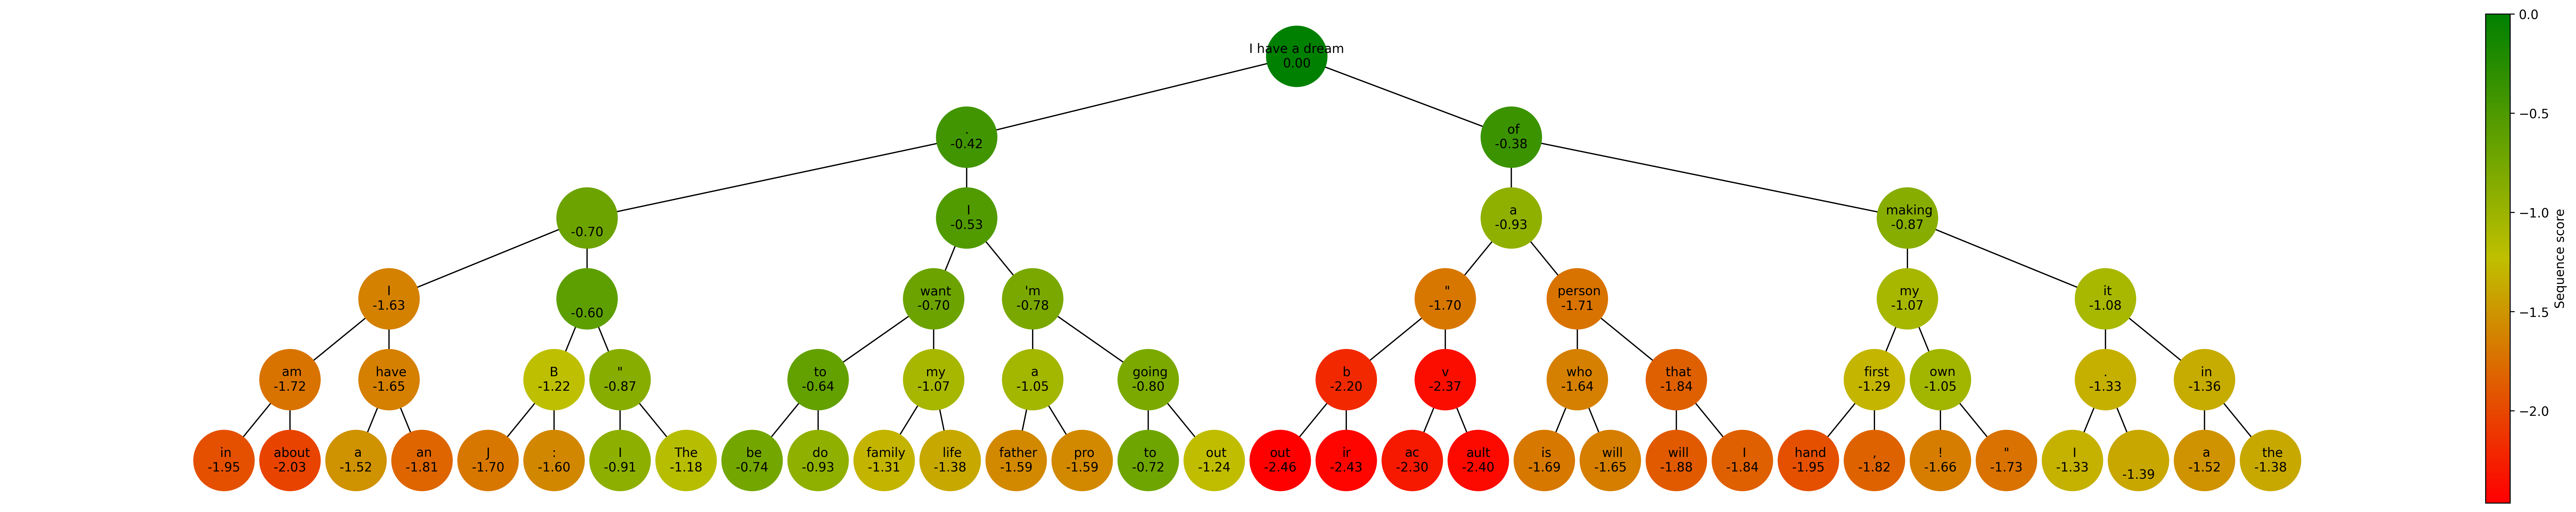
可视化一下这个过程就能发现问题。在生成“being”这个词时,它的概率其实只有 9.68%;而“doctor”的概率更是低至 2.86%。这意味着,第一步选了看似最稳妥的“of”,却把整个句子带进了一个越来越不确定的境地。如果第一步选一个概率稍低但能开启更多可能性的词,后面或许能生成更流畅、更自然的句子。
贪心搜索的优点是快、省资源,因为它永远只跟踪一条路径。但代价就是缺乏创造性和多样性,容易陷入重复或平庸。
束搜索:多看几条路,再选最好的
为了解决贪心搜索的短视问题,束搜索(Beam Search) 出现了。它的核心思想是:别只盯着一条路,同时探索多条最有希望的路径。
这里的“束”(beam)指的就是你愿意同时跟踪的路径数量,由 num_beams 参数控制。比如 num_beams=2,意思是在每一步都保留两个当前得分最高的候选序列。
具体怎么做?模型依然会计算所有词的概率,但它会选出前两名,分别把它们加到现有的两个序列后面,形成四个新序列。然后,它会根据整个序列的累积得分(通常是所有词 log 概率的总和,再除以长度做归一化,防止偏向长句子),从中再选出两个得分最高的,进入下一步。
这个过程一直持续到生成结束符或达到最大长度。最后,从所有存活到最后的序列里,挑出总分最高的那个作为最终输出。
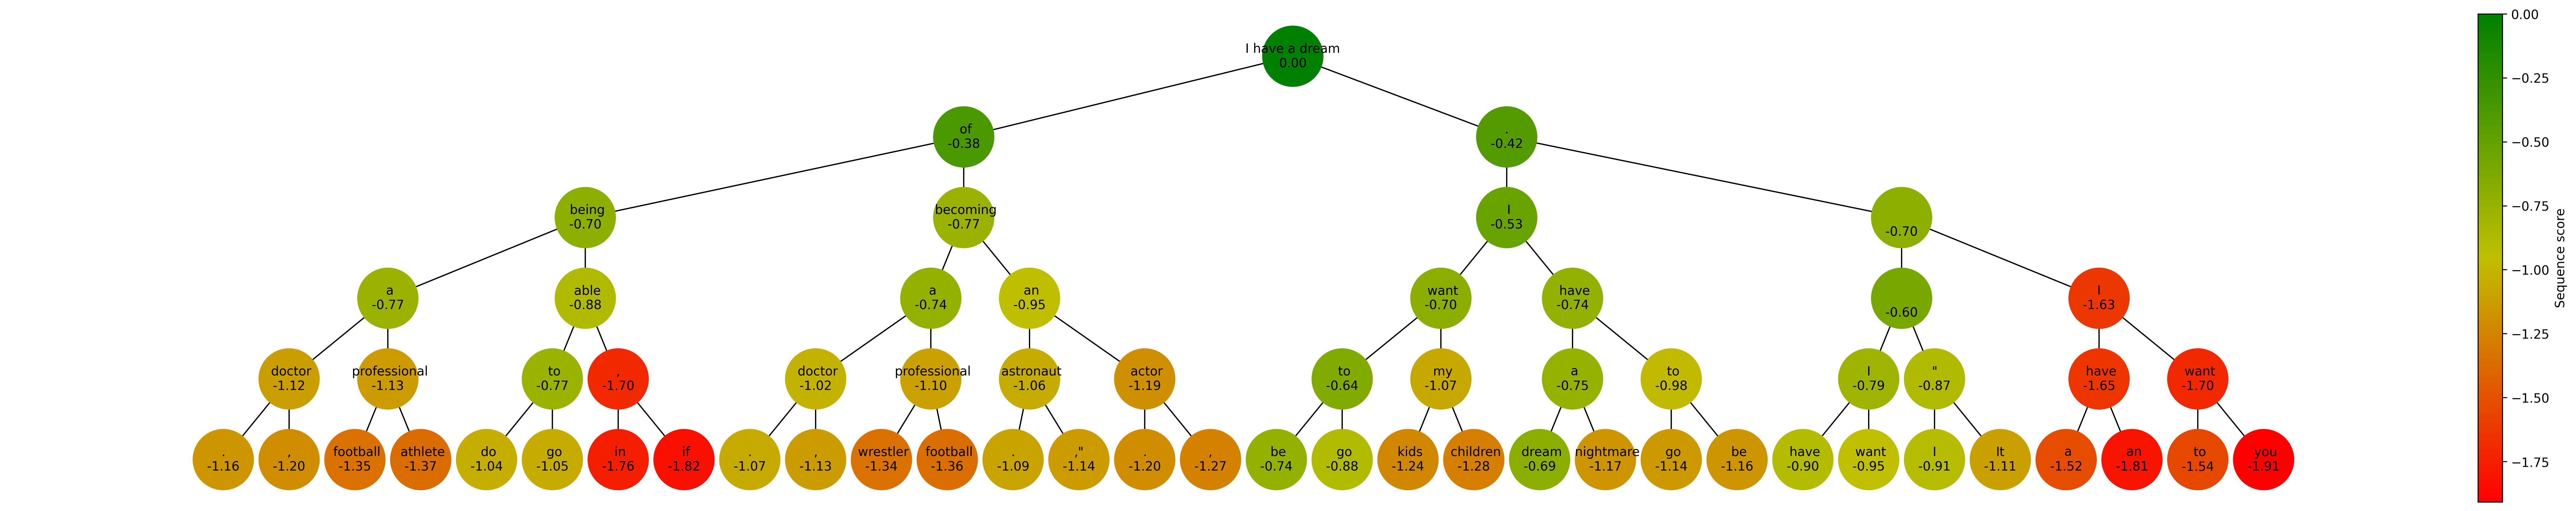
用同样的例子,当 num_beams=2 时,GPT-2 生成的结果是:“I have a dream. I have a dream”。
这个结果有点奇怪,但却是 GPT-2 的一个经典“怪癖”。从得分上看,这条路径的序列得分(-0.69)确实比贪心搜索那条(-1.16)要高。这说明束搜索成功地找到了一个在模型看来“整体更优”的序列。
然而,这个“更优”是基于模型内部的概率计算,不一定符合人类的语感。束搜索虽然比贪心搜索看得更远,但它依然是在确定性的框架下工作,追求的是概率最大化,而不是多样性或创造性。所以它常常会生成非常保守、甚至重复的文本。
Top-k 采样:在前 k 个里随机挑
如果我们想要更有创意、更多样的输出,就需要引入随机性。这就是采样(Sampling)类策略的用武之地。
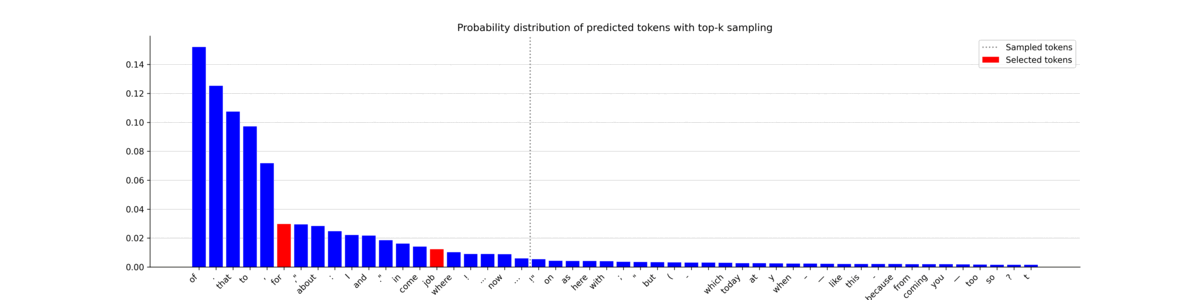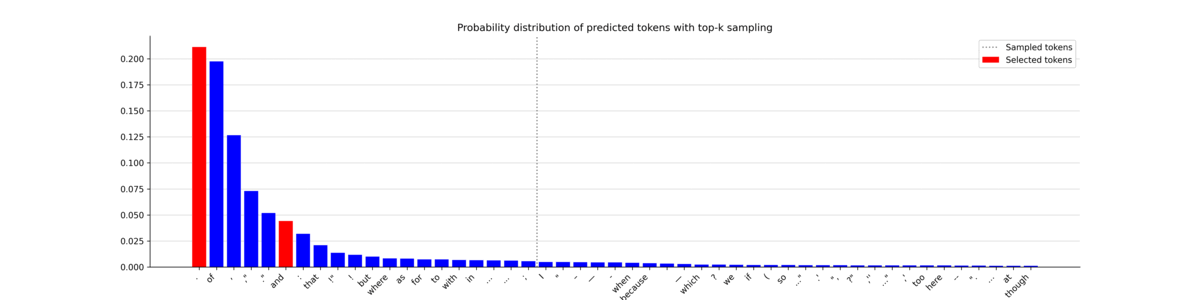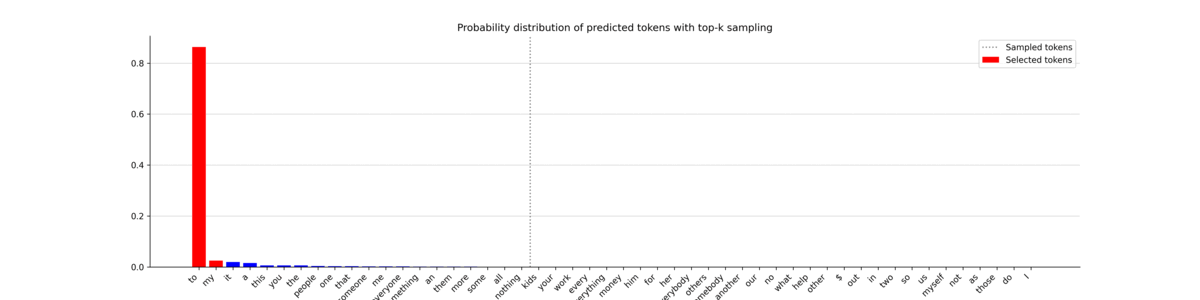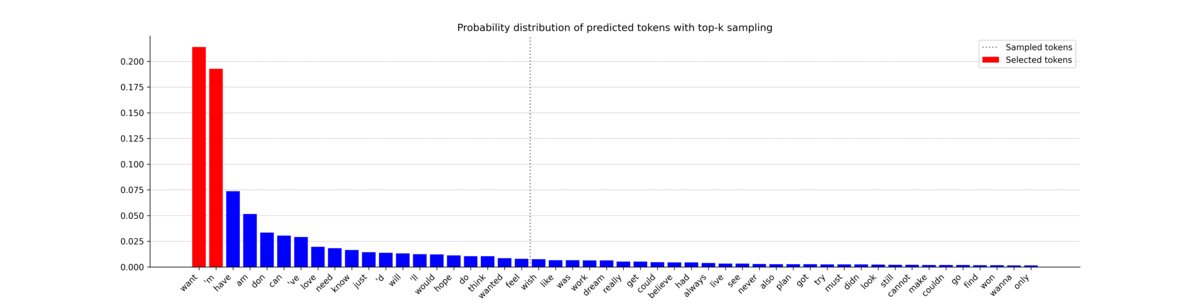
Top-k 采样的做法是:先选出概率最高的 k 个词,把其他所有词的概率直接设为零,然后在这个缩小后的集合里,根据它们的相对概率进行随机选择。
举个例子,假设 k=3,四个词 A、B、C、D 的原始概率分别是 30%、15%、5%、1%。Top-k 会先把 D 踢出去,然后把 A、B、C 的概率重新归一化为 60%、30%、10%,再按这个新概率去抽签。
这样做的好处很明显:既保证了不会选到完全离谱的词(因为只从前 k 个里选),又引入了不确定性,让每次生成的结果都有所不同。
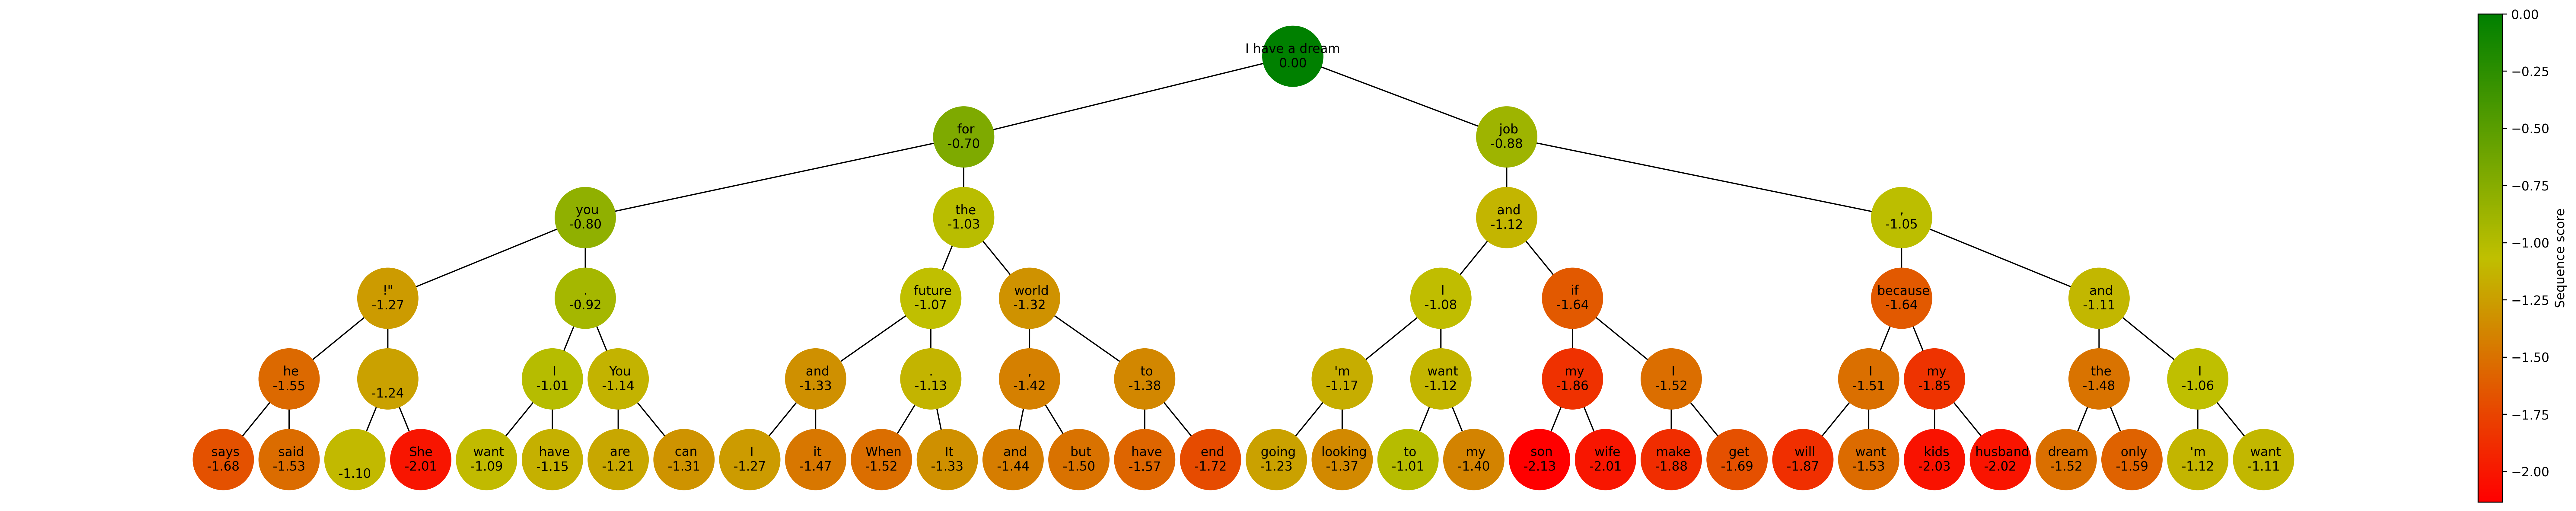
在我们的实验中,使用 Top-k 采样(k=20)后,模型生成了:“I have a dream job and I want to”。这句话比之前两个结果都要自然得多,也更有“人味”。
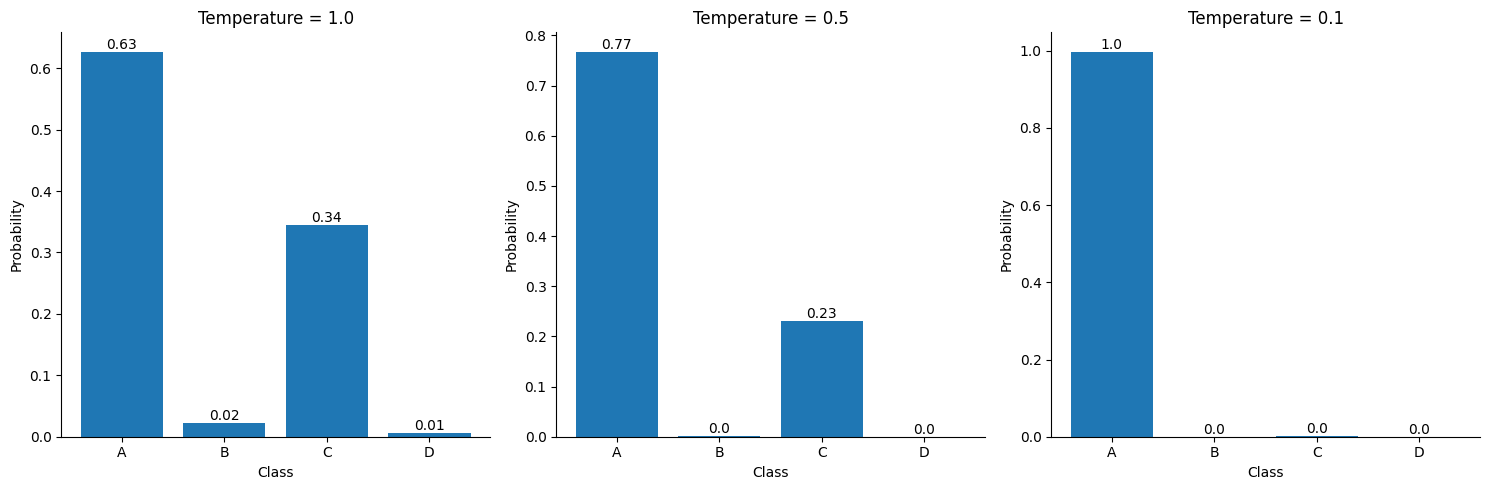
这里还有一个关键参数:温度(Temperature)。温度控制着概率分布的“尖锐”程度。温度越低(接近0),概率分布越集中,模型越倾向于选最高概率的那个词,行为就越接近贪心搜索。温度越高(接近1或更高),概率分布越平缓,低概率的词也有更大机会被选中,输出就越有创意(但也可能更离谱)。通常,我们会把温度设在一个适中的值(比如 0.7 到 1.0)来平衡创造力和连贯性。
核采样(Top-p):动态决定候选池大小
Top-k 有个小缺点:k 是个固定值。但在不同上下文下,模型的置信度是不一样的。有时候它对下一个词非常确定(比如概率第一的词占了 80%),这时候 k=10 可能就包含了太多垃圾选项。有时候它很犹豫(比如前十个词的概率都差不多),这时候 k=10 又可能不够用。
核采样(Nucleus Sampling),也叫 Top-p 采样,就是为了解决这个问题。它不固定候选词的数量,而是固定一个累积概率阈值 p。
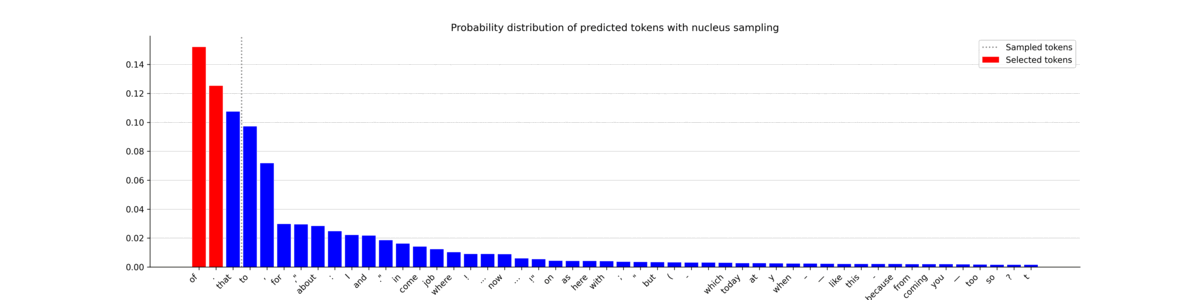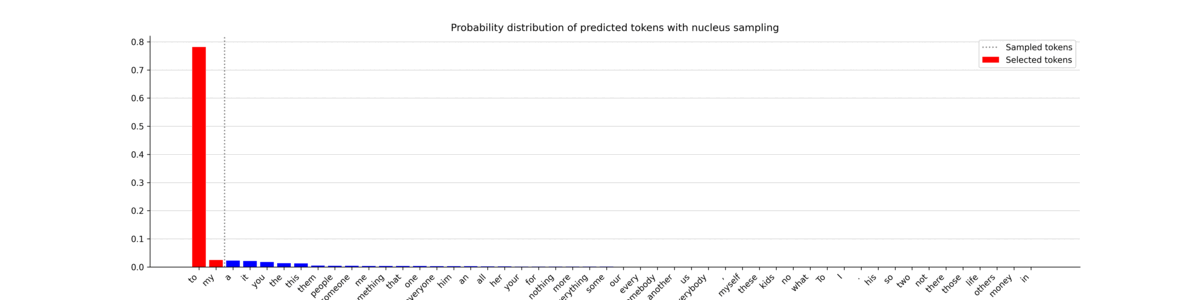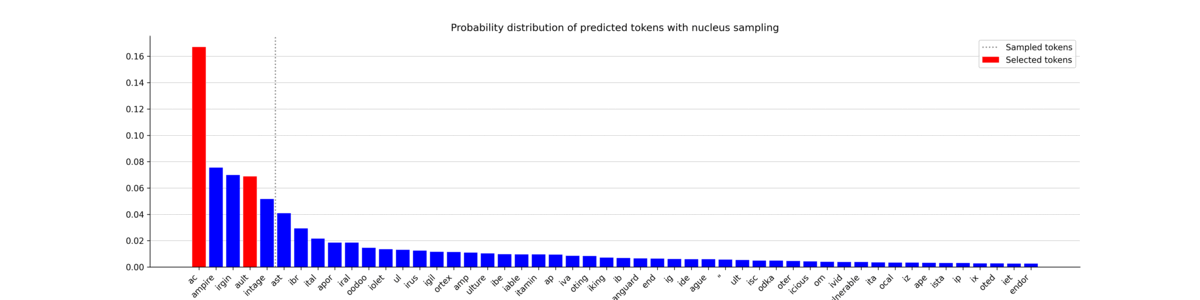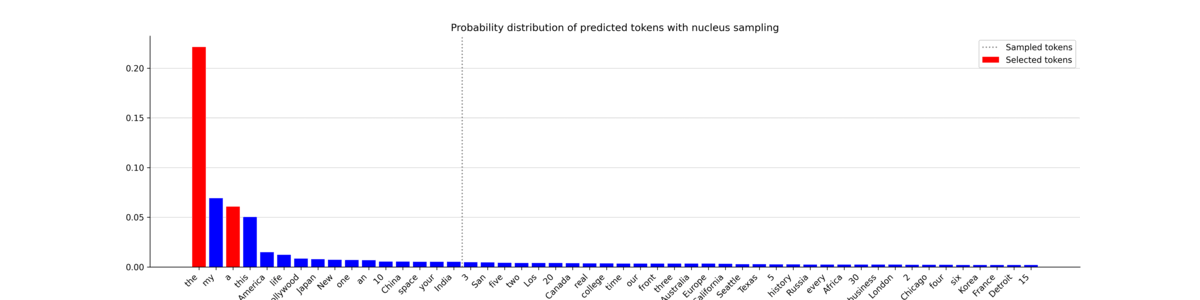
具体做法是:把所有词按概率从高到低排序,然后从头开始累加,直到累积概率超过 p。所有被加进来的词构成一个“核”(nucleus),然后就在这个核里进行随机采样。
比如 p=0.9,如果排第一的词概率是 60%,第二是 30%,那么这两个词的累积概率就是 90%,刚好达到阈值。于是候选池就只有这两个词。如果排第一的词只有 20% 的概率,那么可能需要把前二十个词都加起来才能超过 90%,这时候候选池就很大。
这种动态调整的方式,让模型在自信时更专注,在犹豫时更开放,通常能产生质量更高、更多样的文本。
在我们的例子中,使用核采样(p=0.5)后,模型生成了:“I have a dream. I'm going to”。这个结果不仅避免了束搜索的重复问题,也比贪心搜索的结果更灵活,展现了核采样的优势。
如何选择适合你的策略?
没有一种策略是万能的,选择取决于你的具体需求:
- 追求速度和确定性:用贪心搜索。适合那些对输出一致性要求极高、且上下文非常明确的任务,比如代码补全。
- 追求质量和连贯性,可以接受一点重复:用束搜索。在机器翻译等任务中表现很好,因为它能找到整体上最“安全”的句子。
- 追求创造力和多样性:用采样。无论是 Top-k 还是 Top-p,都能带来惊喜。其中,Top-p(核采样)通常被认为是更优的选择,因为它能自适应地调整候选池,效果往往比固定 k 值的 Top-k 更稳定。
在实际应用中,你往往会组合使用这些参数。比如,设置 temperature=0.8, top_p=0.9,这样既能控制整体的随机性,又能利用核采样的动态优势。
理解这些底层机制,能让你在调用大模型 API 时,不再是盲目地试错,而是有目的地去引导模型,让它为你生成真正想要的内容。