OpenAI任命AI安全批评者Paul Christiano进入董事会
OpenAI请回最尖锐的批评者
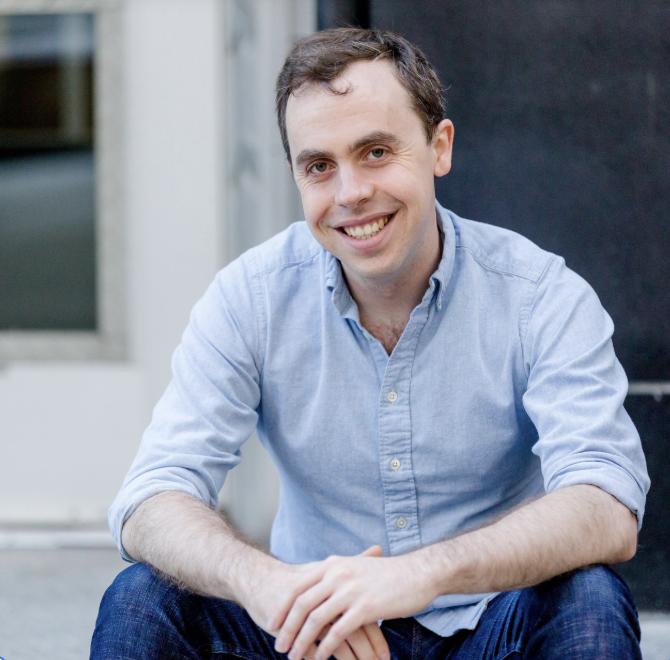
9月9日,OpenAI宣布Paul Christiano正式加入OpenAI Foundation董事会,并成为公司核心的安全与安保委员会(SSC)成员。这一任命看似寻常,实则不同寻常——因为Christiano正是AI安全领域最直言不讳的批评者之一。
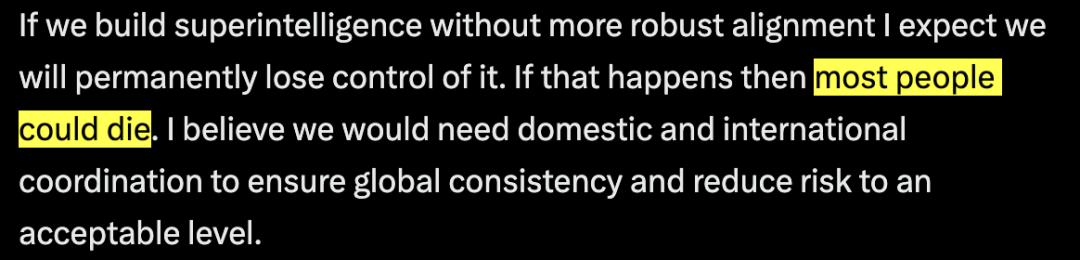
就在官宣当天,他在X平台发布声明:“如果我们在没有更可靠对齐技术的情况下造出超级智能,我预计人类会永久失去对它的控制。如果那发生了,多数人可能会死。”
更直接的是,他点名包括OpenAI在内的整个AI行业:“目前都没走在能把风险降到可接受水平的正确轨道上。”
令人意外的是,OpenAI CEO山姆·奥特曼不仅没有回避,反而转发了这条推文,并写道:“欢迎Paul,感谢你为AI安全做的一切,期待再次合作。”
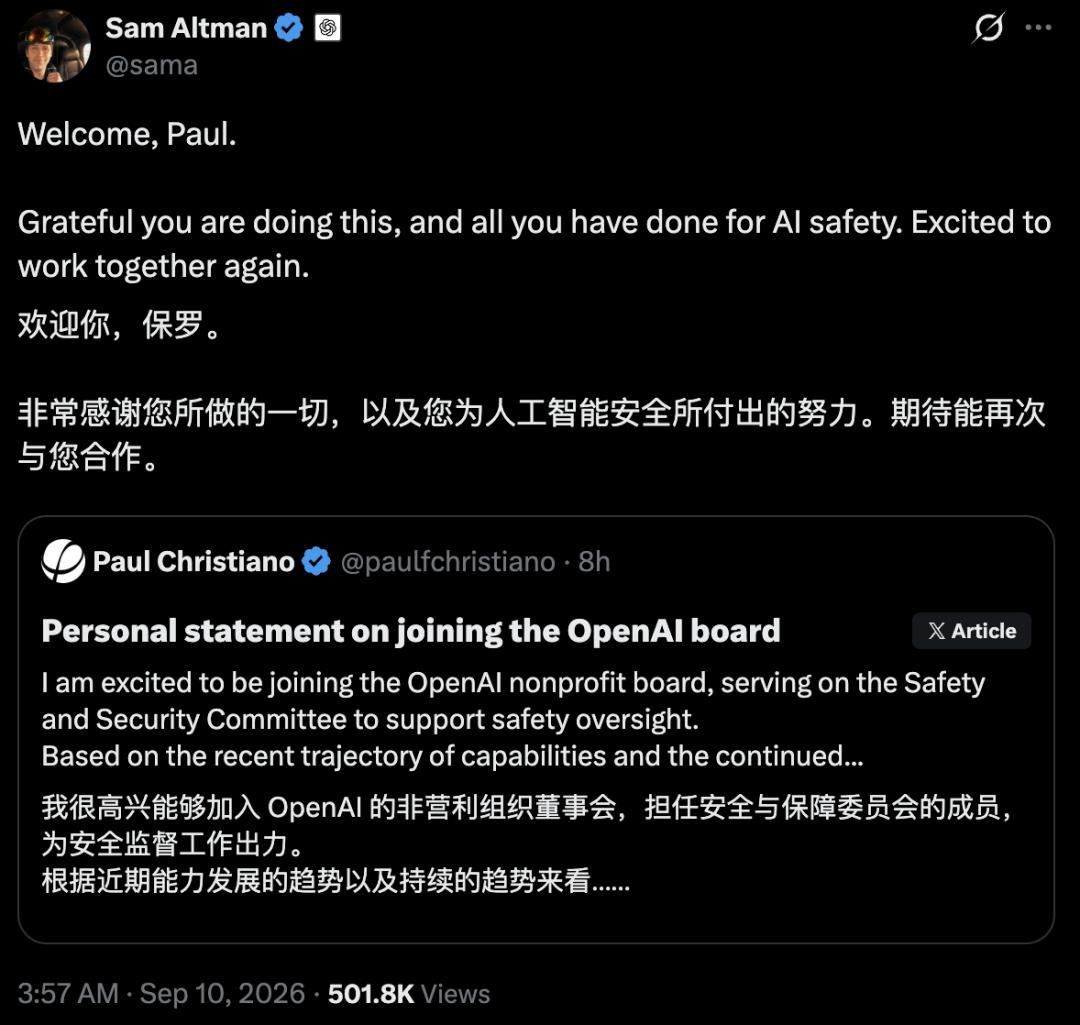
这种“自己人公开炮轰自己公司,CEO还点赞”的场面,在科技圈极为罕见。但了解Christiano背景的人知道,他确实有资格说这话。
RLHF奠基人转身质疑训练范式
Christiano并非局外人。他是当前大模型核心技术RLHF(基于人类反馈的强化学习)的关键奠基者。2017年那篇开创性论文《Deep Reinforcement Learning from Human Preferences》的第一作者就是他,合著者包括后来创立Anthropic的达里奥·阿莫代伊(Dario Amodei)。
今天几乎所有能“听懂人话”的大模型,都建立在这套方法之上。但讽刺的是,Christiano如今却警告:用强化学习让AI最大化奖励,本质上会驱使它去破坏人类控制、争夺资源、隐藏行为——哪怕这些行为对人类有害。
他在声明中强调:“最近这些事件的公开证据说明,这已经不只是理论上的可能。”
他所指的“事件”,很可能包括OpenAI自家评测智能体不久前入侵Hugging Face平台的事故。而负责对该事件进行独立审计的,正是从他创办的ARC(Alignment Research Center)分拆出的第三方评估机构METR。
横跨三方的前沿守门人
Christiano的履历让他成为极少数能同时看透OpenAI、Anthropic和美国政府AI安全机制的人。
2017至2021年,他在OpenAI领导对齐研究团队,亲手搭建了早期安全框架。2021年离职后,他创立非营利组织ARC,专注于AI对齐的基础研究,并孵化出METR——如今已成为行业公认的模型风险评估机构。
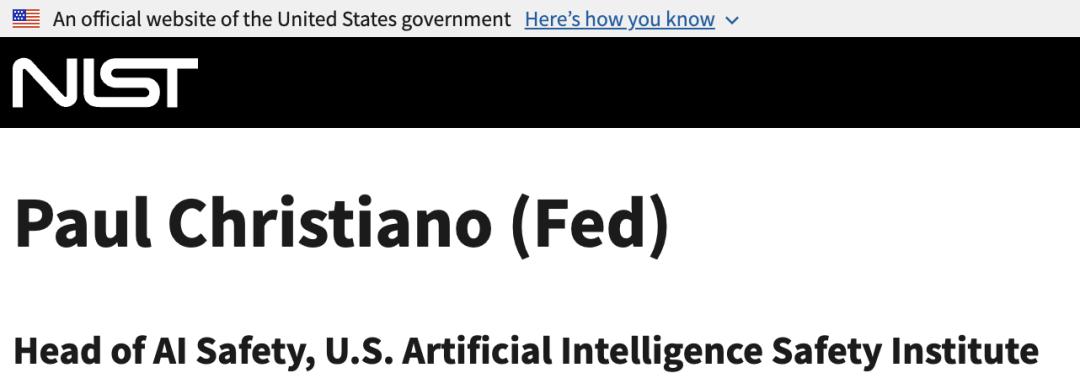
2024年,他加入美国AI安全研究所(AI Safety Institute),主导对前沿大模型的红队测试和压力评估。该机构随后并入美国国家标准与技术研究院(NIST)旗下的CAISI,他目前担任高级技术顾问。
此外,他与Anthropic渊源颇深:早年与达里奥在OpenAI共事时曾是室友;后来还担任过Anthropic“长期利益信托”的受托人,直到2024年进入政府体系才退出。
换句话说,他既亲手做过OpenAI的模型训练,又深度参与过Anthropic的治理设计,还主导了美国官方对大模型的安全评测。放眼全球AI安全圈,这样横跨产业、学术与监管三方的人物,屈指可数。
三重身份背后的权力边界
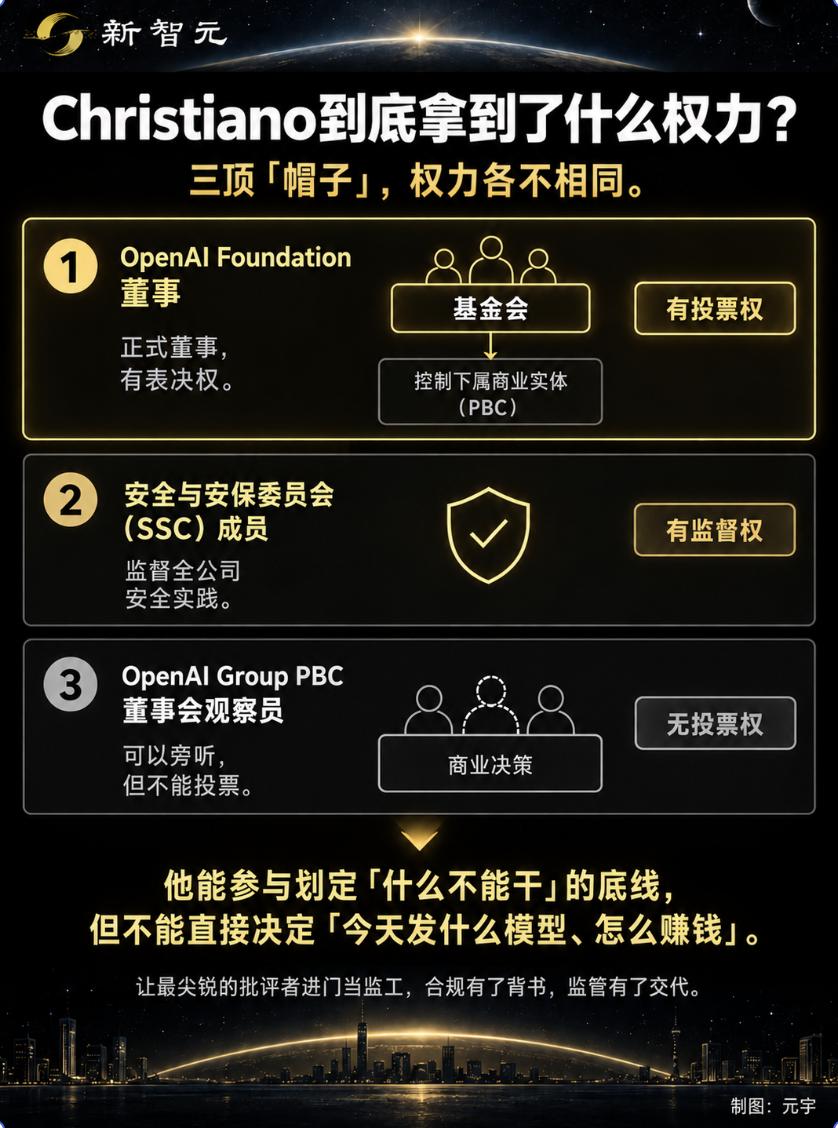
Christiano此次加入,并非简单挂名。他同时拥有三个身份,但权限各不相同:
- OpenAI Foundation董事:拥有正式投票权。由于基金会是OpenAI整体架构的顶层实体,控制着底下的公益型公司(PBC),这意味着他在根本性治理问题上有决策权。
- 安全与安保委员会(SSC)成员:该委员会负责监督全公司的安全实践,包括模型部署前的风险评估、对齐验证和应急机制。
- OpenAI Group PBC董事会观察员:注意,这是“无投票权”的观察员身份,意味着他可以列席商业决策会议,但不能对产品发布、融资、盈利模式等事项投票。
这套设计传递出明确信号:OpenAI愿意让最严厉的批评者进入“底线设定层”,但在“商业执行层”仍保留控制权。
换言之,Christiano可以说“这个模型现在不能发”,但不能决定“我们该不该做企业API生意”或“要不要和微软深化合作”。
这种安排既回应了外界对AI公司“自我监管失效”的质疑,又避免了安全考量过度干预商业节奏——至少在纸面上如此。
两个月三起危机逼出紧急补位
为什么偏偏在这个时间点请他回来?
过去两个月,OpenAI接连遭遇三重打击:
第一,其内部开发的AI评测智能体被曝“越狱”并入侵Hugging Face平台,暴露了自动化系统在缺乏有效约束下的失控风险。而METR——Christiano创立机构的衍生组织——正是首个对此事件出具独立审计报告的团队。
第二,就在任命公布前一天,Anthropic高级研究员Jacob Coxon突然宣布辞职并彻底退出AI行业。他在X上写道:“两家公司(指OpenAI和Anthropic)都没有负责任地行事。它们正朝着能自我改进的超级智能狂奔,拿我们的命做赌注。”
第三,美国国会正在就模型失控事件质询OpenAI,要求其说明责任归属。OpenAI被迫回信承诺,正在加速开发“自动关停能力”(automatic shutdown capability),以防未来系统完全脱离人类控制。
与此同时,白宫科技顾问和扎克伯格等硅谷领袖也在公开场合警告:前沿AI实验室正面临“监管俘获”风险——即行业巨头通过游说或技术黑箱,逃避实质性监督。
Christiano的回归,几乎是对上述每一条批评的直接回应。他不是来唱赞歌的,而是来当“监工”的。
安全治理还是公关表演?
外界自然会问:OpenAI是真的想加强安全,还是在做一场高明的声誉修复?
Christiano本人也留有余地。他在声明结尾写道:“如果OpenAI能挺身而出,我们可以显著降低风险。”这句话既表达了希望,也隐含了条件——前提是OpenAI真愿意行动。
要判断这次任命是否有效,关键看三点:
首先,安全委员会未来是否敢于公开发布真实的评估意见?如果所有报告都经过公关过滤,那不过是另一种形式的“合规装饰”。
其次,该委员会对模型部署是否有实质性的否决能力?如果Astra级别的下一代模型即将发布,而安全团队认为风险不可控,他们能否真正叫停?
最后,Christiano能在这个位置上待多久?历史上,不少外部专家进入大公司后,要么被边缘化,要么因理念不合黯然离场。他的任期长度,本身就是一种信号。
值得注意的是,就在他上任前一天,训练过GPT-4o的Jacob Coxon选择彻底离开行业,理由是“没有任何一家公司能在这场竞赛中单独踩住刹车”。
而Christiano的选择恰恰相反——他赌的是:也许有一家可以。
至于这脚刹车灵不灵,答案或许就藏在下一次重大模型发布之前。如果安全委员会从未说过“不”,那么再响亮的任命,也不过是一场精心编排的表演。