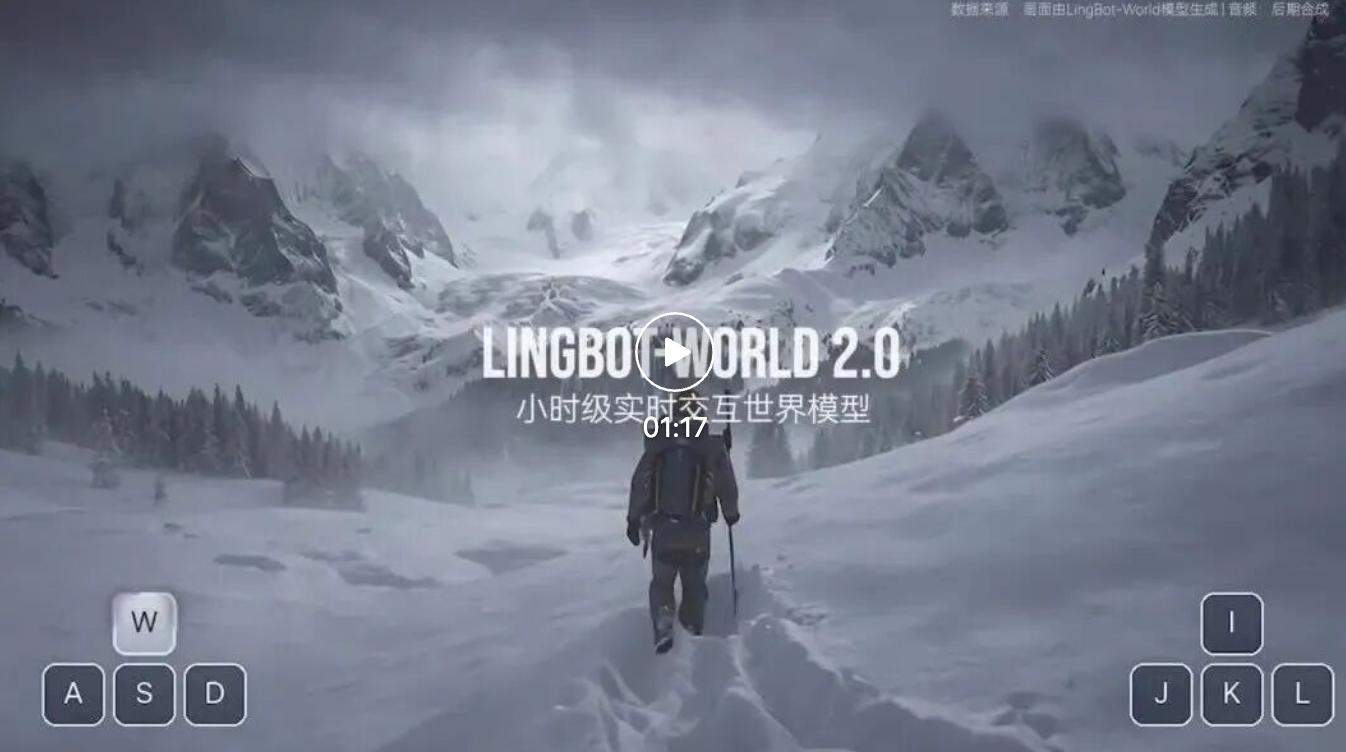
1.3B参数世界模型LingBot-World 2.0轻量版开源,单卡可实时运行
1.3B也能跑世界模型?真的可以
过去提到世界模型,大家默认得有高端服务器、多张A100,或者至少能连上云端API。但最近,蚂蚁灵波团队把门槛拉低到了一张普通显卡——他们开源了LingBot-World 2.0的轻量版,参数规模仅1.3B,却能在本地实现实时、持续、可交互的世界生成。
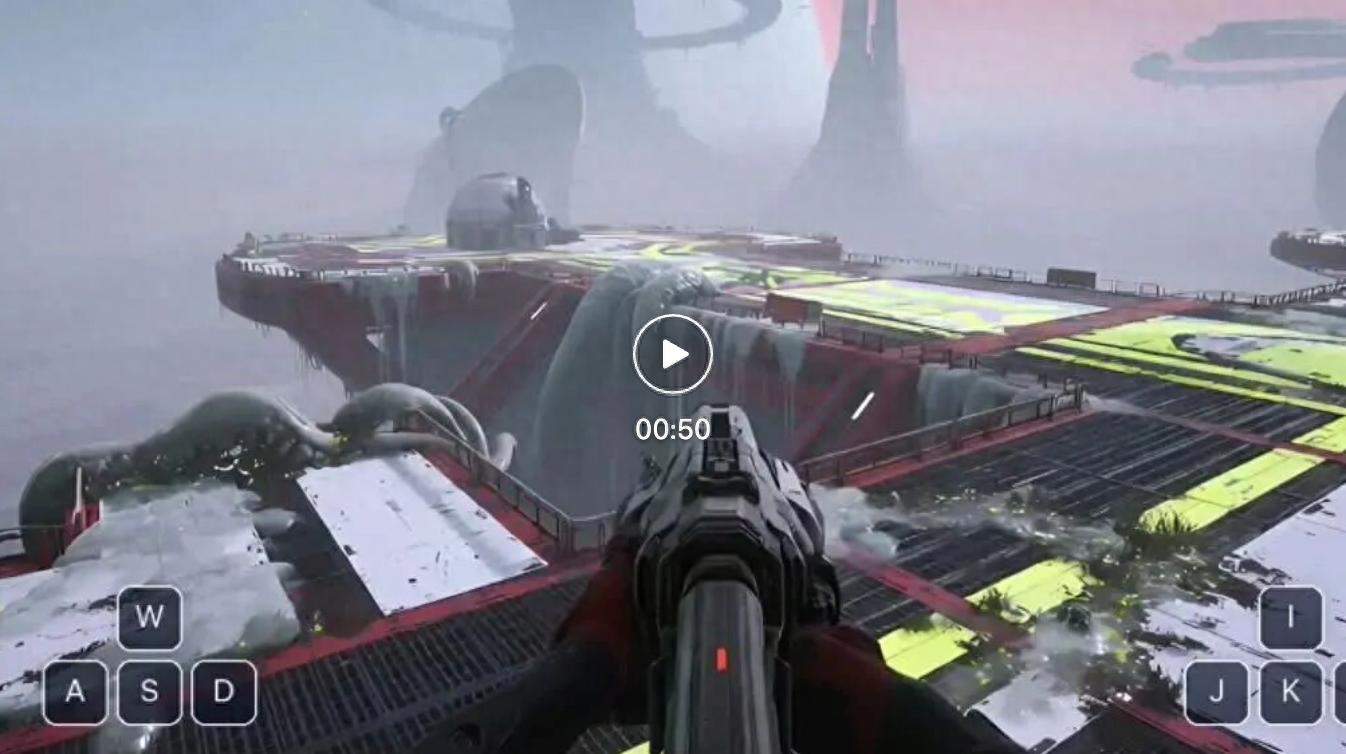
什么叫“世界模型”?简单说,它不是生成一段固定视频就完事,而是构建一个能随用户操作不断演进的虚拟环境。比如你控制角色向前走,场景就得跟着展开;转头看左边,画面要即时响应;开枪后要有爆炸、火焰、护盾反馈,而且这些变化都发生在同一个逻辑连贯的空间里。
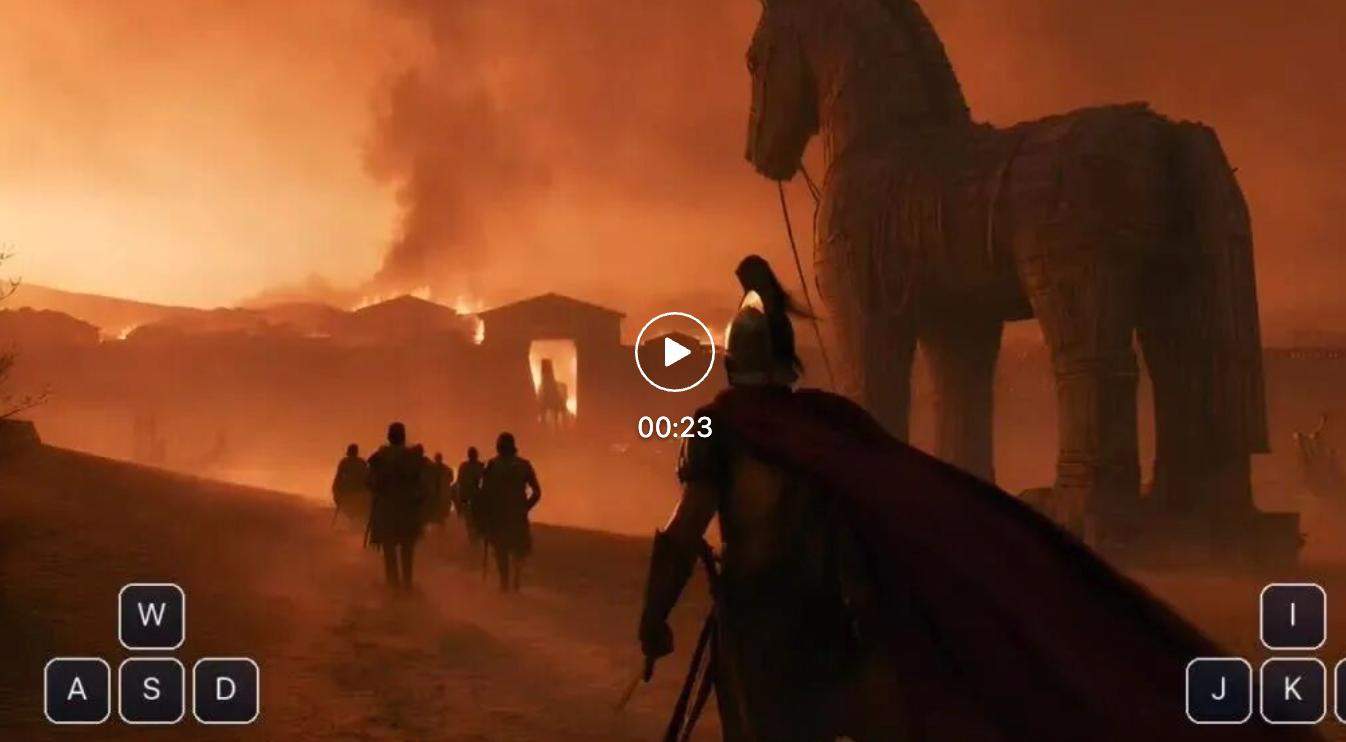
官方放出的三个Demo展示了不同风格:雪地科幻战场(第一人称射击)、《奥德赛》式古城探索(第三人称)、以及另一种艺术化场景。无论哪种,角色移动时近景、中景、远景都能同步更新,空间关系基本不崩。
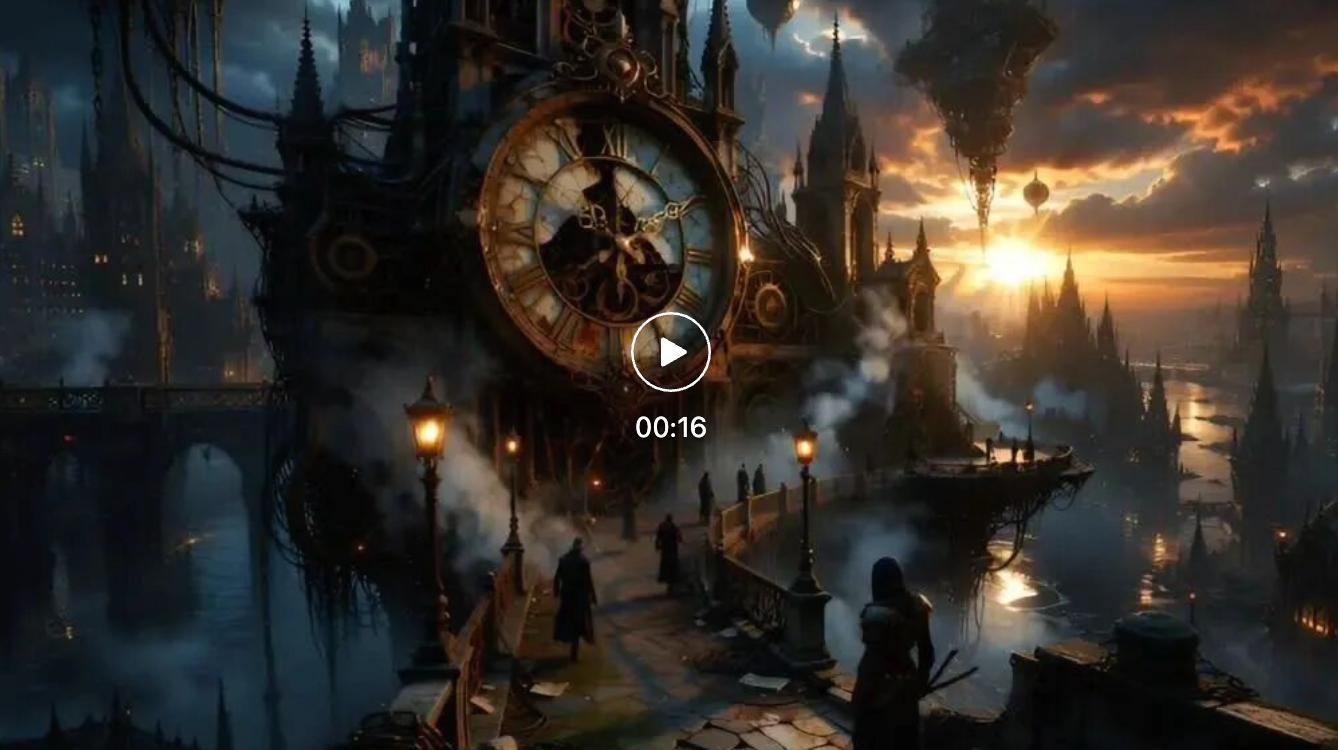
最关键的是,这一切不需要联网,也不依赖远程服务器——只要你有一张主流消费级显卡(比如RTX 4070级别或更高),就能在本地跑起来。
不是“砍小”的大模型,而是一整套新训练链路
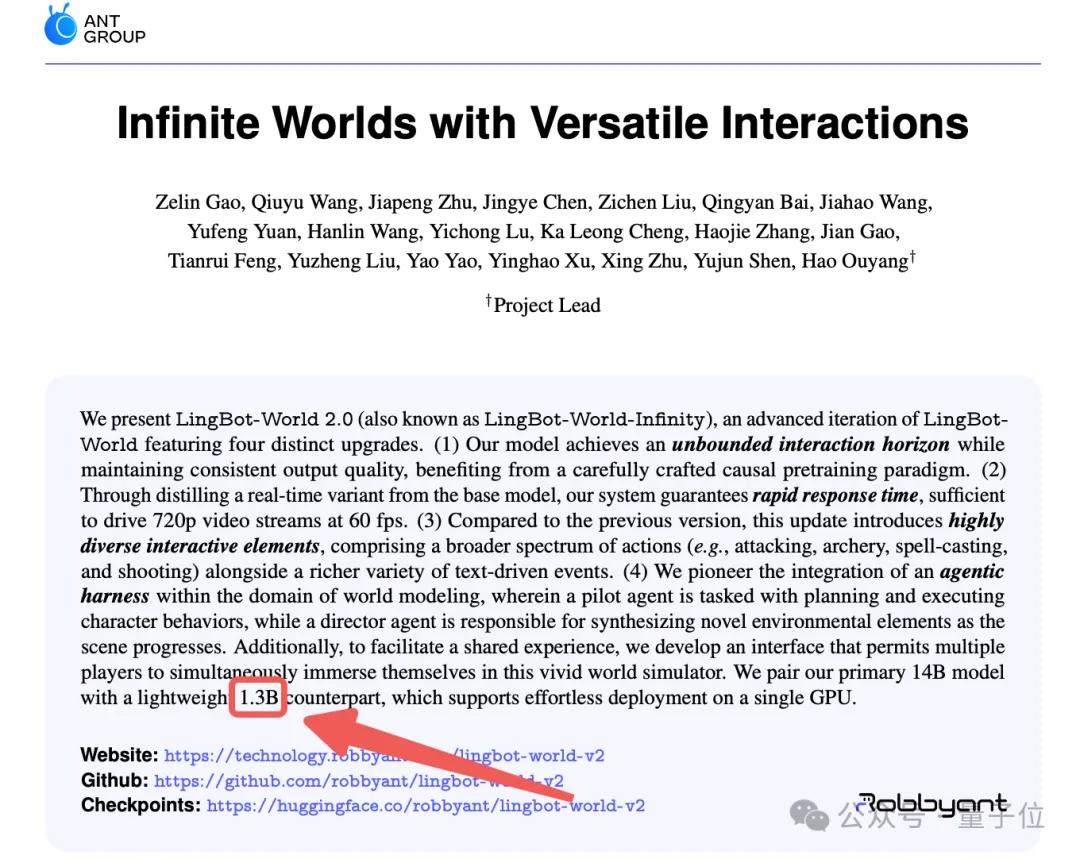
很多人会以为,1.3B版本就是把原来的14B主模型“瘦身”而来。但事实并非如此。蚂蚁灵波团队走的是一条从底层重新设计的路径,小模型其实是整套方法论自然产出的结果。
整个流程分几个关键阶段:
首先是因果预训练(Causal Pretrain)。这里的“因果”指模型生成当前帧时,只能依赖过去已发生的视觉信息和用户输入,不能偷看未来。这模拟了真实交互场景——你往前走一步,世界才生成下一步,而不是一次性把整段视频算完。
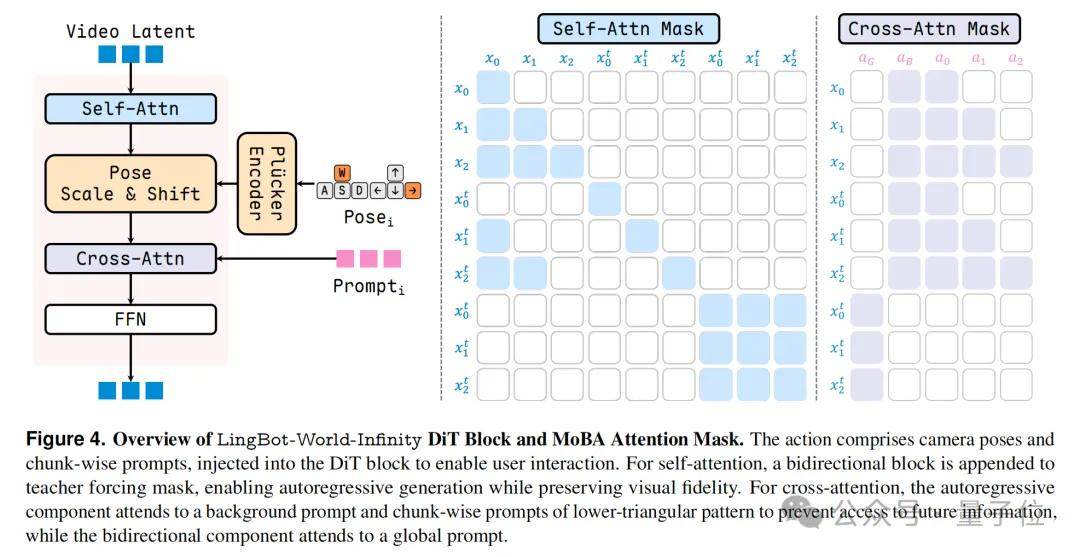
但纯自回归有个致命问题:误差会累积。第一帧稍微偏一点,第二帧基于错误的第一帧继续生成,偏差越来越大,时间一长,纹理变糊、建筑变形,甚至整个场景“漂移”出合理范围。
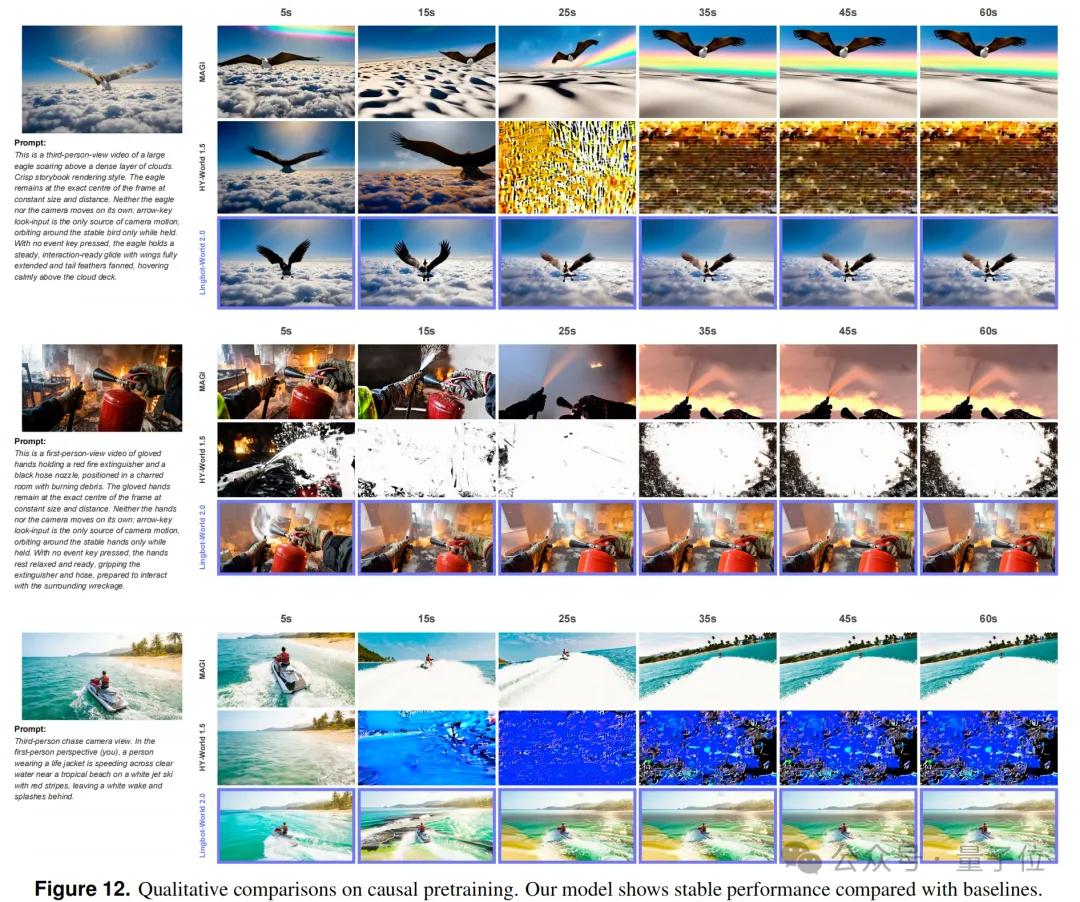
为解决这个问题,团队引入了MoBA(Mixture of Bidirectional and Autoregressive Attention Mask)。它在传统Teacher Forcing的单向注意力掩码中,混入一部分双向注意力。这相当于给训练加了一层正则化,让模型不至于过度依赖前面“干净”的上下文,从而在长序列生成中保持画质和结构稳定。
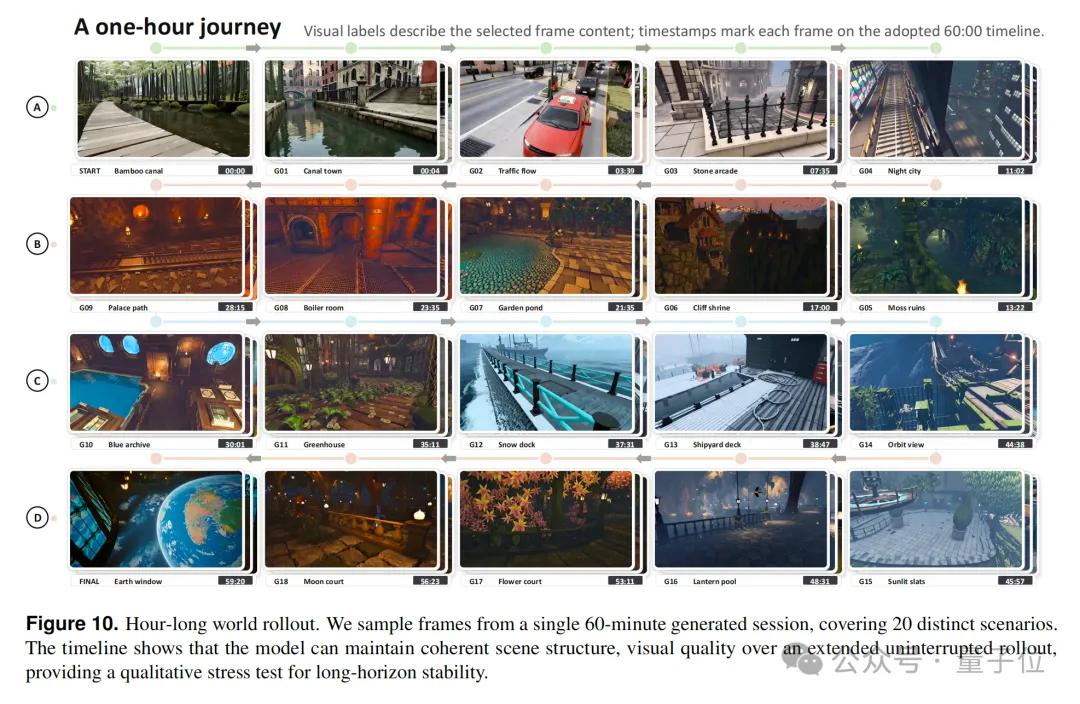
实测显示,相比MAGI、HY-World 1.5等同期模型,LingBot-World 2.0在5秒到60秒的长时生成中,纹理细节、几何一致性和场景连贯性都更可靠。
蒸馏两步走:既要快,又要稳
光有高质量Backbone还不够——它太慢了。这个经过因果预训练的模型作为“Teacher”,虽然能生成精细画面,但每帧需要多步去噪,计算开销大,没法用于实时交互。
于是第二步是蒸馏。第一步叫一致性蒸馏(Consistency Distillation),目标是把Teacher原本需要几十步完成的去噪过程,压缩到几步内由“Student”模型完成。这样推理速度大幅提升,同时尽量保留动作条件下的动态生成能力。
但新问题又来了:Student部署后,大部分输入其实来自它自己上一轮的输出。如果训练时只用Teacher的“完美”数据,一旦实际运行出现微小偏差,后续还是会滚雪球式放大。
解决方案是第二步蒸馏——DMD(Distribution Matching Distillation)。团队专门让Student在自己的长时自回归轨迹(self-rollout)上继续训练。换句话说,模型在训练阶段就提前“体验”了未来真实运行时可能遇到的状态分布,从而学会在误差出现时自我修正,减少累计漂移。
这套组合拳下来,1.3B模型既继承了大模型的长时稳定性,又具备了实时推理的效率。
为什么这件事重要?
回顾LingBot-World这一年的发展,主线很清晰:不断降低使用门槛。
- 1月开源1.0,证明国产团队能做出可用的世界模型;
- 7月推出14B版2.0,挑战小时级生成、复杂交互和720p/60fps实时体验;
- 现在发布1.3B轻量版,直接推向消费级硬件。
三次迭代,分别回答了三个问题:能不能做出来?能不能做得久、做得真?能不能让更多人跑起来?
这次开源的不只是模型权重,还包括Causal Pretrain和双向Teacher的训练代码。这意味着社区开发者可以基于这套链路,做后训练、垂直场景适配、进一步压缩,甚至开发自己的轻量世界模型。
历史上,真正推动技术普及的,往往不是性能最强的版本,而是第一个足够小、足够便宜、能让人随便试试的版本。就像当年MobileNet之于手机端AI,TinyML之于嵌入式设备。
世界模型也一样。当它还困在数据中心时,只有少数公司能玩;一旦能跑在个人显卡上,创意、应用和生态才可能爆发。
技术细节与资源
LingBot-World 2.0轻量版支持多种交互模式,包括键盘控制、鼠标视角转动、动作触发等。生成分辨率可达720p,帧率在合适配置下接近实时。模型采用自回归视频生成架构,结合动作条件建模,确保用户输入能有效驱动世界状态变化。
值得注意的是,该模型并未使用外部3D引擎或游戏引擎回放,所有内容均由神经网络端到端生成。这意味着场景中的光照、材质、物理反馈(如爆炸冲击波)都是模型内部隐式学习的结果。
目前,项目已在Hugging Face、GitHub全面开源,包含训练代码、推理脚本和预训练权重。论文也已公开,详细描述了MoBA机制和DMD蒸馏策略。
对于普通开发者而言,这意味着你可以:
- 在本地显卡上运行Demo,体验实时世界生成;
- 微调模型以适应特定场景(如室内导航、虚拟试衣);
- 基于开源链路训练自己的轻量世界模型;
- 探索世界模型与智能体、游戏AI的结合。
当然,1.3B模型仍有局限。比如复杂物理模拟、高精度材质还原、超长时(>10分钟)零漂移等,仍是挑战。但它已经证明:世界模型不必是巨头的专属玩具。
当一张显卡就能装下一个可交互的世界,或许我们离“Personal AI”的未来,真的又近了一步。