国产万卡集群如何真正跑起来:从星火X2.5看算力落地的工程细节
国产万卡集群不是堆卡就行
最近几个月,国产 AI 算力基础设施迈过一个关键门槛:从千卡走向万卡甚至十万卡规模。7月,全国产十万卡超集群落成;9月初,无锡国产智算中心一期2000张摩尔线程GPU投入运行;而更受关注的是,科大讯飞在9月发布的星火 X2.5 模型,其预训练和后训练全程跑在国产万卡昇腾910B集群上。
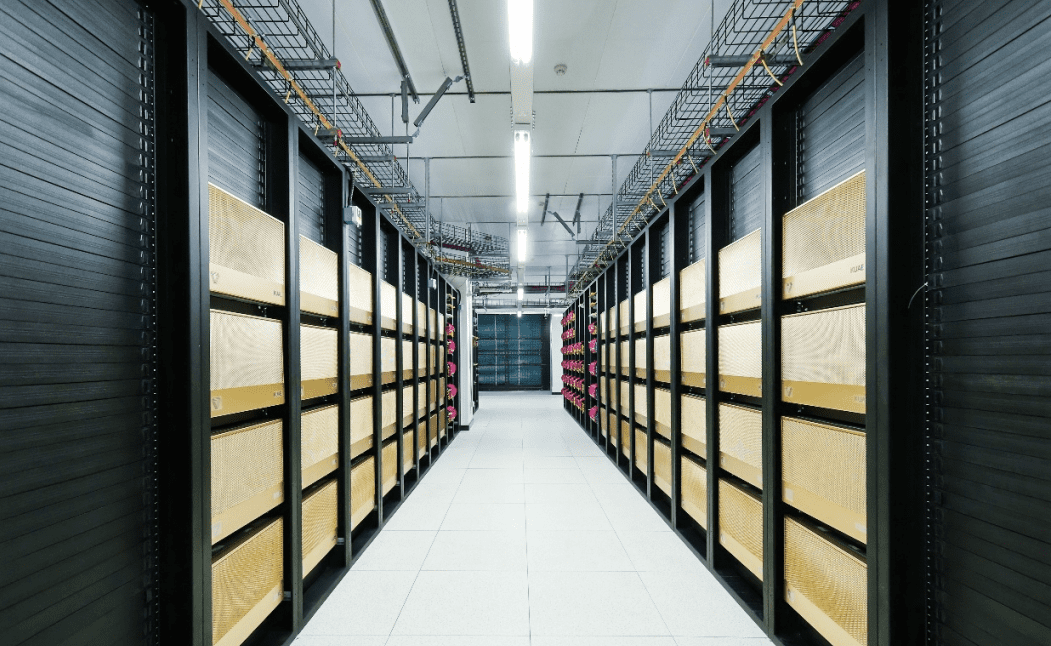
但卡数上去只是第一步。真正的问题是:这些芯片能不能高效协同干活?
大模型训练不是简单叠加算力。当规模扩大到万卡级别,原本在小集群里可以忽略的问题会被急剧放大——单卡算子效率差一点,万卡就浪费大量计算资源;通信延迟高一点,整个训练就会被拖慢;训练周期拉长后,硬件故障几乎不可避免。这时候,评价一套系统不能只看峰值算力,还得看算子、通信、调度、容错和软件栈能不能真正配合起来。
星火 X2.5 的训练过程,恰好提供了一个观察国产万卡集群真实运行状态的窗口。

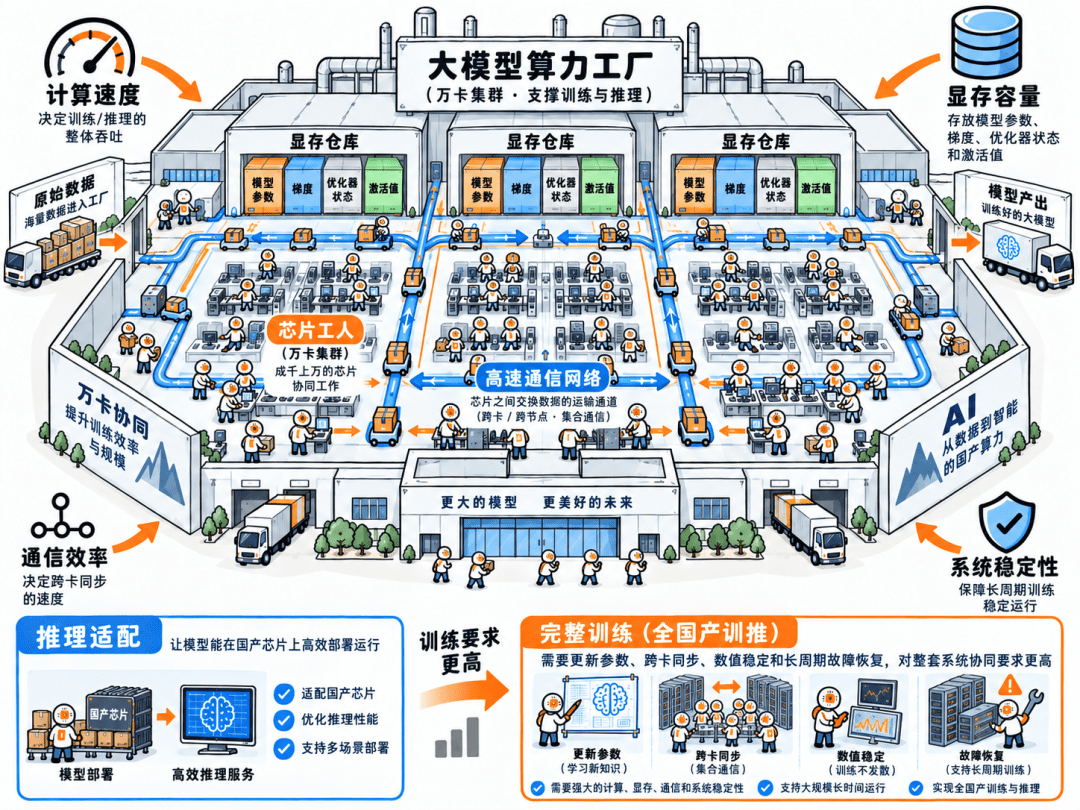
万卡训练的四个硬指标:算得快、装得下、传得顺、跑得稳

可以把万卡训练想象成一座超大型工厂:芯片是工人,显存是仓库,通信网络是运输通道。规模越大,对每个环节的要求越高。

算得快,首先取决于核心算子的执行效率。模型训练中的 Attention 计算最终要靠底层算子实现。如果算子没针对硬件优化,再多的卡也发挥不出性能。科大讯飞团队对国产关键算子做了定向优化,其中 Attention 算子效率相比基础实现提升超过2倍。
但单卡快还不够。万卡训练需要合理分工。如果任务分配不均,部分芯片早早算完,另一些还在忙,整体效率就会被拖累。尤其在处理长文本时,序列越长,负载越容易失衡。为此,星火 X2.5 采用了结合动态负载均衡的长序列并行方案,使长文本训练效率提升30%以上。
装得下,考验的是显存利用效率。模型参数、激活值、梯度和长上下文数据都要暂存在显存中。星火 X2.5 引入了稀疏注意力机制,并在不同层之间共享稀疏索引。这样既能聚焦关键信息,减少无效计算,又避免重复构建索引,节省显存和计算开销。
传得顺,是万卡集群的命脉。训练过程中,芯片之间要频繁交换数据。集群越大,通信拓扑越复杂,等待时间越容易吃掉计算收益。特别是在超长序列训练中,序列被切分到更多节点,跨卡通信量激增。
团队采用了通信压缩、分层通信和计算通信并行等策略。通信压缩减少传输数据量,分层通信根据硬件互联结构组织数据流,再配合通信掩藏技术,整体训练效率提升了约10%。
跑得稳,则是长期训练的底线。万卡运行数周甚至数月,硬件或软件故障难以避免。关键在于能否快速检测、隔离并恢复任务。星火 X2.5 训练中,系统实现了训前配置校验、训中卡死自动检测、失败任务自动重提、问题节点自动剔除,以及进程级快速恢复和临终 checkpoint 保存。最终,机器有效训练时长超过97%。
checkpoint 是训练的“存档点”。一旦出错,可以从最近的存档恢复,而不是从头再来。这套机制让万卡集群不再是脆弱的庞然大物,而是一个能持续产出的稳定系统。
模型不仅能写代码,还能优化算子
星火 X2.5 的另一个重点是强化代码和智能体能力。它不仅能生成网页、调用摄像头识别人手势,还能根据运行结果不断修正代码。这种“理解—拆解—执行—反馈—修正”的闭环,正在从应用层延伸到底层系统。
最值得注意的是,模型开始参与 NPU 算子优化。
算子优化向来是高门槛工作。工程师要懂硬件架构、内存访问模式、性能分析工具,还要反复测试不同实现。现在,星火 X2.5 被赋予了类似能力。在无监督阶段,它学习了 GitCode 上昇腾平台的优质算子代码和 CANN 编程规范;在后训练阶段,又通过真实任务进行性能剖测和迭代优化。
具体做法像给模型建了一间“实验室”:它写出一版算子代码,在真实昇腾910B芯片上运行,拿到性能数据,再根据结果修改,循环往复。
一个典型案例是 DSA(细粒度稀疏注意力)算子。该算子面向长上下文场景,通过稀疏计算减少运算量,但会带来零散访存,影响数据搬运效率。在仅提供基础 Ascend C 实现、任务描述和评估脚本的情况下,星火 X2.5 通过约1600次工具调用探索不同方案,最终比 torch_npu 实现快了3.5倍。
当然,这并不意味着模型能完全独立开发底层系统。任务目标、初始代码、硬件环境和评估脚本仍需人工设定。但模型能在给定条件下自主探索优化路径,显著提升了部分环节的自动化水平。
一次训练留下的不只是模型参数
大模型训练结束后,最直接的产出是一组参数。但星火 X2.5 的价值不止于此——它验证了一套可复用的工程方法论。
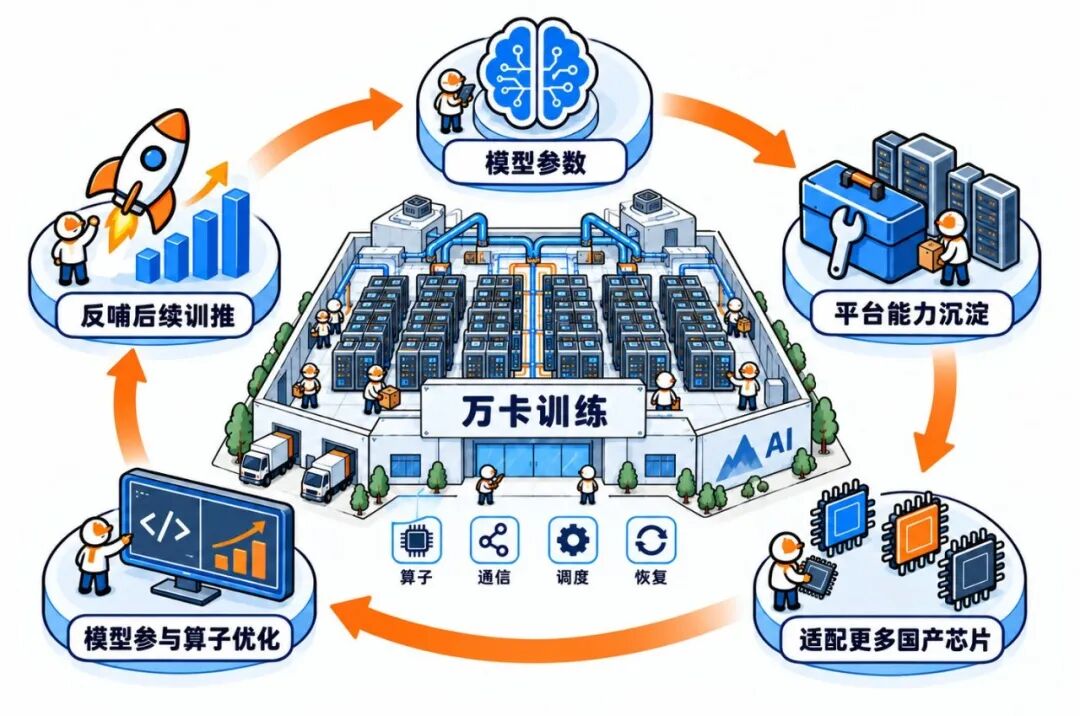
训练中积累的算子优化、通信策略、容错机制,如果能固化进训练平台,后续模型就不必重复踩坑。工程团队也能把精力集中在新架构、新算法上,而不是反复适配底层硬件。
这种积累效应会随训练次数增加而放大。一次项目中的临时补丁,可能变成平台的标准组件。
更进一步的问题是:这些能力能否迁移到其他国产芯片?
目前,科大讯飞已在寒武纪 MLU590、中科海光 BW1000 等平台上开展大模型训练适配。不同芯片在架构、编程接口、通信方式上存在差异,迁移时仍需调整算子实现和并行策略。但若能降低迁移成本,优化经验就能更快沉淀为通用方法。
与此同时,模型本身正成为工程循环的一部分。它不再只是算力的消费者,也开始参与算力的优化。这条反馈链逐渐清晰:国产算力训练大模型 → 模型获得工具调用能力 → 模型参与算子优化 → 优化经验反哺平台 → 提升后续训推效率。
全国产训推正在形成技术闭环
对科大讯飞来说,星火 X2.5 不只是一次模型发布,更是技术体系的一次整合。教育、医疗、企业服务等业务场景持续提出真实需求,驱动模型迭代;模型训练又反过来推动底层系统优化;优化后的平台再支撑下一代模型更快落地。
当这个循环稳定运转,全国产训推就不再是孤立的技术选择,而会沉淀为长期的工程优势。算子库、分布式框架、容错机制、工具链——这些资产会随着每次训练不断丰富,最终构成一套可复用、可迁移、可持续演进的国产 AI 基础设施。
万卡集群的价值,从来不在卡的数量,而在它能否真正跑起来、跑得久、跑出成果。星火 X2.5 的实践表明,国产算力正在从“能用”迈向“好用”,而真正的突破,往往藏在那些看不见的工程细节里。