黄浩杰新作 AMP:用像素分类解决机器人高维动作预测难题
把机器人动作变成“看图选点”
大语言模型的成功背后有一条清晰的路径:用交叉熵(cross-entropy)目标函数,在 token 序列上做自回归预测。数据越多、模型越大,性能就越好。这套方法之所以有效,是因为它天然适合处理一维离散序列,并能建模复杂的多模态概率分布。

但机器人动作不是文字。一个简单的抓取动作,在时间窗口内可能包含多个时刻的 6 自由度位姿(3D 位置 + 3D 朝向)加上夹爪开合。如果粗略地把每个维度离散成 10 个区间,组合起来就是 10⁶ = 100 万种可能动作。提高精度?动作空间会爆炸得更快。这就是机器人学习绕不开的“维度灾难”。
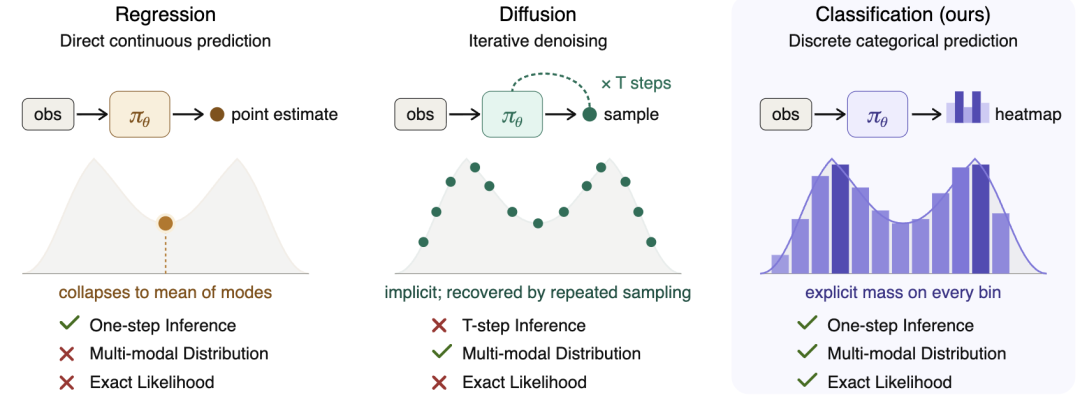
黄浩杰和他的合作者提出了一种新思路:别在高维连续空间里硬猜动作,而是把动作变成图像上的像素分类问题。他们设计的 Action Map Policy(AMP)不直接预测 3D 向量,也不用扩散模型一步步去噪,而是输出一张张“热力图”——每张图显示某个关键点在不同时刻出现在各个像素位置的概率。
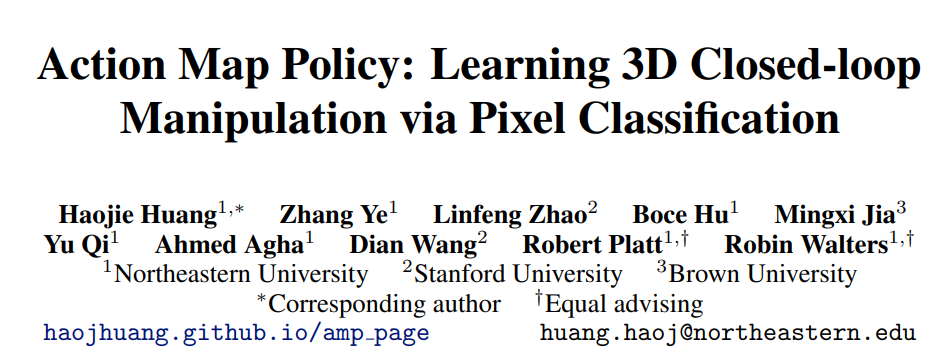
换句话说,AMP 让机器人“看图选点”。输入是几张相机拍到的图像,输出是定义在这些图像上的概率分布。动作不再是抽象数字,而有了明确的空间语义。
为什么像素分类能解决多模态问题?
想象一个简单实验:桌上有四个一模一样的木块,激光笔随机点亮其中一个,机器人要抓被照到的那个。训练数据只有 40 条演示(每个木块 10 条),且木块位置几乎不变——这排除了空间泛化干扰,纯粹测试模型能否根据细微视觉线索区分目标,并表达对应的多峰动作分布。
结果很说明问题。用扩散策略(Diffusion Policy)的模型经常“认错人”,抓错木块,表现出类似 mode collapse 的行为:它似乎无法稳定地将激光位置与特定抓取动作关联起来。而 AMP 在这个任务上达到了 100% 成功率。
关键在于,分类天然支持多模态。一个像素可以有高概率,另一个也可以有高概率,模型不需要“选一个确定答案”。当任务存在多个合理解(比如从不同角度抓同一个物体),分类输出能自然保留这种不确定性;而回归或扩散往往被迫收敛到某个平均解,丢失多样性。
AMP 怎么把 3D 动作“压”进 2D 图像?
AMP 的核心是动作表达的转换。它先把夹爪或物体的 3D 运动轨迹表示为几个关键点的路径,再把这些 3D 点投影到多个相机视角的图像平面上。于是,原本的 3D 轨迹变成了多张 2D 图像上的像素轨迹。
训练时,模型完全在图像空间进行:给定观测图像,预测每个时间步上关键点落在各像素的概率。损失函数就是标准的交叉熵——和训练分类网络一样。不需要任何显式的 3D 轨迹监督。
推理时,先对每张热力图取 argmax,得到 2D 像素坐标;再结合相机内外参,用三角测量(triangulation)把多个视角的 2D 点还原成 3D 空间轨迹。也就是说,AMP 并不是“学 3D”,而是通过学好多张 2D 视角中的动作分布,间接获得对 3D 结构的理解。
这种设计带来两个好处:一是避免了直接处理高维连续动作的困难;二是利用了计算机视觉领域成熟的图像编码/解码架构。
架构:X-Net 与多视角 Transformer
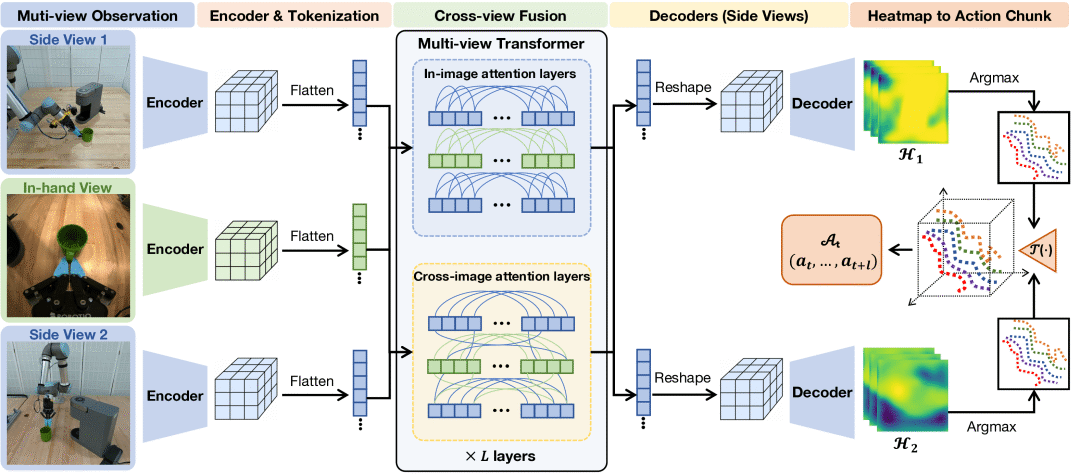
AMP 的网络结构像一个横放的“X”。左边是编码器,把输入图像(通常包括一个手眼相机和两个侧视图)压缩成特征图,再展平为 tokens。中间是一个多视角 Transformer,包含两种注意力机制:
- In-image attention:在单张图像内部建模局部与全局关系;
- Cross-image attention:让不同相机视角的特征相互交流,融合上下文信息。
右边是两个解码器,分别对应不同的关键点(比如夹爪尖端和物体中心),把融合后的特征重新上采样成与输入同分辨率的热力图。每个热力图对应一个时间步,覆盖整个动作时序窗口。
整个流程端到端训练,没有中间的 3D 重建模块或逆动力学层。这使得 AMP 比一些需要生成未来图像再反推动作的方法(如 World Action Model)更轻量。
真机实验:做早餐比扩散策略稳得多
为了验证 AMP 在真实世界的表现,团队设计了三个日常早餐任务:
- 制作咖啡:开盖 → 放胶囊 → 放杯子 → 按启动键;
- 烤面包:把两片面包分别塞进狭窄插槽 → 拉下拉杆;
- 蒸鸡蛋:依次放入三个鸡蛋 → 盖上带卡扣的盖子。
这些任务不仅要求毫米级精度(比如胶囊必须对准卡槽),还涉及多步骤状态维持。实验在 Franka Emika 机械臂上进行,训练数据来自人类遥操作演示。
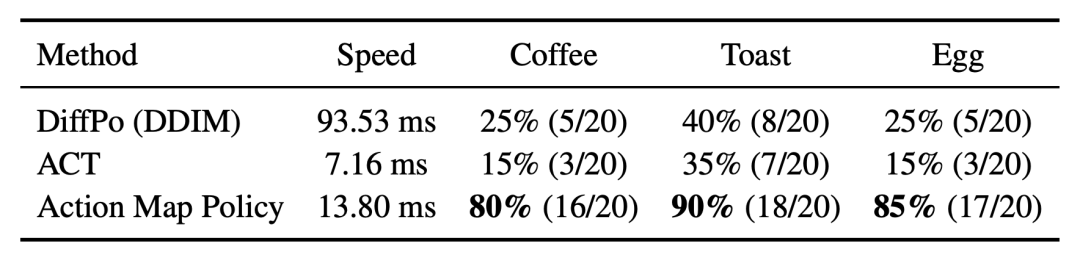
结果很直观:AMP 在三个任务上的成功率全面领先。相比 Diffusion Policy(DiffPo)和 ACT(另一种基于 Transformer 的策略),AMP 的成功率高出 50% 到 70%。尤其当测试场景出现较大空间偏移(比如杯子位置变化)时,baseline 方法性能明显下滑,而 AMP 依然稳健。
速度优势更突出。AMP 单次前向推理只需 13.80 毫秒,而使用 16 步 DDIM 去噪的 DiffPo 要 93.53 毫秒。这对闭环控制至关重要——更快的推理意味着更短的控制延迟,系统更不容易失稳。
精度与分辨率的关系
AMP 能做到多精确?实验发现,3D 重建误差和输入图像分辨率近似线性相关。在常用的 224×224 分辨率下,位置误差约 1 毫米,旋转误差约 1.3 度。这意味着它足以应对大多数精细操作任务,比如插拔 USB、按按钮、盖盖子等。
值得注意的是,这种精度不是靠后期优化或迭代 refinement 得到的,而是单次前向推理的直接输出。这也解释了为什么 AMP 在长时序任务中表现更好——每一步都快且准,累积误差自然小。
和 WAM 等方法的本质区别
最近也有其他工作尝试用视觉生成来表征动作,比如 World Action Model(WAM)。WAM 会预测未来图像或视频,再通过逆动力学层从视觉变化中反推机器人动作。这种方法虽然直观,但计算开销大:既要生成高维图像,又要额外训练 inverse dynamics 模块。
AMP 则绕开了图像生成。它不预测“世界会变成什么样”,而是直接回答“我的手应该往哪动”。动作表达聚焦在紧凑的像素级关键点上,既保留了空间语义,又避免了不必要的计算负担。这使得 AMP 在资源受限或实时性要求高的场景中更具实用性。
交叉熵可能是机器人学习的下一个支点
黄浩杰在文章开头抛出一个观点:“如果我对机器人学习只押一个注,我会押交叉熵。” 这听起来有点反直觉——毕竟机器人动作是连续的,而交叉熵常用于离散分类。

但 AMP 证明,只要找到合适的动作表达,连续控制问题完全可以转化为离散分类。一旦进入分类框架,就能继承 LLM 成功背后的 scaling law:更大的模型、更多的数据,性能持续提升。更重要的是,分类天然支持多模态,而这正是复杂操作任务的核心特征——同一个场景,往往有多种合理动作解。

AMP 不是终点,但它提供了一个清晰的方向:不要强行把机器人动作塞进不适合的范式里,而是重新定义动作本身,让它适配我们已经掌握的强大工具。在这个意义上,AMP 不仅是一个新策略,更是一种新思路。


