AI 正从生成内容转向操作现实:三维世界成为新接口
AI 正在跨过一条新边界
过去两年,我试过几乎所有主流 AI 更新。Agent、多模态、模型迭代一轮接一轮——能力确实在涨,但基本都在“把内容做得更逼真”这条老路上打转。直到最近连着跑完 Astra、Atlas 和 Cosmos,我才第一次停下来认真想:这可能不是又一次渐进式升级,而是一次方向性的转折。
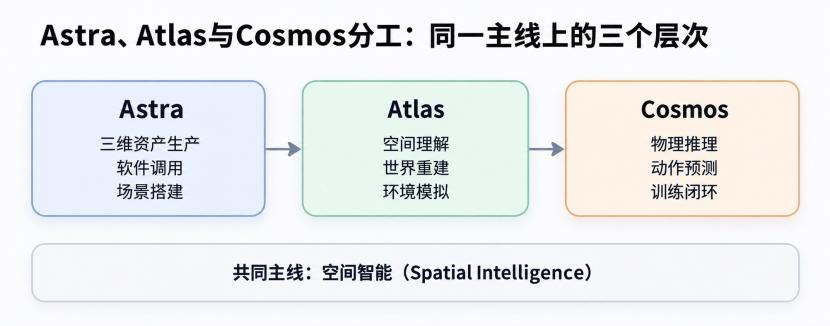
关键变化在于:AI 正从“生成内容”转向“理解世界,并准备动手”。如果你还停留在“3D 内容需求会变多”这种层面去理解,可能会错过整个底层逻辑的替换。
Astra:3D 工作流的成本塌方
先说 Astra。我让它生成一个住宅室内场景。放在以前,这类输出再精美,导进建模软件也只是一张静态图——结构信息全丢,没法继续编辑或交互。
这次不同。它直接吐出了结构完整的 3D 资产:能在 Blender 里调整墙体厚度,在 Unreal Engine 5 中实时漫游,甚至保留了材质层级和光照设置。
做过三维工作流的人都清楚这套流程有多贵。建模、UV 展开、材质绘制、灯光布置、渲染输出、后期合成……每个环节都依赖专业软件和熟练人力,容错率极低。一个小改动可能意味着返工数天。
现在,自然语言成了入口。你说“客厅要有落地窗,沙发朝南,木地板带暖色调”,系统就能生成可编辑的工程级资产。这就像当年 Photoshop 把图像处理从暗房搬上桌面——工具成本一旦崩塌,需求不是被压缩,而是被释放。游戏、电商虚拟展厅、建筑可视化、工业设计评审,全在排队等着用。
这不是预测,是正在发生的事实。Astra 的意义不在于画面多精细,而在于它把 3D 从“成品交付物”变成了“可编程中间态”。
Atlas:从造物体到懂空间
如果说 Astra 让我注意到变化,World Labs 的 Atlas 才真正让我意识到这轮变革能走多远。
关键区别在于:生成一个杯子,你只关心它的形状、颜色对不对;但要理解一个厨房,模型得知道杯子该放哪、台面高度是否符合人体工学、手从哪个角度伸过去最自然、下一秒用户可能要拿什么。
前者是“造对象”,后者是“懂空间”。中间隔的不是分辨率,而是一个维度。World Labs 有句话值得细读:“3D 正在成为空间的通用接口。”
文字曾是人机交互的接口。如果三维变成人与 AI 共同生成、编辑、模拟空间的媒介,那 3D 就不再是一份设计文件,而是一种新的计算载体。听起来有点抽象?实际测试中,Atlas 能根据“老人独居”这个提示,自动调整厨房布局:降低操作台高度、增加扶手、避免尖锐转角。它不是在拼贴预制模型,而是在推理空间功能。
Cosmos:给 AI 装上内部模拟器
到英伟达的 Cosmos 这一步,我基本确认之前的判断不是过度解读。
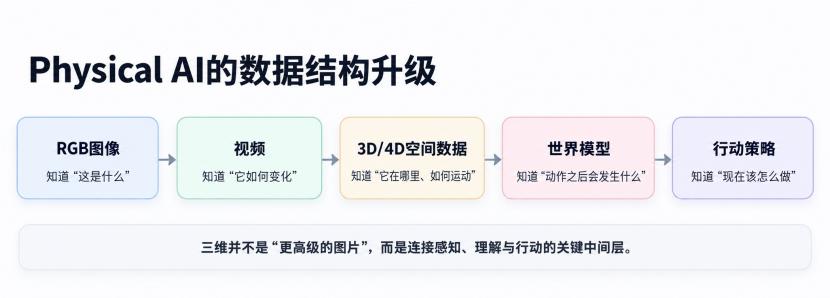
现在的视觉模型已经能准确回答“画面里有什么”。但机器人和自动驾驶真正的难点从来不是识别,而是预判:“接下来会发生什么?”
Cosmos 的核心突破,是让模型在内部建立一个可运行的世界状态推演系统。比如机械臂要抓杯子,它会先在虚拟环境中模拟几十种抓取路径——考虑摩擦力、重心偏移、碰撞风险——再选出最优解。等于给 AI 装了一个能实时运转的内部模拟器。
没有它,机器只能感知当下这一刻;有了它,机器才具备“动手之前先推演一遍”的能力。这一步对 Physical AI(物理人工智能)的意义,不亚于当年大模型在链式推理上的突破。
合成数据:绕过真实世界的瓶颈
为什么这事现在才发生?因为真实世界的数据太贵了。
语言模型可以爬取整个互联网的文本,但机器人没法从网页里学会怎么稳稳抓起一个易碎的玻璃杯;自动驾驶也不可能靠真实路测覆盖所有极端场景——暴雨夜、施工区临时改道、行人突然冲出……这些最关键的数据恰恰最难获取。
而三维重建加世界模型成熟后,逻辑就变了:先用少量高质量真实数据构建一个数字基准场景,再在虚拟环境中系统性地改变变量——调天气、换光照、移动障碍物、调整物体物理属性。从一组种子数据,能长出百万级训练样本。
这意味着 Physical AI 的竞争维度正在迁移:
- 过去比谁拥有更多真实数据
- 未来比的是 真实数据质量 × 空间重建能力 × 仿真精度 × 合成数据放大效率
谁能高效地把现实世界转化为可计算、可模拟、可训练的数字接口,谁就掌握了下一代 AI 的燃料。
谁在受益?
按受益的直接程度,大致可分为四层:
第一层:基础设施(最确定)
- NVIDIA:它卖的早就不只是 GPU。Omniverse 提供协作仿真平台,Isaac Sim 专注机器人训练,Cosmos 构建世界模型——整套“让机器学会现实世界”的底座都在它手里。不管最终哪家机器人或自动驾驶公司胜出,都绕不开这套工具链。
第二层:三维重建与数字孪生(关键入口)
- PTC(ThingWorx、Vuforia)、Autodesk(Fusion 360、BIM 360):它们掌握着工业设计、建筑、制造领域的三维数据流。现实世界要变成 AI 可训练的数字世界,必须经过这些系统的结构化处理。它们是物理世界进入模型的“数据闸口”。
第三层:空间感知硬件(必要但内卷)
- Ouster(激光雷达)、Mobileye(视觉感知):负责把物理环境实时转换为机器可读的空间数据。没有这层,上面全是空中楼阁。但这一层技术趋同快,价格战激烈,胜负取决于成本控制和量产一致性。
第四层:终端落地(高弹性高风险)
- Tesla(Optimus、FSD)、Symbotic(仓储机器人):真正把 AI 部署进现实场景的玩家。弹性最大,但风险也最集中——模型在仿真中跑得好,不代表机器人能规模化交付;合成数据有效,不代表能顺利迁移到现实世界。
接下来别只盯着演示视频多震撼,盯三件事:
- 仿真是否真的减少了实地训练时间
- 合成数据是否显著提高了模型在真实场景的成功率
- 客户是否愿意为这套方案持续付费
下一轮革命的本质
上一轮 AI 革命,把人类积累的知识压缩成了 token,让机器能“读懂”人类。
下一轮,可能是要把整个物理现实——空间、物体、动作、因果——重写成 AI 能读取、能模拟、能操作的接口。语言让 AI 理解了我们的想法,而 3D 才可能让 AI 真正走进我们的世界。
这不是关于“更多 3D 内容”的故事,而是关于“现实世界如何被重新编码”的故事。那些还在比拼生成图片清晰度的人,可能已经站在了旧时代的尾巴上。