DeepSeek V4.1 Flash 内测上线:新结构、更快、更便宜
DeepSeek 突然放出 V4.1 Flash 内测版
9 月初的大模型战场又添一把火。今天下午 3 点,DeepSeek 官方社区悄悄放出消息:DeepSeek V4.1 Flash 已开放测试。

说是“内测”,但对 API 用户来说几乎零门槛——只要在现有服务商后台手动添加模型名 deepseek-v4.1-flash-expires-on-0910,保留原来的 API Key 和 base_url,新建对话时选中它就能直接跑起来。不需要申请白名单,也不用换账号。

这已经是 DeepSeek 近两个月来的第四次重要更新。7 月底,V4-Flash-0731 通过纯后训练就拉高了整体能力;8 月 13 日,V4 Pro 正式版搭配 DeepSeek Harness 生态工具亮相;8 月 21 日,带视觉能力的 v4-flash-vision-exp 终于让 DeepSeek 能“看图说话”。而这次的 V4.1 Flash,明显不止是调参那么简单。
新结构到底改了什么?
DeepSeek 官方明确提到,V4.1 Flash 使用了“新的模型结构”。虽然没细说具体改动,但结合此前版本的演进路径,可能的调整方向包括注意力机制优化、MoE(混合专家)网络结构调整,或者视觉模块的原生集成。
值得注意的是,上一代 v4-flash-vision-exp 虽然支持图文输入,但更像是“视觉+语言”的拼接方案。而 V4.1 Flash 如果真如社区猜测那样实现了原生多模态架构,那意味着图像和文本从底层就开始融合处理,而不是后期对齐。这种改动通常能带来更稳定的跨模态理解能力。
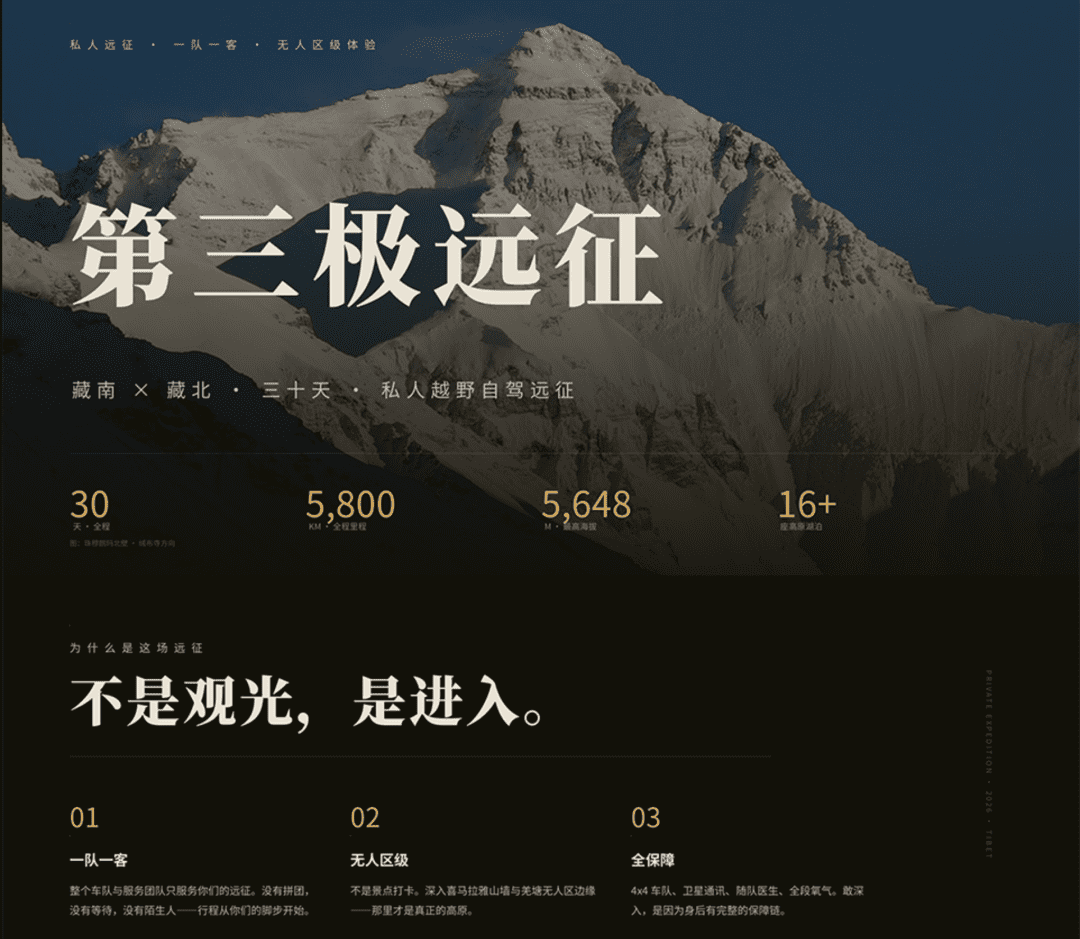
不过目前官方没给技术细节,只能从实际表现反推。有用户测试发现,同样是生成一份西藏自驾游商业 PPT(需解析图片路线+文字需求),V4.1 Flash 的响应更连贯,对地图标注的理解也更准确。
速度提升不是一点点
最让人眼前一亮的是速度。社区已有实测数据显示,V4.1 Flash 的推理速度达到约 400 token/s,比 Google 最新的 Gemini 3.8 Flash 还要快。
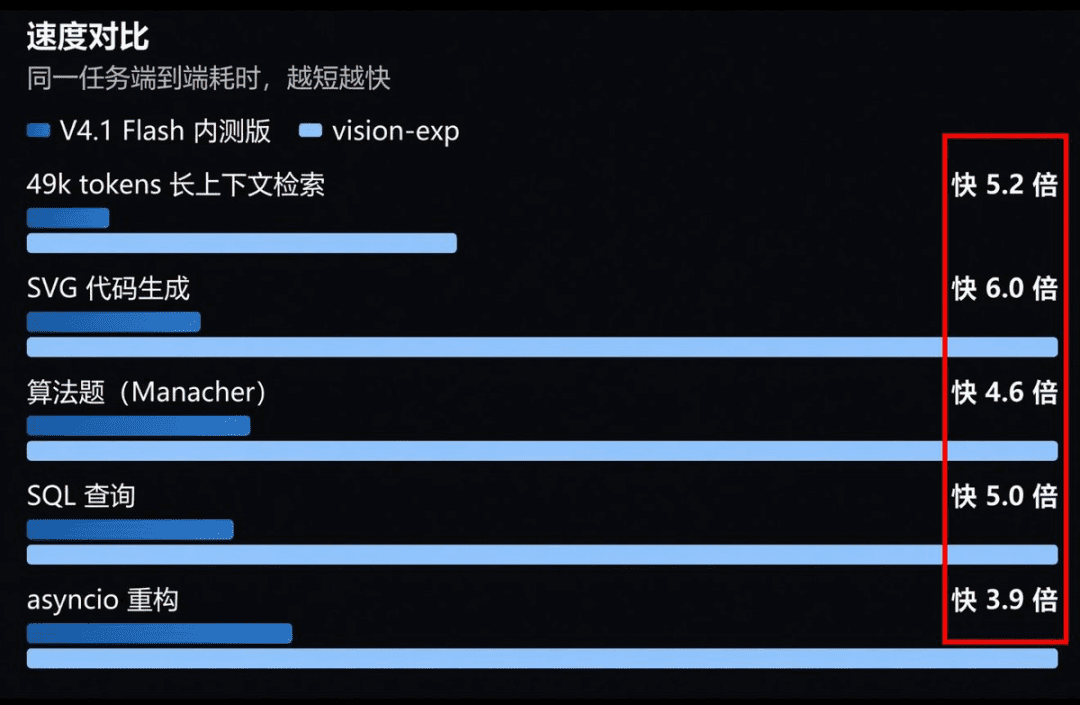
更具体的对比来自 X 用户 @NFT_Chen 的测试:在相同硬件环境下,V4.1 Flash 相比上一代 v4-flash-vision-exp:
- 49k 长上下文检索快 5.2 倍
- SVG 代码生成快 6 倍
- 算法题求解端到端耗时缩短至原来的 1/3.9~1/6
这些数字背后,可能是计算图优化、KV Cache 压缩,或是更高效的并行策略。对于开发者来说,这意味着更低的延迟和更高的吞吐量——尤其在需要实时交互的 Agent 场景里,几秒的差距可能决定用户体验好坏。
我们自己也做了个小实验:让它用 HTML/CSS/JS 写一个能玩的马里奥 MVP(最小可行产品)。从发出指令到生成完整可运行代码,耗时 7 分多钟,花费不到 2 块钱。它没一上来就堆敌人或关卡,而是优先还原核心元素:金币收集、蘑菇怪移动逻辑、水管跳转,甚至角色动画都接近原版。
成本优势可能很快兑现
目前 V4.1 Flash 的计费标准和 V4 Flash 一致,但社区已经在猜:降价是不是快来了?
DeepSeek 过去几次更新都伴随着价格调整。比如 V4 Flash 刚上线时就以“每百万 token 几毛钱”的低价搅动市场。这次速度大幅提升却维持原价,大概率是为正式版铺路——一旦验证稳定性,很可能直接下调费率。
另一个线索藏在模型名字里:expires-on-0910。也就是说,这个测试版9 月 10 日就会失效。留给用户尝鲜的时间不到两天,也侧面说明 DeepSeek 可能正在准备正式发布。
实际用起来怎么样?
除了跑分,我们还试了几个真实场景。
第一个是生成一个关于 FDE(Full Disk Encryption,全盘加密)的科普 PPT。它没急着写内容,而是先问:“你说的 FDE 是指 Windows 的 BitLocker,还是 Linux 的 LUKS?听众是技术人员还是普通用户?”确认后,它自动去查最新文档,把技术原理拆解成“为什么需要加密”“密钥怎么存”“丢了密码怎么办”三块,最后输出成带动画的 HTML 页面。
第二个任务更琐碎:整理一份包含 20 张产品图的电商文案。它不仅能识别图中的商品类别(比如“这是无线降噪耳机,不是普通蓝牙耳机”),还能根据背景色调建议文案风格——深色图配简洁文案,亮色图加促销话术。
这些细节说明,V4.1 Flash 在任务理解深度和执行连贯性上确实有进步。不再是“你让我干啥我就干啥”,而是会主动澄清模糊点、规划步骤、再交付结果。
短期体验窗口,值得试试
虽然只是临时测试版,但 V4.1 Flash 展现出的方向很清晰:在保持低成本的同时,把推理效率和多模态能力推到新高度。对于需要高频调用 API 的开发者、做智能体(Agent)应用的团队,或者单纯想跑个快速原型的人来说,这两天值得一试。
操作也很简单:
- 打开你常用的 DeepSeek API 服务商后台(比如官方平台或第三方代理)
- 在模型列表里手动输入
deepseek-v4.1-flash-expires-on-0910 - 用原有 API Key 发请求即可
注意别等到 9 月 10 日晚上——模型到期后可能直接返回错误。如果你已经试过,不妨说说你的体验:是快得离谱,还是翻车了?