DeepSeek V4-Flash API 降价,输出价格仍是涨价前两倍
DeepSeek V4-Flash 价格回调,但没完全回
本周二晚上,DeepSeek 开放平台发了一则公告:V4-Flash 系列的大模型 API 要降价了。消息一出,不少开发者松了口气——毕竟上个月那波涨价,确实让很多人重新算了账。
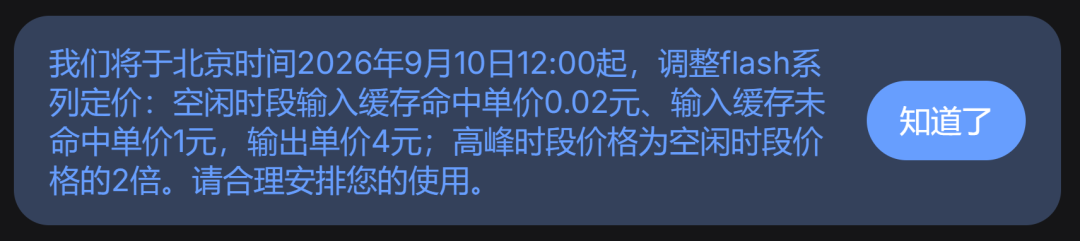
这次调整后,闲时价格统一为:
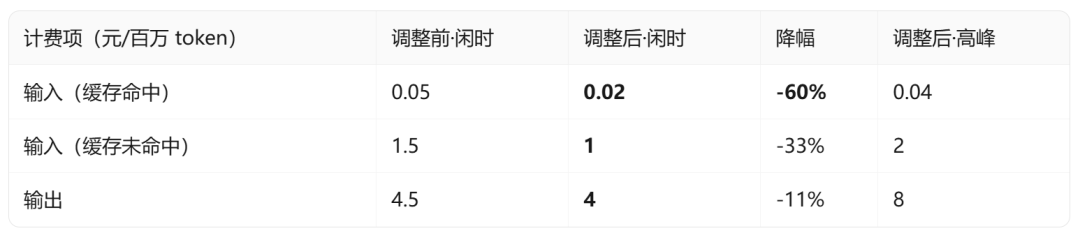
- 输入(缓存命中):0.02 元 / 百万 token
- 输入(缓存未命中):1 元 / 百万 token
- 输出:4 元 / 百万 token
高峰时段(周一至周五 9:00–12:00、14:00–18:00)价格是闲时的两倍,也就是 0.04 元、2 元和 8 元。
值得注意的是,这次只动了 V4-Flash 的价格,定位更高的 V4-Pro 维持原价不变。新定价将在 9 月 10 日中午 12 点正式生效。
和涨价前比,到底降了多少?
要理解这次“降价”的实际意义,得拉回上个月看。
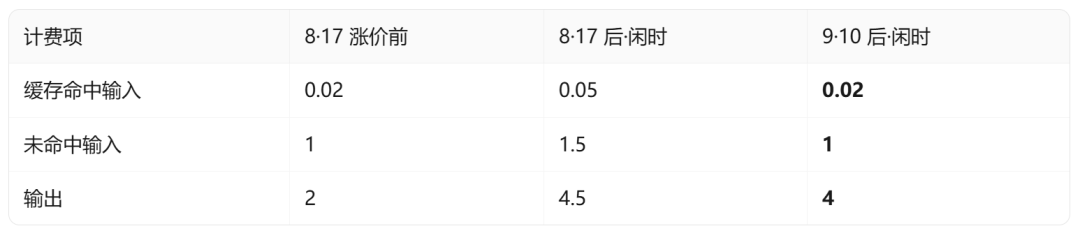
8 月 17 日零点,DeepSeek 曾把 V4-Flash 的价格从原来的统一价(缓存命中 0.02 元、未命中 1 元、输出 2 元)大幅上调。当时官方解释是为了“更合理地调配资源”,鼓励用户错峰使用。但外界普遍猜测,是因为 V4-Flash 0731 版本性价比太高,全球调用量暴增,而 DeepSeek 自身算力储备吃紧。
现在回头看,这次调整其实是一种“部分回调”:
- 输入侧(缓存命中和未命中)的价格回到了涨价前水平;
- 输出价格却仍维持在涨价后的 4 元(闲时),是原先 2 元的两倍。
如果算高峰时段,差距更大:新高峰输出价 8 元 vs 涨价前的 2 元,整整 4 倍。
这意味着,用户能不能回到过去“放开了用”的状态,取决于三个关键变量:
- 缓存命中率:系统提示词固定、上下文重复高的场景(比如 Agent 循环调用)命中率高,成本降幅明显;
- 输入输出比例:以阅读、分析为主的任务(输入多、输出少)受益大;纯生成类任务(如长文本创作)感受有限;
- 任务是否可错峰:能安排在非工作时间跑的任务,直接省一半钱。
好在 DeepSeek API 的缓存机制一直做得不错,很多用户的实际命中率较高,所以社区对这次调整整体反应偏乐观。
同一天上线临时内测版 V4.1 Flash
有意思的是,就在降价公告发布的前一天下午,DeepSeek 在官方交流群里悄悄放出一个内测消息:V4.1 Flash 中间版本开启内测。
这个模型的名字很特别:deepseek-v4.1-flash-expires-on-0910。光看名字就知道,它会在 9 月 10 日自动过期下线——正好和降价生效是同一天。
内测版通过原有 base_url 调用,每账号限流 20 并发,计费暂时和 V4-Flash 一致。官方提到,新模型除了支持原生多模态和保持极快的推理速度外,还通过架构升级进一步降低了推理成本。
这透露出一个信号:DeepSeek 正在从模型工程层面入手,试图从根本上缓解算力压力。如果 V4.1 的正式版能在能力上有明显跃升(比如更强的推理、更稳的多模态),再配合这次价格回调,或许真能掀起新一轮的开发者迁移潮。
用户该怎么应对?
对已经在用 DeepSeek API 的团队来说,接下来几天可以做几件事:
- 检查缓存策略:确保系统提示词、常用指令被有效缓存,最大化命中率;
- 分析 token 消耗结构:用平台提供的用量报表,看看输入和输出各占多少比例;
- 评估任务调度灵活性:非实时任务尽量挪到闲时执行,直接砍半成本;
- 试用内测模型:虽然只有一天有效期,但可以快速验证 V4.1 的效果是否值得等待正式版。
长远看,大模型 API 的价格战不会停。谁能持续优化推理效率、控制边际成本,谁就能在竞争中留出更多定价空间。DeepSeek 这次“降一半、留一半”的操作,既是对用户反馈的回应,也是在为下一代模型铺路。
至于 V4.1 正式版何时发布、能力提升几何,还得等官方进一步消息。但至少在 9 月 10 日之后,V4-Flash 的账单不会再像过去一个月那么吓人了——前提是,你的应用够“聪明”。