文本世界模型的新目标:让智能体行为一致,而非文本相似
预测偏差不可避免时,什么才是“关键”幻觉?
大语言模型(LLM)智能体在网页导航、工具调用或文本冒险等任务中表现越来越强。但要在真实环境中测试它们,成本很高:访问电商网站慢、贵,还可能触发不可逆操作,比如误下单。于是有人想到:能不能用另一个LLM来“扮演”环境?

比如,智能体在模拟电商网站点击“搜索毛衣”,世界模型就生成一个搜索结果页;智能体选中某件商品,它再给出商品详情。这样,智能体就能在纯文本的模拟环境中做离线评估或提前规划,不用真的去碰真实系统。
这类“文本世界模型”的核心问题来了:怎么才算好?
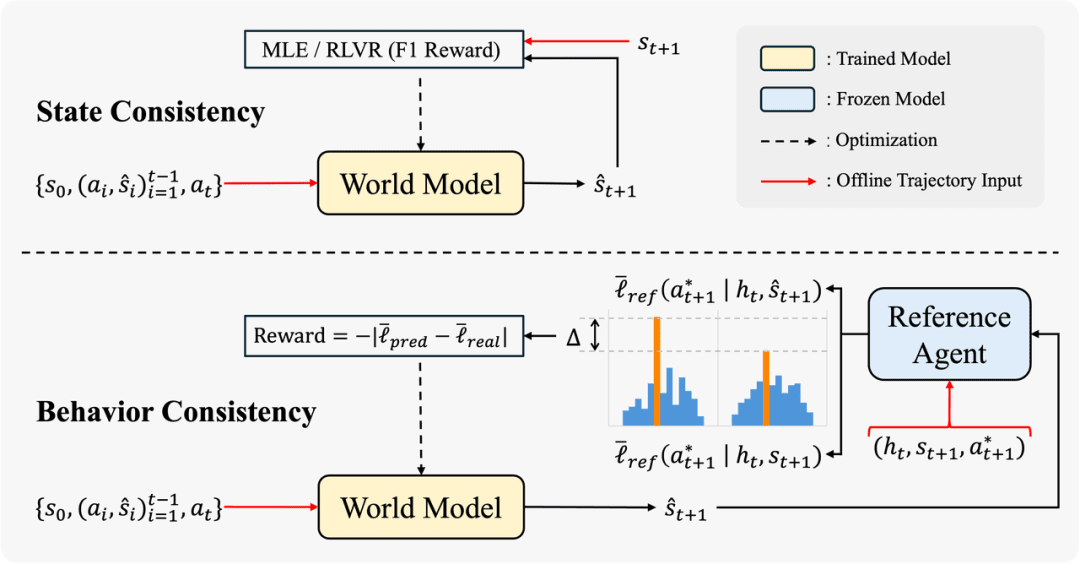
目前几乎所有方法都指向同一个答案:生成的文本越像真实环境越好。训练时,要么用监督学习在真实轨迹上做逐token最大似然(MLE),要么用强化学习把F1、ROUGE-L或BERTScore这类文本相似度当作奖励信号。评估时也依赖这些指标。背后的逻辑很朴素:文本越真,模型越好;所有偏离真实的“幻觉”都是坏的,应该一视同仁地压制。
但现实没那么理想。在几十步的长序列交互中,自回归预测的误差会不断累积——漏掉商品、写错价格、编造不存在的按钮,几乎无法避免。既然幻觉短期内消除不了,一个更实际的问题浮现出来:不同类型的幻觉,对智能体决策的影响真的相同吗?
文本越像,智能体未必做得更好
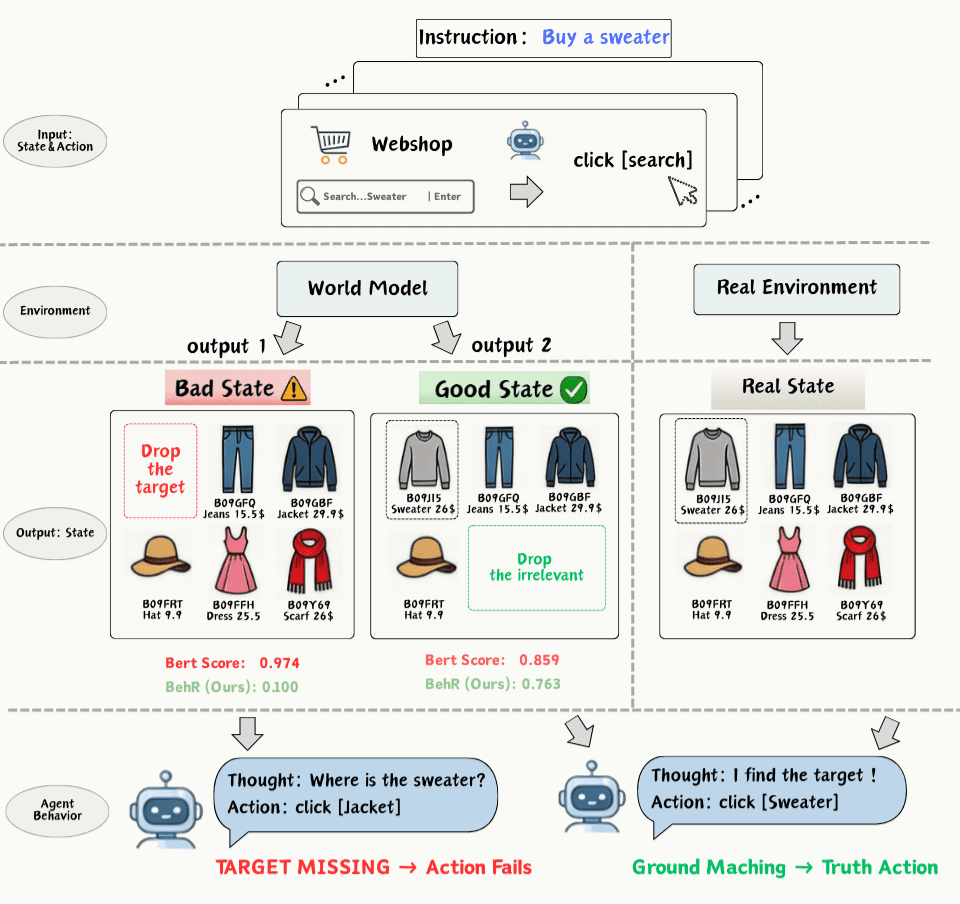
想象两种幻觉输出:
- 输出1:遗漏了用户要买的那件毛衣,但其他内容高度还原,BERTScore高达0.974;
- 输出2:只漏掉了两件无关商品(比如连衣裙和围巾),BERTScore降到0.859。
从文本保真度看,输出1显然“更好”。但对智能体来说,输出1是致命的——它根本找不到目标商品,任务直接失败;输出2却毫无影响,照样能完成购买。
这就是论文揭示的“指标反转”现象:主流文本相似度指标不仅没识别出关键错误,反而严厉惩罚了无害的偏差,放过了致命的遗漏。更糟的是,这种反转不是个例。作者用受控扰动实验证明,F1、BERTScore、ROUGE-L,甚至让GPT-4o当裁判,全部排反了。只有他们提出的新指标BehR能正确排序,并提供稠密的梯度信号。
这说明了一个根本问题:文本保真度不等于功能正确性。现有世界模型的训练目标,其实一直没对齐智能体真正在意的东西。
从“状态一致”转向“行为一致”
既然比文本相似度行不通,换个思路:如果智能体在预测状态和真实状态下做出一样的决策,这个预测就是好的。
论文将这一目标定义为“功能一致性”(Functional Consistency)。形式化地说,给定历史轨迹 τ,真实状态 s 和预测状态 ŝ,若智能体 π 在两者下选择的动作分布相近,则认为 ŝ 是高质量的预测。
这就像翻译:逐字直译未必是好翻译,关键是读者能否从译文中做出和原文相同的判断。对世界模型而言,关键不是页面文字是否一字不差,而是智能体能否基于这个页面做出正确的下一步操作。
BehR:用行为差异替代文本相似度
基于上述思想,作者提出了行为一致性奖励(Behavior Consistency Reward, BehR)。
具体做法很简单:找一个冻结的参考智能体(比如Qwen3-8B),让它分别在真实状态 s 和预测状态 ŝ 下,对同一组候选动作打分(输出对数概率)。两个打分向量越接近,奖励越高。数学表达为:
$$ R_{\text{BehR}} = -| \log \pi(a|s, \tau) - \log \pi(a|\hat{s}, \tau) |_2 $$
这意味着:
- 如果预测漏掉了目标商品,智能体在 ŝ 下对“点击该商品”的打分会暴跌,与真实状态下的高分形成巨大差距,导致奖励骤降;
- 如果只是删掉无关商品,打分几乎不变,奖励不受影响。
训练时,世界模型对每个输入生成多个候选预测,分别计算BehR,再用组相对策略优化(GRPO)进行策略梯度更新。整个过程不需要人工标注偏好,只需一个本地冻结的参考智能体提供反馈。
实验:16组配置,一致性全面提升
实验在两个经典环境展开:
- WebShop:模拟电商网站导航,任务如“买一件红色高领毛衣”;
- TextWorld:基于文本的冒险游戏,需理解复杂指令并操作虚拟物品。
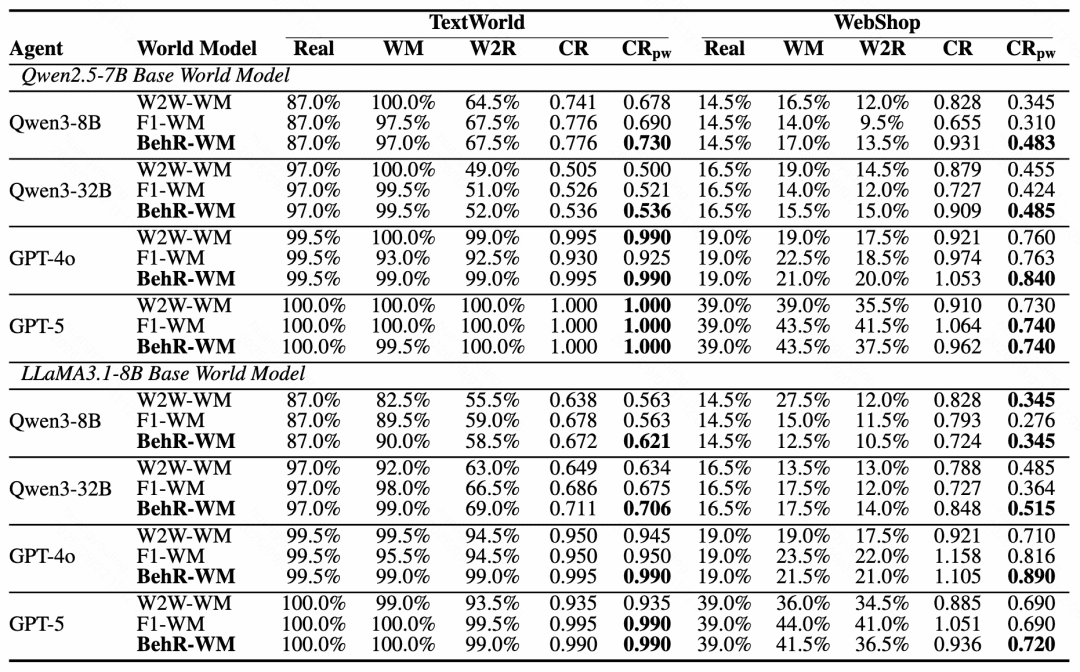
基座模型覆盖 Qwen2.5-7B 和 LLaMA3.1-8B,评测智能体包括 Qwen3-8B、Qwen3-32B、GPT-4o 和 GPT-5,共组成16种配置。
评估指标采用逐任务配对一致率($CR_{pw}$):让同一智能体分别在真实环境和世界模型中跑完整轨迹,看任务结果是否一致(成功/失败匹配)。越接近1.0越好。
结果非常清晰:BehR在13组配置中提升了一致性,其余3组持平,无一退化。
在WebShop上提升最显著:
- Qwen3-8B 的 $CR_{pw}$ 从 0.345 提升至 0.483(+13.8个百分点,约+40%);
- GPT-4o 从 0.760 提升至 0.840(+8.0个百分点,约+10.5%)。
TextWorld上,强智能体基线已接近满分,BehR的作用更多是维持这种高一致性,防止因幻觉导致意外失败。
下游应用:离线评估更准,前瞻规划更有效
离线评估:大幅降低假阳性
弱智能体在简化环境中容易“蒙混过关”。例如,TextWorld上 Qwen3-0.6B 的真实成功率为0%,但用传统世界模型评估时,竟有42.5%的任务被判为成功——近一半是假阳性。
换成BehR训练的世界模型后,假阳性率骤降至9.5%,一致率从57.5%升至90.5%。这意味着离线评估终于能更真实地反映智能体能力,而不是被“友好”的幻觉欺骗。
前瞻规划:先想再动,效果更好
让智能体每步提出5个候选动作,用世界模型模拟后果,再选最优执行。这是典型的“前瞻规划”(lookahead planning)。
在WebShop上,BehR世界模型帮助 Qwen3-8B 将成功率从14.5%提升到25.5%(+11.0个百分点),优于基线的+9.0pp。而且智能体越弱,获益越大——因为它们更依赖“先想一下再行动”的机制来弥补决策能力的不足。
重新定义世界模型的价值
这项工作挑战了一个默认假设:世界模型的好坏取决于它生成的文本有多像真实环境。实际上,真正重要的是它能否引导智能体做出一致的行为。
BehR通过冻结参考智能体的行为差异提供训练信号,无需额外标注,在多个环境、多种模型组合下验证了有效性。它不仅提升了轨迹级一致性,还在离线评估和前瞻规划等实际场景中带来明确收益。
未来,或许我们该少问“这段文本像不像真实页面”,多问“智能体会不会因此做出错误决定”。毕竟,世界模型不是为了写小说,而是为了让智能体在虚拟与现实之间无缝切换。