基础模型时代的人类中心智能:从视觉感知到具身行动的全谱系演进
在人工智能迈向通用智能的进程中,“人”始终是核心参照对象。过去十年,计算机视觉与图形学围绕人体的研究主要聚焦于静态属性识别或孤立任务优化,如人脸检测、姿态估计或服装分割。然而,随着基础模型(Foundation Models)的崛起,这一范式正在发生根本性转变——人类不再仅是被观察的对象,而是作为动态、交互、嵌入环境并能影响世界的智能主体被系统建模。这种转变催生了一个更宏大、更整合的研究方向:人类中心智能(Human-Centric Intelligence)。

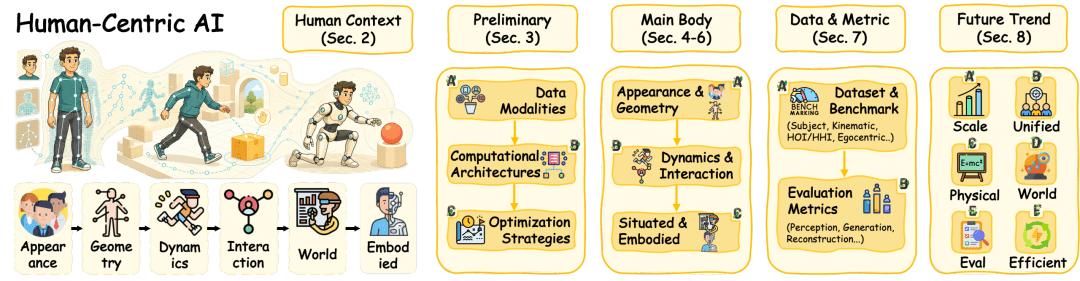
近期由香港理工大学郭径材助理教授团队牵头,联合全球十余所顶尖高校与产业机构发布的综述《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,首次提出一个覆盖感知、行为与行动的全谱系框架,将分散的研究脉络整合为三个递进视角与六个能力层次。这一框架不仅厘清了技术演进逻辑,也为未来研究提供了结构性指引。
从“看见人”到“理解人”:可观察主体的双重维度
人类中心智能的起点是视觉感知。传统方法依赖任务特定模型,例如用ResNet做人脸识别、用HRNet做姿态估计。但在基础模型时代,这一范式被打破。大型视觉语言模型(如CLIP、DINOv2)和扩散模型(如Stable Diffusion)展现出强大的跨任务泛化能力,使得“以人为中心”的通用表征成为可能。
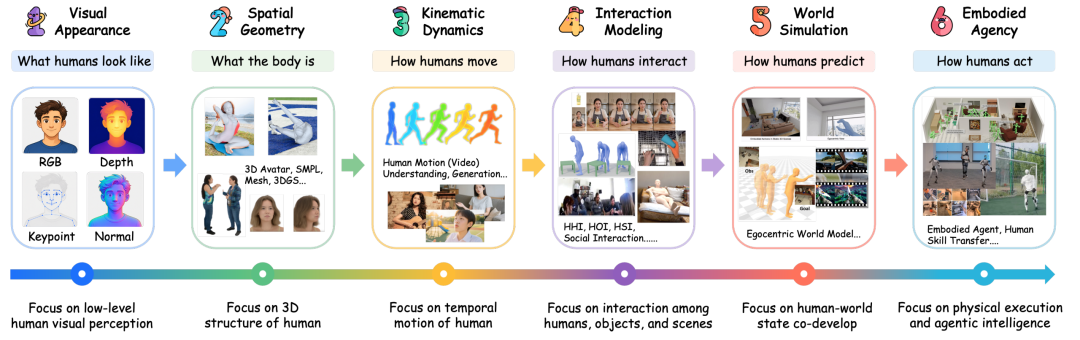
综述将这一阶段细分为两个互补维度:视觉外观与空间几何。
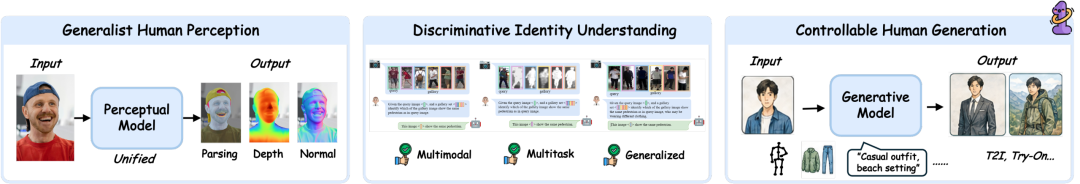
在视觉外观层面,研究重点已从单一属性识别转向多条件可控生成。例如,通过文本提示生成特定年龄、性别、服饰风格的人物图像,或在视频中保持身份一致性的换装与表情迁移。这类工作依赖大规模人物数据集(如LAION-Human、DeepFashion)和精细化的语义对齐机制。趋势表明,未来的外观建模将更强调身份稳定性、光照鲁棒性与跨域一致性,而非单纯追求像素级逼真。
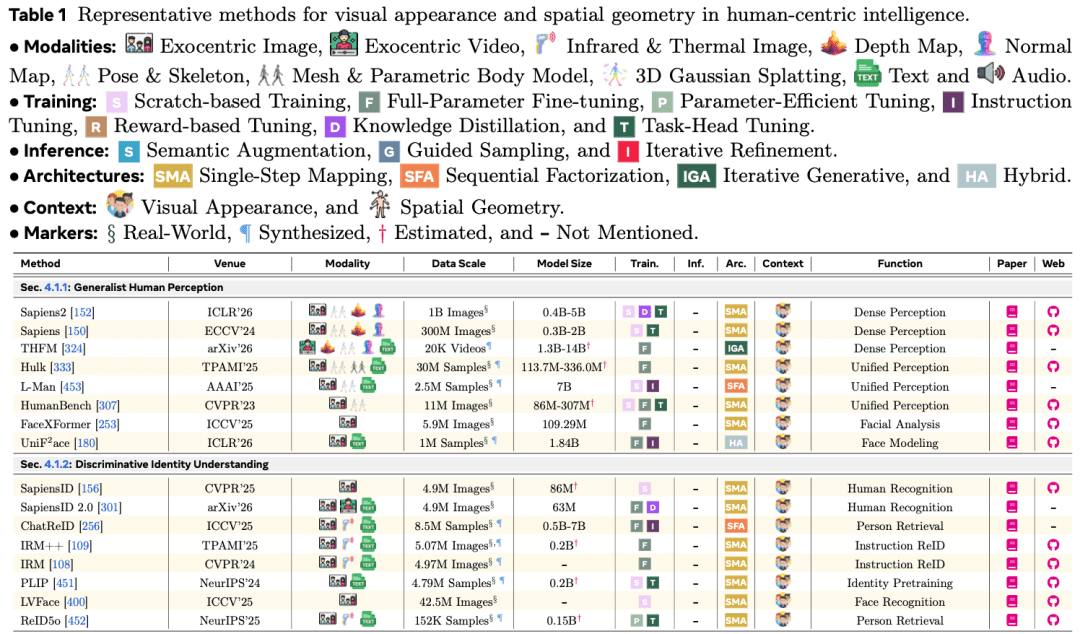
空间几何则关注人体在三维空间中的结构表达。早期方法如HMR、SPIN通过回归SMPL等参数化模型实现单图三维重建,但受限于模板假设与遮挡问题。当前前沿工作开始融合神经辐射场(NeRF)、高斯泼溅(3DGS)等新表示,构建可渲染、可动画的数字人。然而,综述指出一个关键矛盾:视觉合理性不等于几何准确性。许多生成结果虽“看起来像人”,却在关节角度、肢体比例或空间一致性上违背人体工学。因此,如何将生物力学约束、运动学先验嵌入基础模型,成为亟待解决的问题。
动态行动者:从孤立运动到开放交互
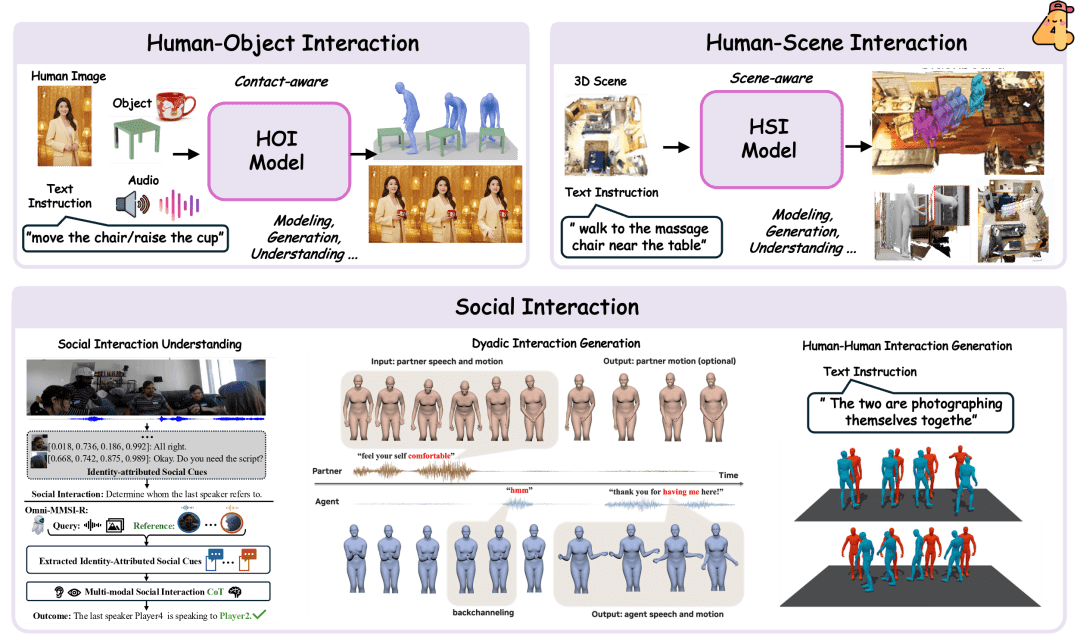
一旦跳出静态图像,人类便展现出其本质特征——动态性。人体不是雕塑,而是持续运动、与环境互动的生命体。因此,第二阶段聚焦于运动动力学与交互建模。
运动动力学研究如何建模人体状态的时间演化。早期运动生成依赖动作捕捉数据(如AMASS、Human3.6M),采用RNN或Transformer预测关节轨迹。但这些方法难以处理长时依赖与多模态输出。近年来,扩散模型与自回归架构被引入,实现了从文本、音频甚至脑电信号驱动的高质量运动生成。例如,MotionDiffuser可根据“挥手打招呼”生成自然手臂摆动,而EmoTalk则能根据语音韵律同步生成面部表情。
然而,真实人类行为极少孤立存在。我们拿杯子、开门、与他人击掌——这些动作天然涉及物体、场景与社会关系。交互建模正是要捕捉这种复杂语境。当前方法可分为两类:一是基于物理引擎的仿真(如NVIDIA Omniverse),二是数据驱动的关系推理(如使用图神经网络建模人-物接触点)。基础模型在此展现出独特优势:其开放词汇能力可泛化至未见物体或场景,而大规模预训练使其具备常识推理能力,例如推断“人弯腰可能是为了捡东西”。
综述强调,未来交互建模需突破三大瓶颈:关系泛化性(能否处理任意人-物组合)、时间连贯性(动作是否流畅自然)与意图可解释性(为何如此行动)。这要求模型不仅学习“怎么做”,更要理解“为什么做”。
情境化智能体:嵌入世界并影响世界
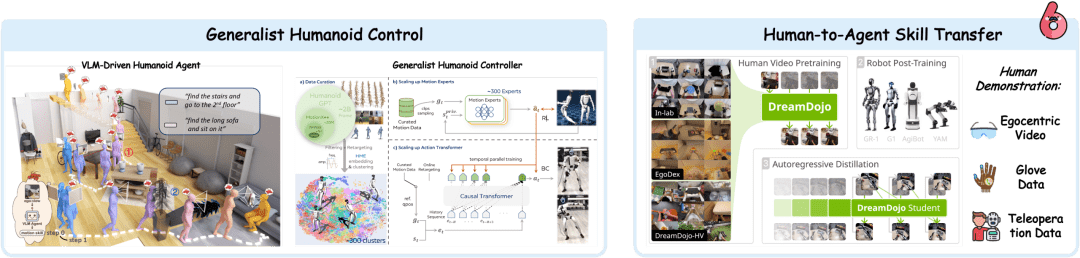
当人类被置于动态环境中,智能的终极考验不再是“能否生成逼真视频”,而是“能否预测并干预世界演化”。这引出了第三阶段:世界模型与具身行动。
世界模型旨在学习以人类为中心的环境动态规律。不同于通用视频预测模型(如Phenaki),人类中心世界模型需显式建模人与环境的耦合关系。例如,在第一视角(Egocentric)视频中,手部动作会改变物体位置,进而影响后续视觉输入。这类模型可用于行为规划、风险预测或虚拟训练。当前前沿工作如EgoExo4D、BEHAVIOR-1K提供了丰富的多视角交互数据,但如何实现长时因果一致性仍是挑战——模型常在短期逼真,长期却逻辑崩坏。
具身行动则将智能推向物理执行端。无论是虚拟数字人还是实体人形机器人,其核心问题是如何将人类行为经验迁移到异构身体上。例如,从YouTube视频中学到的“倒水”动作,如何适配到具有不同关节数、力矩限制的机器人?现有方法如RT-2、VIMA尝试用大模型桥接感知与控制,但面临形态鸿沟(morphology gap)与控制延迟问题。综述指出,未来需发展可迁移的运动基元(motion primitives)与分层控制架构,使高层意图能稳健映射至底层执行。
支撑体系:数据、基准与评价的系统化重构
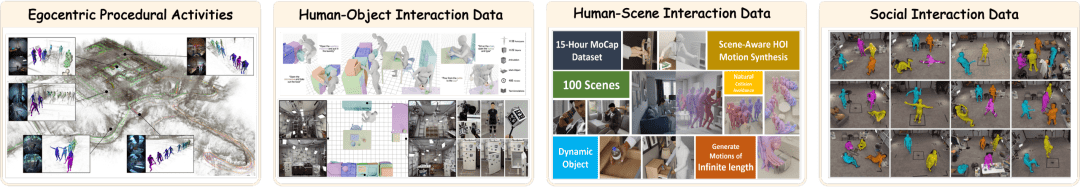
任何技术演进都离不开基础设施。综述系统整理了四大类资源:
- 人类主体数据集:如COCO、MPII(2D姿态),3DPW、SURREAL(3D重建);
- 人类动态数据集:如BABEL(动作语义标注),Motion-X(多模态运动生成);
- 人类交互数据集:如EPIC-KITCHENS(第一视角交互),GRAB(手-物接触);
- 人类具身数据集:如BEHAVIOR、RLBench(机器人操作)。
在评测方面,传统指标如MPJPE(关节误差)、FID(生成质量)已不足以衡量高级能力。综述呼吁建立跨层级综合评测协议,例如:
- 在交互任务中评估物理合理性(如接触力是否合理);
- 在世界模型中测试因果干预能力(如“若人未松手,杯子是否会掉落?”);
- 在具身系统中衡量任务成功率与能耗效率。
未来挑战:超越视觉真实,走向行动可用
综述总结六大关键挑战,直指当前研究的深层局限:
- 可信且可扩展的人体数据:现有数据多来自实验室或受控环境,缺乏多样性与真实性;
- 跨层级迁移的基础模型:如何设计统一架构,支持从外观到行动的端到端推理;
- 物理一致的动态表征:运动与交互必须符合牛顿力学与生物力学约束;
- 人类中心世界模型与具身智能的协同:预测与执行需形成闭环;
- 综合能力评测标准:需超越单项指标,构建任务导向的系统级评估;
- 高效可部署系统:学术模型往往计算昂贵,难以落地实际应用。
这些问题共同指向一个核心命题:人类中心智能不能止步于“看起来像人”,而必须“行动如人”——在结构上可信、物理上可行、任务上有用。
值得强调的是,作者团队同步发布了GitHub资源库(https://github.com/cseeyangchen/Human-Centric-AI),持续整合论文、代码、数据集与教程。这一开放平台有望成为社区协作的枢纽,加速从碎片化研究走向系统化创新。
人类中心智能的终极目标,或许不是复制人类,而是构建能与人类共处、协作、甚至共情的智能体。在基础模型提供的强大底座之上,这一愿景正从科幻走向工程现实。而清晰的框架、开放的资源与批判性的反思,将是通往这一未来的关键基石。