从执行到掌舵:长程Agent为何仍需人类?Argus如何破局?
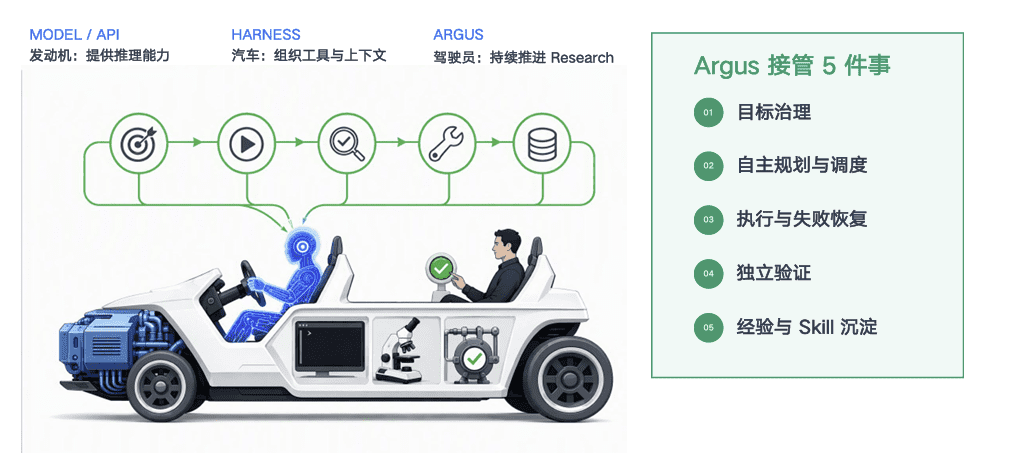
近年来,随着大模型能力的跃升,AI Agent 已能熟练调用工具、修改代码、运行实验,初步实现了与真实世界的交互。然而,当任务时长从几十分钟延伸至数天甚至更久,一个显著瓶颈浮现:系统仍需人类长期值守屏幕,实时判断下一步行动方向。这种依赖并非源于模型无法执行指令,而是因为现有 Agent 架构普遍只自动化了“执行”环节,却未解决更高阶的“驾驶”问题——即在缺乏明确奖励信号和清晰目标的情况下,如何持续、高效、有方向地推进复杂研究任务。

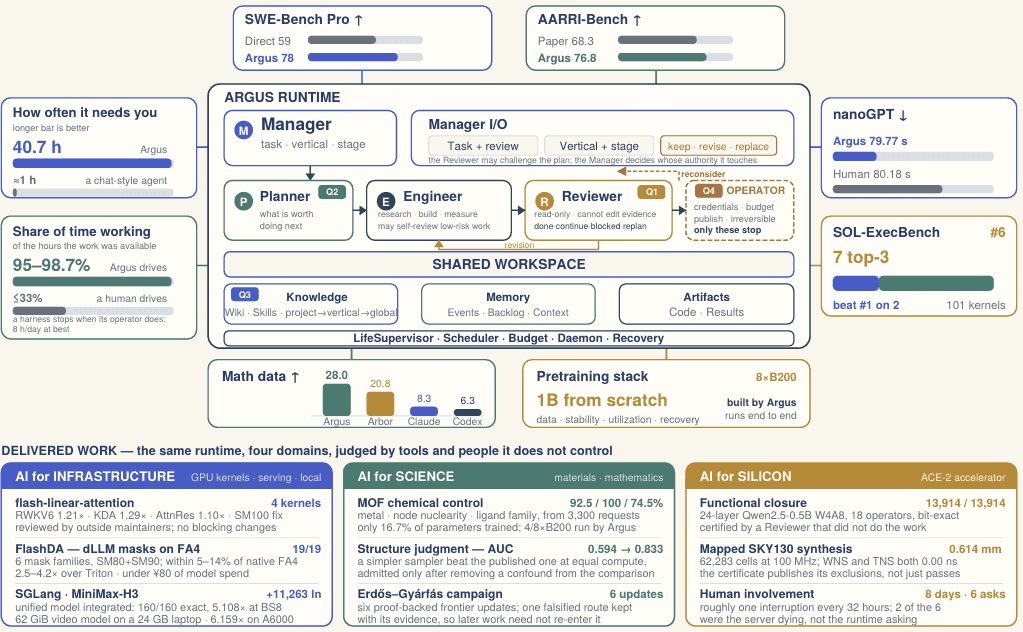
微软与上海交通大学等机构近期开源的 Argus 系统,正是针对这一核心挑战提出的系统性解决方案。Argus 并非仅仅追求在基准测试中取得高分,而是构建了一套面向真实科研场景的通用长程推理运行时。其技术报告覆盖 27 个独立 Campaign,累计运行 1,548 小时墙钟时间,平均仅每 40.7 小时才需一次人类主动干预,任务占空比高达 95.1%~98.7%。更重要的是,Argus 在 AI4AI、GPU Kernel 优化、模型训练、AI4Science、芯片设计、数学证明、系统研究等多个前沿领域产出了可验证的实质性成果,标志着 Agent 正从“自动执行器”向“自主研究员”演进。
从目标驱动到证据驱动:重新定义 Agent 的决策逻辑
传统 Agent 设计多采用 Goal-Driven(目标驱动)范式:用户设定一个初始目标,Agent 围绕该目标规划并执行动作。这种模式在短周期、结构化任务中表现良好,例如自动泊车或单次代码修复。但一旦进入开放性、探索性强的长周期研究场景,问题便暴露无遗。研究初期的目标往往只是基于有限信息的假设,随着实验推进,新证据不断涌现,原始目标可能变得不切实际甚至错误。若 Agent 仍机械地追逐初始目标,极易陷入“目标僵化”陷阱——在不可能成功的路径上反复消耗计算资源与 Token,却无法自我修正。
Argus 提出的核心创新在于将控制逻辑从 Goal-Driven 转向 Evidence-Driven(证据驱动)。在此范式下,Agent 的下一步行动不再由预设目标决定,而是由当前已获得的所有证据动态推导而来。系统引入了一个名为 Driver 的高层决策模块,其职责是在计划与现实发生冲突时,依据最新证据重新校准航向。具体而言,Driver 需持续回答四个关键问题:
- 当前工作是否已完成且质量达标? —— 避免过早终止或无效重复;
- 基于现有证据,下一步最值得投入资源的方向是什么? —— 实现动态优先级排序;
- 本轮经验应如何调整后续系统行为? —— 支持策略自进化;
- 剩余问题是否触及人类专属决策边界? —— 明确人机协作接口。
这种机制使得 Argus 能够在目标模糊、反馈稀疏的环境中保持研究连贯性。例如,在数学猜想验证任务中,Agent 可能最初尝试某种证明路径,但若干次失败后,新生成的反例或中间引理构成关键证据,促使 Driver 主动转向替代方法,而非固执于原计划。
构建通用长程运行时:多角色协作与知识沉淀架构
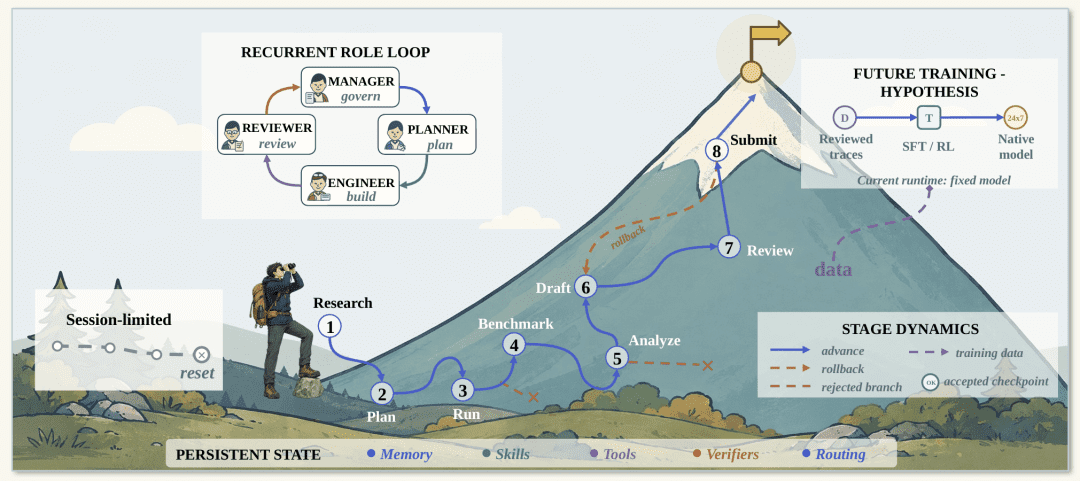
为支撑 Evidence-Driven 决策,Argus 设计了一套高度结构化的运行时架构。它将长期项目组织为 Campaign(战役),每个 Campaign 由一系列边界清晰的 Mission(任务)组成。其核心工作流采用四角色闭环:Manager → Planner → Engineer ⇄ Reviewer → Manager。
- Manager 扮演战略指挥官角色,负责阶段转换、流程审批与全局策略制定;
- Planner 基于当前证据库规划具体子任务,生成可执行方案;
- Engineer 进入真实环境(如代码库、实验平台)执行操作;
- Reviewer 独立审查产出工件,评估其创新性、有效性与合规性,并向 Manager 汇报或要求 Engineer 返工。
这一设计的关键优势在于 上下文隔离与角色专业化。不同于将所有功能集成于单一 Agent 的做法,Argus 通过角色分工避免了“局部爬山”问题——即 Agent 因上下文过载而陷入次优解。每个角色拥有专属上下文窗口,但共享统一工作区(Workspace),既提升 Token 利用效率,又保障信息一致性。更值得注意的是,Argus 支持在同一任务中混合调用不同 Harness(如 Pi、Codex、Claude Code、DeepSeek),实现高度客制化的工具链组合。
此外,Argus 强调 Core 与 Vertical 的解耦。Core 层提供通用能力:角色权限管理、证据提交协议、人类干预边界定义;Vertical 层则由领域专家定制,明确特定领域(如数学、材料科学、芯片设计)中何为“有效证据”,并注入领域专属技能与知识库。这种架构不仅提升了跨领域适应性,也为人类专家与 Agent 的协同进化提供了标准化接口。
所有通过质量门槛的经验会被沉淀至 Wiki(知识库)与 Skill(技能库),按 Project、Vertical 或 Global 作用域分类存储,供后续任务复用。这种自进化机制使系统能力随时间累积增强,形成正向循环。
1548 小时的真实验证:从工程交付到科学探索
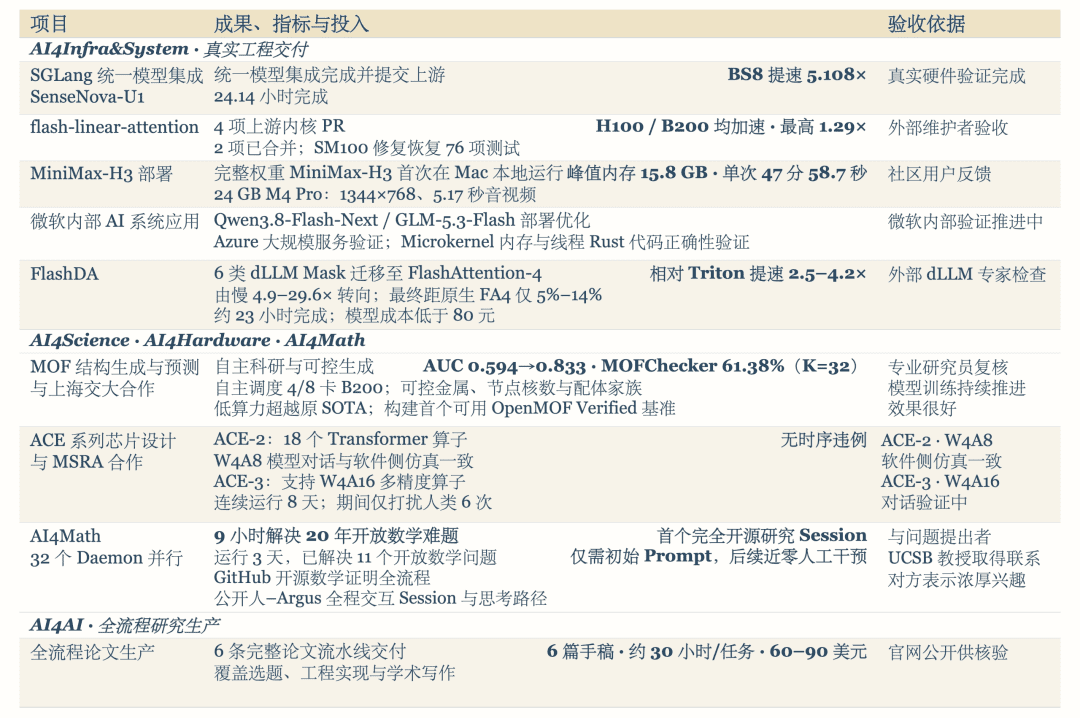
Argus 的价值最终体现在其产出的真实性与广度。在不到一个月的开源周期内,系统已在多个高难度领域取得突破:
- AI4System & Infra:成功自动化部署并优化分布式训练流水线,产出可直接集成的工程交付物;
- AI4Science:在材料发现任务中,通过高通量模拟筛选出潜在高性能合金成分;
- AI4Hardware:自动生成并验证新型 GPU Kernel,性能优于手工优化版本;
- AI4Math:公开完整运行日志,展示对开放数学猜想的系统性探索过程,包括反例构造与引理推导;
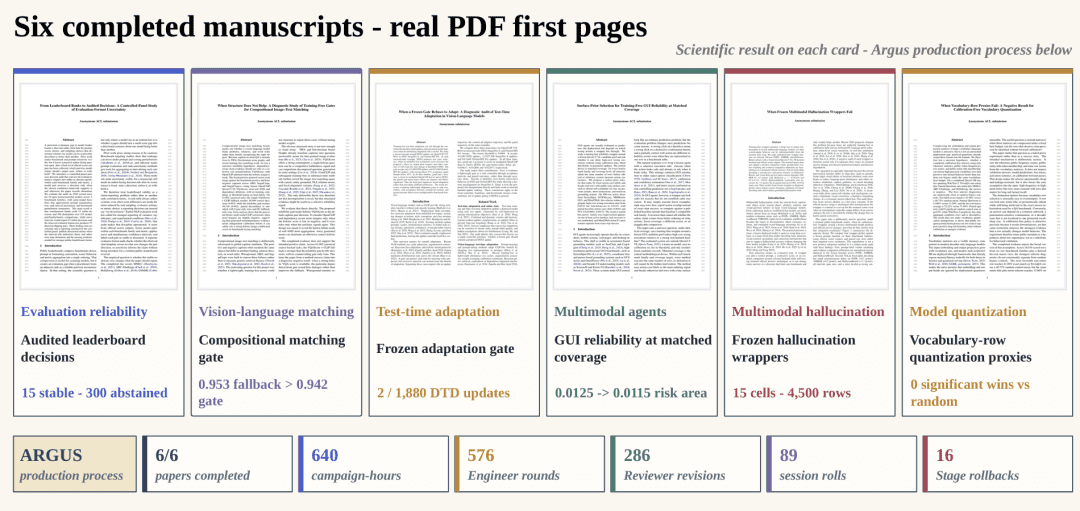
- AI4AI:实现从问题定义、实验设计、结果分析到论文撰写的端到端研究流程。
这些成果共同勾勒出一条清晰的价值演进路径:从自动化执行 → 自动化交付 → 自动化探索 → 全流程自主研究。评价标准也相应从“是否完成指定任务”转向“能否独立推进悬而未决的科学问题”。尤其在数学领域,Argus 是首个公开完整 session 日志的团队,其透明性为社区验证 Agent 的科研能力提供了宝贵基准。
长程智能的本质:让研究在无人值守时继续
Argus 的真正意义,远不止于延长 Agent 的运行时间。它重新定义了人机协作的边界:人类从“持续推动的驾驶员”转变为“关键时刻的副驾驶”。Harness 解决了“如何行动”,而 Driver 解决了“向何处去”。当屏幕熄灭、研究人员离线,项目不再归零,而是依据证据持续演进。
这种转变预示着一个 研究加速时代 的到来。在 Argus 架构下,研究进度不再受限于人类的工作节律,Token 被高效转化为智能行动,智能行动又沉淀为可复用的知识资产。未来,每个科研团队或许都将拥有自己的“数字实验室”——一个能 24/7 不间断探索、试错、进化的智能体集群。
当然,挑战依然存在。如何进一步降低人类干预频率?如何在更广泛的科学领域定义“有效证据”?如何确保自进化过程的可靠性与可解释性?这些问题的答案,或许就藏在下一个 1548 小时的运行数据中。但可以肯定的是,从“会执行”到“会掌舵”,Argus 已为长程 Agent 的发展树立了新的里程碑。