中国开源大模型如何成为全球AI发展的新度量衡?
在全球人工智能竞争日益激烈的背景下,一种新的格局正在悄然形成:中国开源大模型正逐步成为衡量各国AI能力的新“度量衡”。这一转变并非源于单一技术突破,而是由开放策略、成本优势、本地化灵活性以及地缘政治现实共同推动的结果。
过去,全球AI话语权长期被美国主导的闭源模型(如GPT、Claude)所垄断。这些模型虽在能力上限上领先,但其黑箱特性、高昂调用成本及数据出境风险,使得许多国家难以将其纳入国家战略体系。而中国近年来推出的Qwen、DeepSeek、MiniMax、Kimi等开源或开放权重模型,恰好填补了这一空白——它们提供接近前沿的能力,同时允许本地部署、持续训练和完全控制,从而成为各国构建“国产AI”的理想底座。
沙特案例:用资本换时间,用数据换主权
2025年成立的沙特国家AI公司HUMAIN,由王储小萨勒曼亲自推动,目标是建立覆盖算力、模型到应用的完整AI生态。然而,从零开始训练一个具备前沿能力的大模型,即便对拥有雄厚资本和能源优势的沙特而言,也意味着数年时间与巨大试错成本。
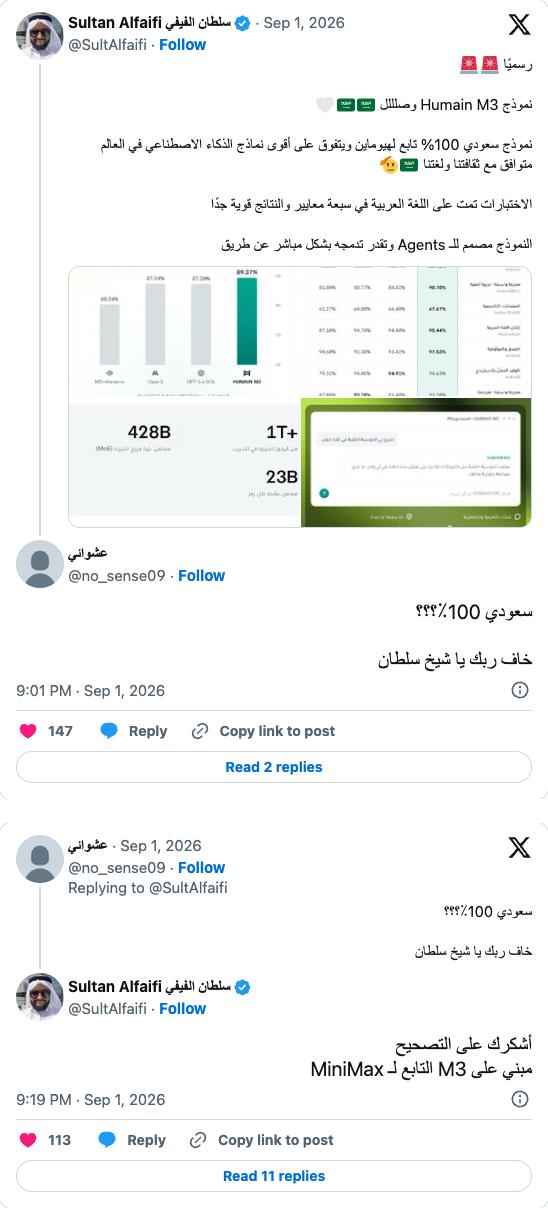
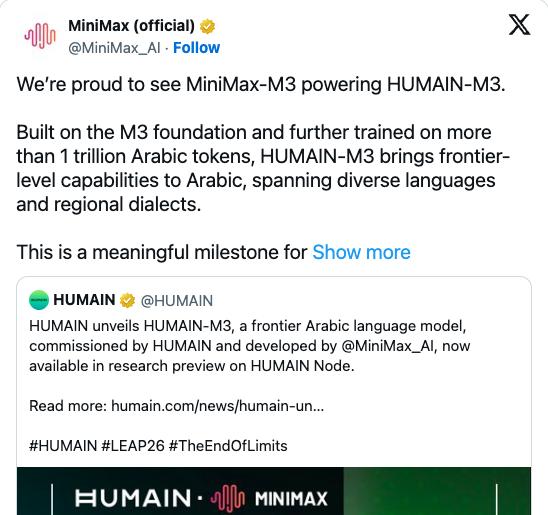
于是,HUMAIN选择与中国公司MiniMax合作:后者提供已完成基础训练的MiniMax-M3模型,前者则投入超过1万亿阿拉伯语tokens进行领域适配,并部署于本国服务器。最终发布的HUMAIN-M3虽以“沙特国家模型”名义亮相,但其技术底座清晰标注为MiniMax-M3。这一合作模式实现了双赢——沙特获得了模型控制权与数据主权,MiniMax则首次将中国基础模型嵌入他国国家级AI体系的核心层。
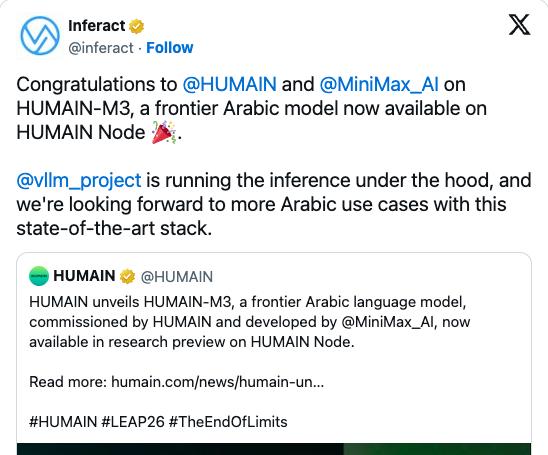
值得注意的是,HUMAIN-M3在七项阿拉伯语基准测试中平均得分达89.37%,比原始M3提升9个百分点,证明了“基础模型+本地数据”路径的有效性。更重要的是,这种模式绕开了对闭源API的依赖,使沙特在信息安全、服务连续性和政策合规方面拥有了更大主动权。
从亚洲到中东:中国模型成“自研”上游
HUMAIN-M3并非孤例。在日本,乐天发布的Rakuten AI 3.0虽宣称是“高性能日语模型”,但其配置文件明确显示使用了DeepSeekV3架构。尽管无法确认是否直接复用权重,但DeepSeek定义的模型结构与接口标准已实质性影响了日本本土AI的技术选型。
在东南亚,新加坡国家研究基金支持的AI Singapore项目基于Qwen3-VL开发出Qwen-SEA-LION,一次性覆盖缅甸语、印尼语、菲律宾语等七种语言;泰国CMKL大学则利用Qwen3.5构建泰英双语模型MANGO。这些项目均未从头预训练,而是依托中国开源模型快速实现多语言能力落地。
更令人瞩目的是,连Meta这样的美国科技巨头也在其代号“Avocado”的新模型训练中引入Qwen等开放模型作为辅助数据源。彭博社报道称,Meta此举旨在以更低的成本补齐特定能力短板。这表明,即便拥有顶级研发资源,全球头部企业也开始接受“混合训练”范式——即不再坚持所有组件必须自研,而是优先考虑效率与经济性。
此外,坊间传闻称部分海外团队因Claude模型成本过高而转向本地部署Kimi K3,虽缺乏官方证实,但Kimi已公开提供与Claude Code的兼容接口,且Mozilla技术负责人Raffi Krikorian公开表示将日常任务迁移至Kimi K3,理由正是“更快、更便宜”。
开放权重:构建全球AI新基线
中国模型之所以能迅速渗透全球市场,核心在于其独特的“开放权重”策略。与传统开源软件不同,这些模型通常采用社区许可(如MiniMax的协议),允许商用、微调和部署,但限制直接复制分发。这种介于完全开源与闭源之间的中间态,既保护了开发者权益,又满足了企业对可控性和安全性的需求。
Hugging Face平台的数据印证了这一趋势:过去一年,中国研发模型占平台总下载量的41%,首次超越美国。仅Qwen家族就衍生出超过11.3万个微调版本。这些数字背后,是无数开发者、企业和政府机构基于中国模型进行本地化创新的实践。
更重要的是,中国模型正在重新定义“AI及格线”。过去,评估一个新模型只需看它离GPT还有多远;如今,采购方还会追问:与Qwen相比贵多少?能否本地部署?是否允许客户保留权重?当沙特、日本、新加坡乃至Meta都用实际行动回答这些问题时,中国开放模型便自然成为全球AI能力的参照系。
技术栈协同:从模型到底层工具链
中国模型的影响力不仅限于权重本身,还延伸至整个技术生态。例如,HUMAIN-M3的推理服务由开源框架vLLM支撑,形成“开放权重模型+开放工具链”的完整技术栈。这种组合极大降低了部署门槛,使各国无需依赖特定厂商即可构建高性能AI服务。
vLLM、TensorRT-LLM、FastChat等中国团队广泛采用的推理优化工具,正与Qwen、DeepSeek等模型深度耦合,形成一套高效、可复制的部署范式。这种软硬协同的优势,进一步巩固了中国模型在全球AI基础设施中的地位。
地缘意义:AI主权时代的新型合作
在AI主权日益重要的今天,各国对数据安全、算法透明和供应链可控的要求不断提高。美国对华芯片出口管制、欧盟《人工智能法案》对高风险系统的严格监管,都促使非西方国家寻求替代方案。中国开放模型恰好提供了这样一条路径:既能获得接近前沿的能力,又能避免陷入地缘政治风险。
虽然目前尚无证据表明HUMAIN-M3项目由中国主导的WAICO(世界人工智能合作组织)直接促成,但其合作逻辑与中方倡导的“面向全球南方的AI能力建设”高度一致。未来,随着中国推动与阿盟共建国际AI应用合作中心,此类“技术输出+本地共建”模式有望制度化、规模化。
挑战与隐忧
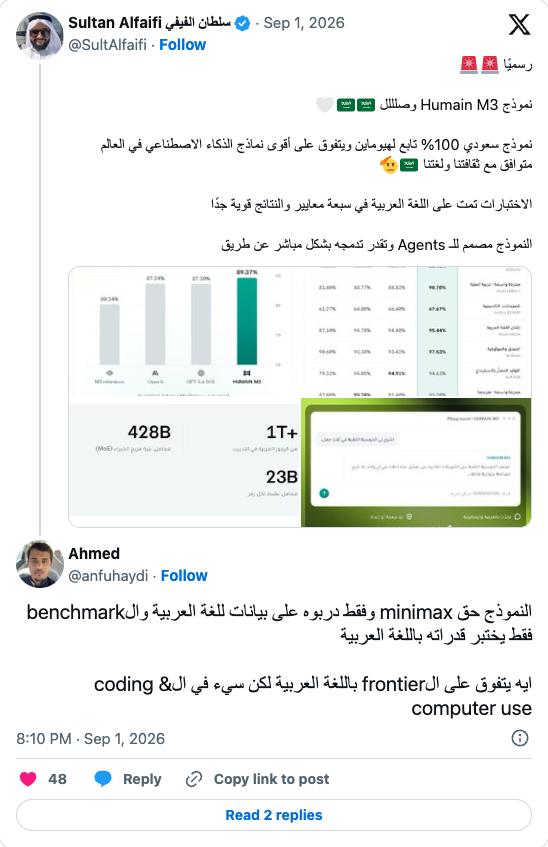
当然,这一趋势也面临挑战。首先,开放权重不等于永久依赖,各国在完成本地化后可能逐步替换底座,导致中国品牌“隐形化”。其次,模型性能虽接近前沿,但在复杂推理、代码生成等细分领域仍与GPT-4存在差距。再者,社区许可的法律边界尚不清晰,可能引发知识产权争议。
但总体而言,中国开源大模型已成功开辟了一条不同于美国闭源垄断的发展路径。它们不是要取代GPT,而是为全球大多数国家提供了一种更现实、更可控、更具成本效益的选择。
当一个沙特开发者能在利雅得本地服务器上运行基于MiniMax的阿拉伯语模型,当一位曼谷工程师用Qwen微调出泰语客服系统,当东京的AI团队以DeepSeek架构构建日语智能体——中国模型便不再是单纯的“产品”,而成为全球AI协作网络中的通用语言与基础设施。这或许正是“度量衡”一词最深刻的含义:它不强制统一,却为多样性提供标尺;它不追求霸权,却在实践中赢得共识。