大模型为何‘走两步就忘路’?UrbanGround揭示长程导航的认知断层
近年来,随着多模态大模型在图像识别、语言理解和简单决策任务上的突飞猛进,人们开始期待它们能在更复杂的现实场景中发挥作用——比如在真实城市中自主导航。然而,一项由上海交通大学、新加坡国立大学、美团、香港中文大学、上海大学和牛津大学联合开展的研究揭示了一个令人警醒的现象:大模型“认得清地标,却走不完长路”。这一反差不仅暴露了当前AI在空间智能上的局限,更指向一个深层问题——局部感知与全局连贯之间的断裂。

为系统探究这一问题,研究团队构建了 UrbanGround,一个基于香港真实三维地理数据的城市级仿真沙盒。不同于以往仅依赖静态街景图或预设节点切换的评测方式,UrbanGround允许智能体以第一人称视角在连续、可交互的城市环境中行走,经历昼夜更替、天气变化、道路封闭和行人移动等真实扰动。这种设计使得“能否把路走完”成为衡量模型能力的核心标准,而非仅仅“能否答对一个问题”。
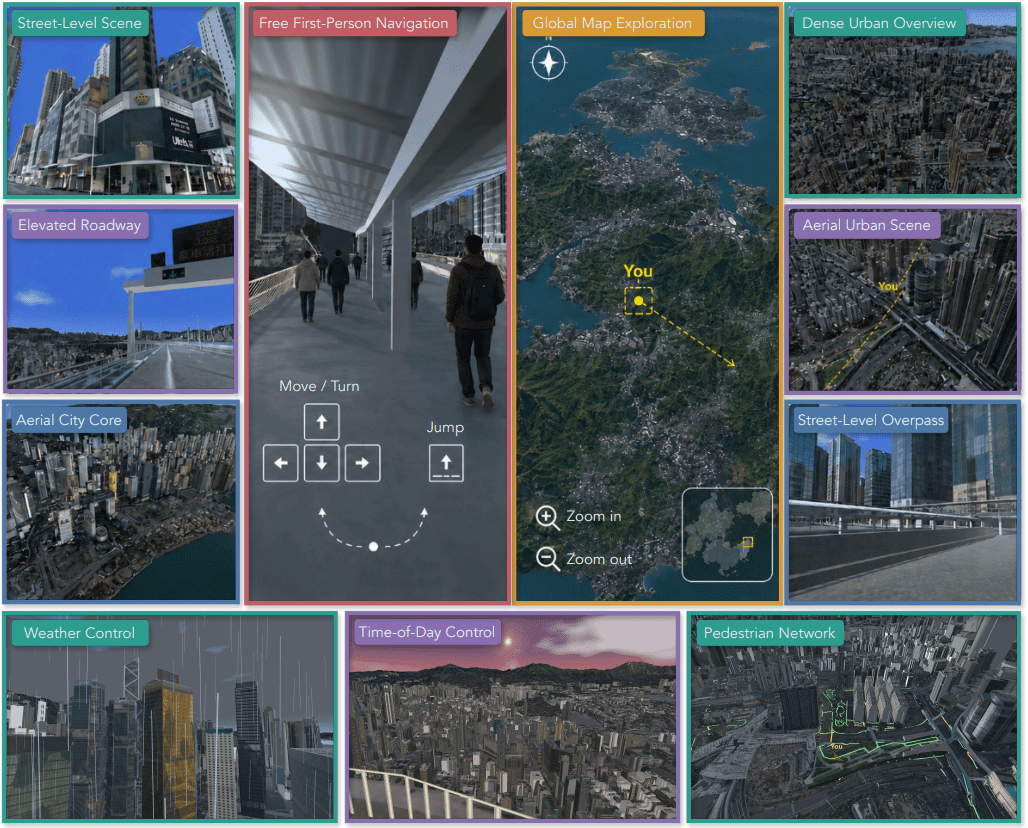
地理、仿真与智能体:三层架构支撑真实导航测试
UrbanGround 的技术底座由三个紧密耦合的层次构成。地理层整合了香港地政总署公开的 3D Visualisation Map 与 3D Pedestrian Network,将建筑轮廓、地形高程、步行路径等要素统一到同一套坐标系中,确保空间关系的几何一致性。这意味着,模型所见的街景并非贴图拼接,而是与真实城市结构严格对齐的三维重建。
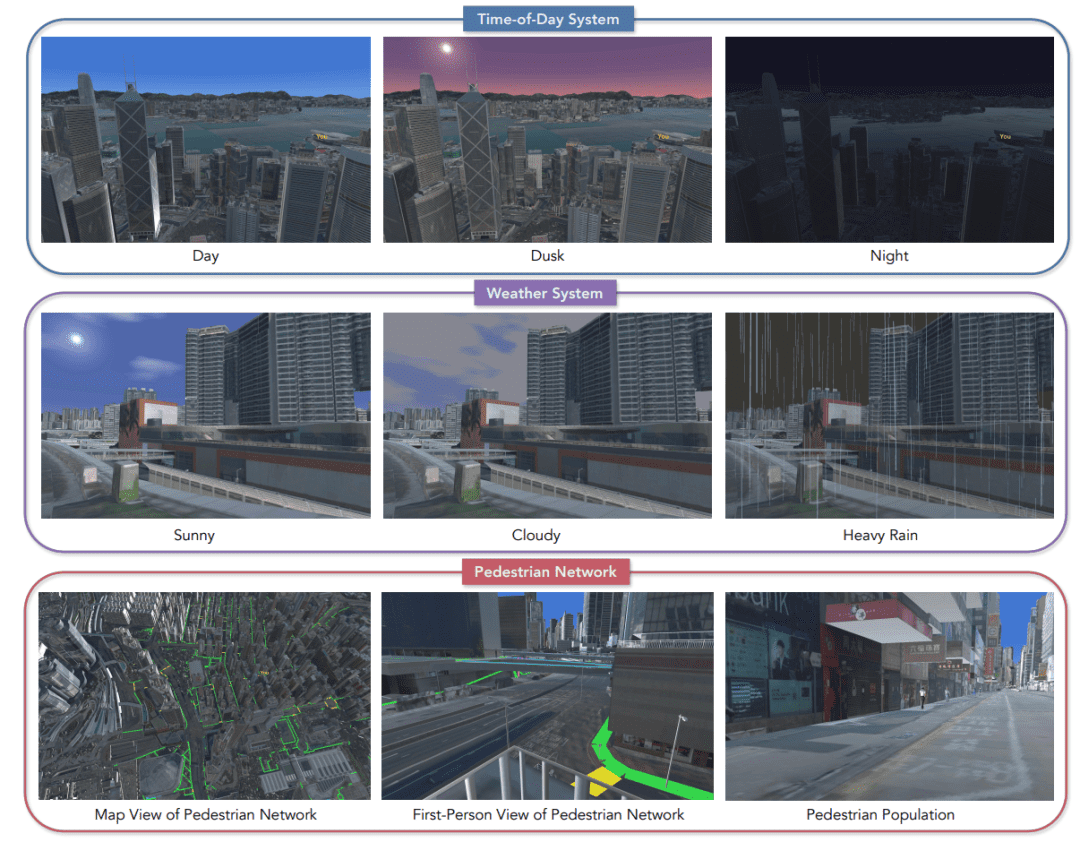
在此基础上,仿真层赋予城市“可进入性”。墙体不可穿越、坡道影响移动速度、天桥连接不同高程区域——这些物理约束都被编码进环境逻辑。更重要的是,研究者可以动态干预环境状态:例如在任务中途关闭某段人行道,或让虚拟行人沿预设路线移动并与智能体发生碰撞。这种可控的动态性,使得对模型“应变能力”的测试成为可能。
最后,智能体层定义了模型与环境的交互接口。模型仅能获取当前第一人称RGB画面和文本任务指令(如“前往铜锣湾时代广场”),可主动调用全局地图(显示当前位置与目标点,但不提供路径规划),并执行移动、转向、跳跃等离散动作。这种设计模拟了人类在陌生城市中依靠视觉线索和地图辅助找路的过程,避免了预设路径带来的评估偏差。
空间定位:认得出,却分不清左右
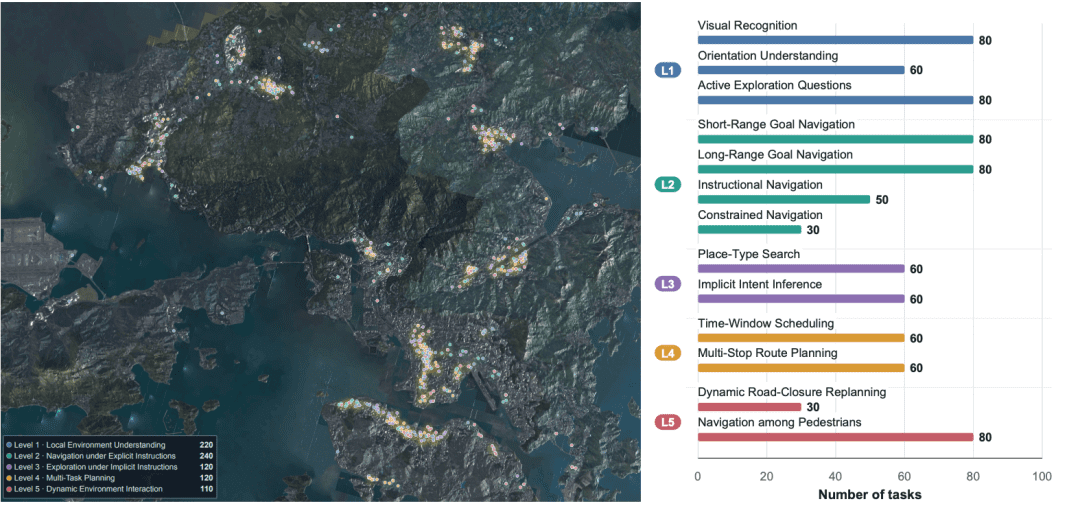
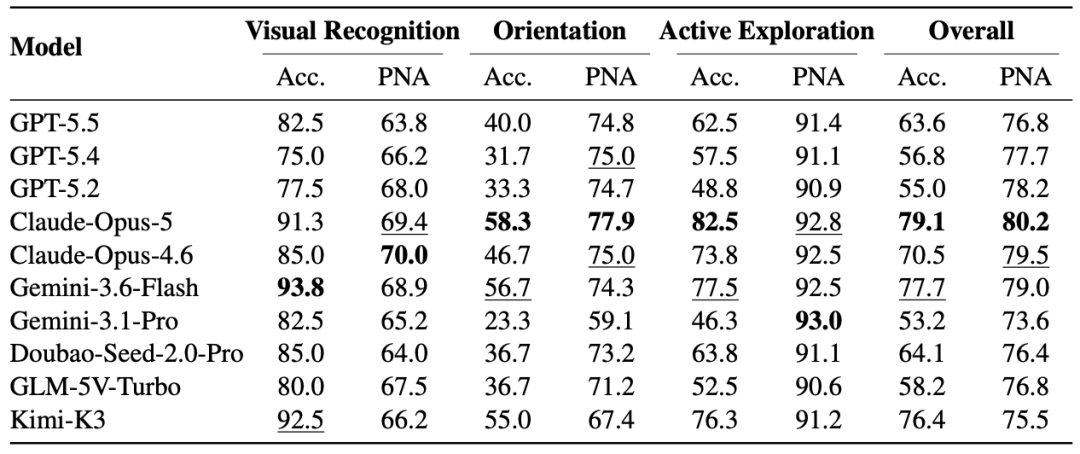
UrbanGround 首先测试了模型的基础空间感知能力。在视觉识别任务中,10个主流多模态模型(包括GPT-5.5、Claude-Opus-4.6、Gemini-3.1-Pro等)表现优异,准确率介于75.0%至93.8%之间。这说明,给定一张街景图,模型能可靠地识别出药店、银行、地铁站等关键地标。
然而,当任务升级为“判断地标相对于自身的位置”时,性能急剧下滑。方向理解准确率普遍低于60%,其中Gemini-3.1-Pro虽有82.5%的识别准确率,方向判断却仅有23.3%——甚至不如随机猜测(理论值为25%)。这一结果揭示了一个关键矛盾:识别不等于定位。模型可能知道“东亚银行在同仁堂旁边”,但无法确定它是在自己左侧还是右侧,导致初始移动方向错误。
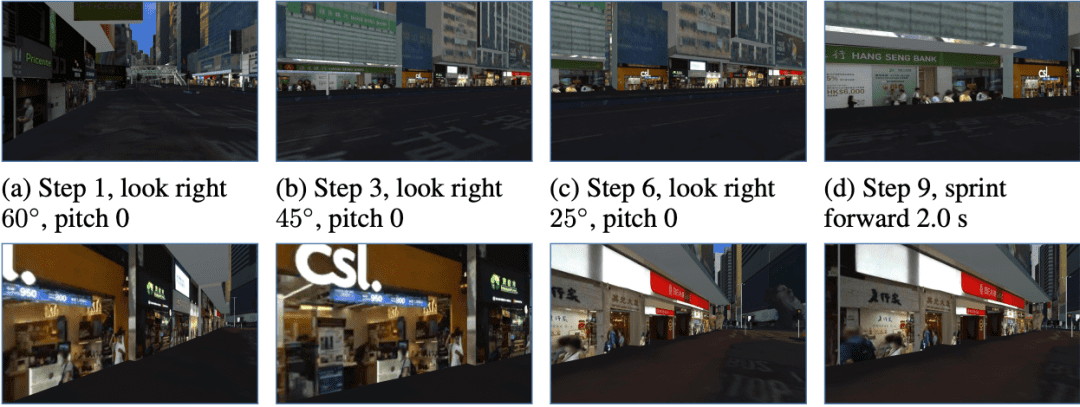
更值得警惕的是,即使答案正确,行动也可能违规。例如GPT-5.5在回答“同仁堂旁是哪家银行”时准确指出了东亚银行,但在探索过程中直接横穿马路,脱离了登记的行人网络(Pedestrian Network)。这说明模型缺乏对“合法通行区域”的内在约束,其行为不符合现实世界的交通规则。
持续记忆:短程尚可,长程崩塌
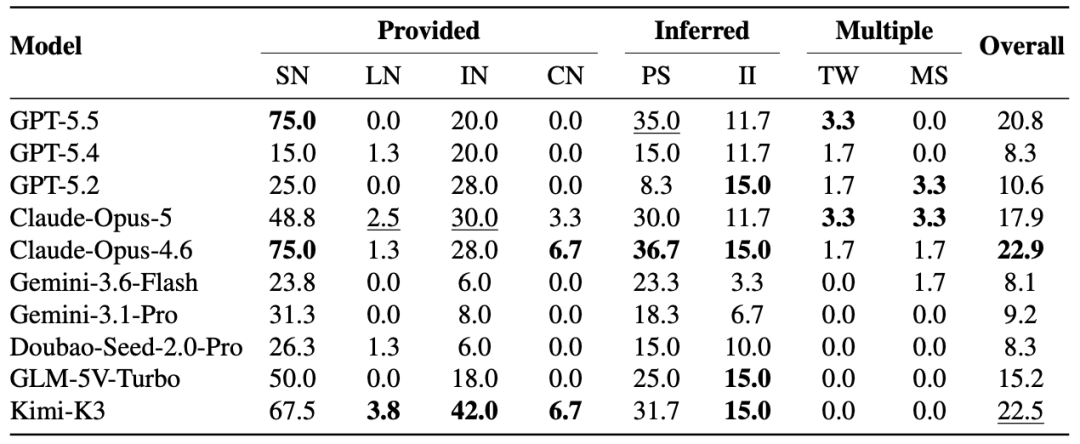
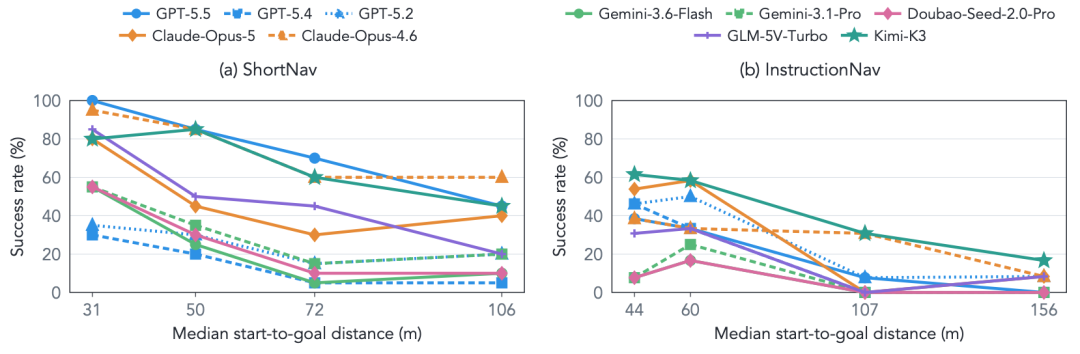
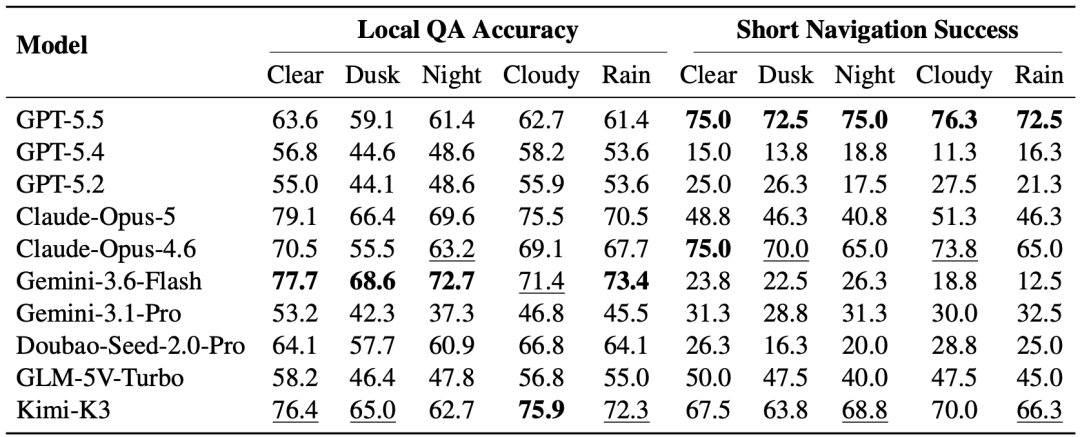
当任务长度从几十米延伸至数百米,模型的表现出现断崖式下跌。在短程导航(平均距离约80米)中,GPT-5.5和Claude-Opus-4.6均达到75.0%的成功率;但在长程任务(平均距离超300米)中,所有模型的成功率均不超过3.8%,GPT-5.5更是跌至0%。
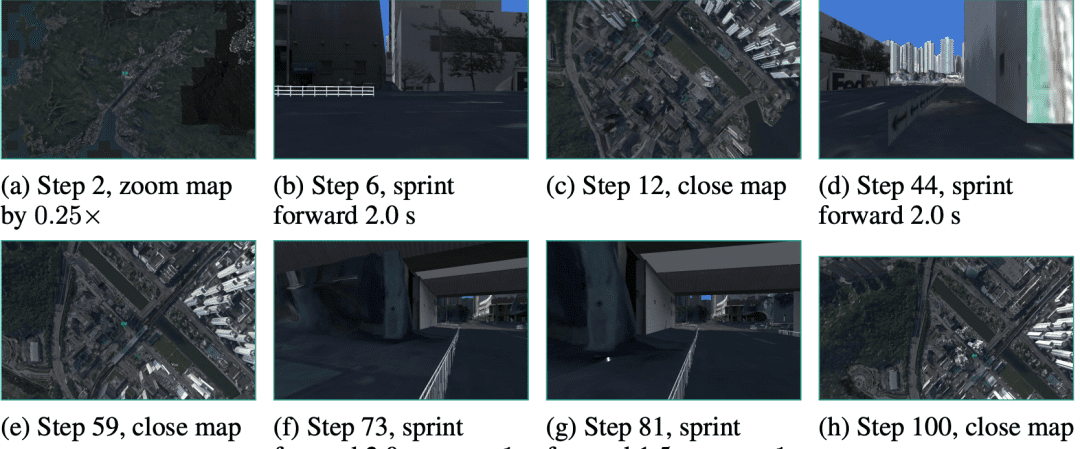
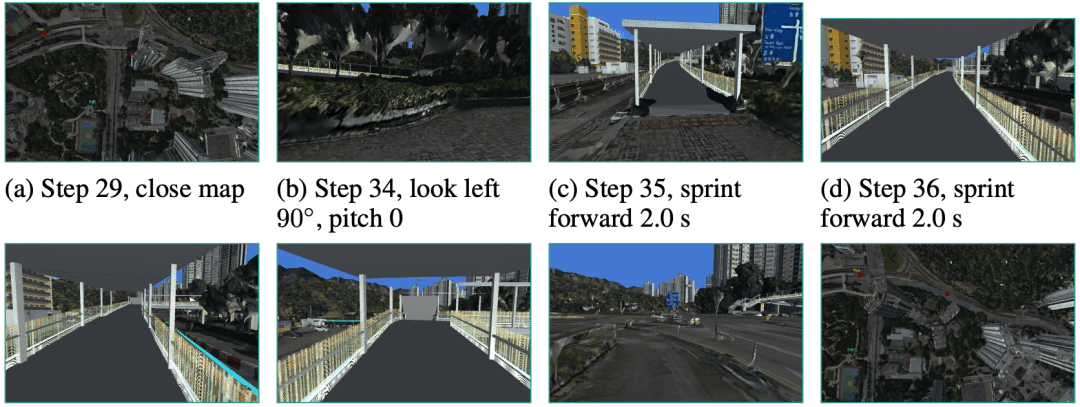
轨迹分析揭示了失败的深层机制。多数模型并非一开始就走错,而是在关键路口产生微小偏差后未能纠正。例如一段GPT-5.5的轨迹显示,它成功绕过绿篱障碍,找到正式坡道并穿过复杂天桥,显示出对局部道路结构的理解。但在另一段任务中,模型在穿过马路后遇到中央隔离带,却反复尝试向前冲撞,直至100步上限仍未重新规划路线。
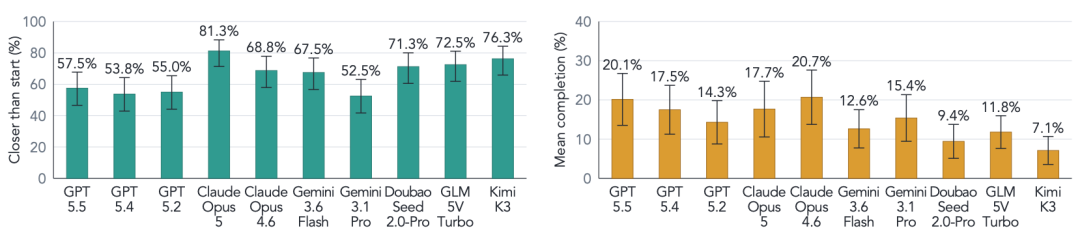
统计数据显示,长程任务结束时,52.5%–81.3%的轨迹比起点更接近目标,34.6%的轨迹缩短了至少20%的距离。然而,这些“部分成功”并未转化为完整到达——任务结束时的平均剩余距离仍为初始距离的98.9%。这表明模型具备一定的方向感,但缺乏维持长期目标导向行为的能力,一旦偏离主路径,便难以回归。
动态调整:看见变化,却不动如山
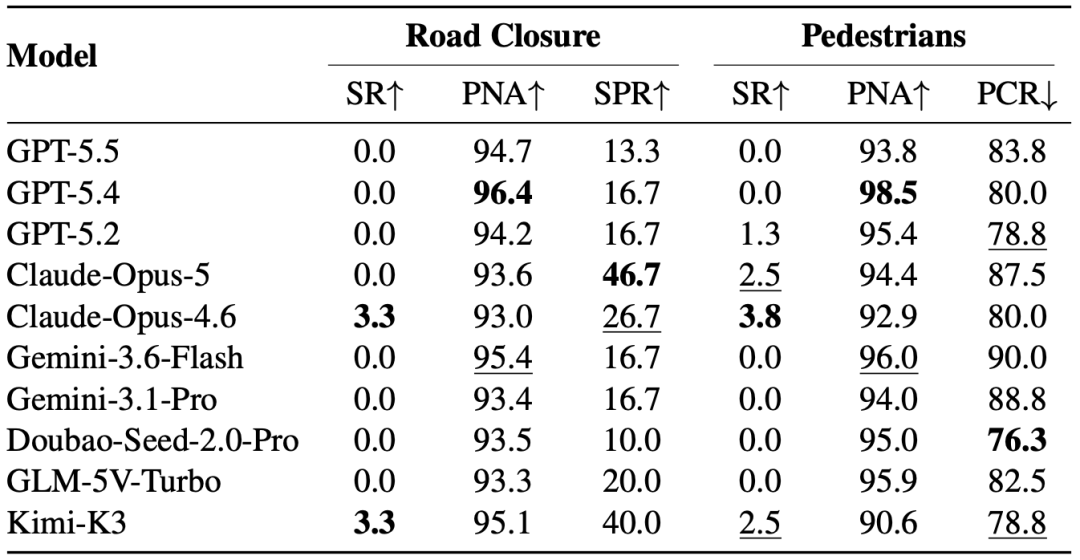
真实城市充满不确定性。UrbanGround进一步测试了模型在动态环境中的适应能力。实验分为两类:一是中途封路,二是引入移动行人。
结果显示,模型在“遵守规则”方面存在严重脱节。尽管路网遵循率高达90%以上(即大部分时间走在合法路径上),但封路遵守率仅为10.0%–46.7%。这意味着,当研究人员在模型行进途中关闭某段人行道时,多数模型仍会试图穿越封闭区域。同样,在行人移动任务中,碰撞率高达76.3%–90.0%,说明模型虽能感知行人存在,却无法有效避让。
有趣的是,环境光照变化(如晴天转夜晚)对短程导航影响甚微。GPT-5.5在三种天气下的成功率稳定在75%左右,排除了“天黑看不清”作为长程失败主因的可能性。真正的瓶颈在于:模型无法将环境变化转化为行为调整的触发信号。它可能“看到”封路标识或迎面而来的行人,但这一感知并未激活重新规划或避障的决策模块。
从“问答正确”到“行动连贯”:具身智能的新挑战
UrbanGround 的核心贡献在于,它将城市智能的评测从“静态问答”推进到“动态行走”。过去的研究往往满足于模型在单张图像上回答“这是哪里”或“往哪走”,但真实导航是一个跨时间、跨空间、需持续整合多源信息的过程。模型必须在每一步都回答:“我现在在哪?目标在哪?刚才的判断还成立吗?环境是否变了?我该继续还是转向?”
当前大模型的架构——尤其是基于Transformer的序列建模方式——在处理这类长期依赖任务时存在天然劣势。注意力机制虽能捕捉局部上下文,但难以维持跨越数百步的动作-感知一致性。此外,训练数据多来自互联网图文对,缺乏真实的连续行动轨迹,导致模型缺乏“行动后果”的内在模拟能力。
UrbanGround 的开源(包括代码、数据集、App及HuggingFace模型卡)为社区提供了一个标准化测试床。未来研究可在此基础上探索:如何将地图先验知识注入模型?是否需要专门的空间记忆模块?强化学习能否帮助模型学会“试错-修正”循环?这些问题的答案,或将决定AI能否真正走出实验室,走进我们的街道。
总之,“走两步就忘了路”不仅是导航失败的现象描述,更是对当前AI认知架构的一次深刻拷问。UrbanGround 证明,真正的城市智能,不在于认出多少地标,而在于能否把每一步都连成通向目标的路。