VS Code 支持自定义 AI 模型接入:开发者如何自由配置任意大模型?
随着人工智能技术在软件开发领域的深度渗透,集成式 AI 编程助手已成为现代开发者的标配工具。Visual Studio Code(以下简称 VS Code)作为全球最受欢迎的代码编辑器之一,在其最新发布的 1.122.0 版本中引入了一项具有里程碑意义的功能更新:支持用户自带 API 密钥(Bring Your Own Key, BYOK)并自由接入任意兼容 OpenAI Chat Completions 协议的大语言模型。这一变革不仅打破了此前对 GitHub Copilot 内置模型的单一依赖,更赋予开发者前所未有的灵活性——无论是使用 DeepSeek、Claude、GLM 等第三方商业模型,还是部署在本地或企业内网的私有化大模型,均可无缝集成至 VS Code 的智能对话与辅助编码体系中。
三种模型接入路径:从开箱即用到完全自定义
VS Code 当前提供了三种不同层级的模型接入机制,以适配多样化的使用场景:
- 内置提供商模式:适用于 Azure OpenAI、Anthropic、Google Gemini、OpenAI 等已预集成的服务商。用户只需在设置界面输入对应平台的 API 密钥,即可立即启用官方模型,操作最为简便。
- 扩展插件模式:通过 Visual Studio Marketplace 安装特定 AI 工具包(如 Ollama、LM Studio 或 AI Toolkit),可直接调用本地运行的开源模型(例如 Llama 3、Qwen、Phi-3)。此类方案适合注重数据隐私或希望离线使用的开发者。
- 自定义端点模式(本次更新核心):这是最具扩展性的方案,允许用户指向任意符合 OpenAI API 规范的 HTTP 端点。只要目标模型支持
POST /v1/chat/completions接口(或 Responses/Messages 变体),无论其托管于公有云、私有服务器,甚至是经过代理中转的服务(如 thinkai.tv),均可被 VS Code 识别并调用。
对于追求技术自主性与成本优化的团队而言,自定义端点模式无疑是当前最值得关注的突破点。
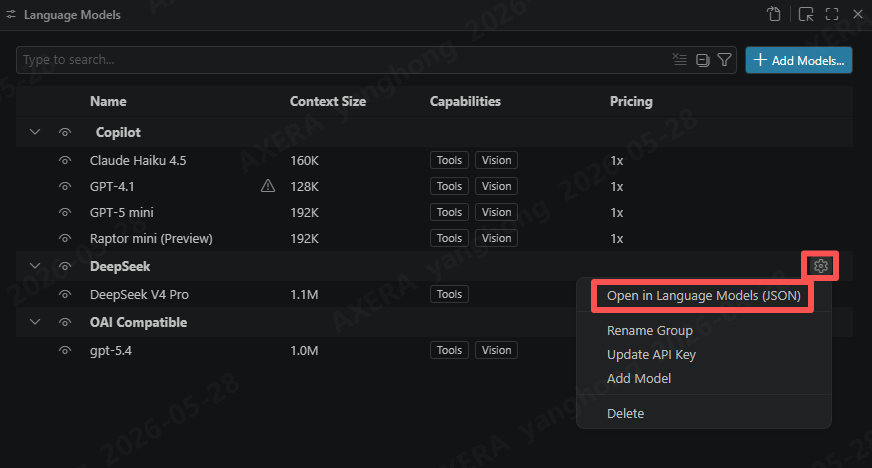
实战指南:手把手配置 DeepSeek 自定义模型
以下以国内知名大模型服务商 DeepSeek 为例,演示如何在 VS Code 中完成自定义模型的完整配置流程:
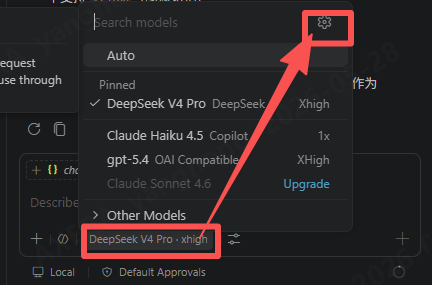
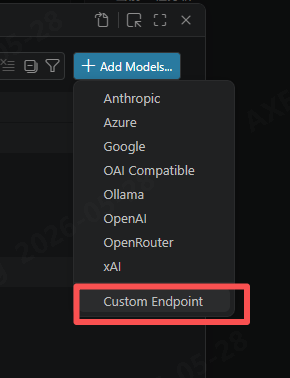
- 启动配置入口:打开 VS Code 内置的 Copilot 聊天面板,点击模型选择栏右侧的齿轮图标,依次选择「添加模型」→「自定义端点」。
- 填写基础信息:
- 分组名称(Group Name):建议使用有意义的标识,如
DeepSeek; - 显示名称(Display Name):如
DeepSeek V4 Pro; - API 密钥:粘贴从 DeepSeek 控制台获取的有效密钥;
- Base URL:必须为标准 OpenAI 兼容端点,此处应填
https://api.deepseek.com。
- 分组名称(Group Name):建议使用有意义的标识,如
- 选择 API 类型:绝大多数现代模型均采用
chat-completions协议,故首选此项。 - 编辑模型配置文件:系统将自动打开
chatLanguageModels.json文件,需在此补充详细参数。参考如下配置:
[
{
"name": "DeepSeek",
"vendor": "customendpoint",
"apiKey": "${input:chat.lm.secret.39d03ffb}",
"apiType": "chat-completions",
"models": [
{
"id": "deepseek-v4-pro",
"name": "DeepSeek V4 Pro",
"url": "https://api.deepseek.com",
"toolCalling": true,
"vision": false,
"thinking": true,
"maxInputTokens": 1024000,
"maxOutputTokens": 64000,
"supportsReasoningEffort": ["low", "max", "xhigh"]
}
],
"settings": {
"deepseek-v4-pro": {
"reasoningEffort": "xhigh"
}
}
}
]该配置明确启用了 思考能力(thinking) 和 工具调用(toolCalling),并设定了高达 102 万 token 的上下文窗口,充分释放 DeepSeek V4 Pro 的长文本处理优势。保存后重启 VS Code,新模型即会出现在模型选择器中。
动态更新与维护:无需重复配置
当需要更换 API 密钥、调整端点地址或升级模型版本时,无需删除重建。只需进入「管理大模型」界面,找到对应分组,点击其旁的齿轮图标即可在线修改所有字段。这种非破坏性更新机制极大提升了运维效率,尤其适用于频繁切换测试环境或多团队协作场景。
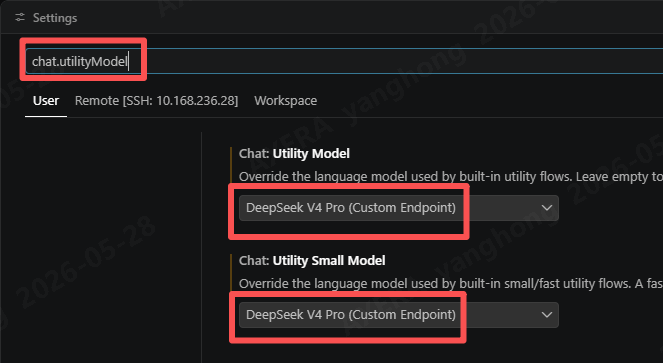
进阶应用:让自定义模型接管后台智能任务
除主聊天功能外,VS Code 还在后台运行两类轻量级 AI 任务:
- 通用辅助任务:如生成对话标题、编写 Git 提交摘要、解释错误信息、搜索设置项等,由
chat.utilityModel控制; - 快速响应任务:包括建议分支名、重命名变量、检测用户意图等低延迟操作,由
chat.utilitySmallModel管理。
默认情况下,这两项均使用 Copilot 内置的小模型。但开发者可将其替换为自定义模型——例如指定一个低成本、高吞吐的专用小模型(如 DeepSeek-Coder-1.3B)来处理 utilitySmallModel 任务,从而在保证响应速度的同时显著降低 API 成本。
实践建议:对于高频但简单的任务,优先选择参数量较小、推理速度快的模型;而对于需要深度理解上下文的复杂任务(如代码审查),则应分配具备强推理能力的大模型。
配置详解:关键参数深度解读
chatLanguageModels.json 的结构分为 提供商级 与 模型级 两层,以下对核心字段进行技术剖析:
提供商级属性
vendor: 必须设为customendpoint以启用自定义逻辑;name: UI 中显示的分组标签,影响用户体验一致性;models: 包含一个或多个具体模型定义的数组。
模型级属性
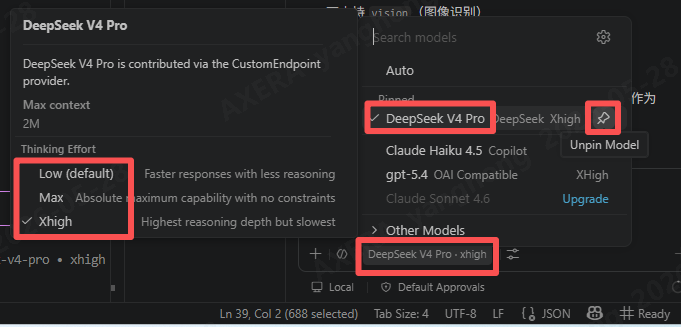
id: 实际发送给 API 的模型标识符,需与服务商文档一致(如gpt-4o、claude-3-5-sonnet);toolCalling: 启用后,VS Code 可向模型请求执行文件读写、终端命令等操作,是实现“AI Agent”能力的关键;maxInputTokens: 不仅决定最大输入长度,也间接定义了可用上下文窗口。若设为 1024000,则意味着可一次性处理超长代码库;supportsReasoningEffort: 声明模型支持的推理强度等级。配置后,UI 将出现下拉菜单供用户动态调节思考深度(如从low切换至xhigh),适用于调试复杂逻辑时的性能权衡;requestHeaders: 允许附加自定义 HTTP 头,可用于传递认证令牌、租户 ID 或 A/B 测试标识,增强企业级集成能力。
值得注意的是,部分字段存在智能推断机制。例如未显式设置 streaming 时,默认启用流式响应以提升交互流畅度;而 reasoningEffortFormat 若缺失,系统会根据 URL 自动判断应使用顶层参数还是嵌套对象格式。
安全与隐私考量
尽管 BYOK 架构极大提升了灵活性,但也带来新的安全挑战。VS Code 采用加密存储机制保护 API 密钥(通过操作系统级凭据管理器),但仍建议开发者:
- 避免在共享设备上长期保存敏感密钥;
- 对于企业环境,优先使用短期有效的访问令牌(Token)而非永久密钥;
- 启用
zeroDataRetentionEnabled: true可防止历史响应 ID 被回传,进一步减少数据泄露风险。
未来展望:开放生态驱动开发范式演进
此次更新标志着 VS Code 正从“封闭式 AI 助手”向“开放式智能平台”转型。随着更多模型厂商提供 OpenAI 兼容接口,以及本地推理框架(如 llama.cpp、vLLM)的持续优化,开发者将能构建完全自主可控的 AI 开发流水线——从前端代码生成到后端测试自动化,全程由自选模型驱动。
可以预见,在不久的将来,VS Code 或将进一步支持多模型协同(如路由不同任务至最优模型)、上下文感知调度(根据项目类型自动切换模型)等高级特性,真正实现“每个开发者都拥有专属 AI 团队”的愿景。
综上所述,掌握自定义模型接入能力,不仅是应对当前 AI 工具碎片化现状的务实之举,更是迈向下一代智能开发基础设施的关键一步。建议广大开发者尽快升级至 VS Code 1.122.0+ 版本,探索属于自己的高效、安全、低成本的 AI 编程新范式。