Qwen3.8-Max实战:打造拍照讲题+错题诊断一体化AI作业辅导系统
在家庭教育场景中,作业辅导长期存在效率低、方法单一、难以精准定位知识盲区等痛点。传统搜题App仅提供答案,缺乏过程性引导;家长受限于时间与专业能力,难以系统化分析孩子的学习问题。随着多模态大模型能力的突破,尤其是具备图像理解、长上下文处理与结构化输出能力的模型出现,为构建真正智能化的作业辅导系统提供了技术可能。本文以Qwen3.8-Max为核心,详细阐述一个集“拍照讲题”与“错题本诊断”于一体的AI作业辅导助手的设计与实现路径。
技术架构与核心能力设计
该系统的成功依赖于对大模型能力边界的精准把握与合理的技术栈选择。整体架构遵循轻量化、可复现原则,避免过度工程化。
后端采用FastAPI框架,其异步特性和自动文档生成功能极大提升了开发效率。前端使用原生HTML配合Tailwind CSS,无需复杂构建流程,确保快速迭代与部署。模型接入层面,系统利用Qwen3.8-Max的两大核心优势:一是原生支持多模态输入,可直接处理包含题干的图片;二是高达百万token的上下文窗口,使得一次性分析整周错题成为可能。
值得注意的是,模型调用并非简单地发送请求。针对阿里云百炼平台的Lite Token Plan套餐,必须使用专属的Base URL(https://token-plan.cn-beijing.maas.aliyuncs.com/compatible-mode/v1)并通过OpenAI兼容模式进行调用。这一细节是项目能否跑通的关键,许多开发者在此处因沿用标准DashScope SDK地址而遭遇InvalidApiKey错误。
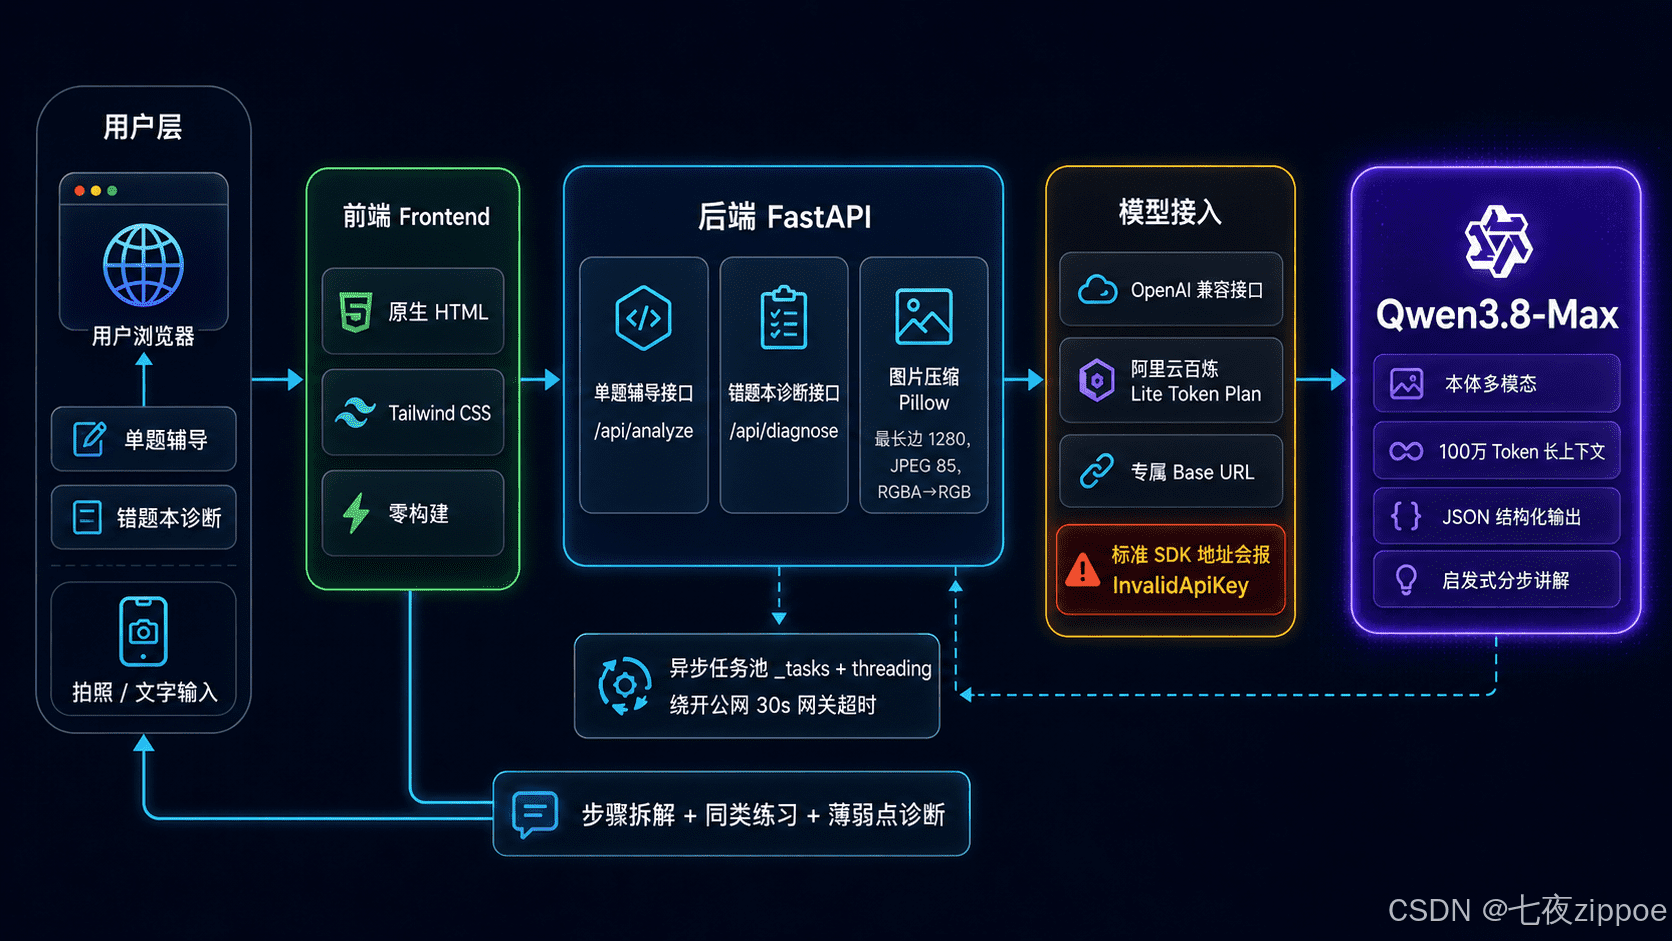
图片预处理环节同样重要。系统使用Pillow库对上传图片进行标准化处理:将最长边压缩至1280像素,转换为RGB色彩模式,并以85%的JPEG质量保存。这一步骤在保证OCR识别准确率的同时,有效控制了token消耗和网络传输延迟。
核心Prompt工程:定义AI的“教学人格”
系统的智能程度很大程度上取决于Prompt的设计。我们为两种核心场景分别设计了高度结构化的System Prompt,本质上是在为AI定义两种不同的“角色”和“行为准则”。
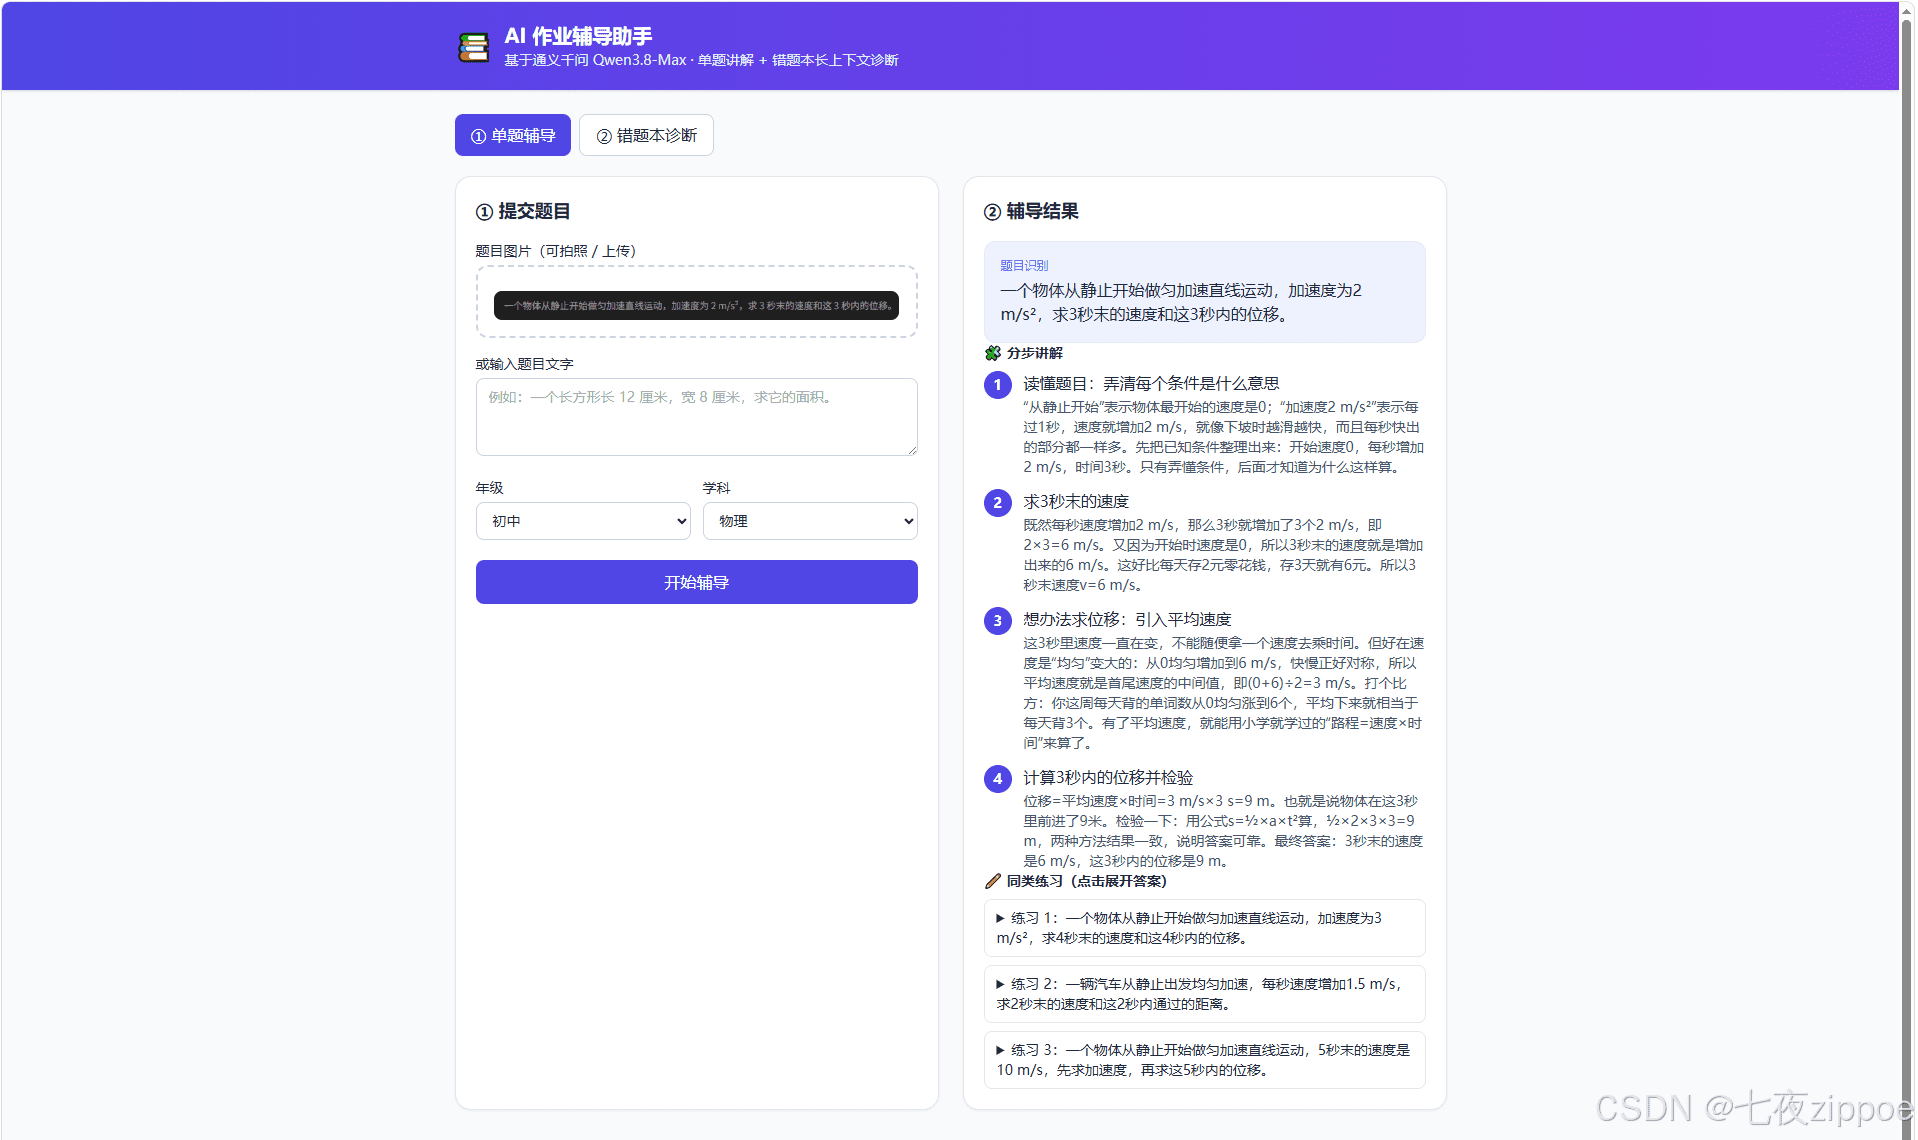
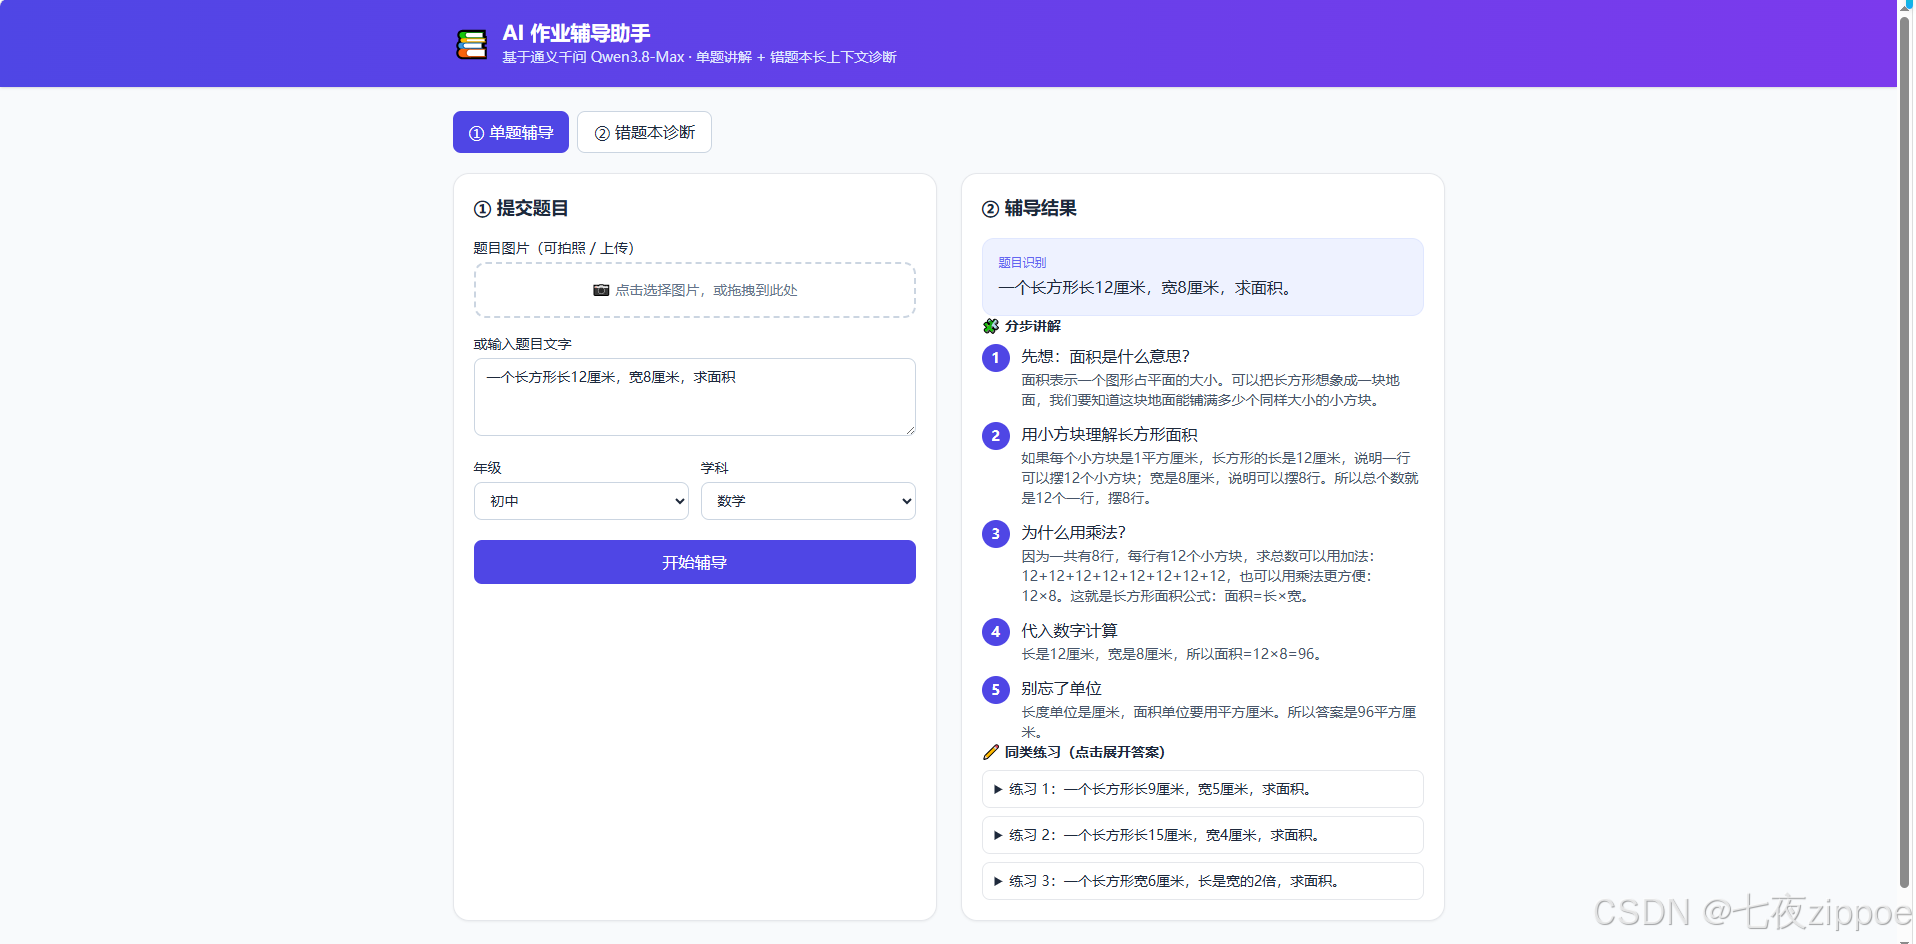
在单题辅导模式下,AI被塑造成一位耐心且专业的启发式教师。其Prompt明确要求:语言必须符合指定年级学生的认知水平;解题过程需分步骤呈现,且每一步都必须解释“为什么这么做”;禁止使用超出学段的术语或跳过关键推理步骤;最后必须生成三道同类型练习题以巩固学习效果。最关键的是,所有输出必须严格遵循预定义的JSON Schema,确保前端能稳定解析。
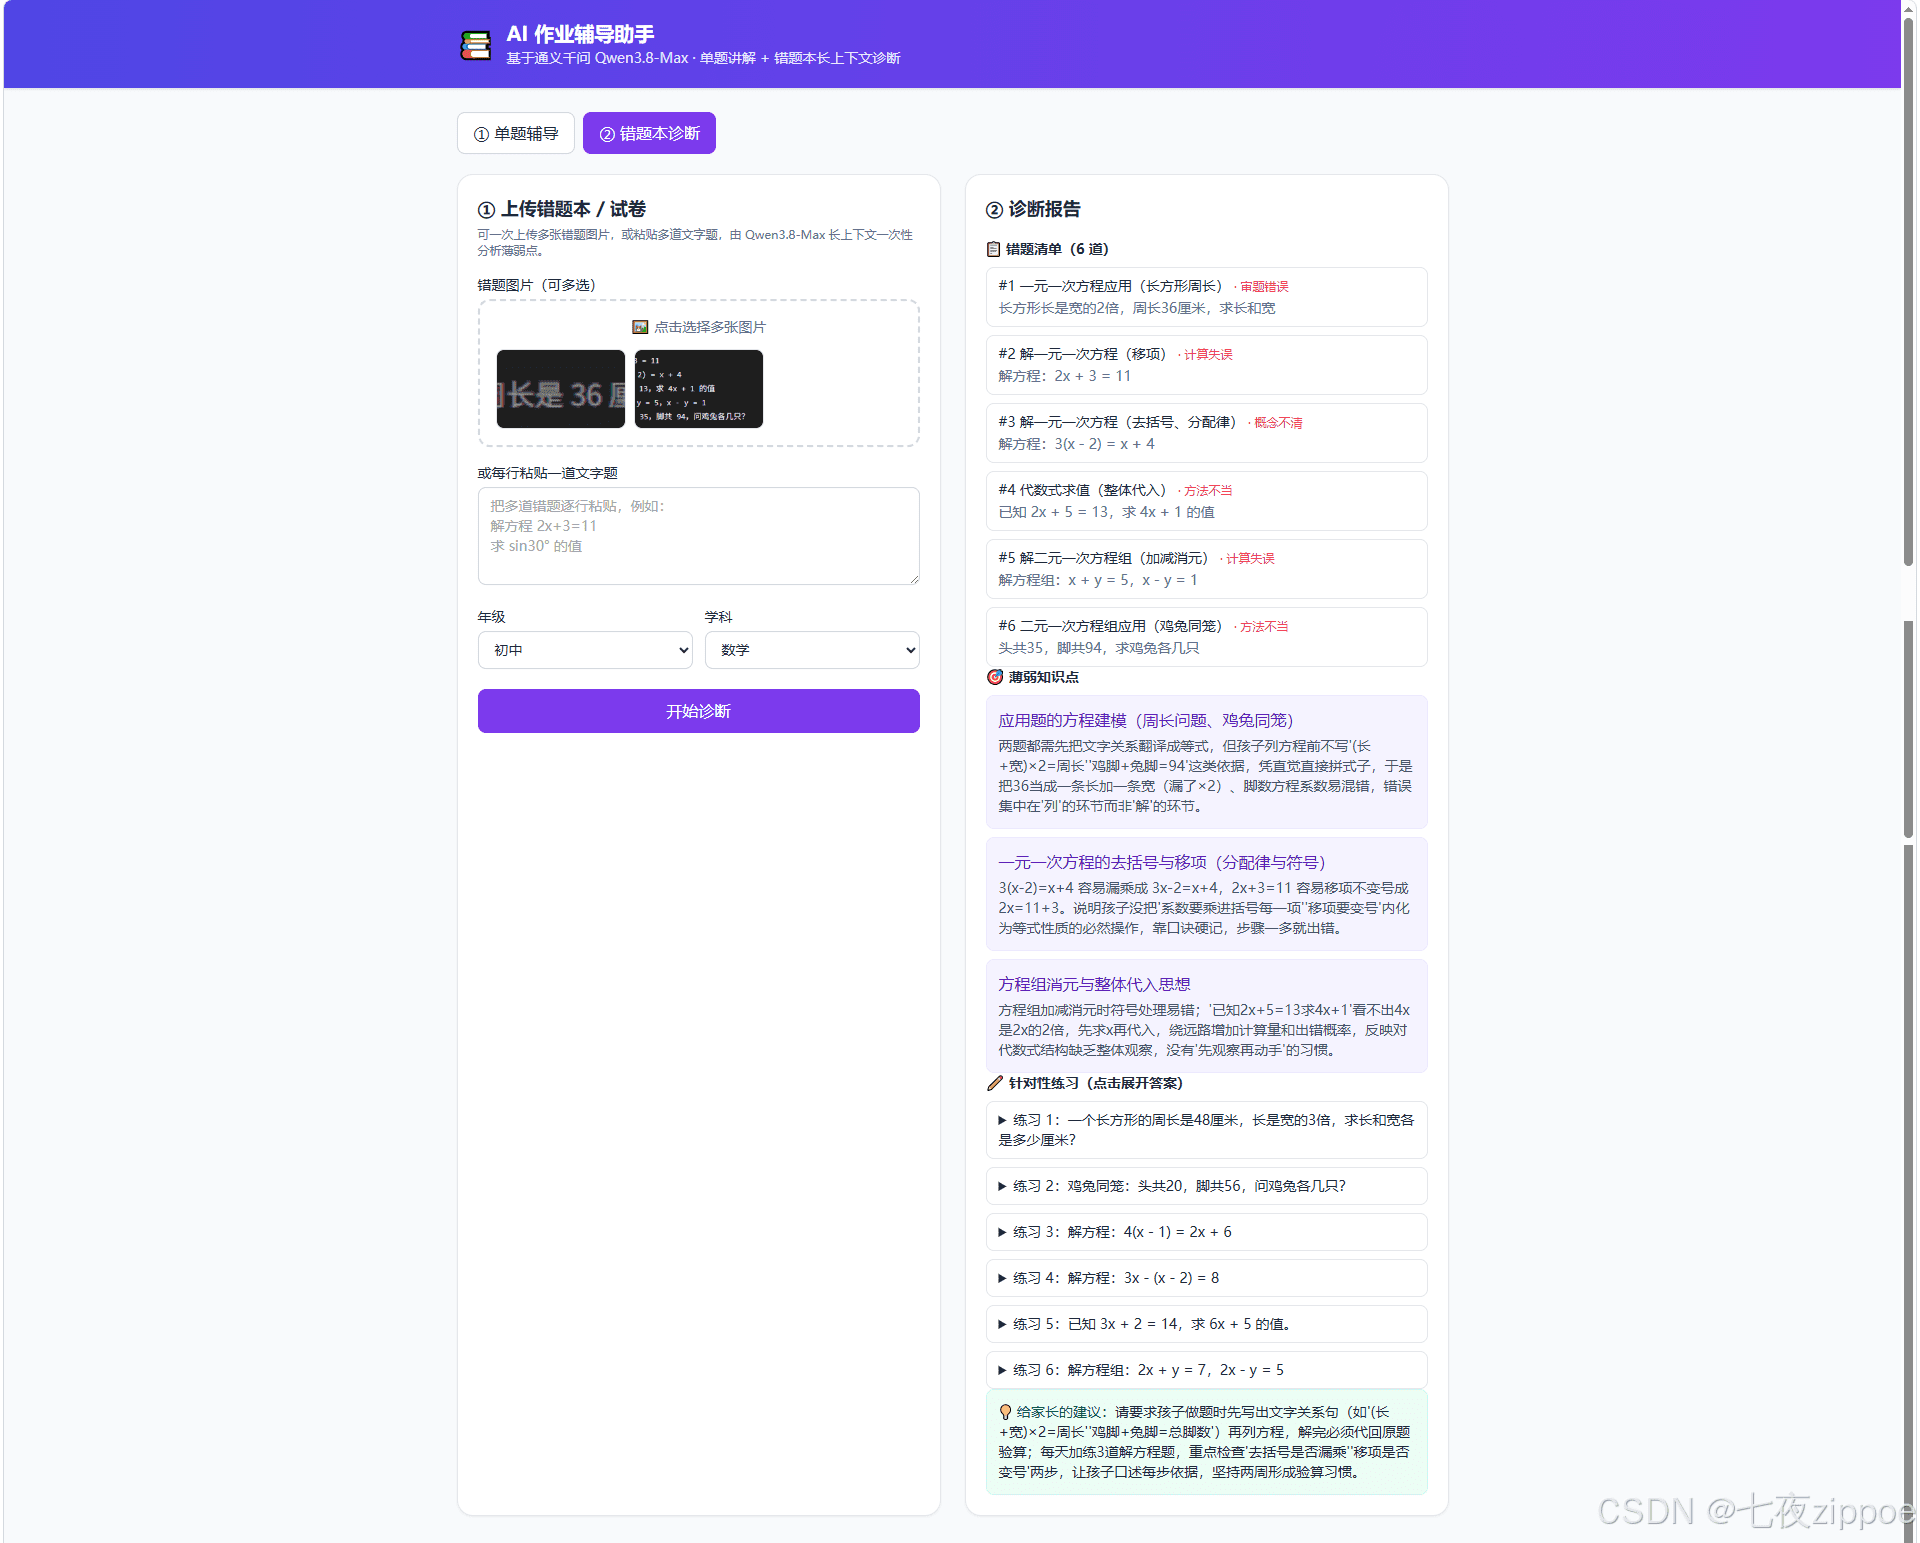
而在错题本诊断模式下,AI的角色转变为资深学情分析师。此Prompt充分利用了Qwen3.8-Max的长上下文优势,要求模型一次性“通读”用户提交的所有错题(无论是多张图片还是多段文字)。任务分解为四个层次:首先,逐题识别学科、知识点和错误类型(如概念不清、计算失误等);其次,跨题目归纳出2-4个最突出的系统性薄弱点,并深入分析其反复出错的根本原因;再次,针对每个薄弱点生成两道巩固练习题;最后,向家长提供一条具体、可操作的辅导建议。这种从微观到宏观的分析链条,是小上下文模型无法实现的。
关键挑战与解决方案
在开发过程中,我们遇到了几个具有代表性的技术挑战,其解决方案对同类项目具有普适参考价值。
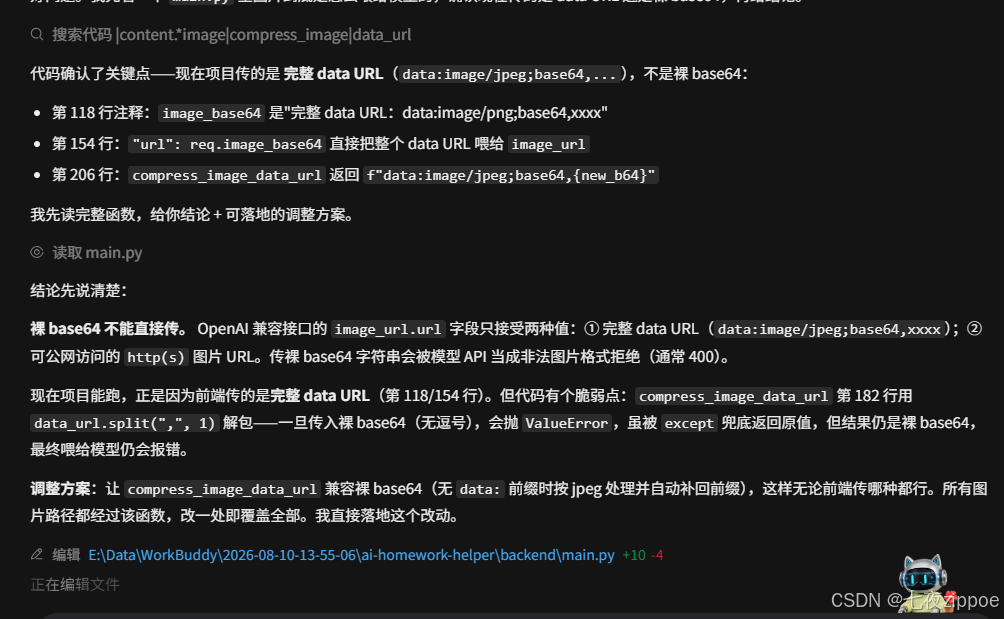
首先是多模态输入的格式规范问题。初期尝试将图片的base64编码直接作为消息内容发送,但模型无法正确解析。经过调试发现,必须将base64字符串包装成完整的Data URL格式(data:image/png;base64,...),模型才能将其识别为图像输入。这个看似微小的格式差异,却是多模态功能能否启用的分水岭。
其次是模型输出的稳定性问题。尽管Prompt中明确要求“只返回JSON”,但大模型仍有一定概率在JSON外包裹Markdown代码块(如json ... )或添加额外说明文字。为应对这一情况,后端设计了双重保障机制:首先通过正则表达式提取代码块内的纯JSON内容;若提取失败,则将原始响应文本作为兜底方案返回给前端,确保用户界面不会因解析错误而白屏。同时,使用Pydantic模型对JSON结构进行强校验,进一步提升了数据可靠性。
最棘手的问题来自云服务的接入配置。如前所述,Lite Token Plan的API Key与标准DashScope服务不兼容,必须配合专属Base URL使用。官方文档对此说明不够清晰,导致初期调试耗费了大量时间。这一经验凸显了在使用特定云服务套餐时,仔细阅读其技术接入指南的重要性。
效能评估与价值验证
通过实际测试,该系统在多个维度上展现出显著优势。对于一道简单的文字题(如3+5=?),系统能在10-15秒内返回包含5步启发式讲解和3道同类练习题的完整辅导包,而传统家长讲解通常需要15-20分钟,且质量不稳定。
对于图片题目,虽然处理时间较长(约30秒至2分钟,主要耗时在图像上传和OCR识别),但其产出远超传统搜题App。后者仅提供最终答案,而本系统提供完整的、带原因说明的分步解析和巩固练习,真正实现了“授人以渔”。
错题本诊断功能的价值最为突出。家长手动分析一周错题通常需要30分钟以上,且难以发现系统性问题。而系统能在30秒至2分钟内,不仅指出“移项符号错误”这样的具体问题,更能分析出“对等式性质理解不深”这一根本原因,并据此生成针对性练习和家长指导建议。这种从现象到本质的洞察力,正是大模型长上下文能力带来的独特价值。
复现与部署实践指南
为了让其他开发者能够快速复现此项目,我们整理了一套清晰的部署流程。环境要求仅为Python 3.10+,支持主流操作系统。依赖安装通过标准的pip install -r requirements.txt命令完成。
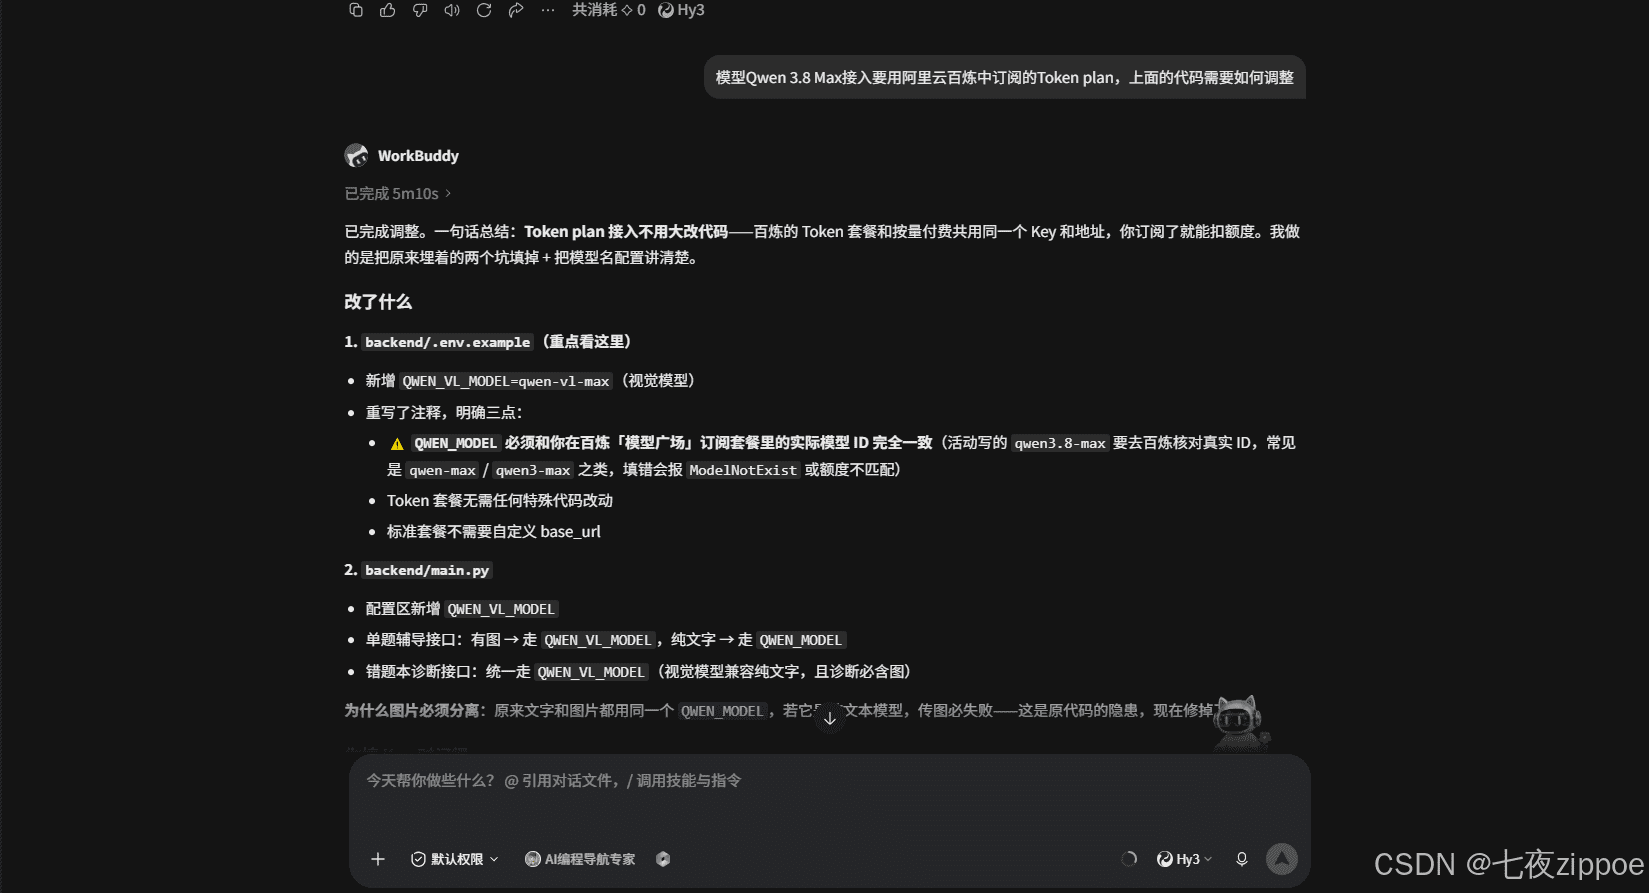
配置环节的核心在于.env文件的正确设置。除了填入API Key外,必须根据所购套餐类型正确配置DASHSCOPE_BASE_URL。对于按量付费用户,应使用标准DashScope地址;而对于Token Plan用户,则必须使用前述的专属URL。此外,模型名称QWEN_MODEL和QWEN_VL_MODEL均应设置为qwen3.8-max,因为该版本已原生集成多模态能力,无需单独调用VL专用模型。
服务启动后,系统通过内存字典和线程实现异步任务处理,以应对公网网关可能存在的30秒超时限制。前端页面会实时显示任务处理进度,用户需耐心等待30-120秒(取决于图片数量和复杂度)。这一设计平衡了用户体验与系统稳定性。
综上所述,该项目不仅是一个实用的家庭教育工具,更是一个展示大模型在垂直领域落地的典型案例。它证明了通过精心的Prompt设计、合理的架构选择以及对云服务细节的深入理解,即使是个人开发者也能构建出具备专业级能力的AI应用。未来,此类系统可进一步结合学生的历史学习数据,实现更个性化的长期学习路径规划,真正迈向智能化教育的新阶段。