Foundation Model时代机器人操作的系统重构:规划与动作建模的新坐标系
近年来,人工智能尤其是基础模型(Foundation Model)的突破,正以前所未有的速度重塑机器人操作的研究范式。从大型语言模型(LLM)驱动的任务规划,到视觉-语言-动作(VLA)联合建模,再到基于扩散机制(Diffusion Policy)或流匹配(Flow Matching)的动作生成,各类新方法层出不穷。然而,这种繁荣背后隐藏着一个结构性问题:许多研究者将不同层级、不同目标的技术路径置于同一比较维度,导致概念混淆与系统理解偏差。

近期被IEEE Transactions on Robotics(T-RO)接收的综述论文《Embodied Robot Manipulation in the Era of Foundation Models: Planning and Learning Perspectives》正是对这一问题的系统性回应。该工作由西安交通大学、香港科技大学(广州)、北京大学等多家机构联合完成,提出了一套清晰的分析坐标系,将纷繁复杂的机器人操作方法重新归位到其应处的系统层级中。
高层规划与低层动作:机器人智能的双主线
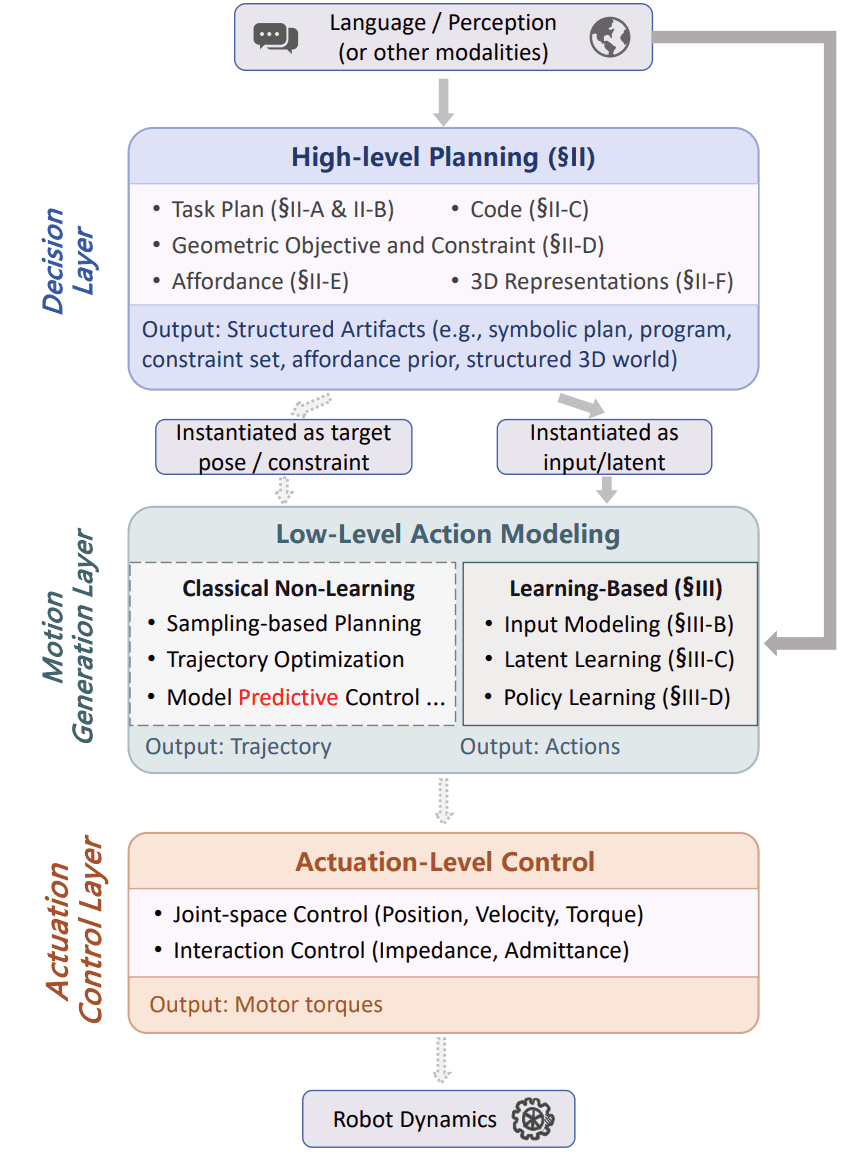
机器人要完成一个操作任务,本质上需要解决两个核心问题:“做什么” 和 “怎么做”。前者属于高层规划(High-Level Planning),后者则属于低层动作建模(Low-Level Action Modeling)。两者之间还存在执行层面的底层控制(Actuation-Level Control),负责将抽象动作转化为电机指令。这一三分法并非简单划分,而是提供了一个理解当前技术演进的关键透镜。
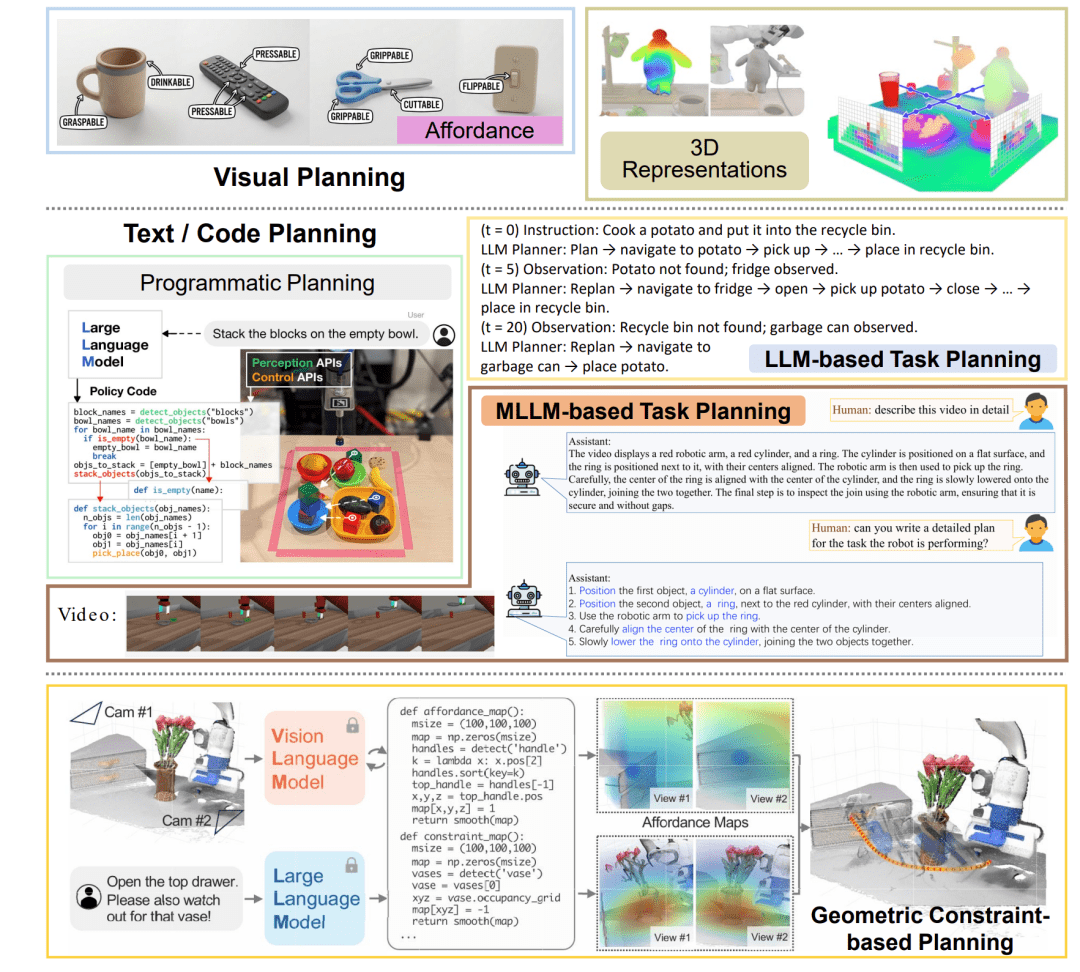
在高层规划层面,传统方法依赖预定义的任务图或符号逻辑,而Foundation Model的引入带来了质变。LLM具备强大的开放世界知识和语义推理能力,能够理解如“把咖啡杯放进橱柜”这样的自然语言指令,并将其分解为子任务序列。然而,语言上的合理性并不等同于物理上的可行性。一个典型的挑战是:LLM可能正确分解任务,却无法判断机械臂是否能触及目标、物体姿态是否允许抓取,或路径是否存在碰撞。
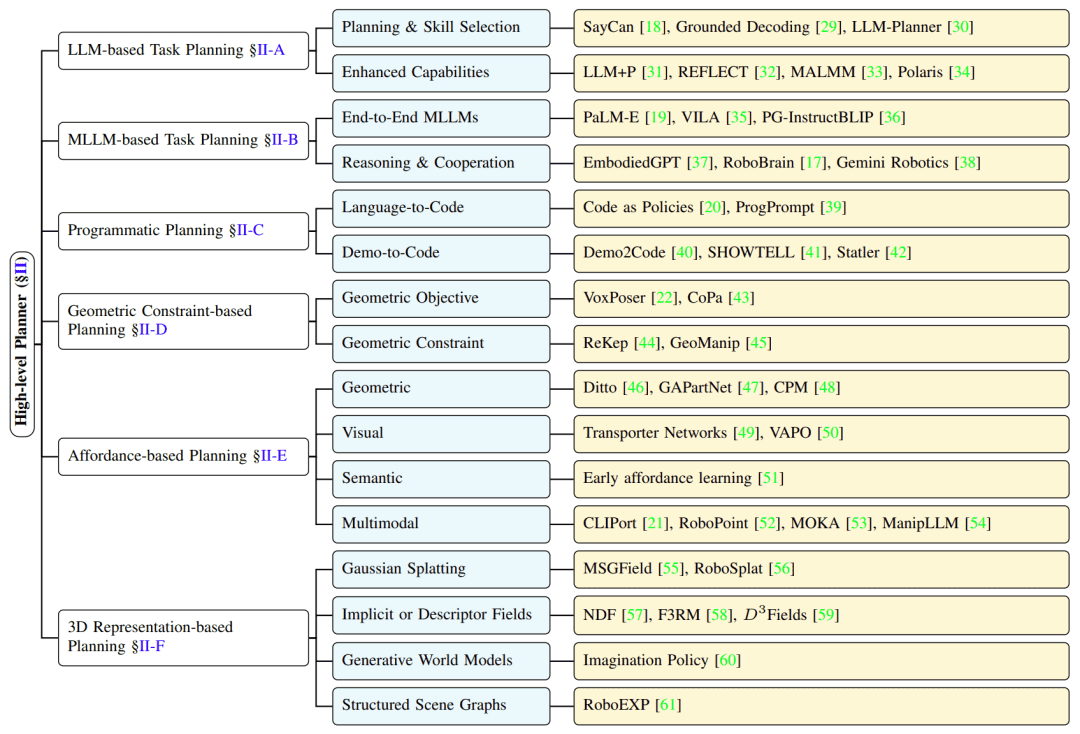
为弥合这一鸿沟,研究者开始探索规划工件(planning artifacts) 的生成机制。例如,VoxPoser将语言指令转化为三维空间中的价值图(value map),指导机械臂在可行区域移动;ReKep将操作任务表达为关键点之间的几何关系约束;GeoManip则进一步将语义意图映射为明确的几何约束条件。这些方法的共同点在于:不直接输出完整轨迹,而是生成可供下游运动规划器使用的结构化中间表示。这标志着高层规划的角色正在从“决策者”转变为“接口设计者”——其核心任务是将语义理解转化为物理可执行的形式。
与此同时,对环境的理解也从“识别物体”深化为“理解可操作性”。传统计算机视觉关注分类与检测,而机器人更需要知道“哪里可以抓”“门把手如何旋转”“哪些表面可接触”。这一需求催生了Affordance建模、Gaussian Splatting、Neural Descriptor Field等新型3D表示方法。它们将视觉感知转化为动作相关的表征(action-relevant representation),使机器人不仅能“看见”,更能“理解如何作用于”环境。
低层动作建模:输入、潜在空间与策略生成的三层解耦
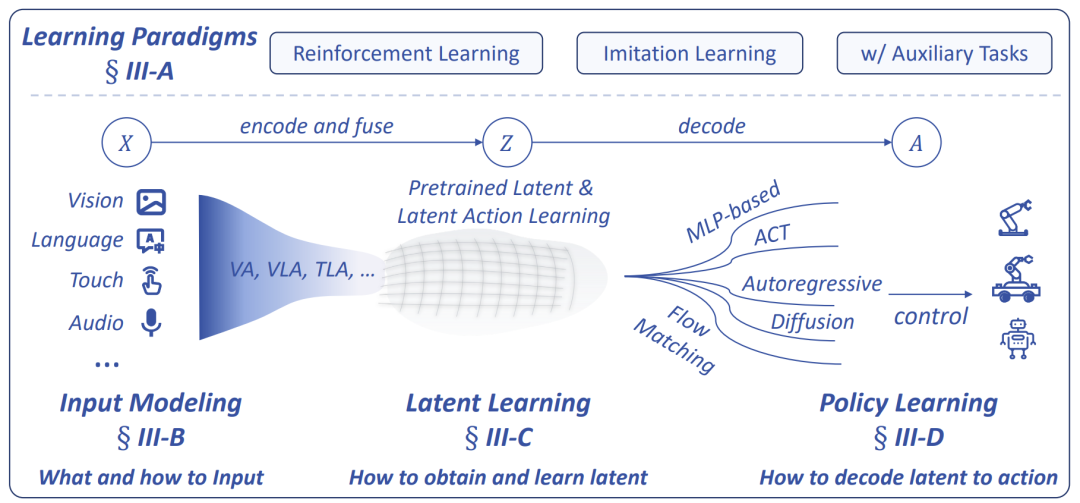
如果说高层规划解决“想什么”,那么低层动作建模则聚焦“怎么动”。过去十年,数据驱动的方法逐渐取代传统的采样规划与轨迹优化,成为主流。但即便在学习范式内部,也存在多个正交维度,需分别审视。
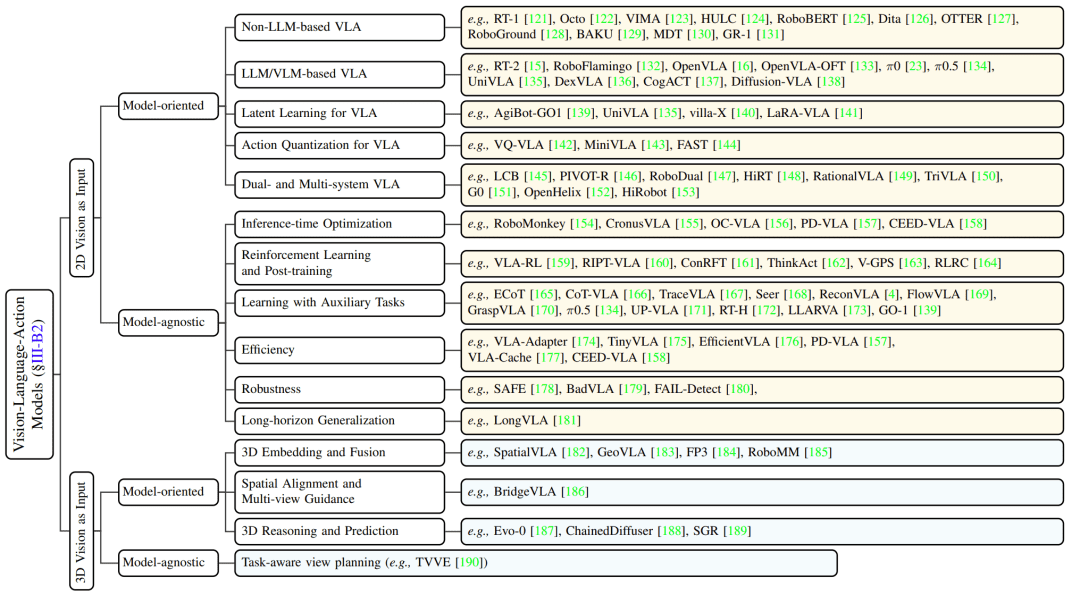
首先是输入建模(Input Modeling)。早期视觉策略仅使用RGB图像和机器人状态,但二维视觉缺乏深度信息,难以支撑精确操作。因此,点云、深度图、神经辐射场(NeRF)等3D表示被广泛引入。同时,自然语言作为任务条件,使策略具备开放词汇泛化能力。VLA架构的核心贡献即在于此:它统一了视觉观测、语言指令与本体状态,构建了一个多模态输入空间。值得注意的是,VLA并非一种特定模型,而是一种输入组织范式——它可以与Transformer、扩散模型或流匹配结合使用。
随着任务复杂度提升,仅靠视觉和语言已显不足。触觉传感器可检测滑动与接触力,麦克风可捕捉操作声音,惯性测量单元(IMU)可反馈动态扰动。这些异构信号正逐步融入动作模型,推动输入建模从“看什么”转向“利用哪些物理线索理解世界”。
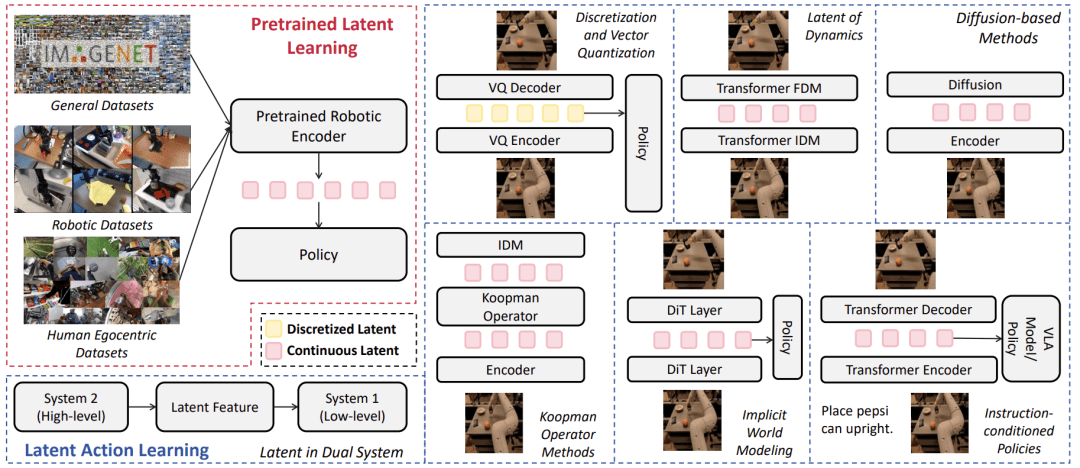
其次是潜在学习(Latent Learning)。高维输入直接映射到连续动作空间存在优化困难,因此研究者引入中间潜在表示以压缩信息。一类方法利用大规模预训练(如人类视频、通用图像)学习通用视觉特征;另一类则聚焦动作本身的潜在结构,如将复杂轨迹编码为离散token(类似语言模型中的词元)或连续latent vector。World Model进一步将潜在空间与环境动态预测结合,实现对未来状态的隐式建模。这些工作共同指向一个目标:建立感知与动作之间的紧凑、可泛化的接口。
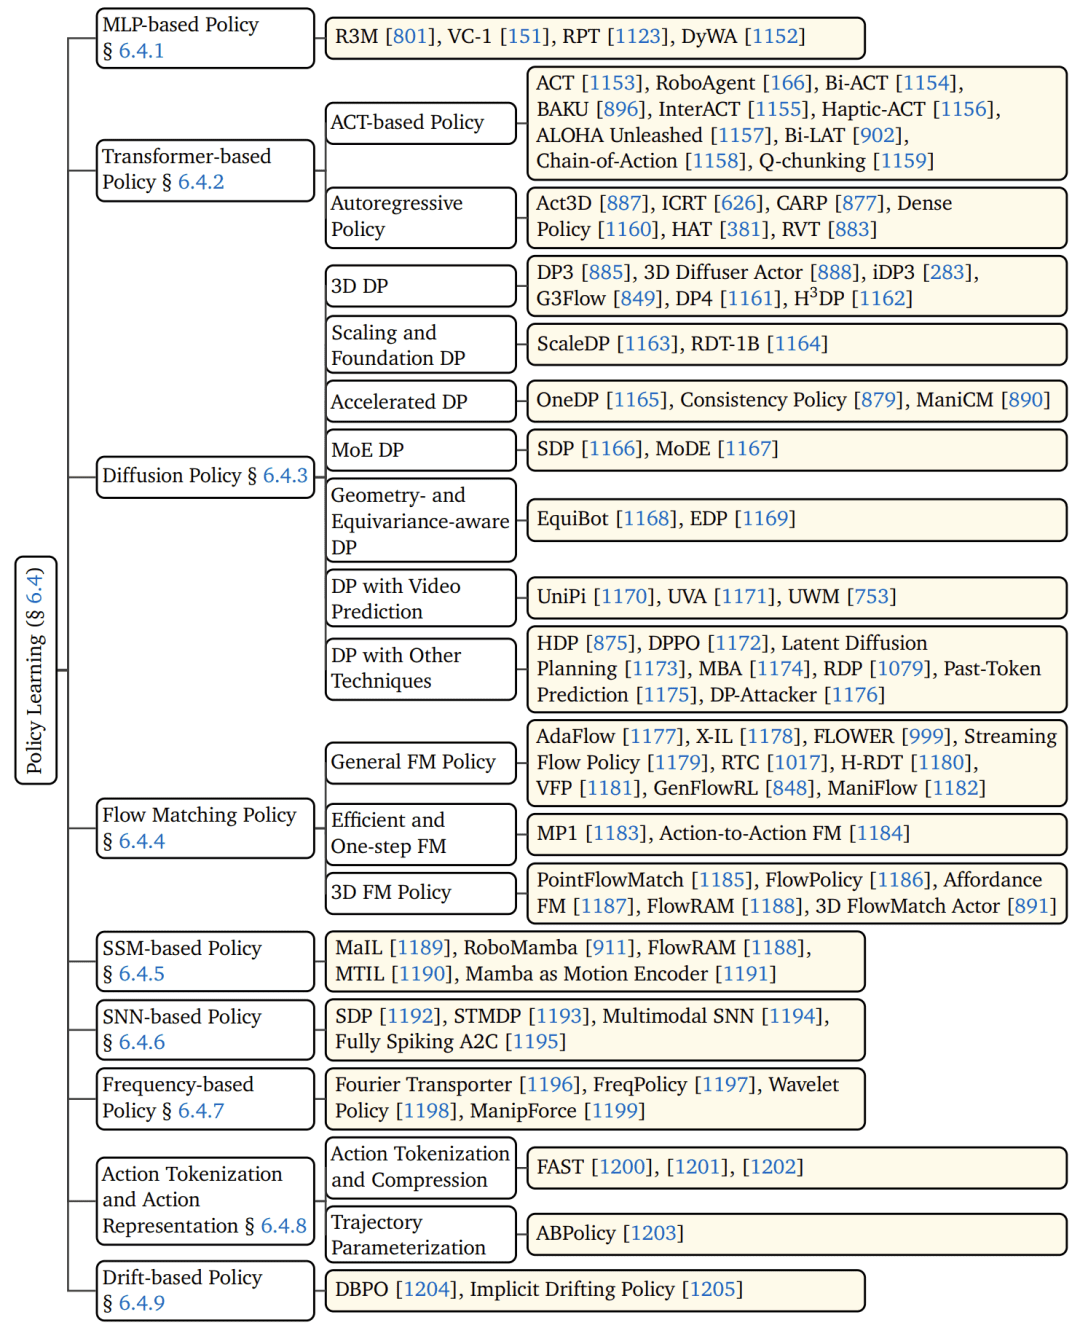
最后是策略学习(Policy Learning),即如何生成最终动作。早期多层感知机(MLP)适用于简单任务,但难以处理长时序依赖。Transformer凭借其自注意力机制,在序列建模上表现优异。而Diffusion Policy通过反向扩散过程建模多峰动作分布,特别适合存在多种可行解的操作场景(如不同抓取姿态)。近期兴起的Flow Matching则以更高效的常微分方程(ODE)求解替代扩散过程,在保持生成质量的同时显著降低计算开销。需要强调的是,Diffusion或Flow Matching属于动作生成机制,而非输入或学习范式的替代。
在此基础上,学习策略(Learning Strategy) 构成另一独立维度。模仿学习(Imitation Learning)利用专家示范数据进行监督训练;强化学习(Reinforcement Learning)通过试错优化长期回报;辅助任务学习(Auxiliary-task Learning)则引入重建、对比等目标提升表征质量。这些策略决定了模型“如何学会”行为,与“用什么生成动作”并无必然绑定。
通用机器人脑的四大缺口
尽管技术进展迅速,距离真正通用的机器人智能仍有显著差距。综述指出四个关键缺口:
第一,外推能力不足。当前模型在训练分布内的插值任务上表现良好,但在面对全新任务结构、未知物体类别或异构机器人平台时,泛化能力急剧下降。真正的通用性要求系统具备跨域迁移、持续学习与经验积累的能力。
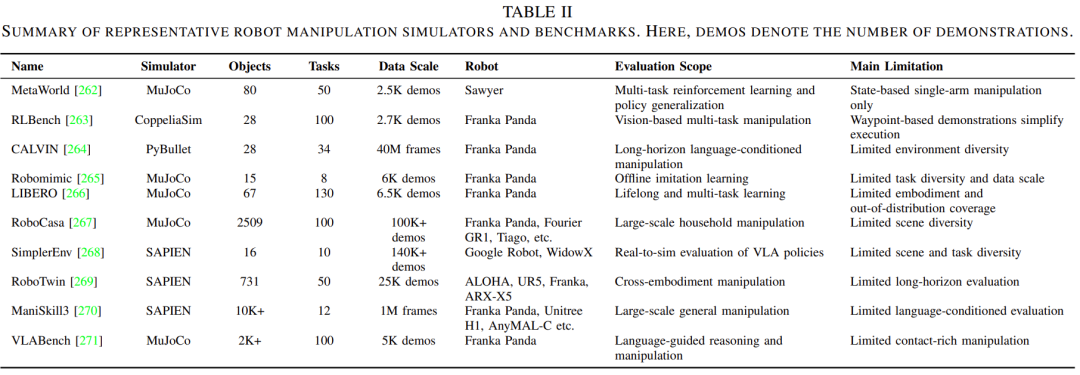
第二,数据与评测体系缺失。真实机器人数据采集成本高昂,导致多数研究依赖仿真。虽然CALVIN、LIBERO、SimplerEnv等基准平台分别覆盖长时序任务、多任务泛化与sim2real迁移,但缺乏统一、可复现且涵盖安全、鲁棒性等维度的综合评测标准。
第三,物理感知薄弱。人类操作高度依赖触觉、力觉与听觉反馈,尤其在处理柔性物体(如布料、线缆)或非刚性材料(如流体、颗粒)时。仅靠视觉增强无法解决接触力学、材料形变等核心问题。未来系统需融合多模态物理传感,并建模材料属性与动力学过程。
第四,安全与协作机制欠缺。在家庭、工厂等共享环境中,机器人不仅需成功完成任务,还需在失败时安全恢复、在不确定时主动降级,并满足运动学、动力学及接触力等多重约束。这意味着纯端到端学习模型难以独当一面,混合架构(Hybrid Architecture)将成为主流——学习模型提供适应性,而传统规划器、模型预测控制(MPC)等确保可靠性与安全性。
回归系统思维:超越模型竞赛
Foundation Model的浪潮不应沦为新一轮的“模型竞赛”。LLM、VLA、Diffusion等技术各有其适用层级与解决的问题。真正重要的不是哪个模型更大、哪个架构更新,而是如何将这些能力有机整合,形成一个对任务与世界有深刻理解、并能可靠转化为物理行为的智能系统。
这篇T-RO综述的价值,正在于引导研究者从“追逐热点模型”回归“构建完整系统”。通过明确高层规划与低层动作建模的边界与接口,我们得以看清:通用机器人并非一个单一的端到端网络,而是一个多层次、多模态、学习与规则协同的复杂智能体。未来的研究重点,应是如何设计有效的中间表示、构建可验证的评测体系、融合多源物理感知,并在开放世界中实现安全可靠的持续学习。
最终,机器人智能的衡量标准,不应是参数量或FLOPs,而是其在真实物理世界中解决问题的能力——这需要整个社区从系统工程的角度重新思考技术路线的选择与组合。