视觉语言模型真能指挥身体行动吗?HumanCLAW揭示行动智能的三大断层
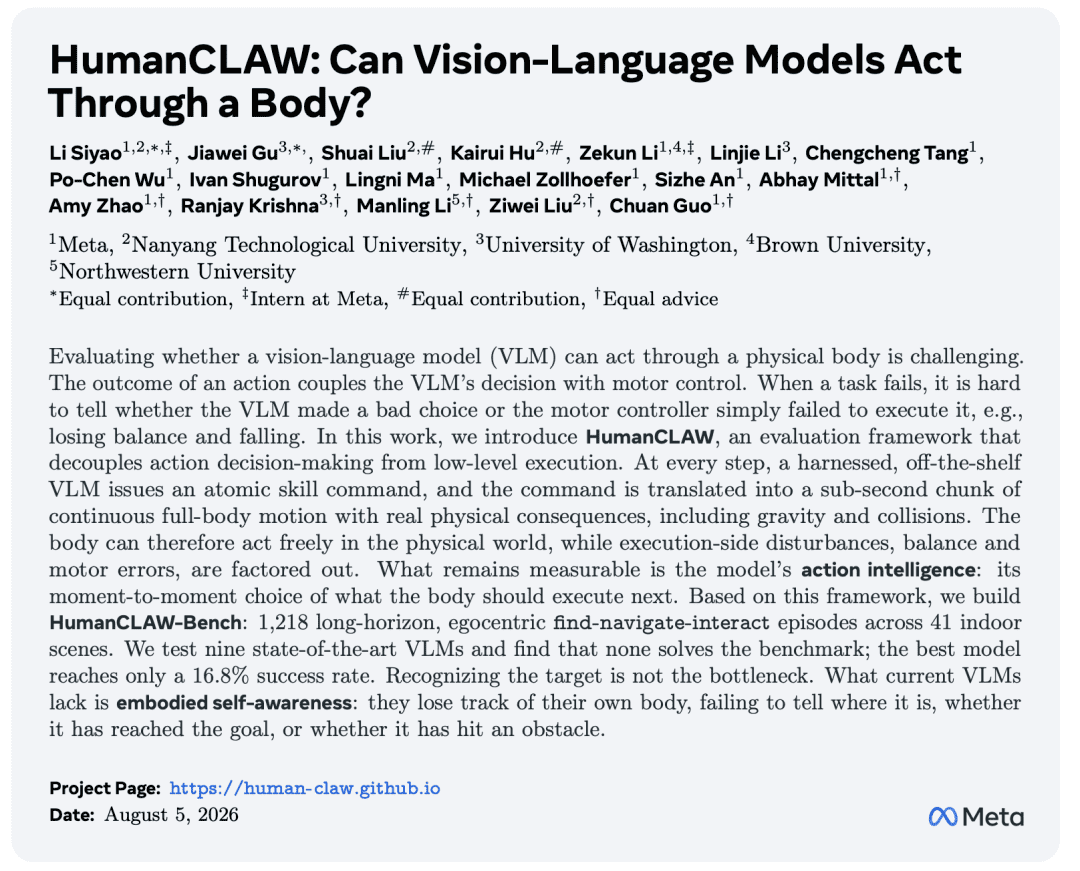
近年来,人工智能领域的一个核心命题正在发生微妙而深刻的转变:从“理解世界”走向“通过身体改变世界”。过去,基础模型主要扮演观察者角色,擅长描述图像内容、回答关于环境的问题;如今,随着机器人技术的发展,研究者开始尝试让这些模型直接参与身体控制,决定下一步该做什么动作。然而,这种跨越并非水到渠成。最新研究《HumanCLAW: Can Vision-Language Models Act Through a Body?》以严谨的实验设计揭示了一个令人警醒的事实——即便最前沿的视觉语言模型(VLM),在真实的身体行动任务中表现依然脆弱。
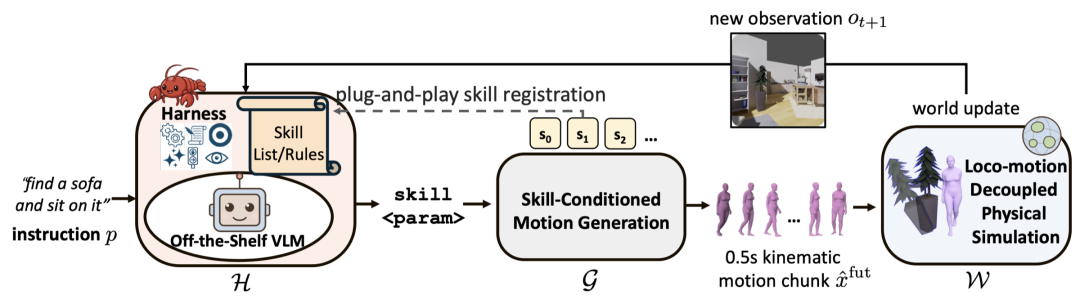
该研究由Meta、南洋理工大学、华盛顿大学、布朗大学和西北大学联合完成,其核心贡献在于构建了一个名为HumanCLAW的评测框架,首次将高层行动决策与低层运动控制明确分离。这一设计至关重要,因为它解决了长期困扰具身智能研究的归因难题:当机器人任务失败时,究竟是模型选错了动作,还是控制器执行不到位?HumanCLAW通过“冻结VLM + 可靠执行器”的组合,确保所有失败都源于决策层面,从而精准测量模型本身的行动智能(Action Intelligence)。
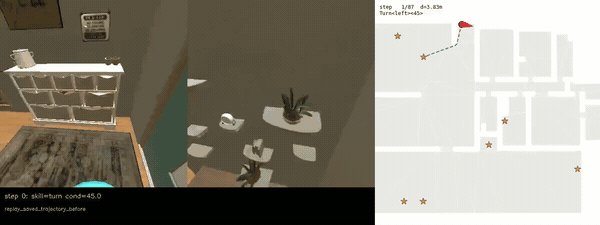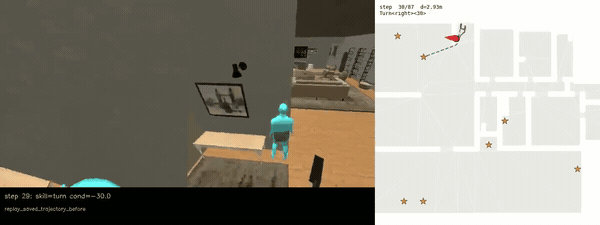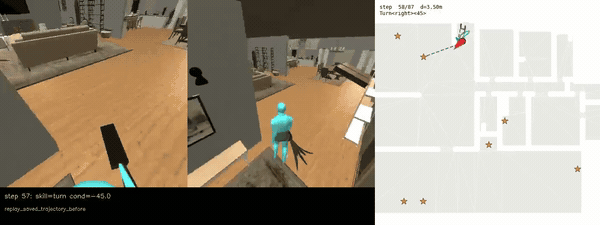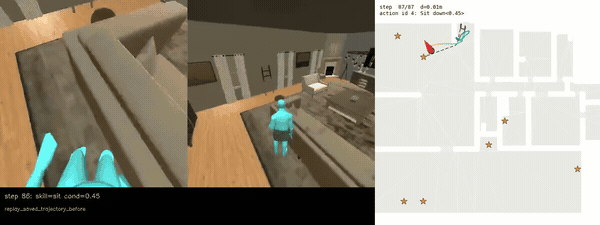
在HumanCLAW的设定中,模型每0.5秒需从一组原子技能(如向前走、左转、坐下等)中选择一个动作。这些技能随后被运动生成器转化为连续的全身运动,整个过程保留真实的物理交互——墙会阻挡、家具会被撞开、重力始终存在。但关键的是,身体永远不会摔倒,低层控制误差被完全排除。这使得评测聚焦于一个纯粹的问题:模型是否知道在何时、何地、以何种方式发出下一个动作指令?
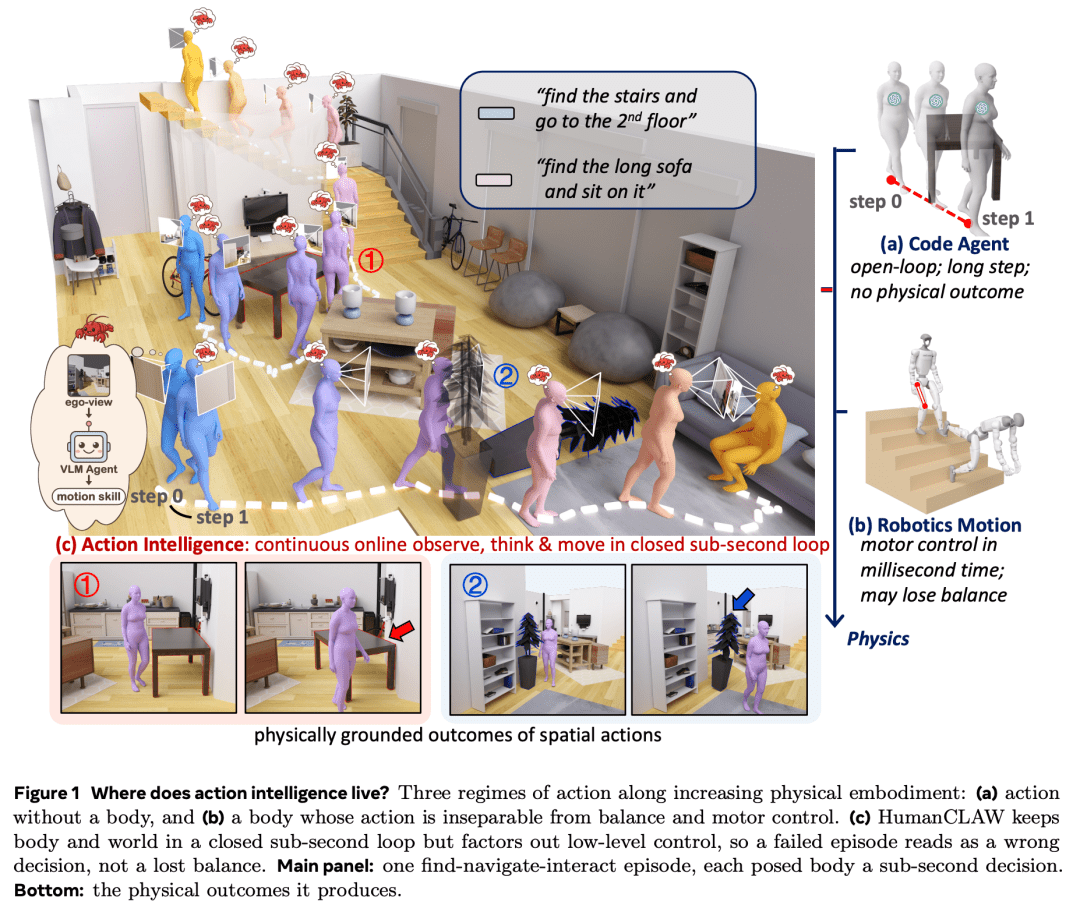
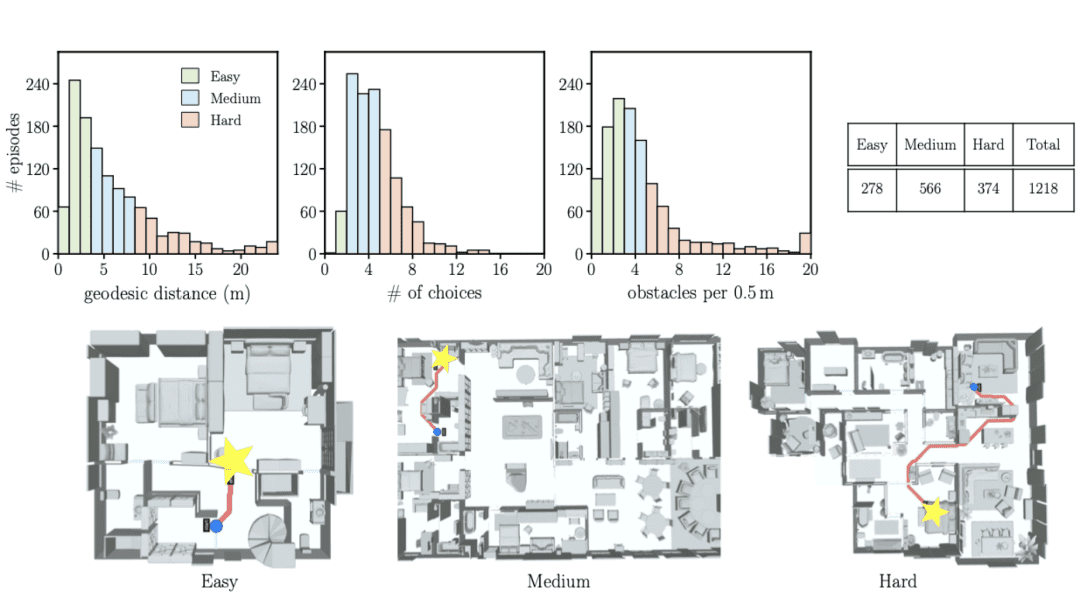
为了全面评估这一能力,研究团队构建了HumanCLAW-Bench,包含41个室内场景中的1,218条长程任务。每条任务严格划分为三个阶段:首先找到目标物体(Find),然后导航至其附近(Navigate),最后完成真实物理交互(Interact),例如坐在椅子上。这种分阶段设计使得研究者能够精确追踪能力衰减的位置。
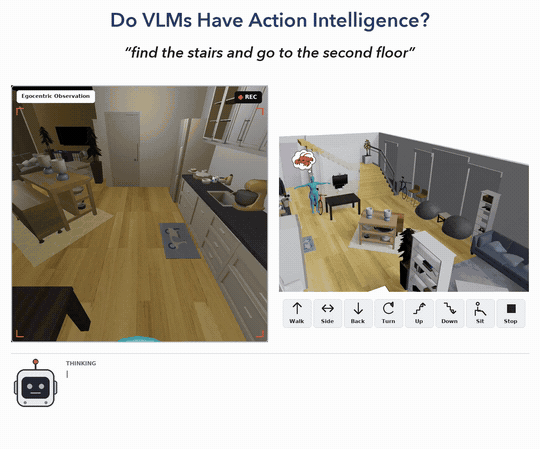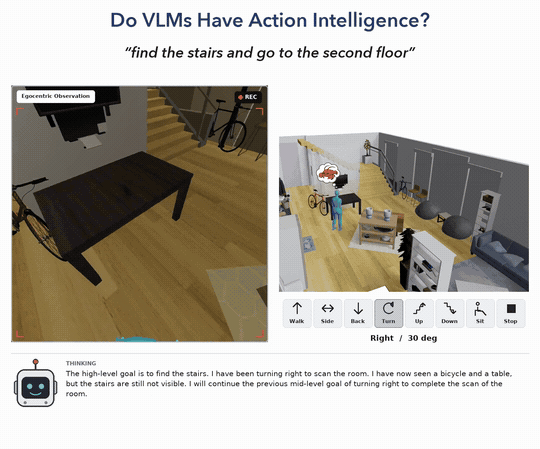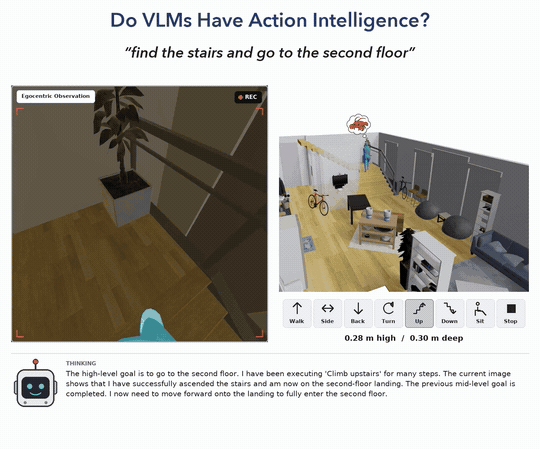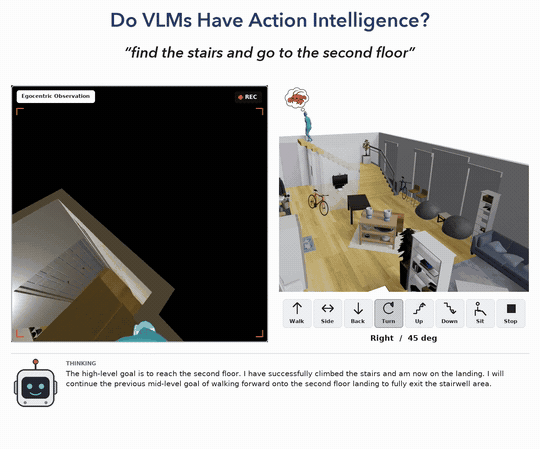
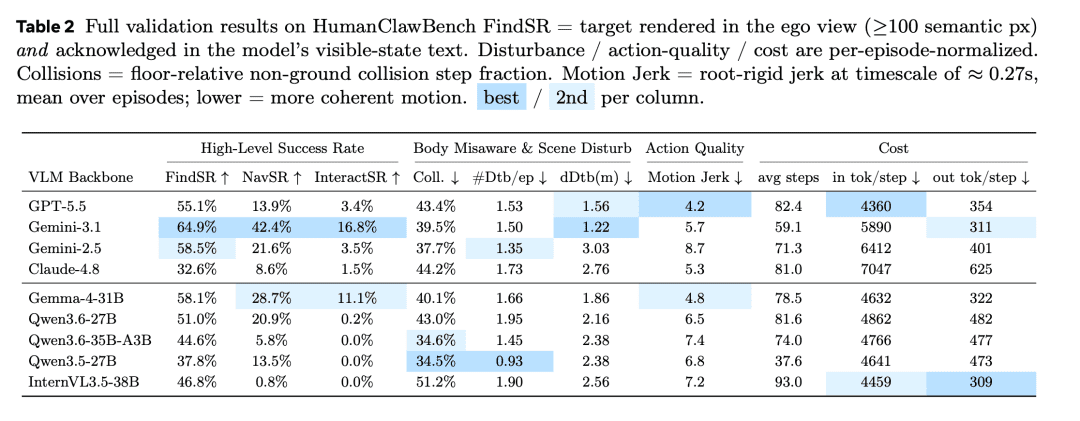
实验结果令人深思。九个当前最先进的VLM(包括闭源和开源模型)在完全相同的条件下接受测试,全程未进行任何任务微调。表现最佳的模型在三个阶段的成功率分别为64.9%、42.5%和16.8%。这意味着,尽管模型大多能识别目标(第一阶段成功率超六成),但在后续的连续决策中迅速掉队,最终仅约六分之一的任务能完成完整交互。更令人惊讶的是,四个模型的完整交互成功率甚至低于0.2%,几乎无法完成任何实际操作。
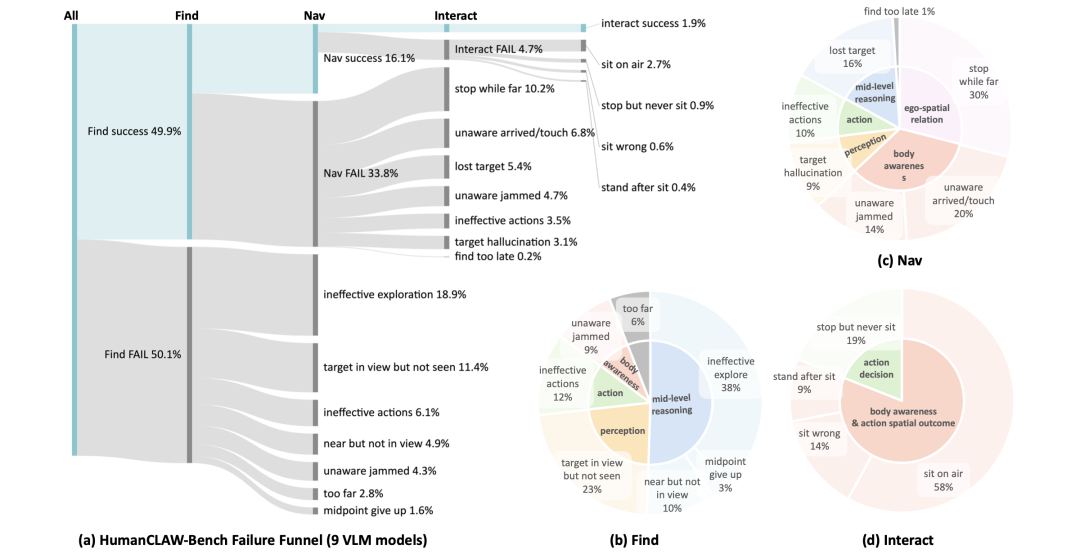
这种能力断层背后隐藏着更深层的认知缺陷。错误分析揭示了三大典型失败模式。首先是低效探索:模型未能将目标带入视野,反映出对环境结构的理解不足或探索策略的缺失。其次是空间判断失误:即使目标已在视野中,模型仍无法准确判断自身与目标的距离和相对朝向,导致导航失败。数据显示,在已发现目标的轨迹中,68%未能成功靠近。最后是交互时机错误:模型可能正确选择了“坐下”动作,却在距离目标过远或角度不对时发出指令,结果坐进空气而非椅子。
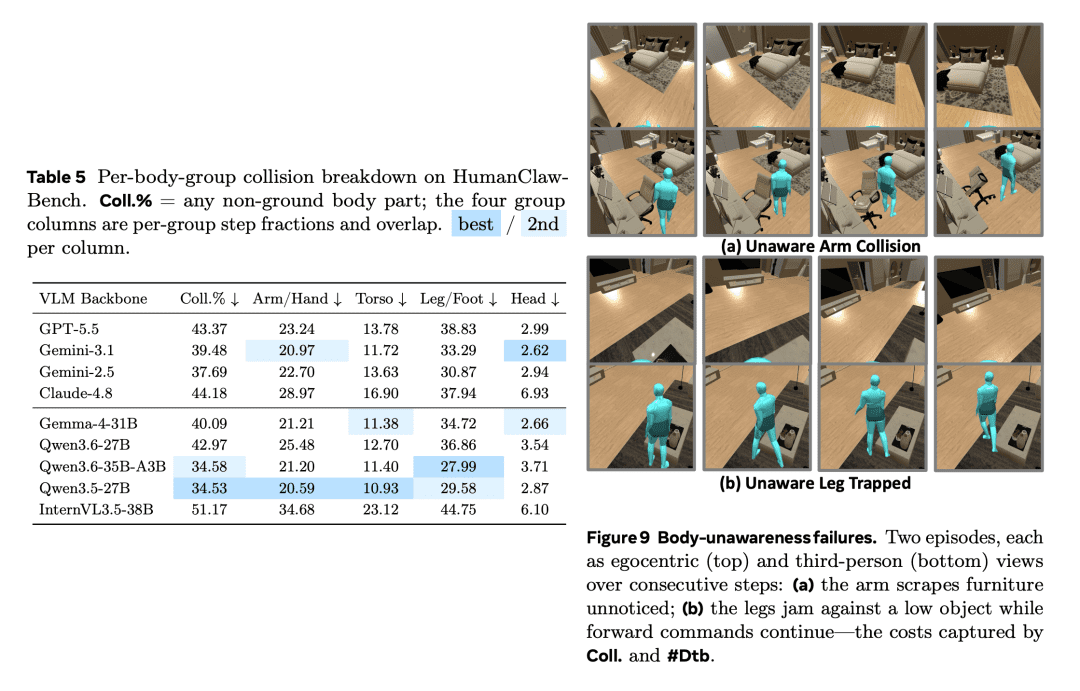
尤为值得注意的是身体碰撞的分布特征。研究发现,腿部在28%–45%的动作步中发生碰撞,而位于视野中心的头部碰撞率不到7%。这表明模型对自身不可见部位的空间位置缺乏持续感知。一个典型场景是:模型能准确描述“墙在左侧”,但下一步仍将左腿伸入墙体。这种矛盾行为凸显了当前VLM的一个根本局限——它们擅长描述外部世界,却无法维护一个关于“身体在哪里、朝向如何、刚碰到什么”的在线状态估计。
研究者将这种缺失称为“具身自我感知”(embodied self-awareness)。它不同于静态的本体感觉,而是一种动态的、随动作不断更新的自我模型。没有这种感知,模型就无法形成“行动-反馈-调整”的闭环,只能依赖瞬时视觉输入做孤立决策,极易在长序列任务中累积误差。
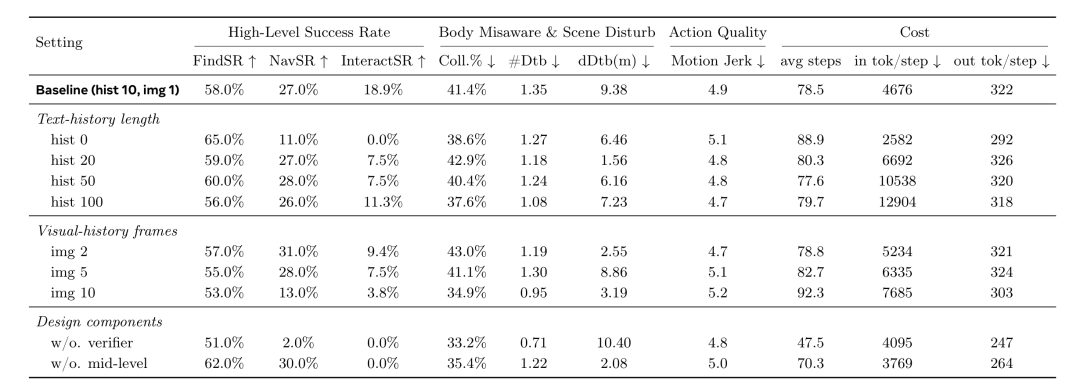
那么,如何弥补这一缺口?HumanCLAW的消融实验提供了关键线索。研究发现,增加历史上下文长度(如十帧图像记忆)不仅无益,反而可能损害性能。相反,引入结构化推理机制能显著提升表现。具体而言,当系统配备中层目标(如“先走到门边”)和短上下文验证器(检查动作合理性)时,完整交互成功率从接近零提升至18.9%;若移除验证器,导航成功率骤降至2%。这说明,行动智能的关键不在于记住更多数据,而在于如何组织信息——围绕身体状态构建有逻辑的推理链条。
这一发现对未来的模型设计具有重要启示。当前主流VLM多采用自回归方式处理长序列,但行动决策可能需要更专门的架构支持,例如显式的状态跟踪模块或分层规划机制。此外,研究还观察到一个积极信号:最强开源模型的表现已接近顶级闭源模型,暗示行动能力可能随基础模型的通用推理进步而自然提升。
展望未来,HumanCLAW为具身智能研究开辟了三条清晰路径。首先是跨身体泛化:当前实验基于人形身体,未来可扩展至四足、轮式等不同形态,检验行动智能的普适性。其次是模拟到现实的迁移:将高层决策接入真实机器人的学习控制器,重新引入硬件噪声和控制延迟,测试模型在非理想条件下的鲁棒性。最重要的是具身自我感知的建模:通过融合本体感受信号(如关节角度、接触力)并针对性训练,探索这种能力究竟源于多模态观察、记忆机制,还是需要专门的学习范式。
如果行动智能确实能随基础模型共同演进,那么具身系统的开发范式将发生根本转变。我们或许不再需要为每个任务收集海量示教数据、训练专用策略,而是依赖一个通用决策层,配合可复用的低层控制器。基础模型的角色也将从被动的观察者,升级为主动的行动者——不仅能理解“这是什么”,更能决定“我该怎么做”。
HumanCLAW的价值不仅在于其具体发现,更在于它将一个模糊的愿景转化为可量化、可重复的研究问题:“基础模型能否成为具身智能的决策层?”随着新模型不断发布,这套基准将持续提供客观答案。无论结果如何,它都标志着具身AI研究迈入了一个更严谨、更系统的新阶段。