TimechoAI高精度落地全攻略:数据清洗+调参规范+误差归因+阈值控制四维体系
在工业智能化加速推进的背景下,时序预测模型已成为设备运维、能源调度、环境监测等核心业务的关键支撑。然而,许多团队在引入如 TimechoAI 这类先进时序 AI 工具后,常面临一个共性困境:模型在演示环境中表现优异,但部署到真实业务场景后预测偏差显著增大,且难以定位根本原因。这种“落地即失准”的现象,往往并非模型能力不足,而是缺乏一套系统化、可执行的精细化落地规范。

大量实践验证,时序预测效果的差异主要源于三大维度:数据质量(占比约70%)、参数配置合理性(约20%)与场景适配度(约10%)。模型本身的算法架构固然重要,但在相同模型下,能否通过标准化流程释放其最大潜力,才是决定项目成败的关键。为此,本文构建了一套覆盖“数据预处理—参数调优—误差诊断—运行管控”全链路的四维优化体系,并以可直接复用的表格形式呈现,助力开发者高效实现高精度、高稳定性的生产级部署。
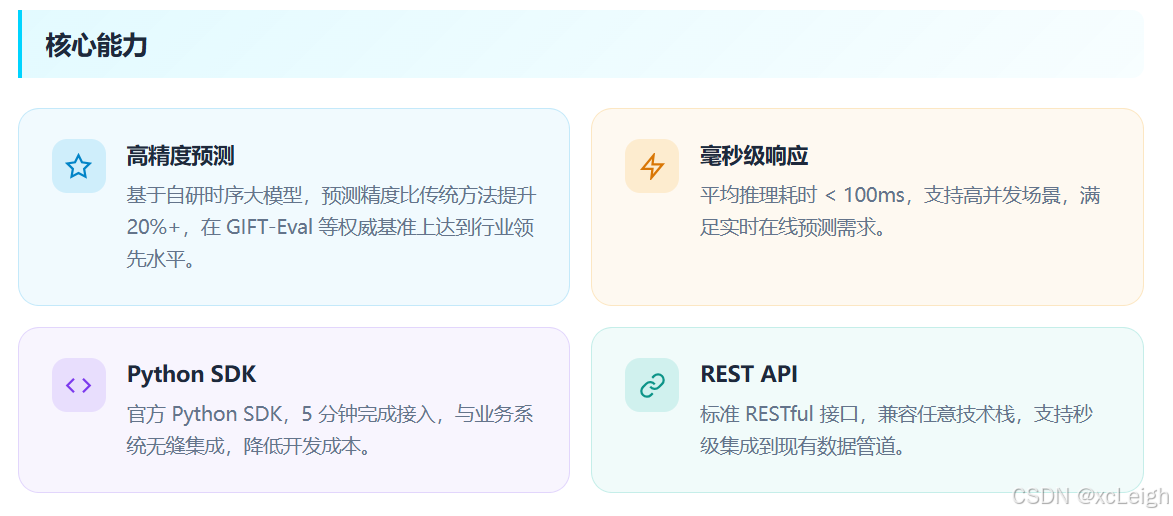
数据清洗:预测精度的基石
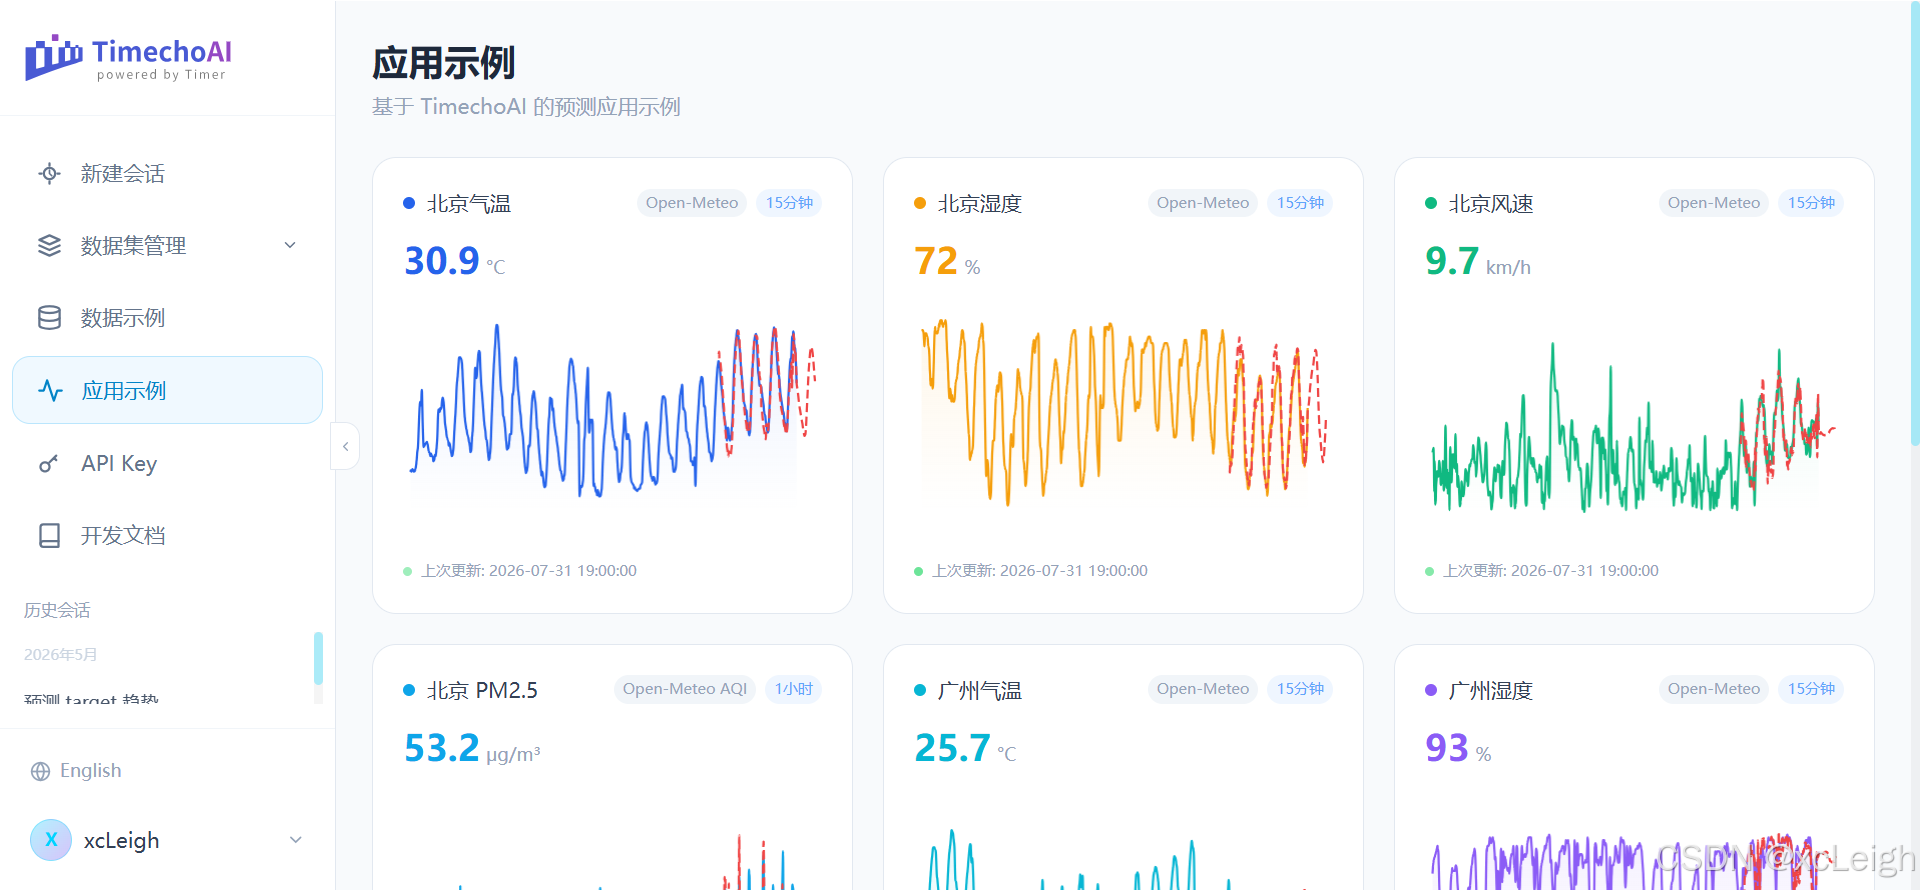
原始时序数据往往包含各类噪声与异常,若未经规范处理直接输入模型,极易导致学习偏差甚至逻辑错乱。我们基于上百个工业场景的实测反馈,提炼出五类典型数据异常及其标准化处理方案:
- 短时单条缺失值:表现为孤立的时间点数据为空,而前后序列连续正常。此时应采用前后邻近点的均值进行填充,尤其适用于温度、压力等变化平缓的物理量。严禁直接删除,否则会破坏时间连续性,造成模型对趋势误判。
- 连续多条缺失值:当缺失长度超过3个时间步,填充已无法还原真实状态。此时应果断舍弃该段数据,重新截取前后连续的有效序列。切忌使用线性插值或批量填充,这会人为制造虚假趋势,误导模型训练。
- 极端突变异常值:如传感器故障导致的数值骤升/骤降,明显超出业务合理范围。此类数据必须剔除,并以邻近平稳值替代。保留原值会使模型误认为存在结构性拐点,严重影响长期预测。
- 小幅噪声抖动:由测量精度或环境干扰引起的微小波动,通常无实际业务意义。TimechoAI 内置的注意力机制具备一定抗噪能力,无需人工平滑处理,否则可能抹除关键细节特征。
- 时间戳错乱:数据采集或传输过程中出现的时间顺序颠倒。必须按时间戳严格升序重排,绝不可直接传入模型,否则整个时序逻辑将彻底失效。
实测数据显示,仅通过上述标准化清洗流程,预测精度最高可提升20%,远超盲目调整模型超参数的效果。这印证了“垃圾进,垃圾出”(GIGO)原则在时序AI中的核心地位。
场景驱动的精细化调参策略
TimechoAI 虽提供通用预测能力,但不同业务场景对时序特性的敏感度差异巨大。例如,电网负荷具有强周期性与日级规律,而风机受力则受瞬时风速影响显著。因此,必须依据场景特性定制参数组合。我们针对六大高频应用场景,总结出经生产验证的最优配置:
| 业务场景 | 历史输入长度 | 预测步长 | 请求间隔 | 采样密度 | 推荐模型 |
|---|---|---|---|---|---|
| 变压器油温预测 | 25–40条 | 3–5步 | 1分钟 | 15秒/次 | timer_base |
| 风机塔筒受力预测 | 40–60条 | 5–8步 | 2分钟 | 10秒/次 | timer_base |
| 城市气象温湿度 | 30–45条 | 8–12步 | 5分钟 | 15分钟/次 | timer_base |
| PM2.5空气质量预测 | 20–30条 | 4–6步 | 10分钟 | 1小时/次 | timer_base |
| 流量/销量趋势预测 | 35–50条 | 6–10步 | 30分钟 | 1小时/次 | timer_base |
| 电网负荷能耗预测 | 50–60条 | 10–15步 | 1小时 | 30分钟/次 | timer_base |
其中,历史输入长度需覆盖至少一个完整业务周期(如电网的日负荷曲线),预测步长则应匹配业务决策窗口。采样密度过高会引入冗余噪声,过低则丢失关键动态,需在信息完整性与计算效率间取得平衡。值得注意的是,当前所有场景均推荐使用 timer_base 版本,因其在轻量化与精度间实现了最佳折衷。
误差归因:从结果反推问题根源
当预测结果出现偏差时,快速定位问题是保障业务连续性的关键。我们依据误差幅度建立三级归因机制:
- 轻微误差(0–5%):属于正常随机波动范围,尤其在高噪声工业环境中不可避免。此类结果可直接用于业务决策,无需干预。
- 中度误差(5%–12%):通常由局部数据质量问题或参数微小偏移引起。解决方案包括:执行基础数据清洗、对照场景表微调输入长度或预测步长。整个修复过程可在5分钟内完成。
- 重度误差(>12%):表明系统性问题存在,如时间戳错乱、大规模脏数据污染或参数完全不匹配。此时需启动全量数据重处理,并重新匹配场景专属参数组合,耗时约10–15分钟。
该归因体系将模糊的“预测不准”转化为可操作的排查清单,大幅降低运维复杂度。
线上生产阈值:保障系统长期稳定
高精度仅是第一步,持续稳定运行才是生产系统的终极目标。我们定义四类关键阈值,作为线上部署的“安全护栏”:
- 单次请求数据量:建议控制在10–60条之间。超过80条易触发推理超时,尤其在边缘设备资源受限场景下。
- 单次预测步长:上限设为15步。步长过大会导致误差累积放大,使远期预测完全失真。
- 接口响应耗时:应低于100ms以满足实时业务需求。若持续高于150ms,需检查网络链路或服务端负载。
- 单日请求频次:应保持平稳节奏。避免短时高频请求(如每秒多次),否则将触发平台限流机制,导致服务中断。
这些阈值并非理论假设,而是基于数千次线上调用统计得出的经验边界,严格遵守可规避99%的运行时异常。
接入方式选型:匹配项目生命周期
TimechoAI 提供三种接入路径,适用于不同阶段需求:
- 网页零代码操作:适合POC验证、临时测试或非定时分析任务。优势在于极速上手,但缺乏容错与扩展能力。
- Curl命令调用:适用于服务器定时任务或简单自动化脚本。可通过Shell或批处理集成,稳定性良好,但功能较为基础。
- Python SDK接入:面向生产级系统,支持自定义重试策略、异常捕获、日志追踪及与现有业务系统深度集成。虽需少量编码,但长期维护成本最低,扩展性最强。
对于正式上线项目,强烈推荐采用 Python SDK 方案,以构建健壮、可观测的预测服务管道。
综上所述,TimechoAI 的高精度落地并非依赖单一技巧,而是一套涵盖数据、参数、诊断与运维的系统工程。通过严格执行本文提出的四维规范——以数据清洗筑牢基础、以场景参数释放潜力、以误差归因快速纠偏、以运行阈值保障稳定——企业可将预测误差稳定控制在5%以内,真正实现AI技术从“能用”到“好用”再到“可靠用”的跨越。这一方法论不仅适用于TimechoAI,也为其他时序预测系统的工业化部署提供了可复用的参考范式。