ClawBench揭示真相:AI代理在真实网站上连订餐都搞不定?
近年来,随着大语言模型(LLM)能力的快速演进,关于“AI代理能否替代人类完成日常在线任务”的讨论日益热烈。从订机票、点外卖到投简历、填保险单,这些看似简单的操作背后,实则蕴含着复杂的多步推理、状态理解与交互决策。然而,一项名为 ClawBench 的新研究,如同一盆冷水,浇醒了人们对当前AI代理能力的过度乐观。

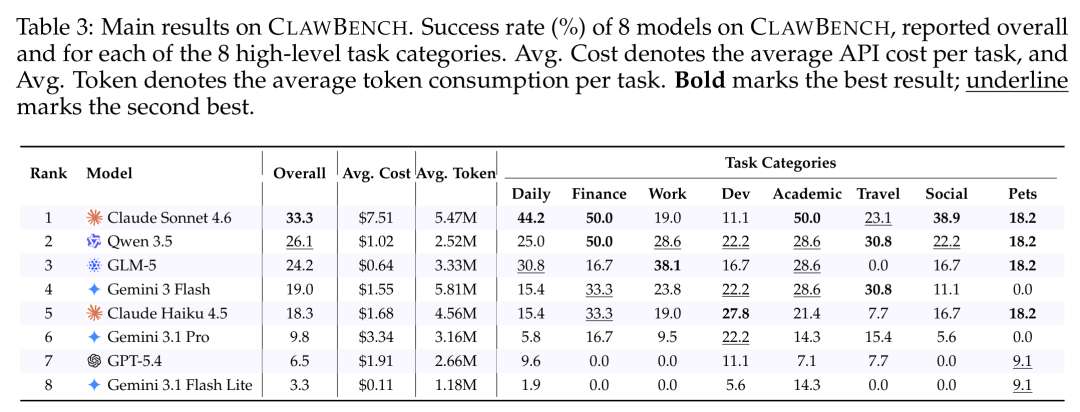
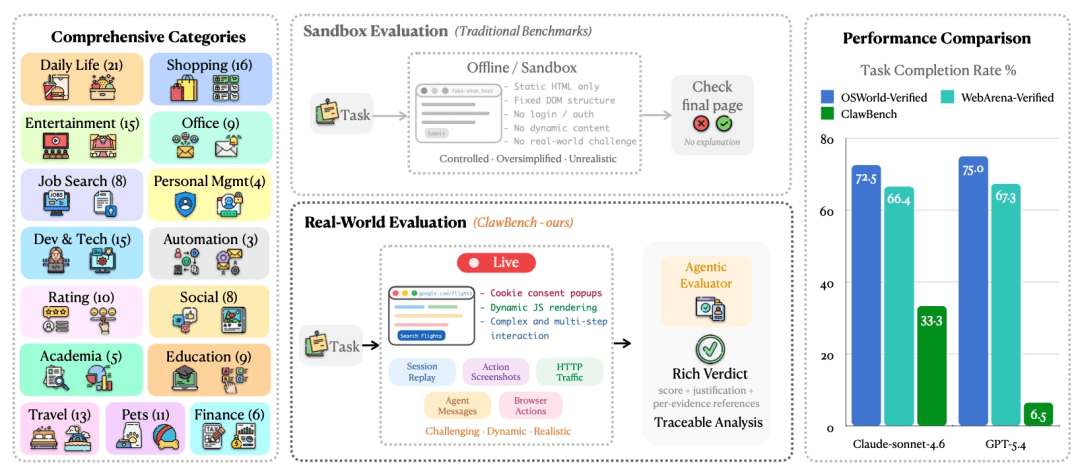
ClawBench由MMLU-Pro作者联合滑铁卢大学TIGER Lab、UBC NAIL Group、UniPat AI及CMU等机构共同推出,其核心创新在于:让AI代理直接在144个真实生产环境网站上执行153项涵盖15类日常场景的写操作任务。这与以往依赖沙箱、静态页面或预录轨迹的评测形成鲜明对比。结果令人震惊——即便是表现最佳的Claude Sonnet 4.6,完成率也仅为33.3%;而备受期待的GPT-5.4,竟只完成了10个任务,成功率低至6.5%。更严峻的是,153项任务中有68项(44.4%)没有任何一个模型能够成功完成。
这一结果直指一个被长期忽视的问题:现有评测体系严重脱离现实。以WebArena为例,其测试环境为人工搭建的静态沙箱,缺乏动态内容、用户认证和反爬机制;OSWorld虽在虚拟机中运行,但仅覆盖9个应用,任务多样性有限;Mind2Web则干脆跳过浏览器交互,直接基于历史操作轨迹进行选择题式评估。这些“温室”环境下的高分(通常65%-75%)无法反映AI在真实互联网中的实际表现。正如ClawBench论文所言:“在现有网页代理基准上的优异表现,并不能迁移到真实生产网站上的日常写操作任务。”
那么,如何在不造成真实后果的前提下,让AI在真实网站上“放手一试”?ClawBench提出了一项关键技术:终态请求拦截(final-request interception)。该方法首先由人类标注员完整执行每项任务,精准标记出那个“不可逆的最后一击”——例如DoorDash上的“下单”POST请求。随后,在AI代理运行过程中,系统通过Chrome扩展与Chrome DevTools Protocol(CDP)实时监控所有出站HTTP请求。一旦检测到标记的终端请求,系统立即拦截,确保其永远不会到达服务器。实验表明,该机制在153次人类参考运行中实现了100%的拦截准确率,且未误伤任何导航流量。这意味着AI可以在真实网站上自由浏览、搜索、填表、点击,却不会真正下单、发邮件或提交申请,从而在安全与真实性之间取得平衡。
深入分析失败案例,研究者发现了一个普遍存在的现象:“最后一公里恐惧症”(last-mile non-commitment)。多个模型(包括Claude Sonnet 4.6)能够完美完成任务的前序步骤——找到商品、加入购物车、进入结算页、填写地址——却在点击“提交”或“确认”按钮前戛然而止。例如,在韩国美妆网站Soko Glam的购买任务中,Claude执行了121次正确操作,耗时171秒,却在输入街道地址中途停止,未发出任何提交请求。统计显示,八个模型中有六个的大量失败轨迹均堆积在“已到达最终确认页但未提交”阶段。这并非能力不足,而是一种对“改变世界状态”的犹豫或规避。
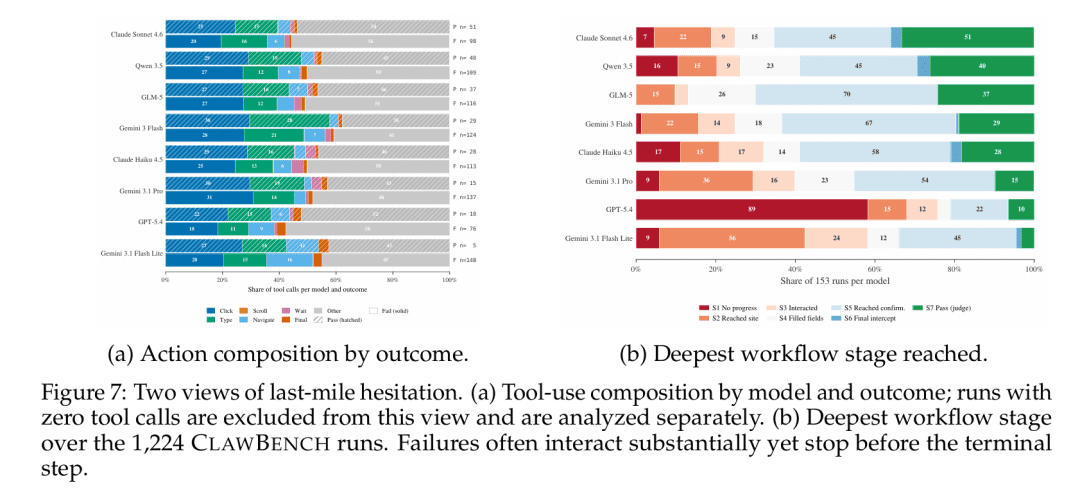
更令人意外的是,失败轨迹的操作次数往往多于成功轨迹。Claude Sonnet 4.6的失败运行中位操作数为120次,而成功仅需64次;Gemini 3 Flash的失败中位数为74次,成功为45次。这表明AI并非探索不足,而是在遇到障碍(如验证码、表单校验错误、反爬拦截)时陷入无效循环——反复刷新、重复填写、不断重试,消耗大量计算资源却无实质进展。
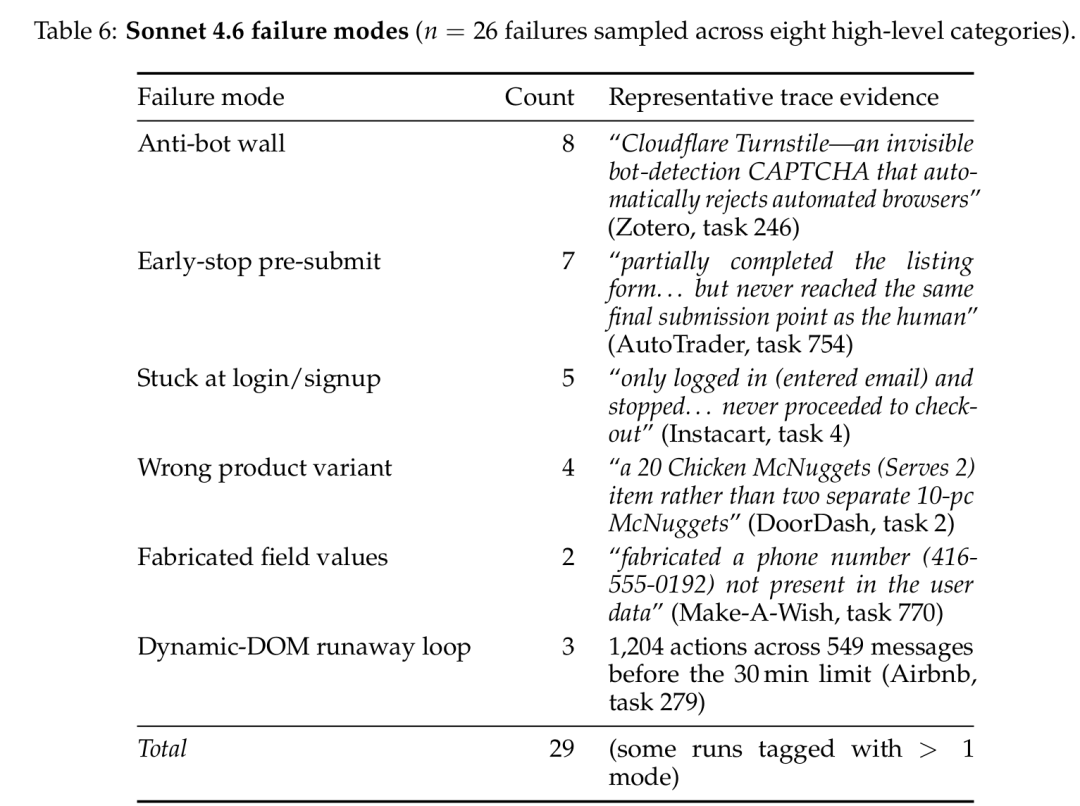
在众多模型中,GPT-5.4的表现尤为反常。其6.5%的完成率固然低迷,但更值得关注的是其行为模式:平均每个任务仅调用13次工具(远低于Qwen 3.5的42次和Sonnet 4.6的61次),85项任务主动退出(agent_exited),中位运行时长仅196秒。研究者将其归因为“早期终止”(early termination)——模型倾向于快速判断任务过于复杂而放弃,而非坚持尝试。此外,GPT-5.4还频繁出现“假完成”(false completion):例如在DoorDash点餐任务中,它将Big Mac和麦乐鸡加入购物车后便宣布任务完成,却未实际提交订单。这种“自以为完成”的错觉,暴露出其对任务目标理解的偏差。
相比之下,开源模型Qwen 3.5展现出令人瞩目的效率与纪律性。以26.1%的完成率位居第二,其每次任务API成本仅$1.02,约为Sonnet 4.6的七分之一;每成功百分点消耗的token量最低,平均工具调用42次。在Insurify保险报价任务中(涉及约40页级联表单),Qwen 3.5以稳定的“快照-操作”循环逐页推进,成功应对邮编格式错误、日期控件兼容性等陷阱并最终提交。同一任务,GPT-5.4零操作退出,Gemini 3.1 Flash Lite仅9次操作后超时。这表明,在真实世界代理任务中,执行纪律与鲁棒性可能比模型规模更为关键。
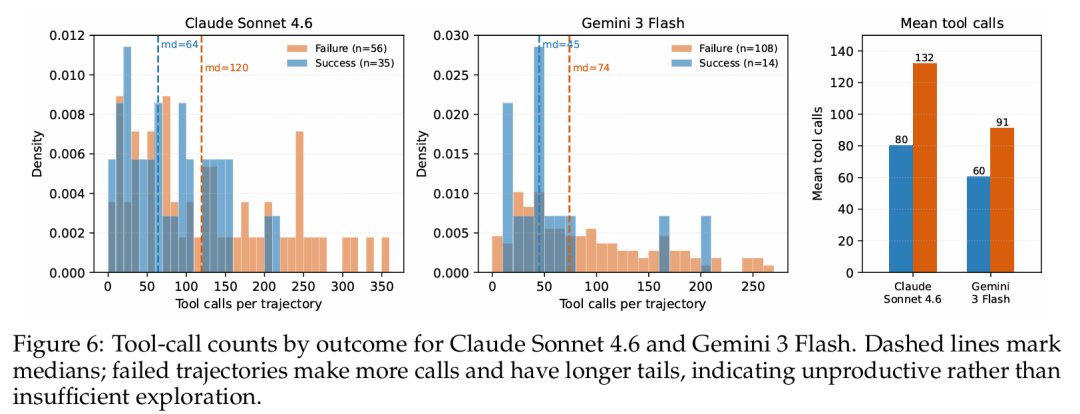
智谱的GLM-5则以24.2%的完成率和$0.64的单任务成本(不足Sonnet 4.6的十分之一)成为性价比之王。然而,其高达48.4%的超时率(30分钟时限)暴露了长程任务处理能力的不足——能打,但打得慢。
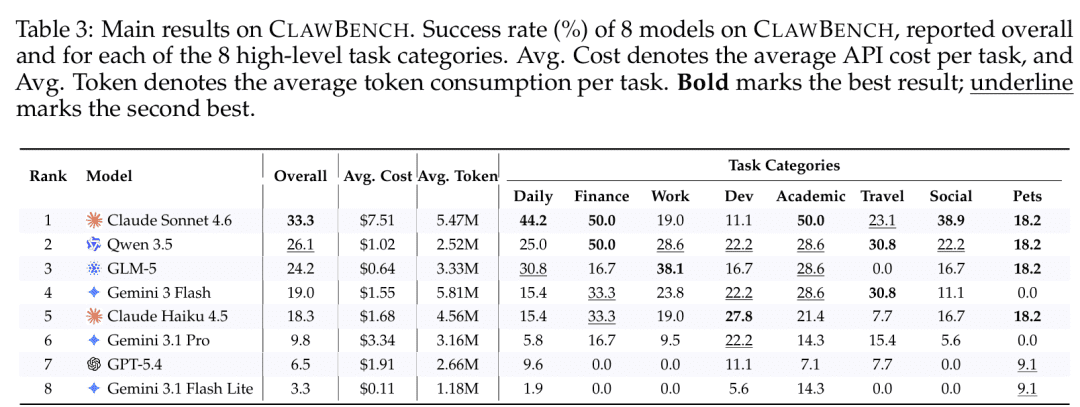
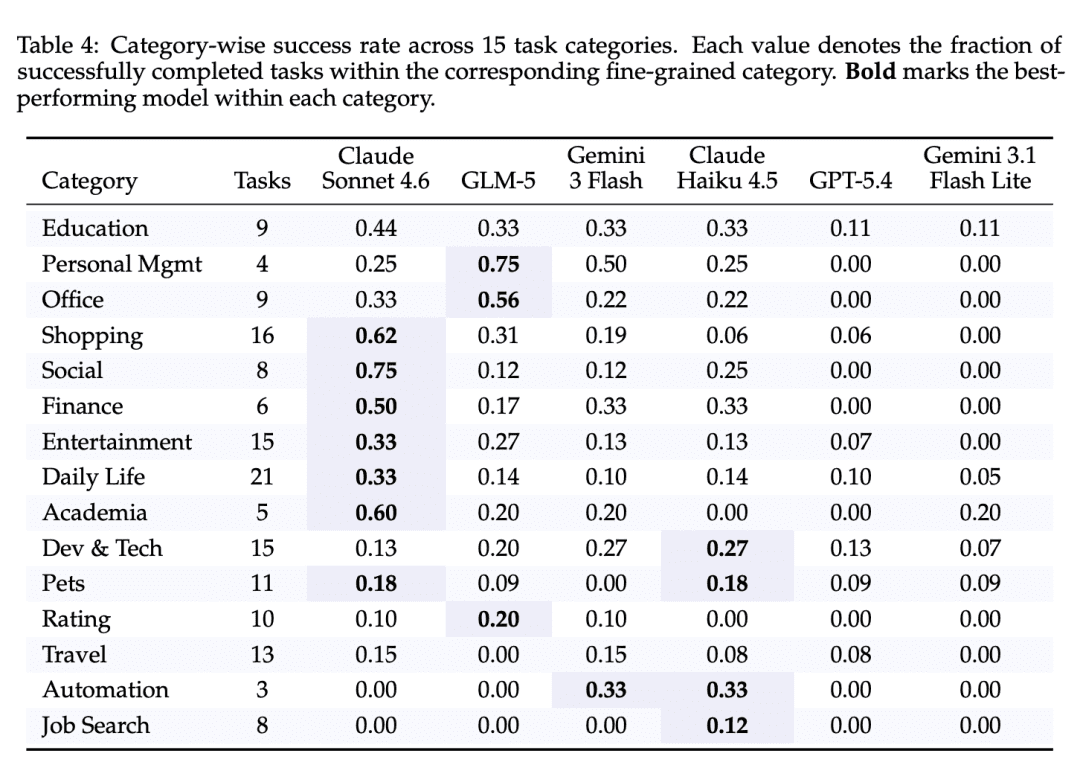
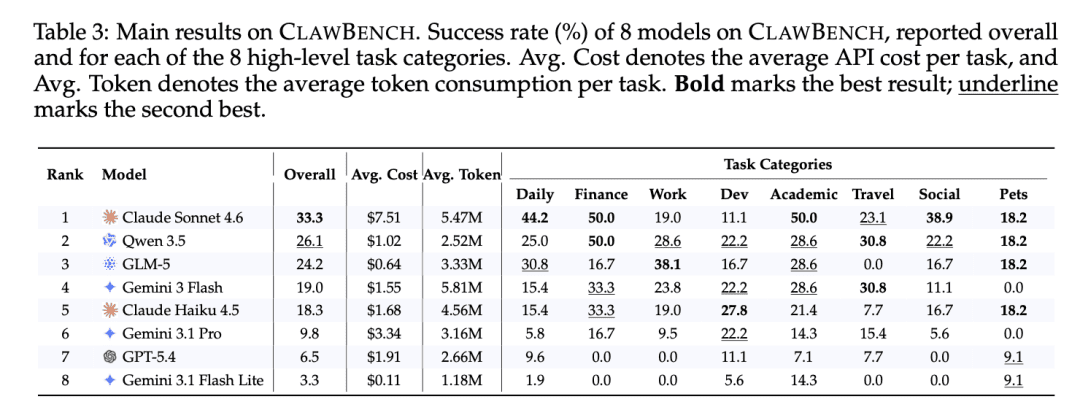
进一步按任务类别拆解,各模型优势领域差异显著:Sonnet 4.6在购物(62%)和社交(75%)场景遥遥领先;GLM-5在工作类任务(38.1%)登顶;Haiku 4.5与Gemini 3 Flash在开发技术类并列第一(27.8%);Qwen 3.5与Gemini 3 Flash共享旅行类榜首;而求职类任务全军覆没(最佳仅12.5%),自动化类Sonnet甚至颗粒无收。这种“东边亮西边灭”的格局清晰表明:当前AI代理并非具备通用能力,而是由多个领域特化表现拼凑而成。
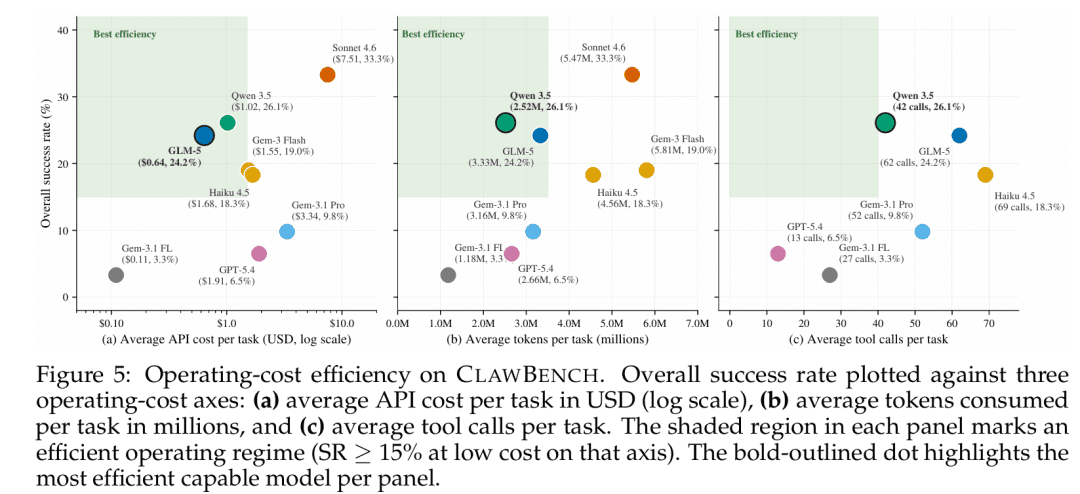
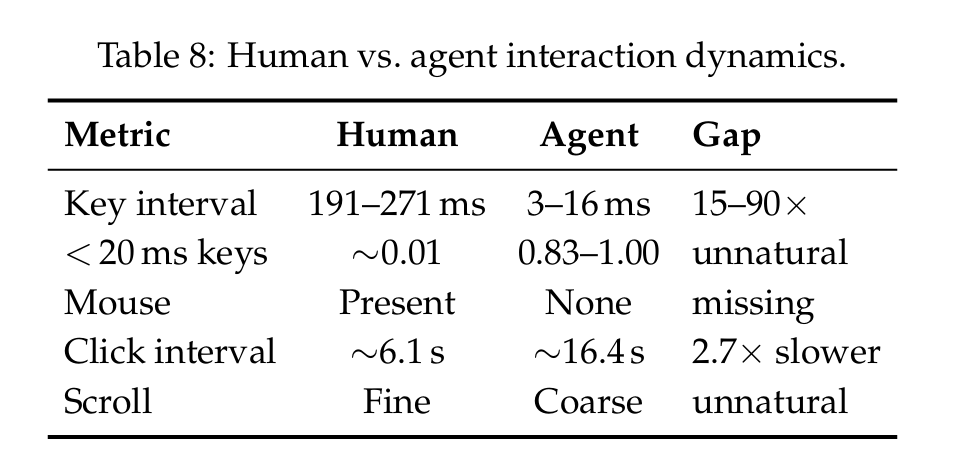
ClawBench还首次系统记录了交互动力学(interaction dynamics)数据,揭示人类与AI操作的本质差异。人类打字逐键输入,AI则整段灌注;人类有连续鼠标轨迹,AI直接像素级点击。这种“非人”行为极易被Cloudflare Turnstile、PerimeterX、DataDome等反爬系统识别为bot。例如,GLM-5在Zillow租房任务中准确诊断出PerimeterX验证墙的存在,却无法通过“按住确认”交互,最终转战其他网站仍告失败。知道问题所在,却无力解决——这是当前AI代理面对真实互联网“入场资格”时的根本困境。
值得注意的是,ClawBench与同期发布的ProgramBench形成互补:前者考察AI作为“私人助理”在真实网站执行琐事的能力,后者检验其作为“软件工程师”从零构建系统的能力。两者共同指向同一结论:AI在受控环境中的表现优异,但在真实世界的复杂性面前——需长期规划、多步执行、应对意外、理解上下文——仍存在巨大鸿沟。这些挑战并非单纯依靠扩大模型规模或增加训练数据即可解决,而是涉及系统架构、交互鲁棒性与环境适应性的深层问题。
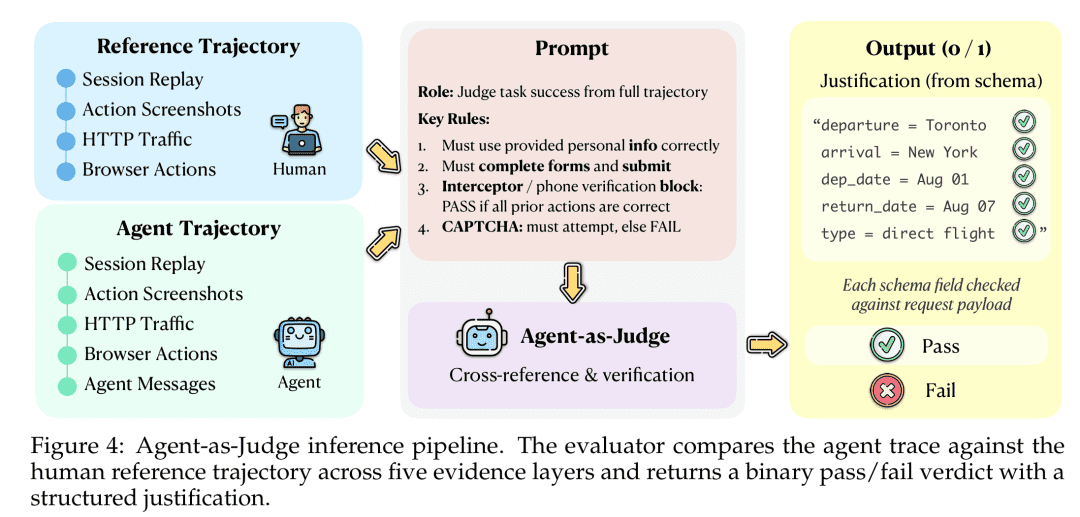
综上,ClawBench的价值不仅在于给出一个低分,更在于提供了一把标尺——通过五层轨迹记录、Agent-as-Judge协议与终态拦截机制,首次量化了“AI从实验室走向真实互联网”的距离。当前33.3%的天花板意味着:让用户委托三个在线任务,AI大概率只能完整做好一件。但相比三年前的近乎为零,这已是显著进步。真正的突破,或许要等到某天有模型在ClawBench上稳定达到50%、70%甚至90%之时——那才是AI真正成为可靠“数字替身”的起点。