AI Agent代码执行沙箱横评:不可信代码运行的六大方案深度对比
引言:AI时代不可信代码的安全执行困境
2024年后,AI Agent技术迅速渗透至代码生成、自动化运维、智能测试等核心场景。然而,一个根本性问题始终悬而未决:由大模型生成的代码是否可以直接执行? 答案显然是否定的。一段简单的rm -rf /命令可能导致整个服务瘫痪,一个内网API调用可能泄露敏感数据,而无限循环则会耗尽系统资源。这些并非理论风险,而是每个尝试让AI执行代码的团队必须面对的现实威胁。
因此,代码执行沙箱成为AI Agent架构中不可或缺的安全组件。但面对市场上琳琅满目的沙箱方案——从轻量级容器到硬件级虚拟机,从开源自托管到云端SaaS服务——开发者该如何选择?本文通过两周的深度实测,对六大主流方案进行全面横评,旨在为不同业务场景提供清晰的选型依据。
沙箱的核心需求与评估维度
理想的AI代码执行沙箱需满足六大核心要求:
- 强隔离性:确保沙箱内代码无法访问宿主机文件系统、网络或进程空间
- 瞬时销毁:任务完成后能彻底清除所有状态,不留痕迹
- 精准网络控制:支持断网、白名单、黑名单等细粒度策略
- 毫秒级启动:适应Agent短平快的任务特性,避免用户体验延迟
- 高资源密度:单机可承载数百实例,控制运营成本
- 低接入门槛:兼容现有SDK,降低迁移成本
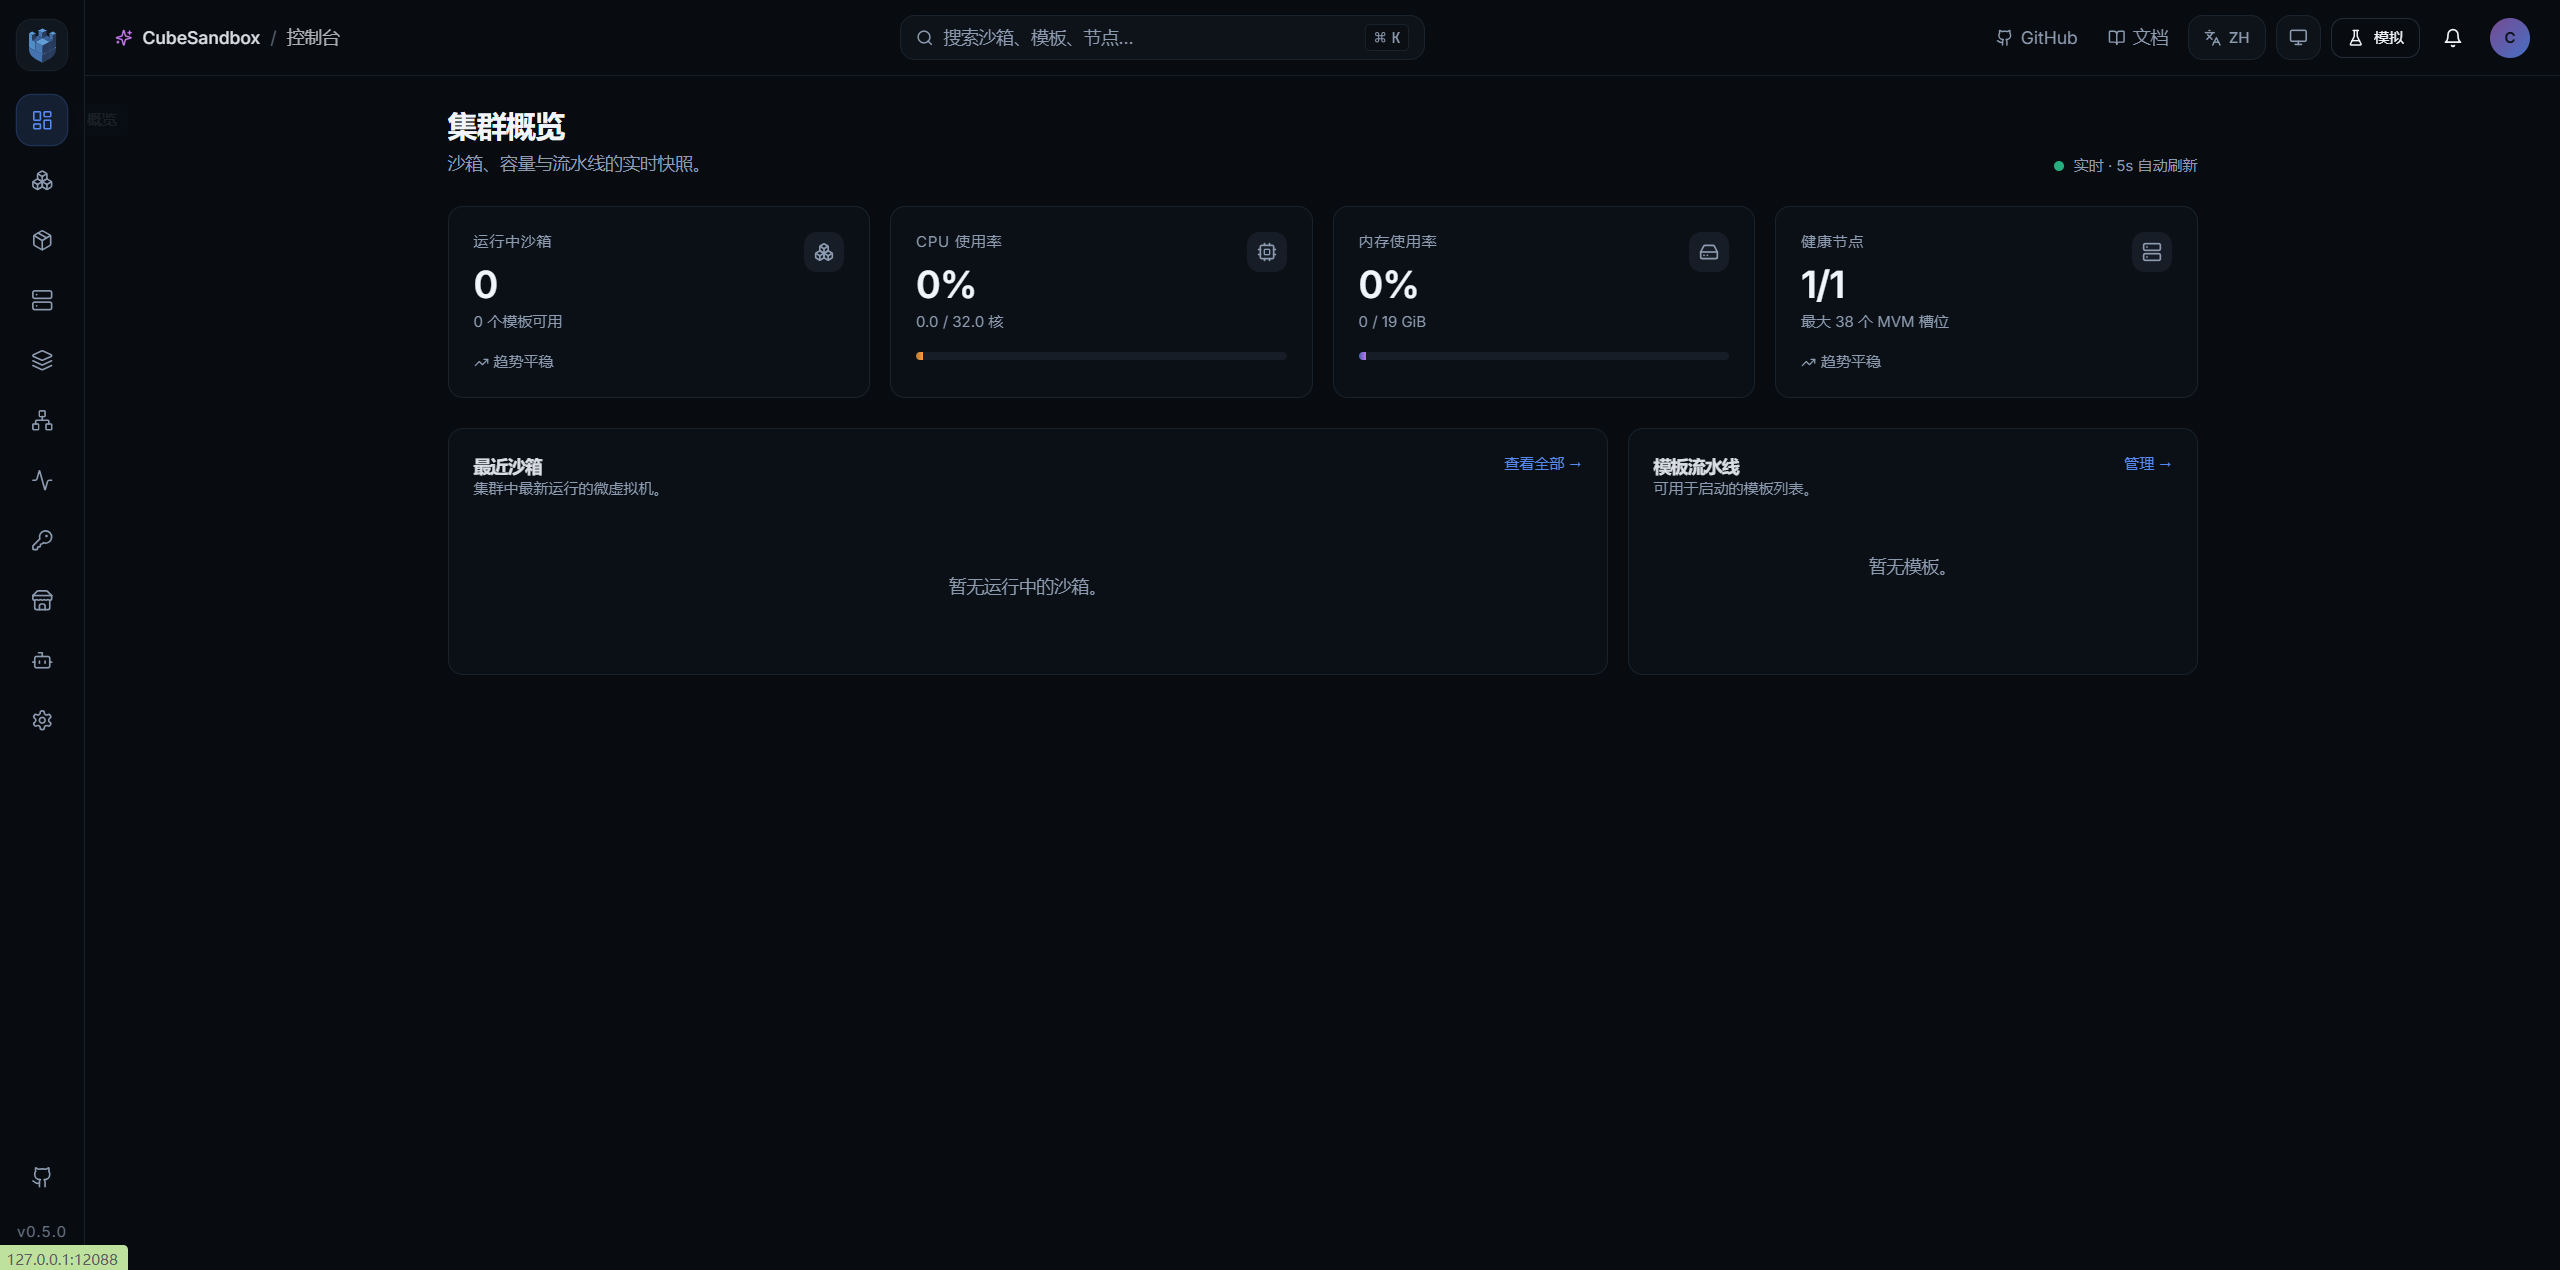
基于这些标准,我们选取了六类代表性方案进行评测:CubeSandbox(MicroVM)、Docker(容器)、E2B(托管云)、Daytona(Agent平台)、OpenSandbox(通用抽象层)及传统VM(完整虚拟机)。
技术路线与架构差异解析
MicroVM vs 容器:隔离模型的根本分野
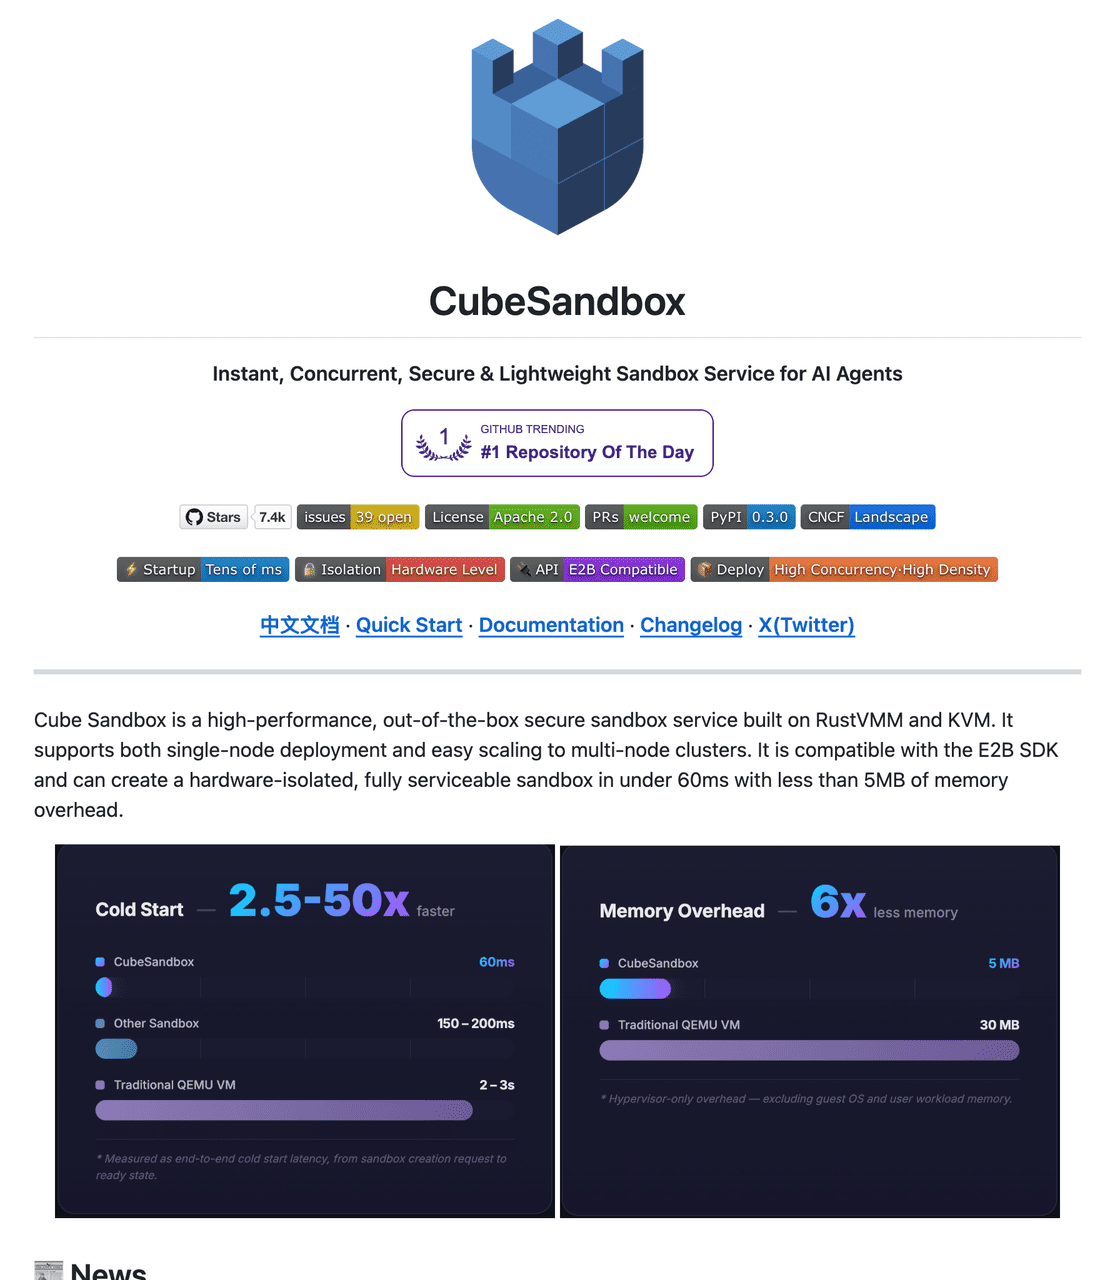
CubeSandbox采用KVM MicroVM技术,每个沙箱拥有独立Linux内核,通过硬件虚拟化实现强隔离。相比之下,Docker等容器方案共享宿主内核,依赖Linux Namespace和cgroup进行隔离。这种架构差异带来本质区别:
- 安全边界:MicroVM即使被攻破root权限,攻击面也仅限于虚拟机内部;容器逃逸则可能直接危及宿主机
- 内核漏洞影响:容器方案受宿主内核CVE影响范围更大
- 资源调度:MicroVM的CPU/内存分配更精确,避免容器间的资源争抢
托管服务 vs 自托管:数据主权与运维成本的权衡
E2B和Daytona作为托管服务,提供开箱即用的API体验,但要求代码数据经由第三方服务器。对于金融、政务等强合规场景,这往往不可接受。而CubeSandbox、Docker等自托管方案虽需自行维护基础设施,却能确保数据完全留在内网。
状态管理能力:Agent工作流的关键差异点
传统沙箱多关注“创建-执行-销毁”单次流程,但AI Agent常需多轮试错。例如在代码修复任务中,Agent可能需要:
- 初始化环境(安装依赖、拉取代码)
- 尝试方案A → 失败
- 回滚到初始化状态
- 尝试方案B → 成功
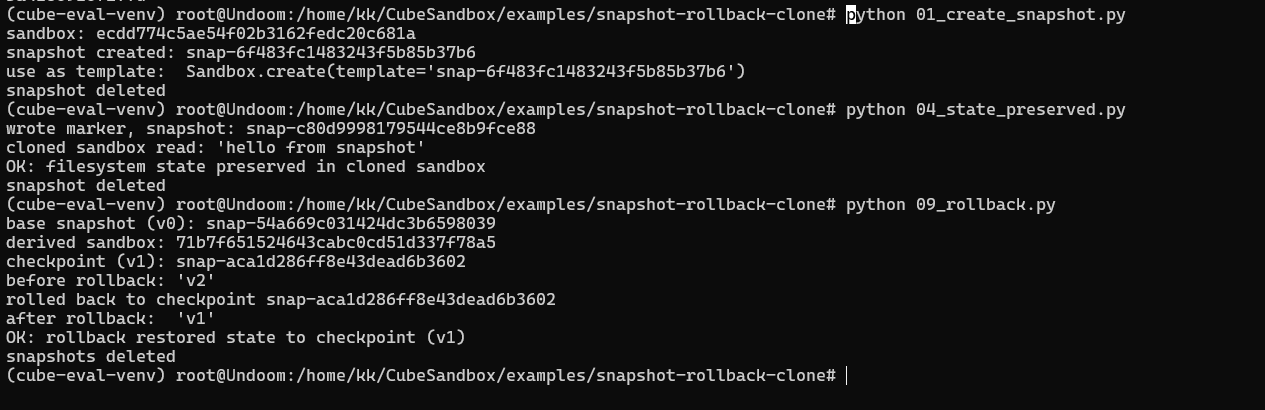
若无快照能力,每次试错都需重复步骤1,效率极低。CubeSandbox内置的Snapshot/Clone/Rollback机制正是为解决此痛点设计。
实测环境与方法论
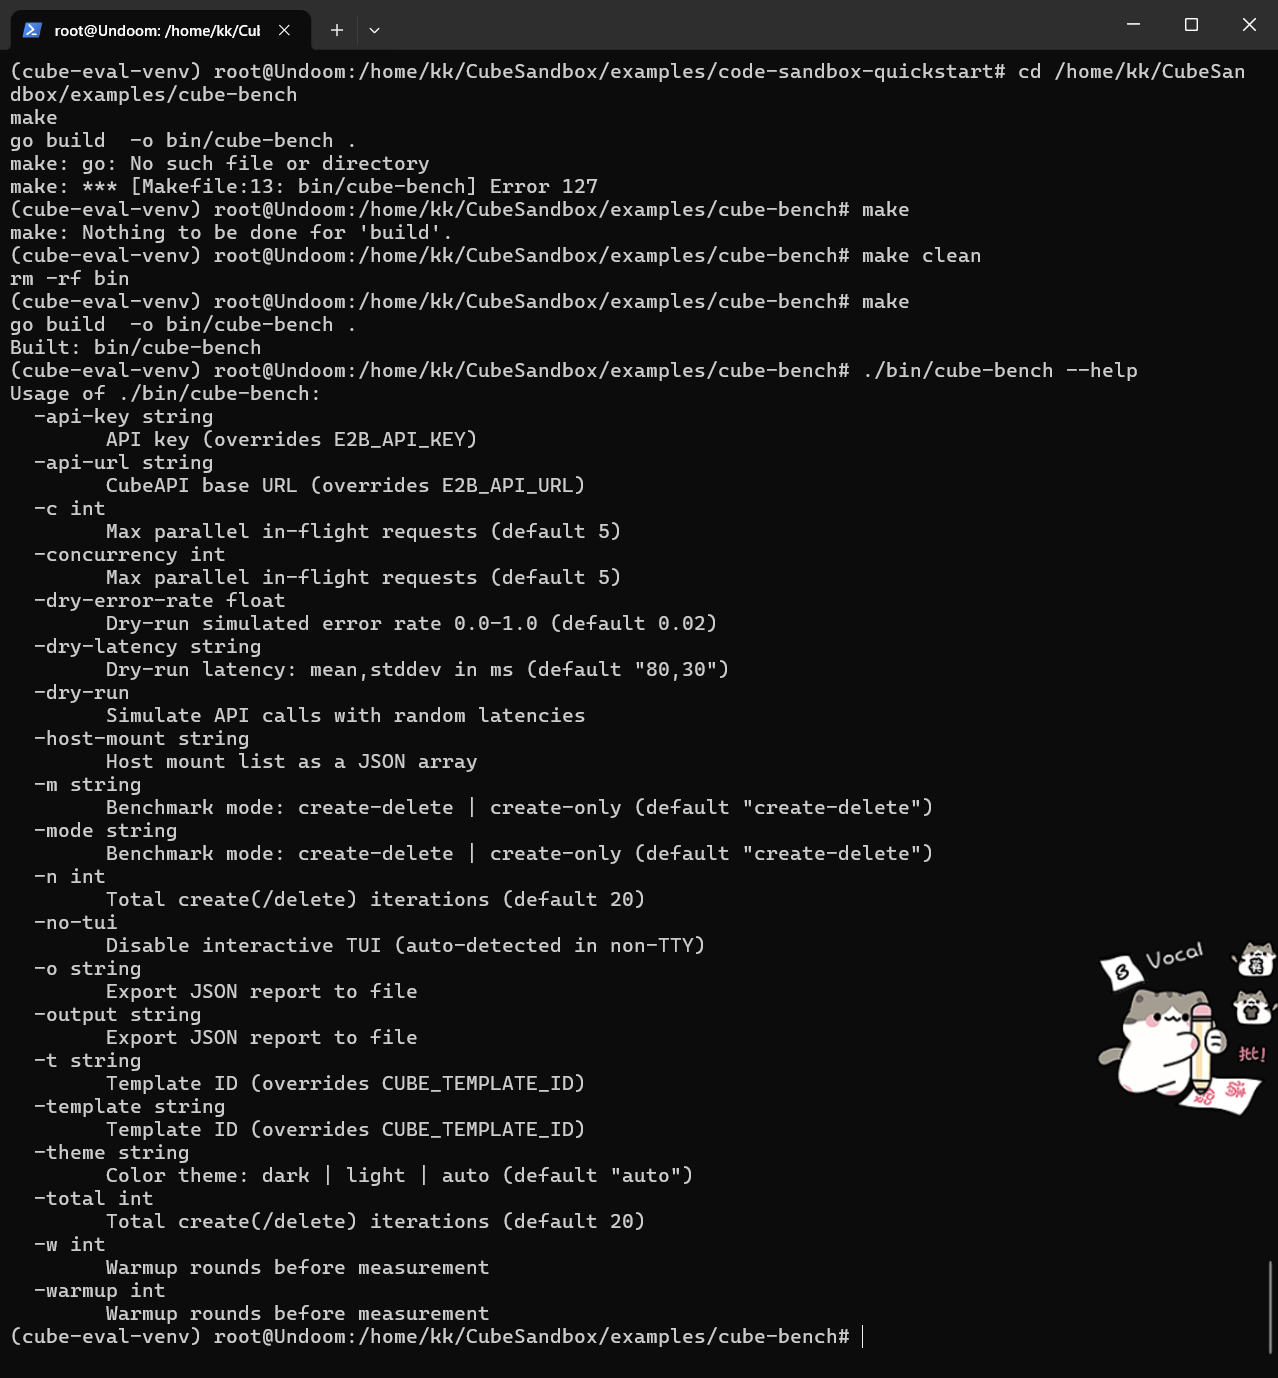
测试平台配置
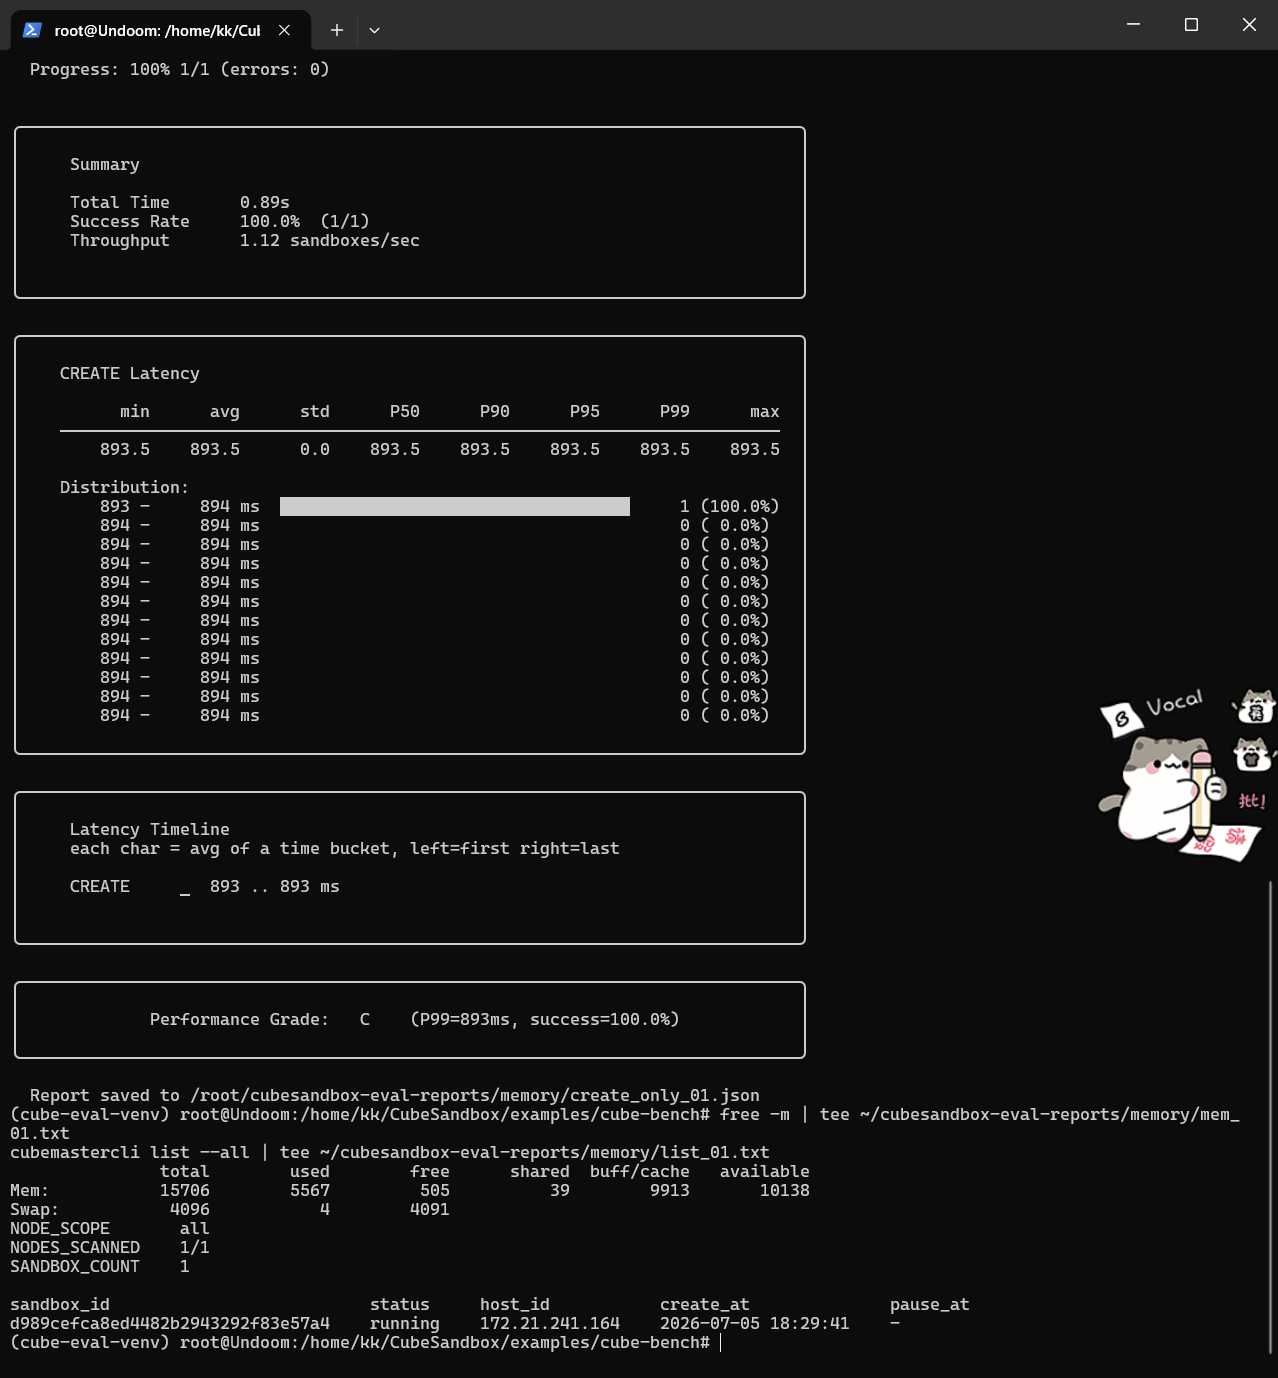
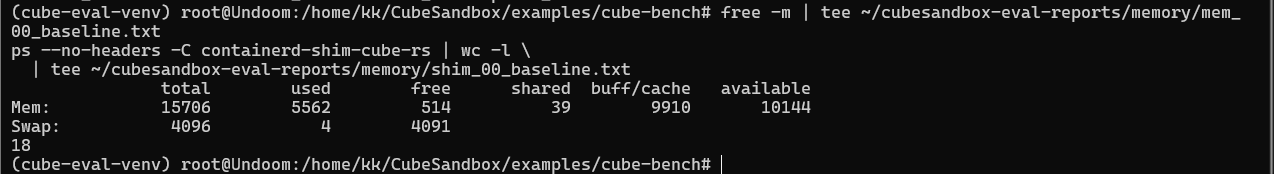
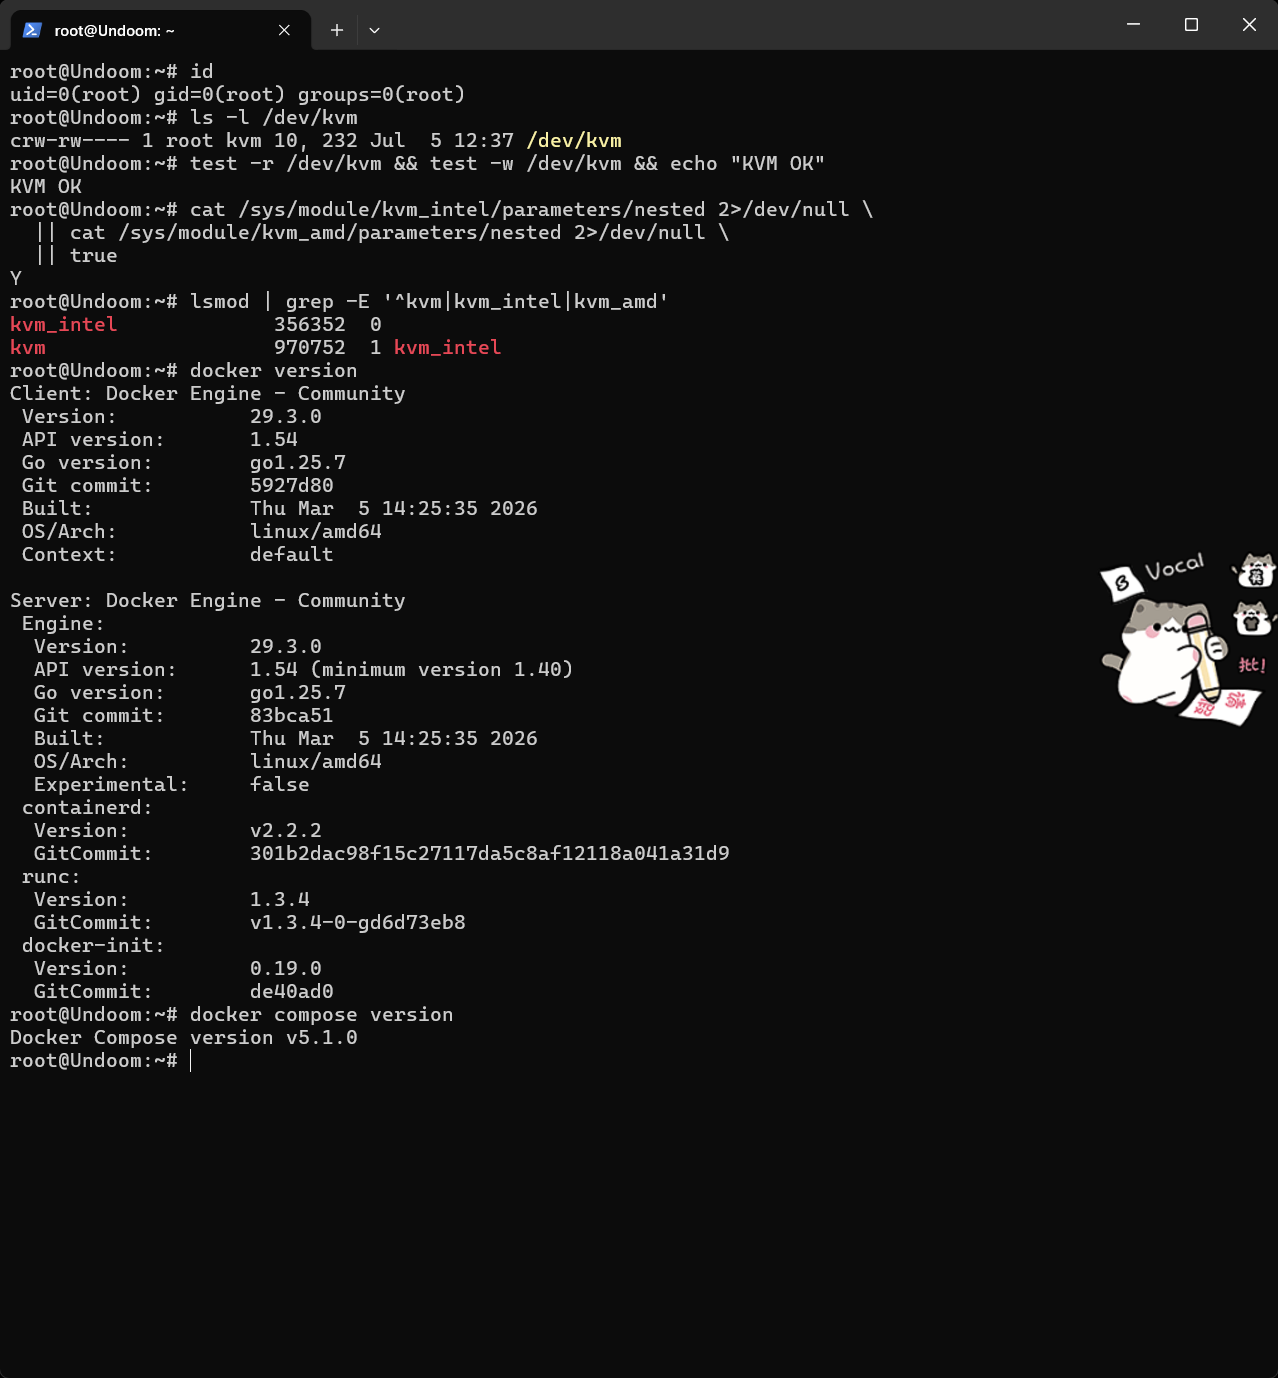
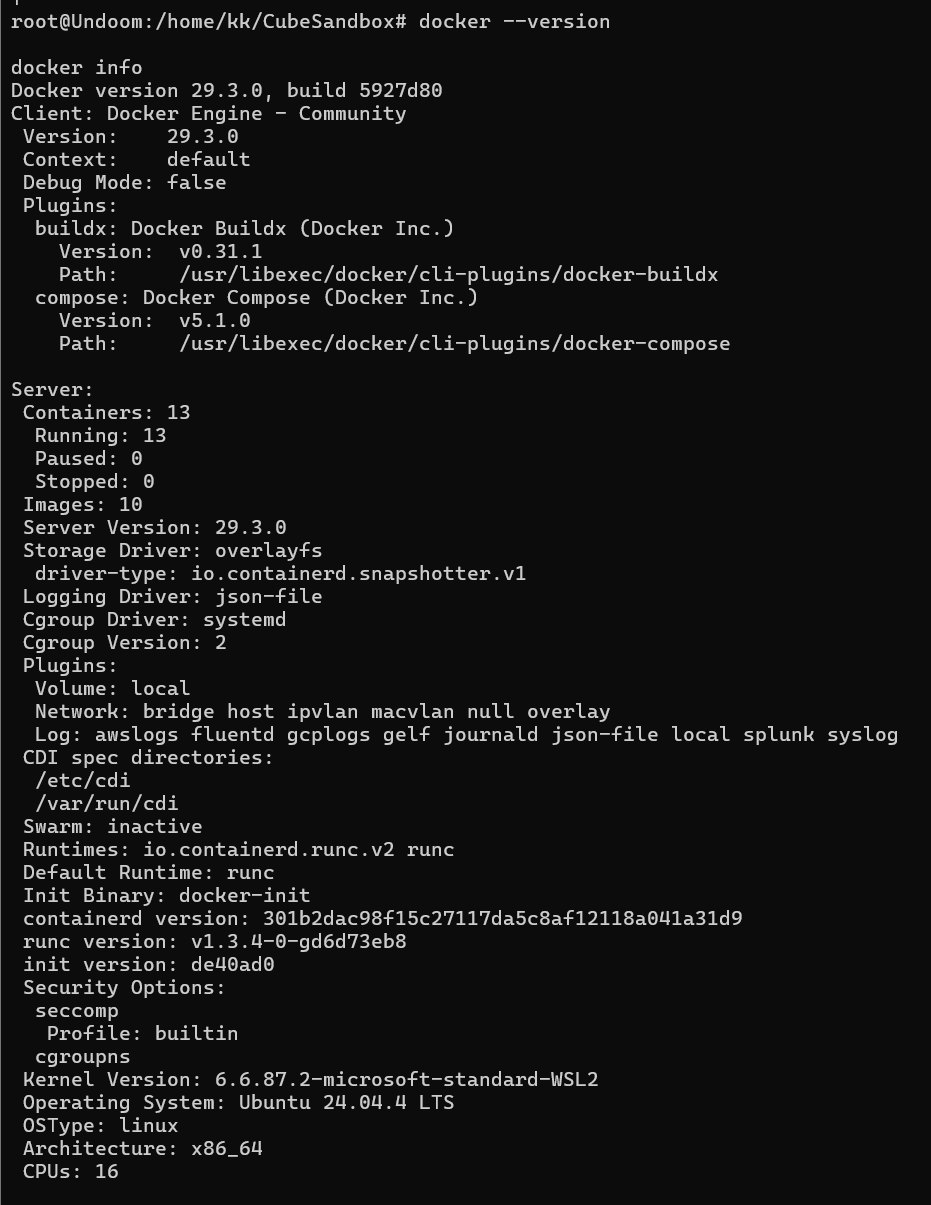
本地测试基于WSL2 Ubuntu 24.04环境(Intel Core Ultra 7 255H, 16vCPU, 15GB RAM),重点验证功能可行性。同时参考各方案官方在裸金属/PVM环境的基准数据,确保结论可靠性。
核心评测指标
- 冷启动延迟:从请求到代码可执行的时间
- 内存密度:单实例平均内存开销
- 状态操作性能:快照创建、克隆、回滚耗时
- 网络控制精度:策略生效层级与绕过难度
- 并发扩展性:高负载下的稳定性与吞吐量
CubeSandbox深度实测
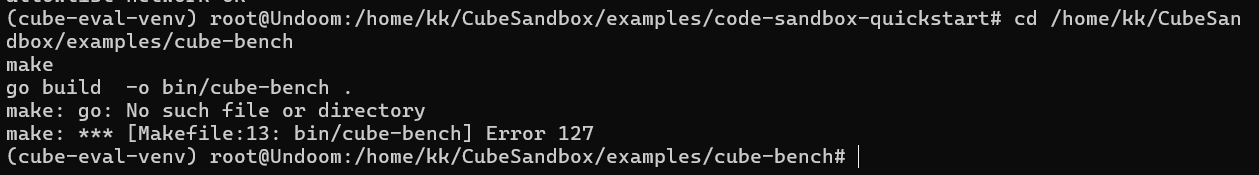
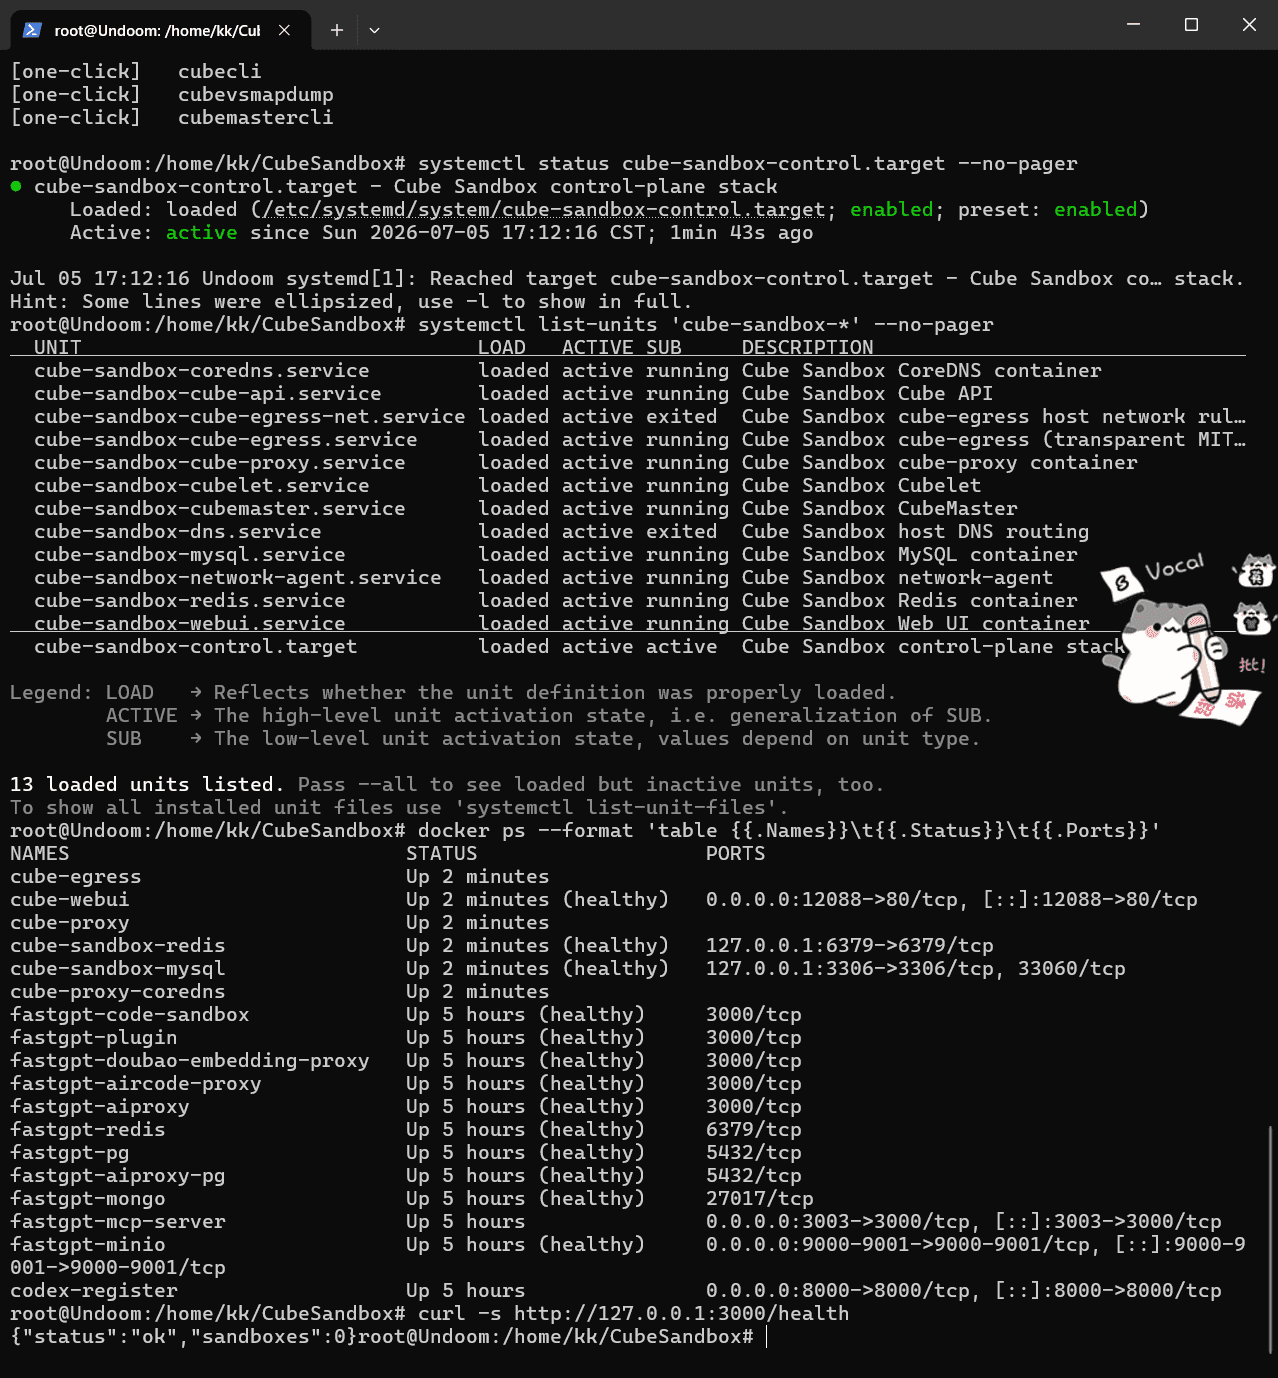
部署流程与关键依赖
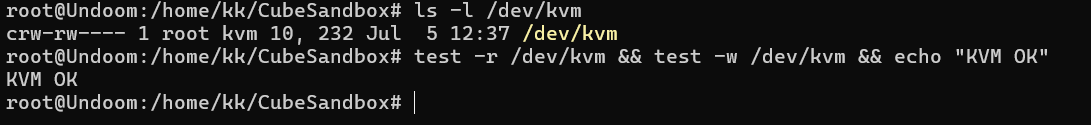
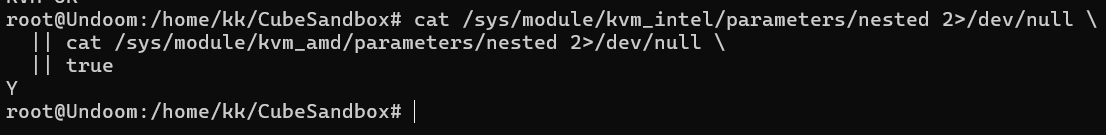
CubeSandbox部署需满足三个硬性条件:
- KVM支持:通过
/dev/kvm设备验证 - XFS文件系统:启用reflink特性实现CoW快照
- systemd管理:作为PID 1进程
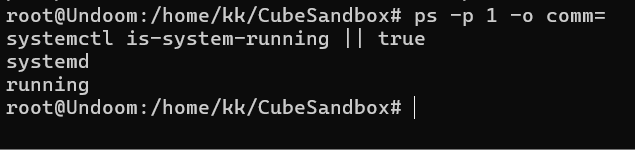
在WSL2中,需手动创建XFS loop设备:
sudo fallocate -l 80G /cubelet-xfs.img
sudo mkfs.xfs -f -m reflink=1 /cubelet-xfs.img
sudo mount -o loop,pquota /cubelet-xfs.img /data/cubelet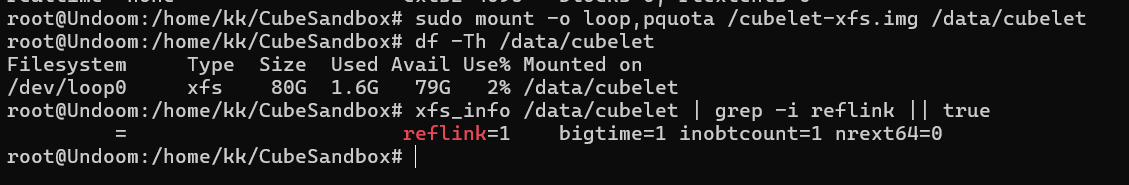
性能表现分析
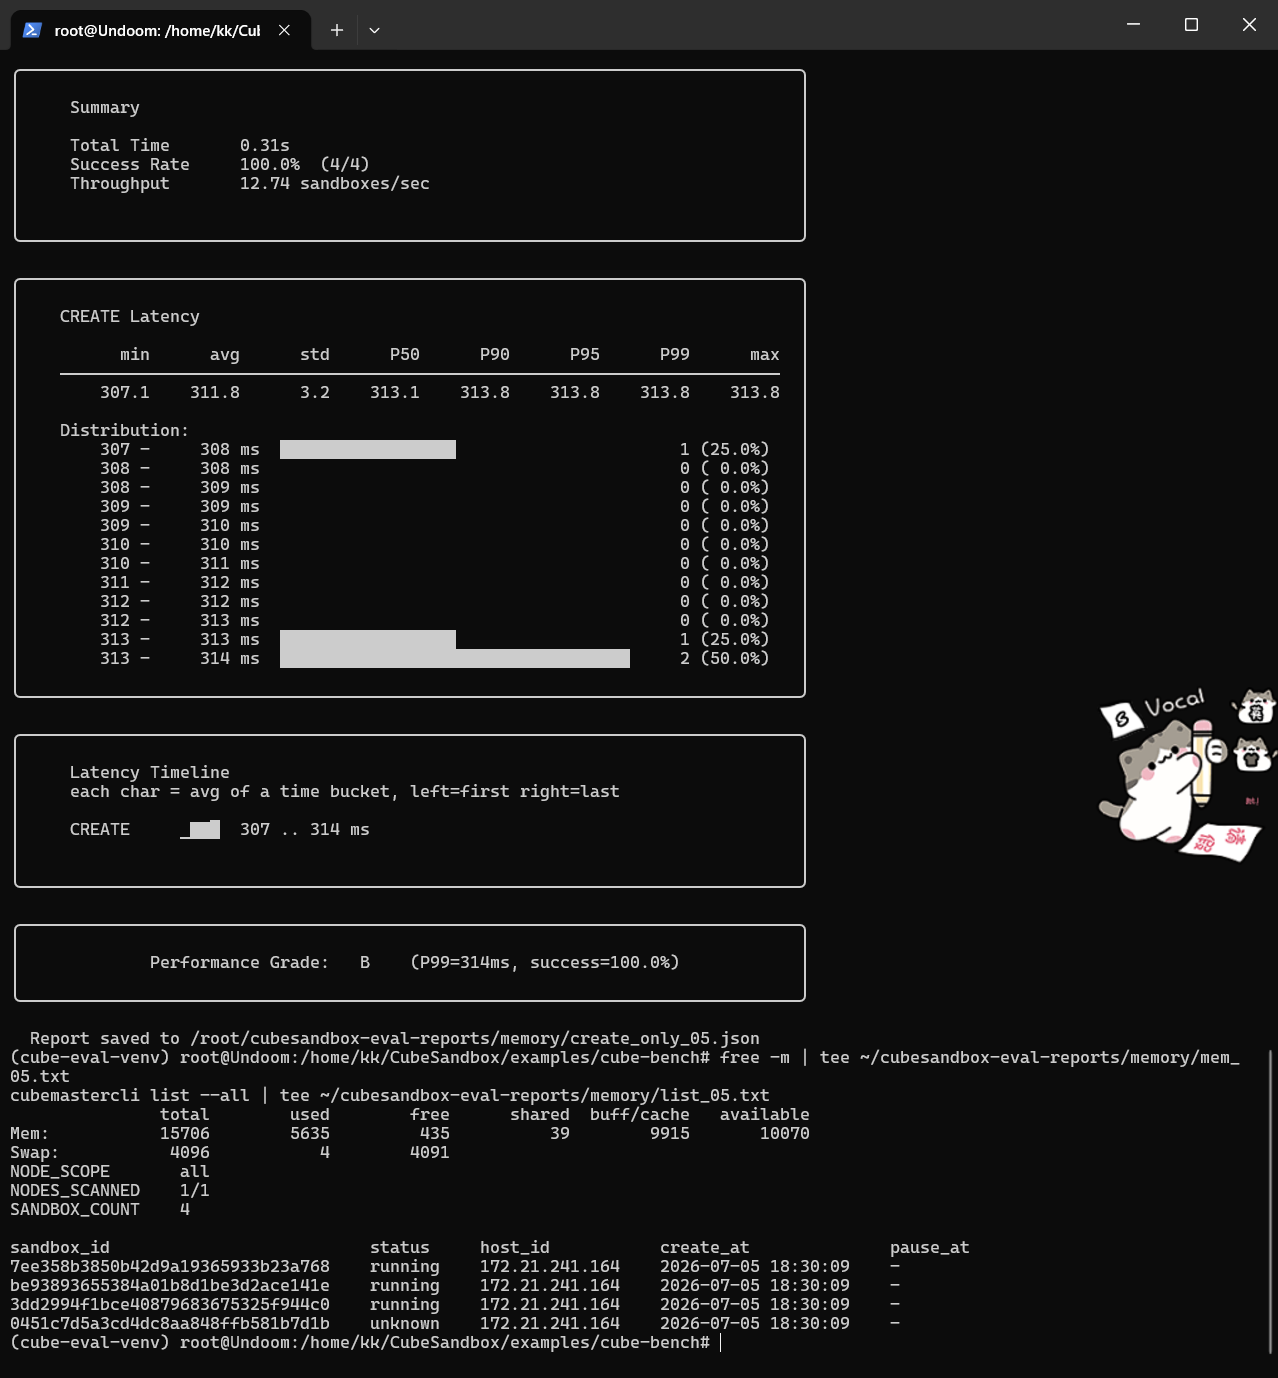
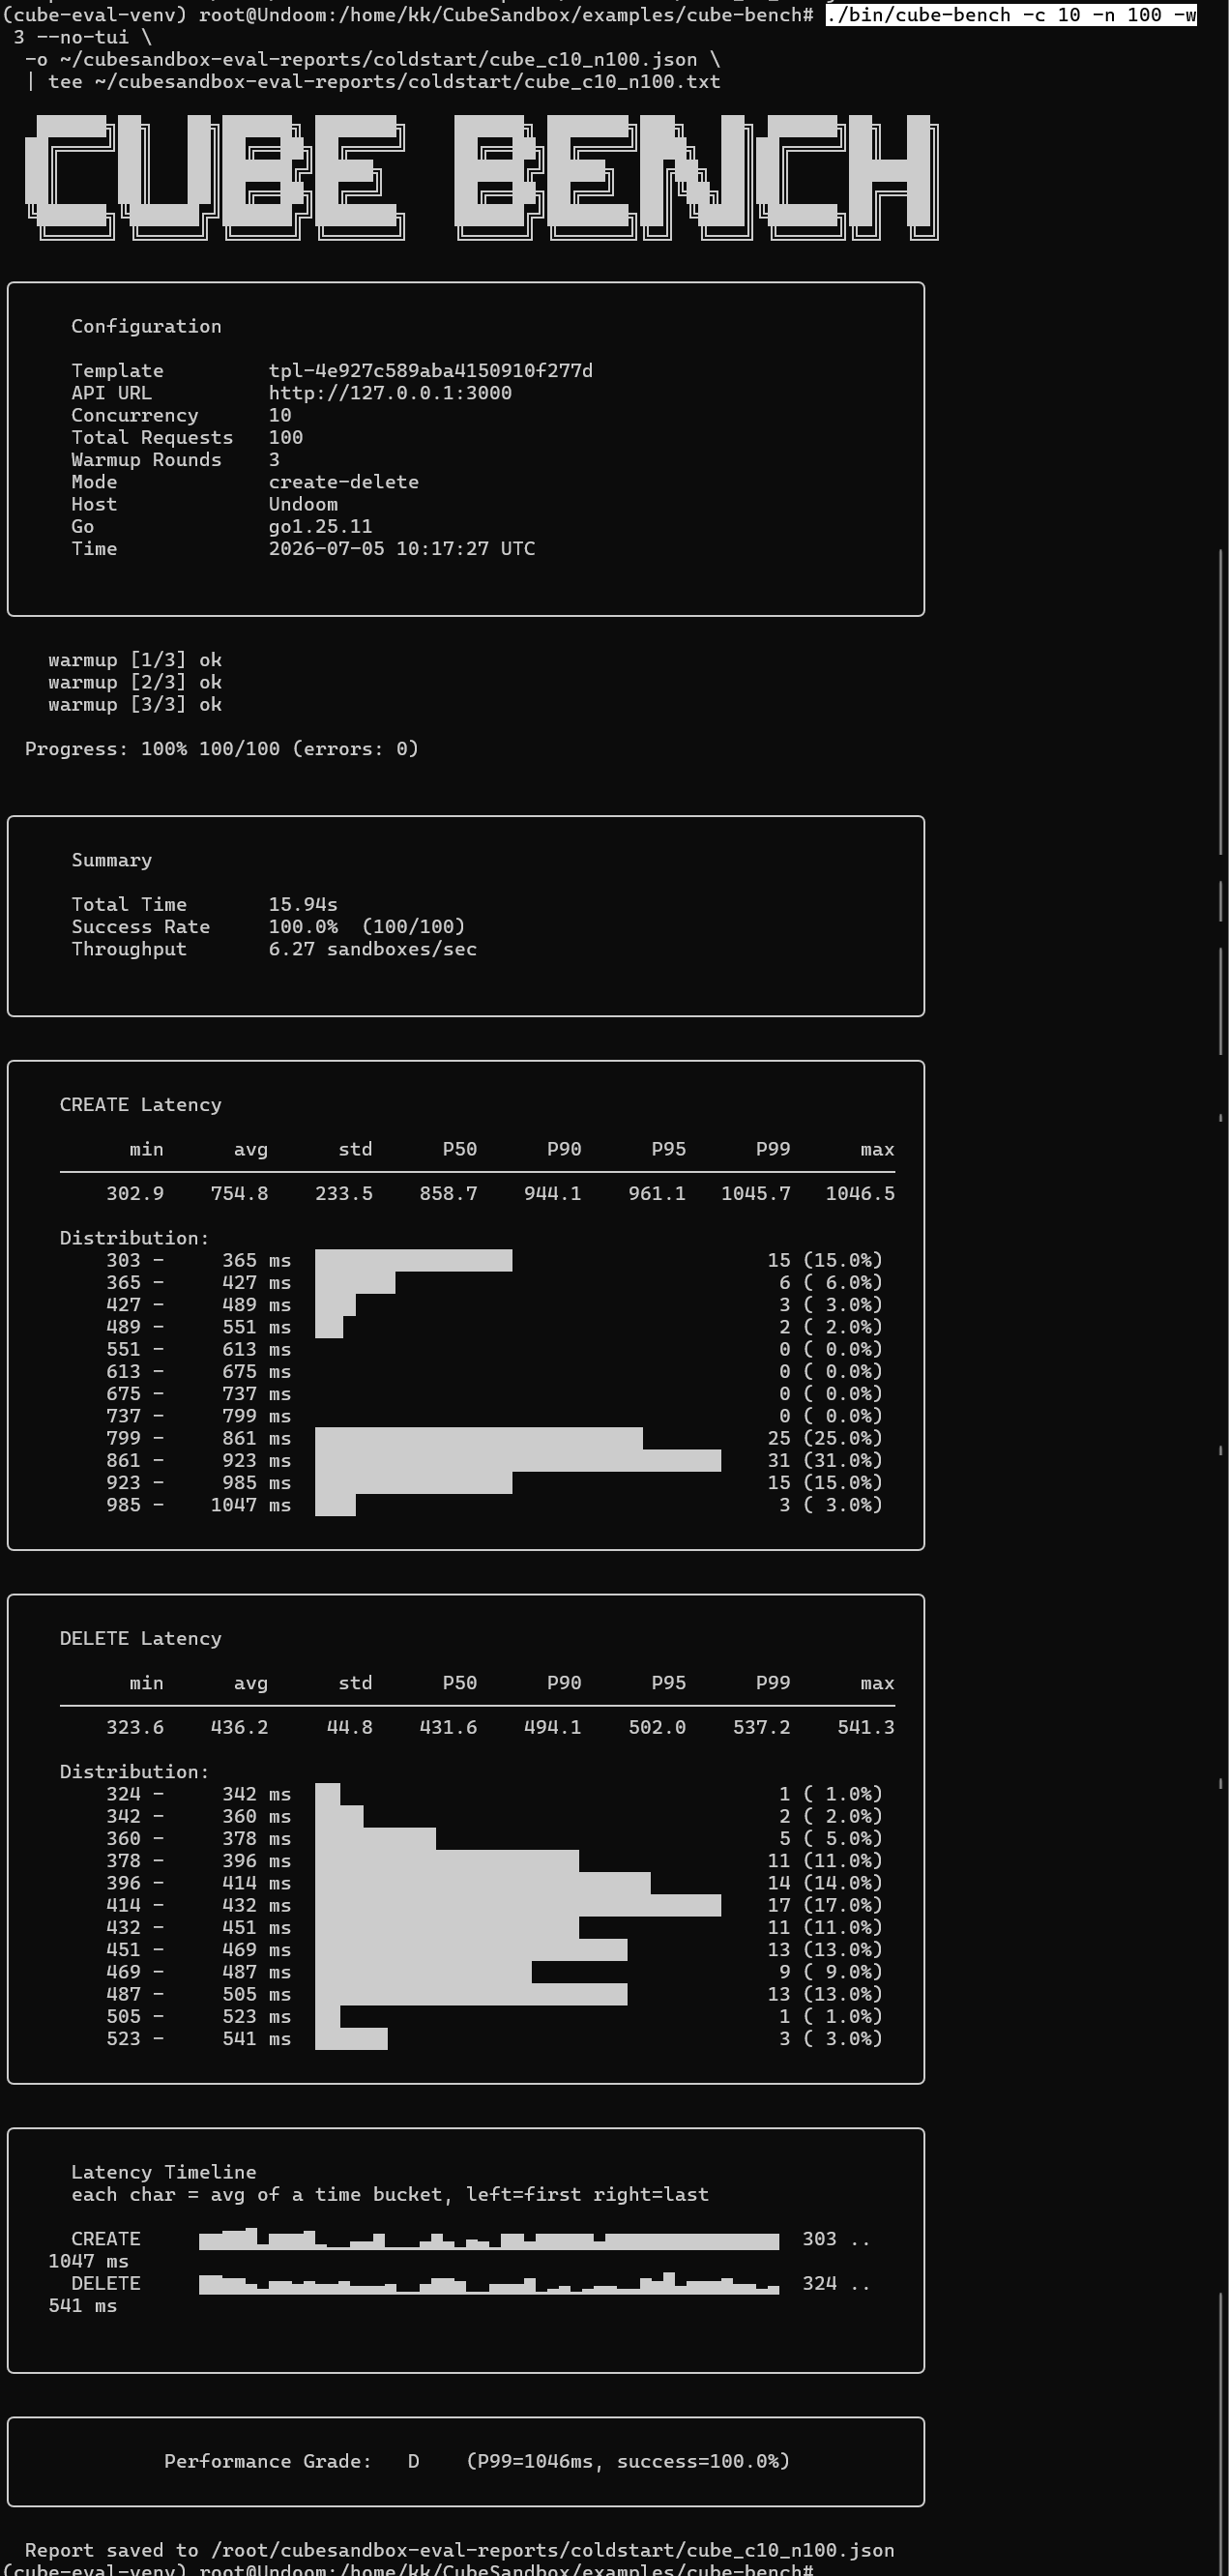
冷启动速度
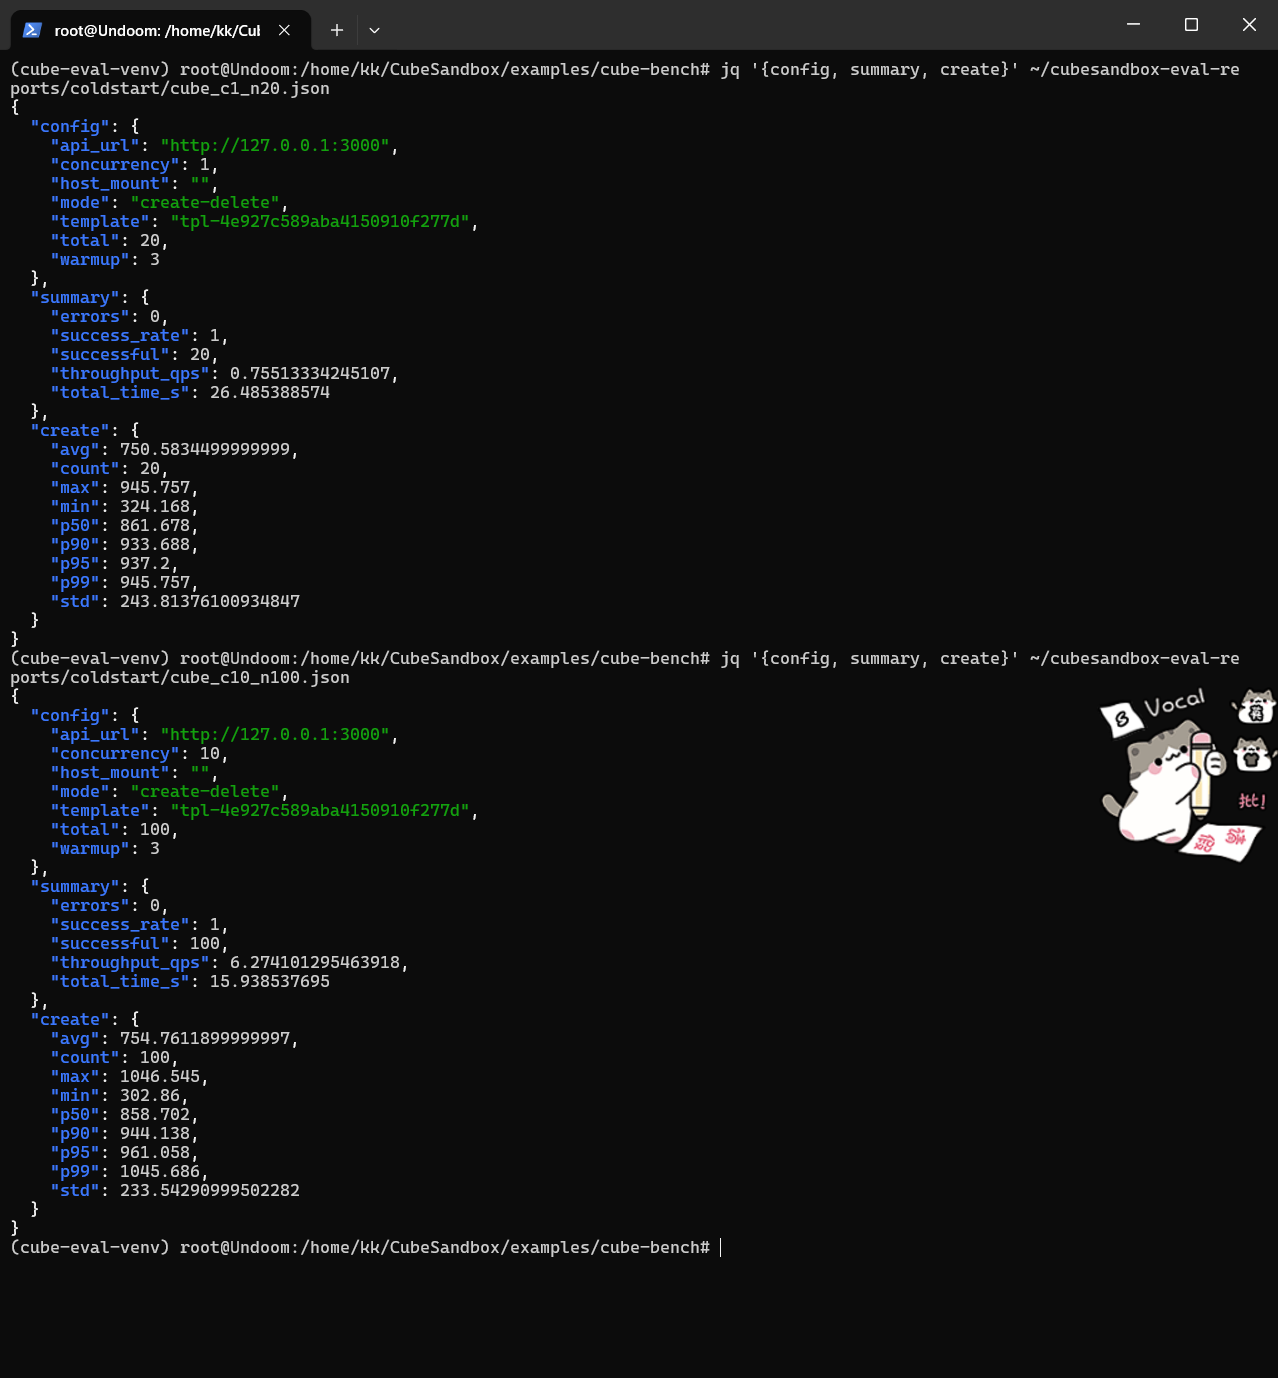
| 环境 | 单并发平均延迟 | 20并发吞吐 |
|---|---|---|
| WSL2本地 | 750ms | 未稳定测试 |
| 腾讯云BMI5裸金属 | 47.8ms | 180.9/s |
| SA9云主机 | 66.7ms | ~50/s |
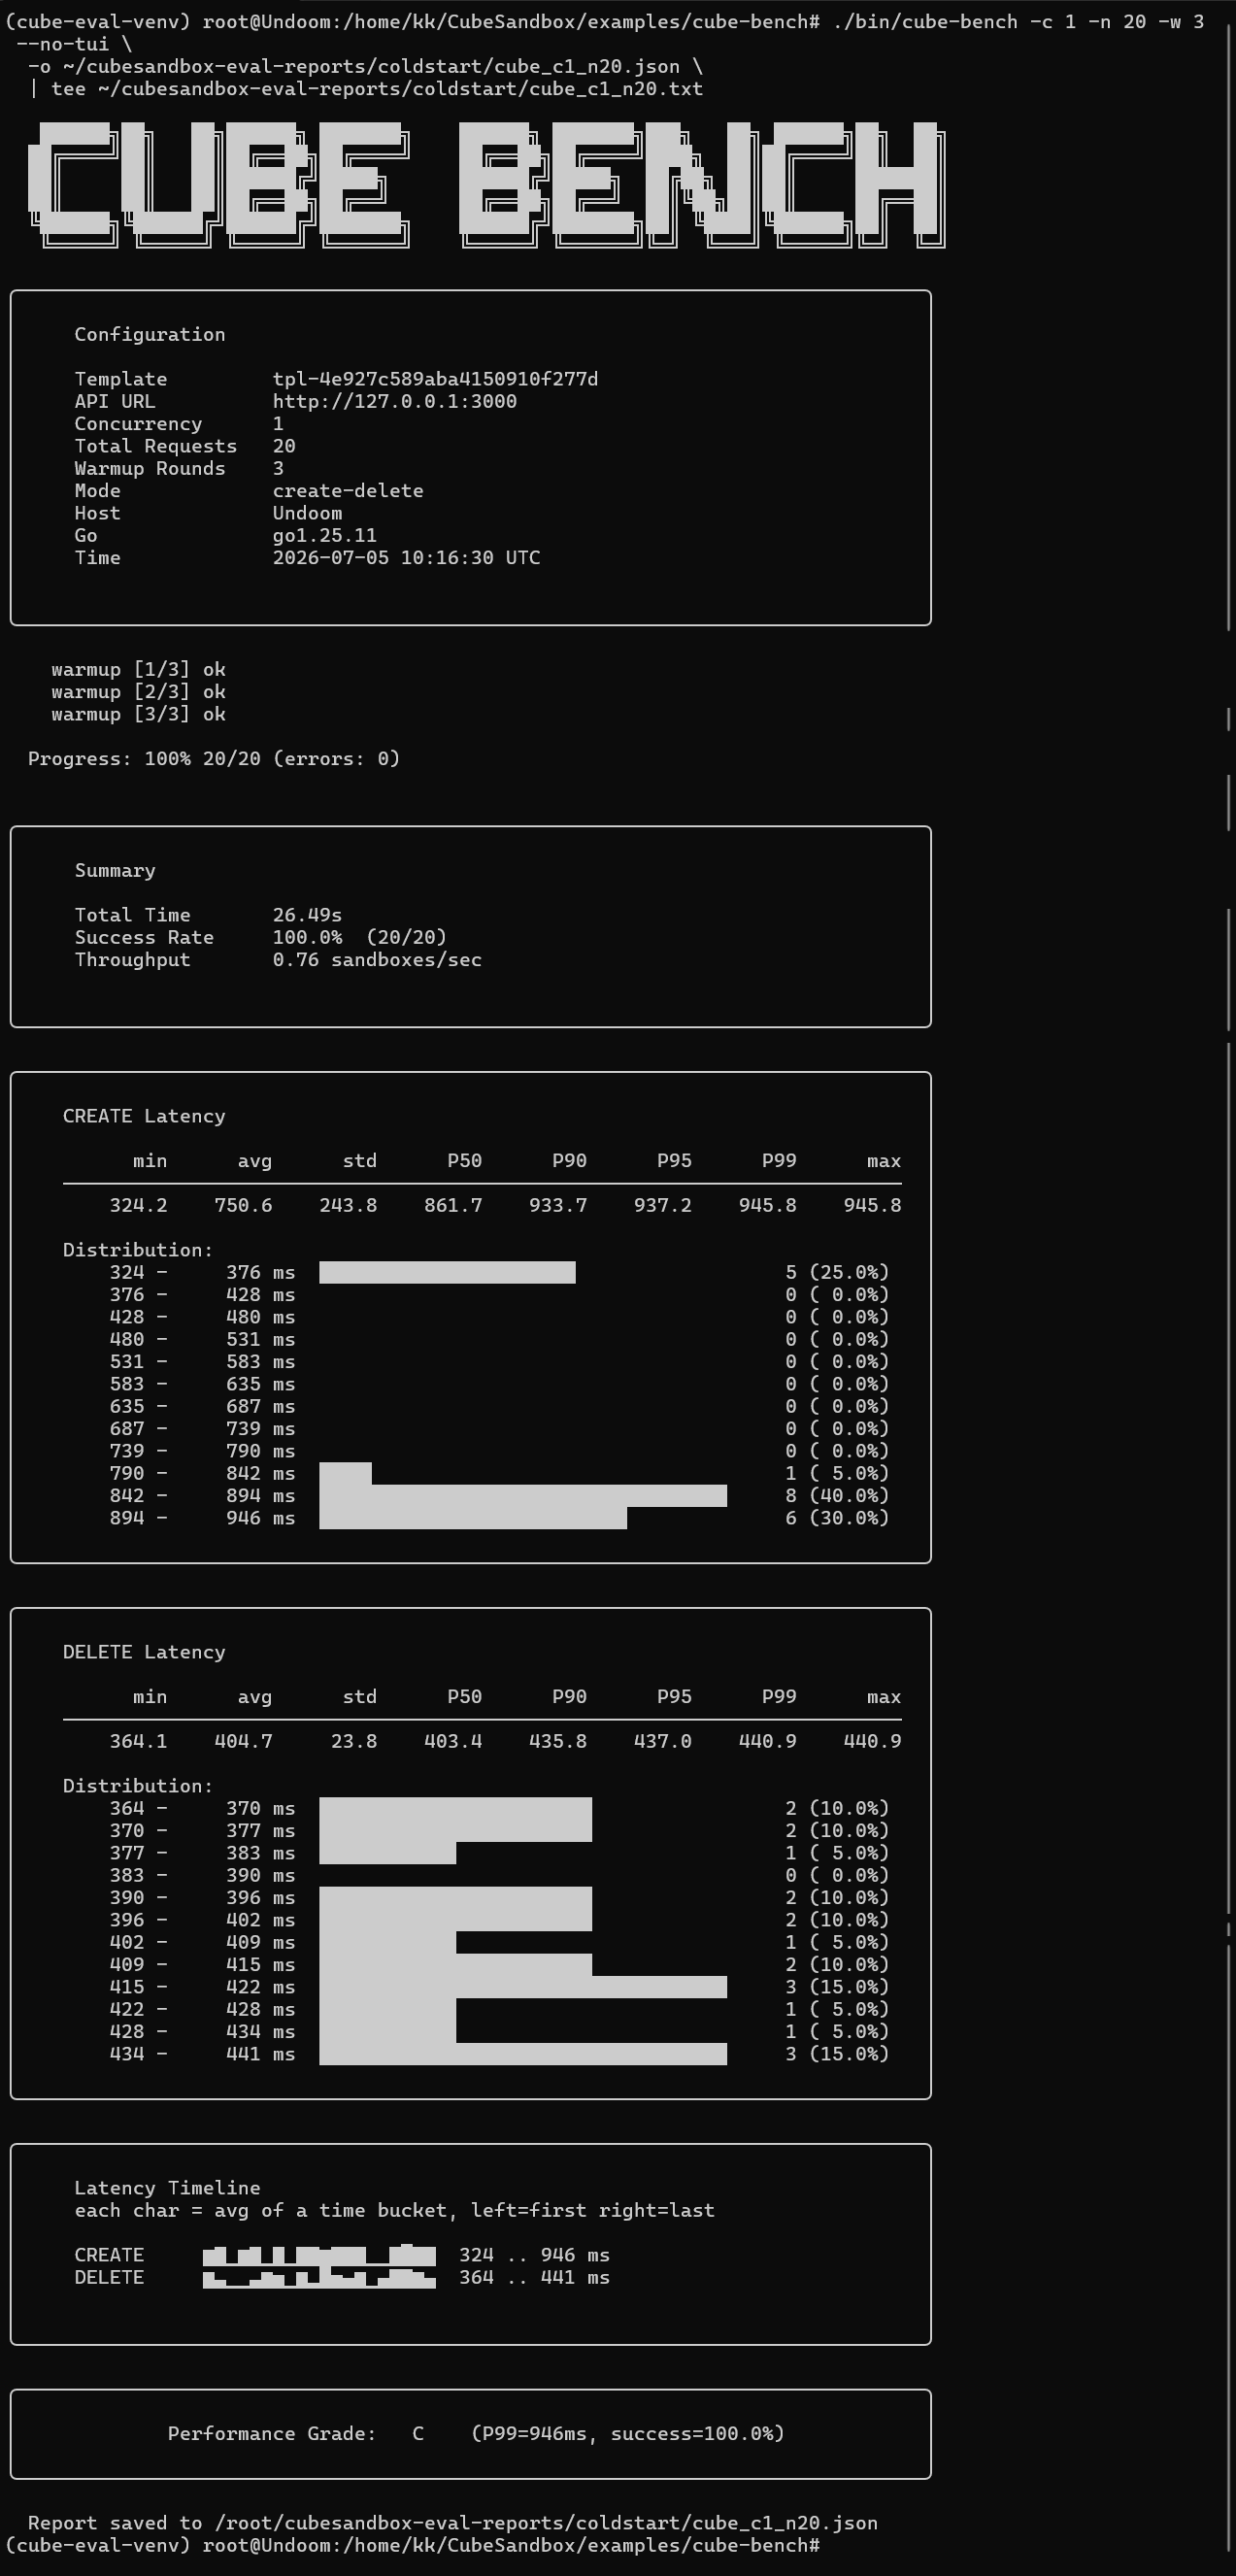
数据表明,CubeSandbox在合适硬件上可达真正毫秒级启动,WSL2的延迟主要源于Windows虚拟化开销。
内存密度
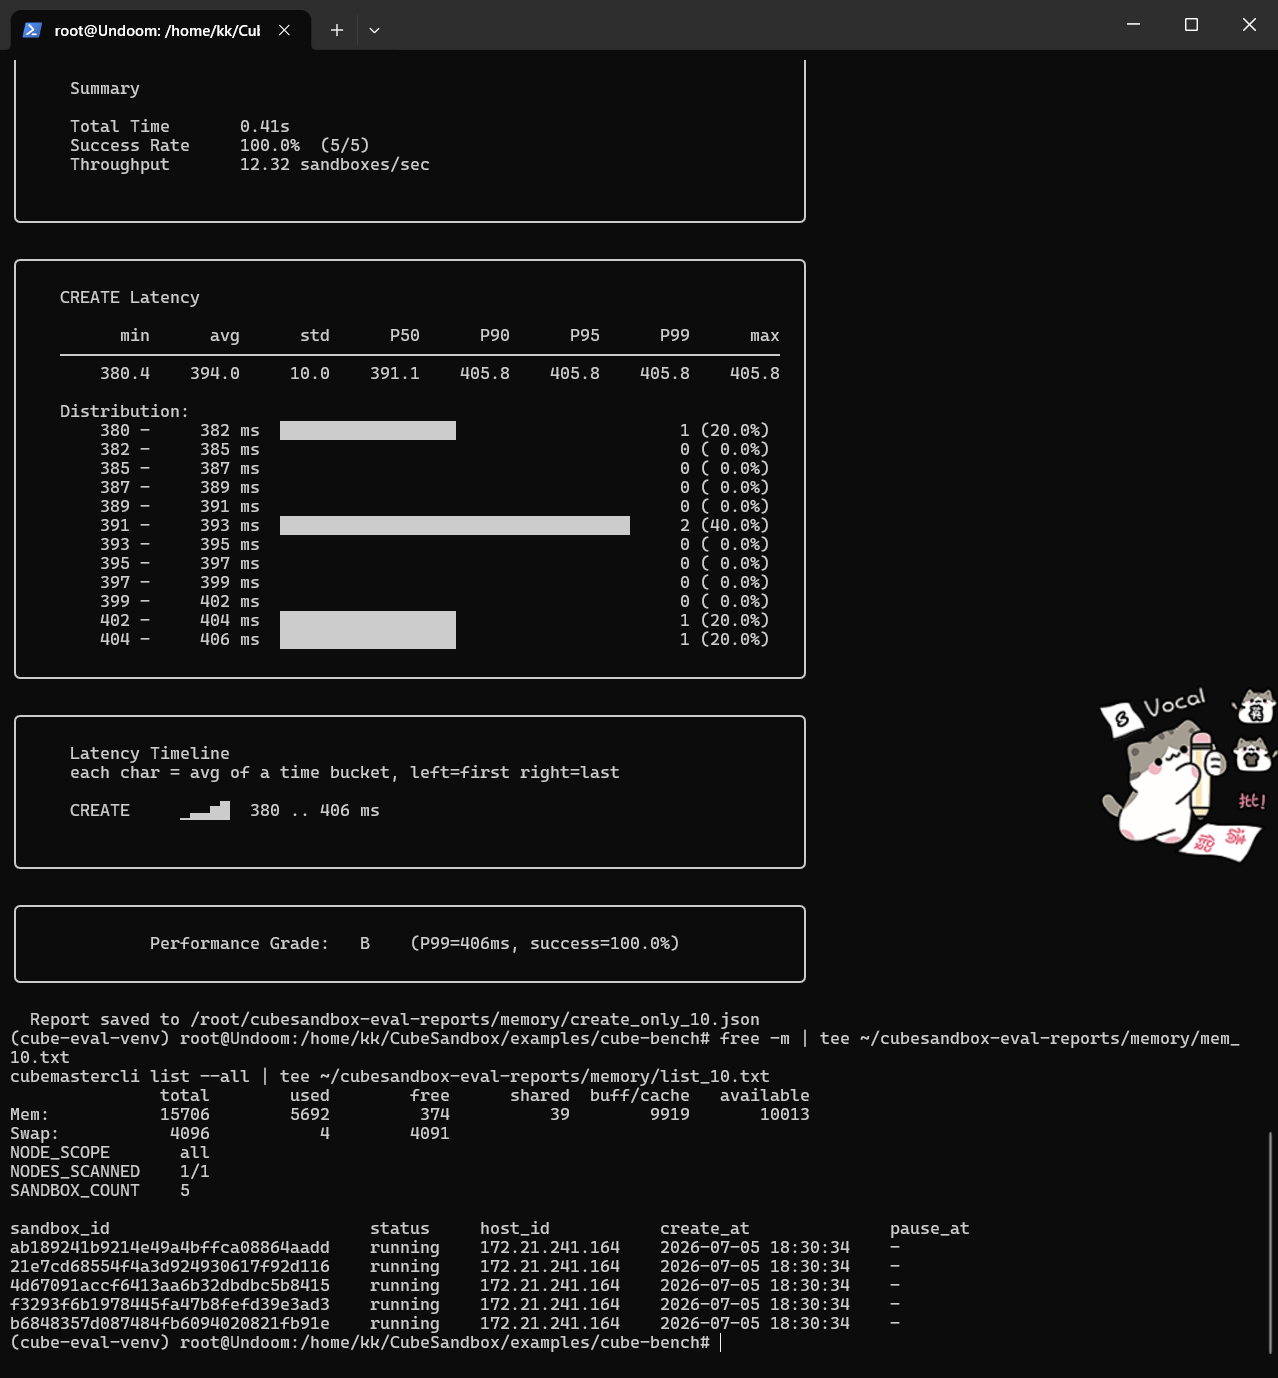
官方裸金属数据显示,1000个空闲沙箱摊销内存约25.7MB/实例,单机可承载700+实例。这显著优于传统VM(数百MB/实例),略高于Docker(~20MB/实例),但在安全隔离性上具有压倒性优势。
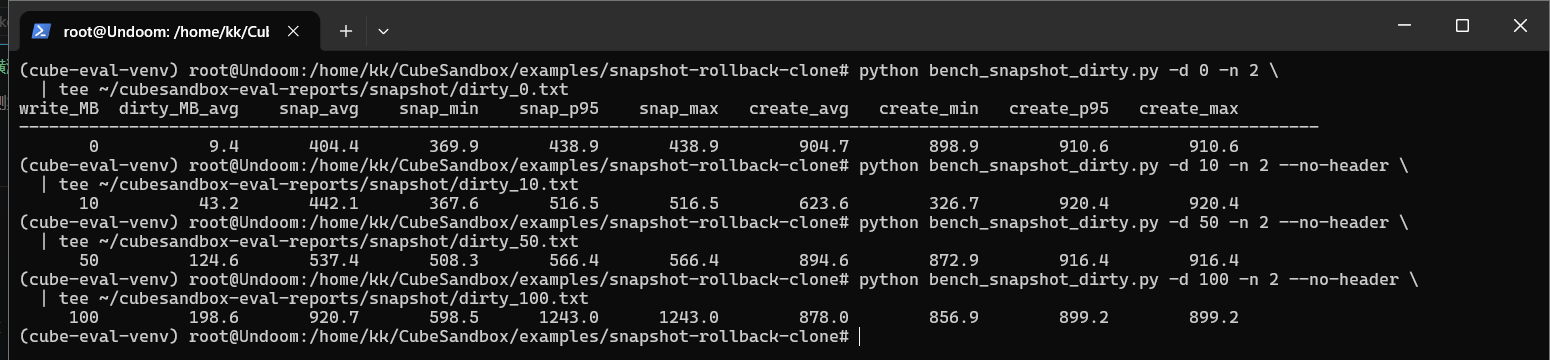
状态管理能力
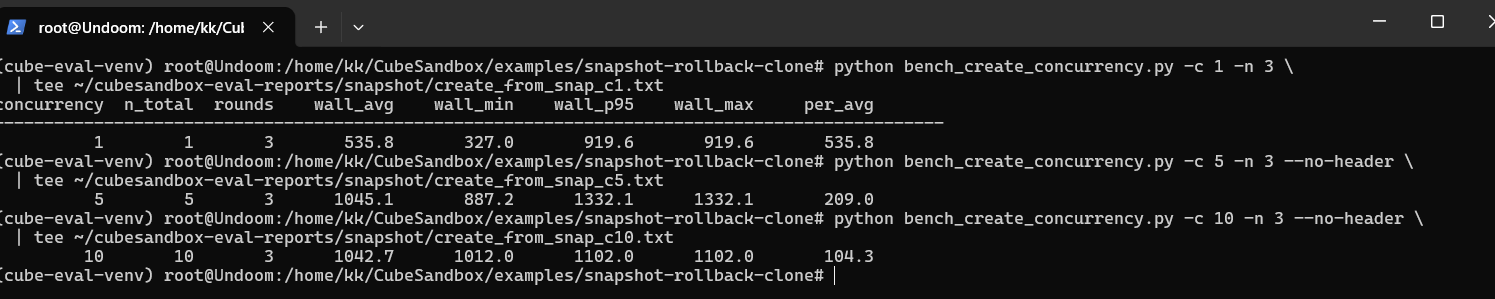
| 操作 | 裸金属单次耗时 | 高并发摊销 |
|---|---|---|
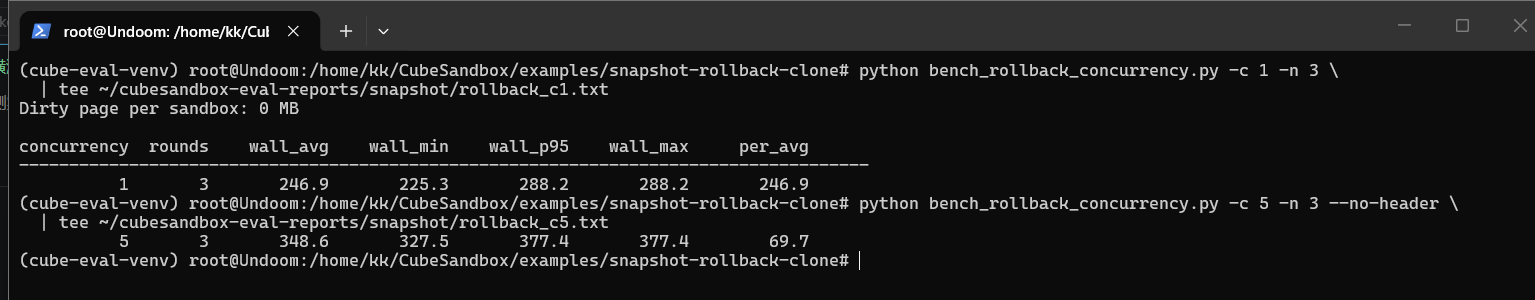
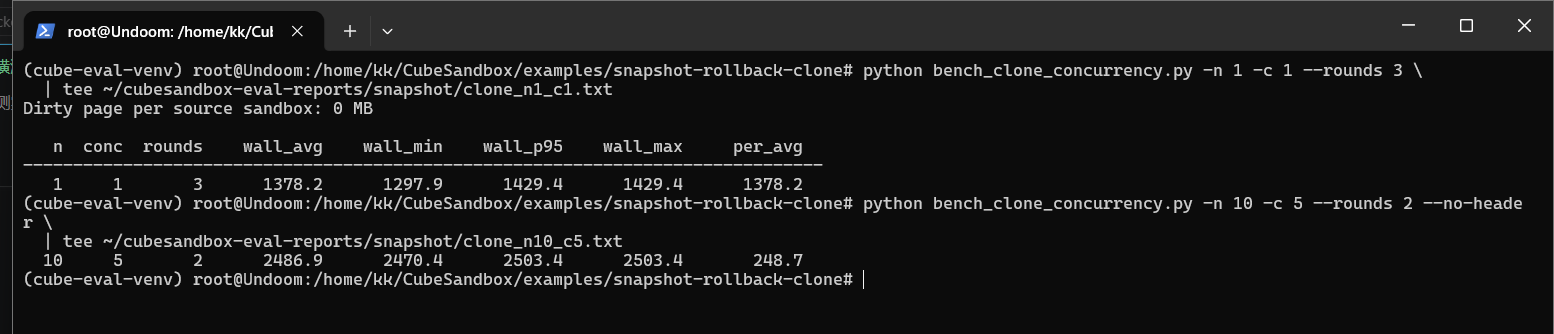
| Snapshot | 49.8ms | 10并发→12.7ms/snapshot |
| Clone(100个) | 219.6ms/个 | 50并发→5.4ms/clone |
| Rollback | 81.6ms | 10并发→26.6ms/rollback |
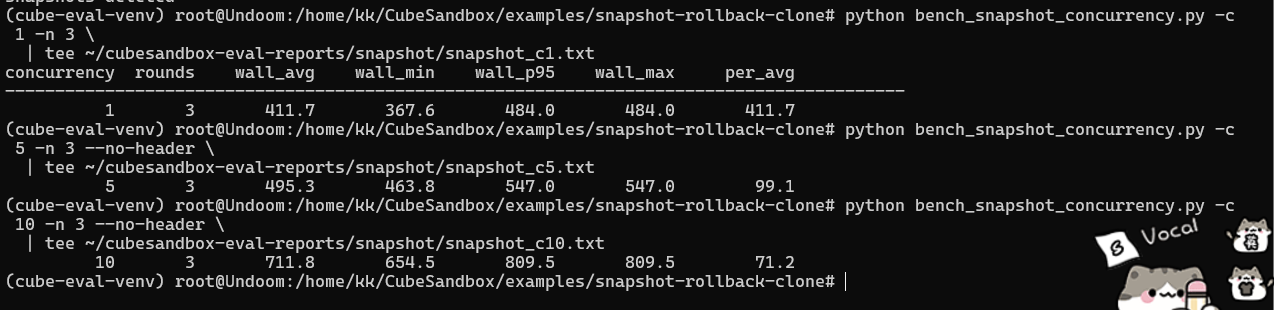
高并发下克隆操作的极低摊销成本,使其特别适合Agent并行试错场景。
对比方案实测结果
Docker:轻量但隔离有限
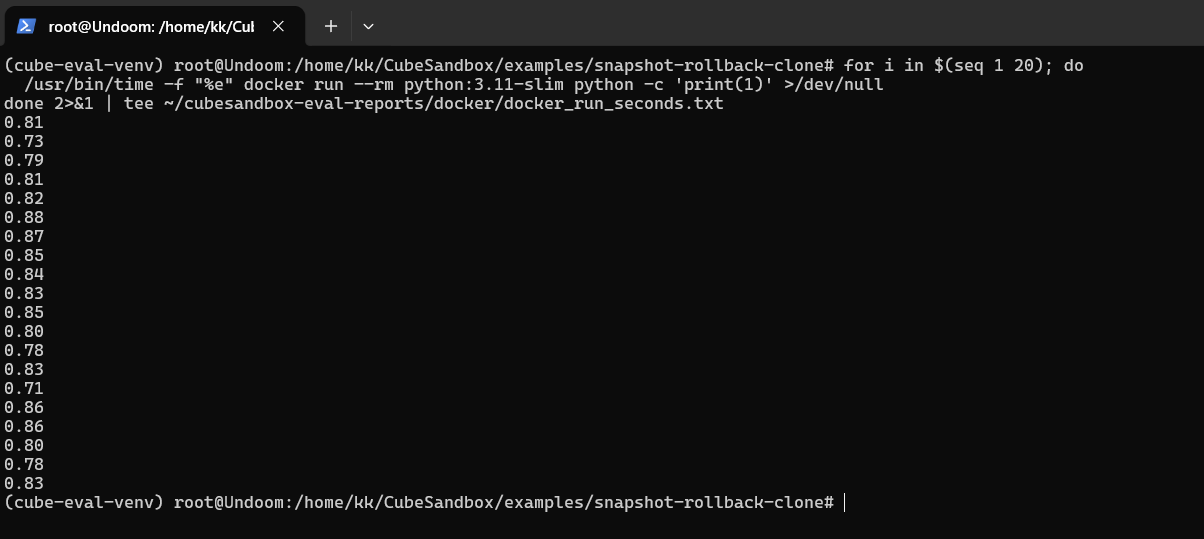
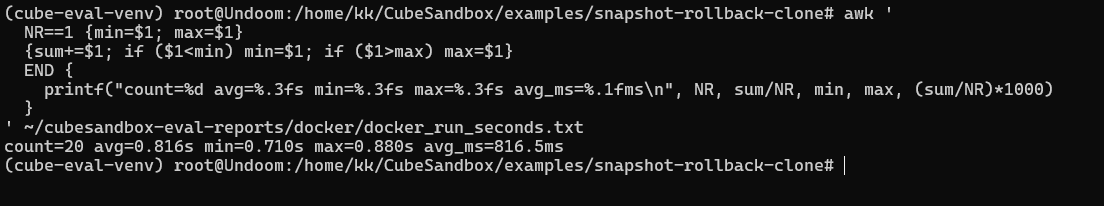
在相同WSL2环境下,Docker启动Python容器平均耗时794ms,与CubeSandbox(750ms)相当。但关键差异在于:
- 隔离强度:共享内核存在理论逃逸风险
- 状态管理:不支持运行时快照
- 网络控制:需额外配置iptables规则
适用于可信脚本执行,但不适合处理AI生成的不可信代码。
E2B与Daytona:托管服务的便利与局限
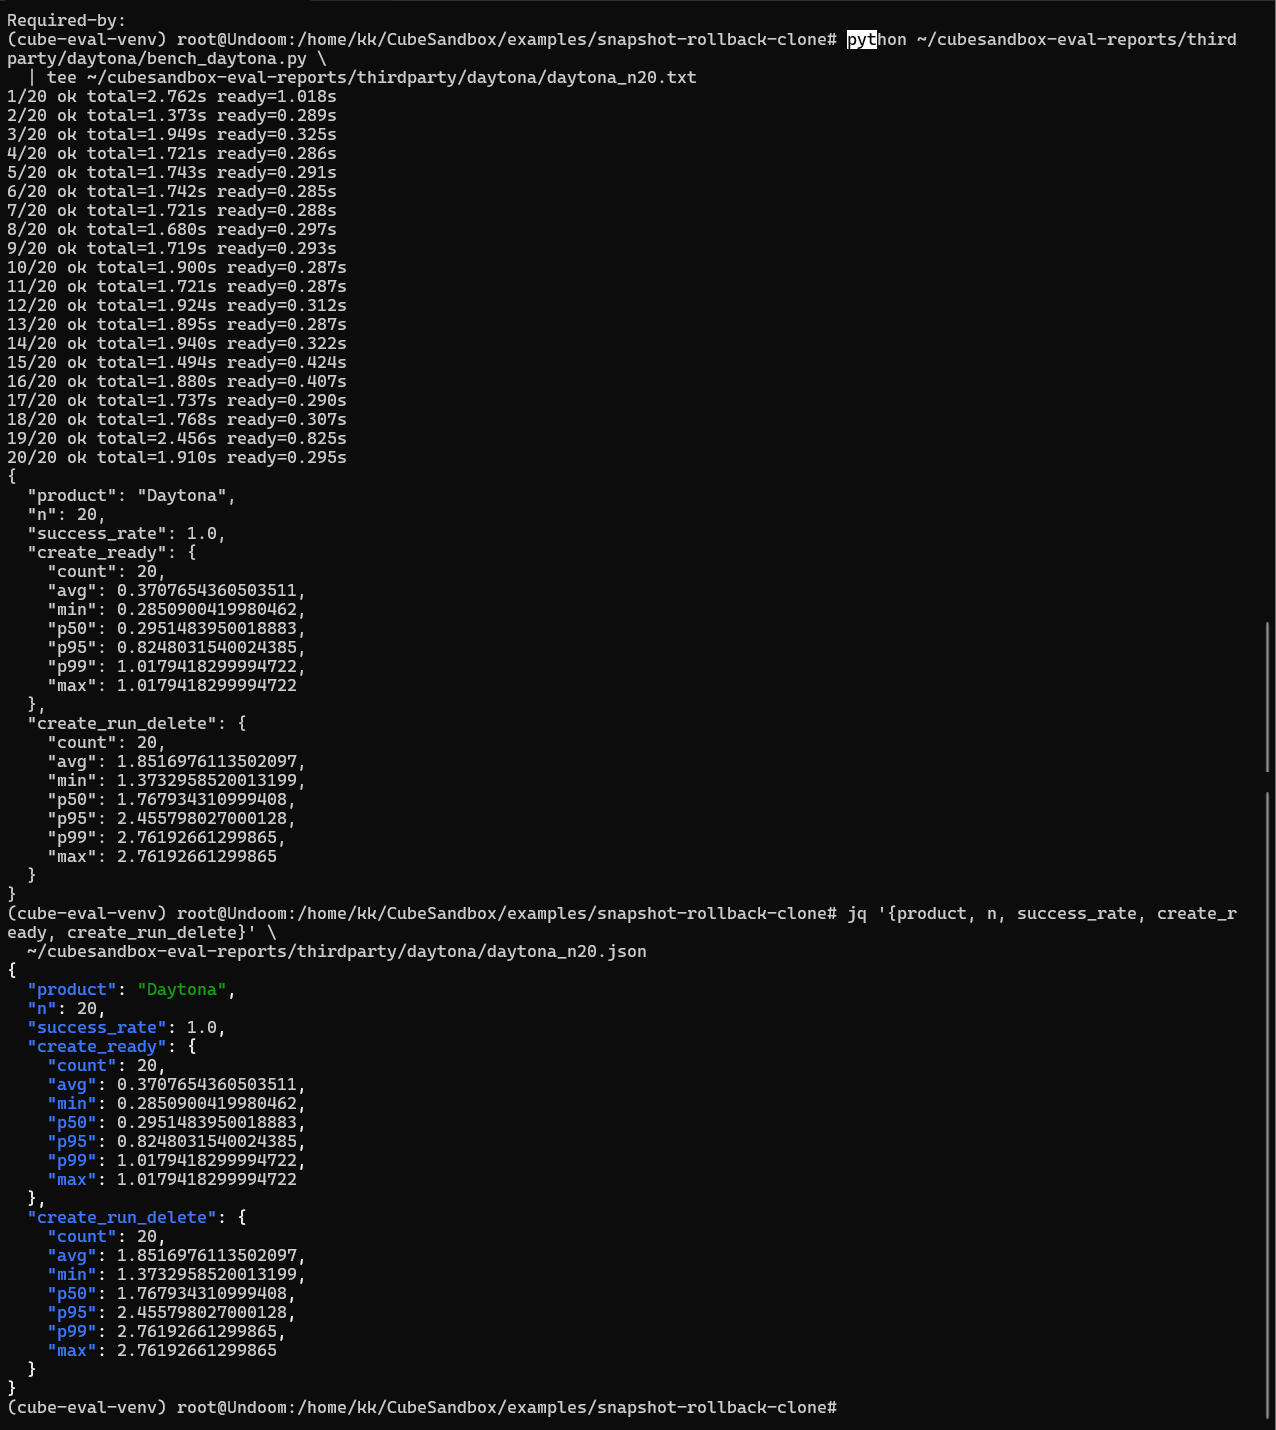
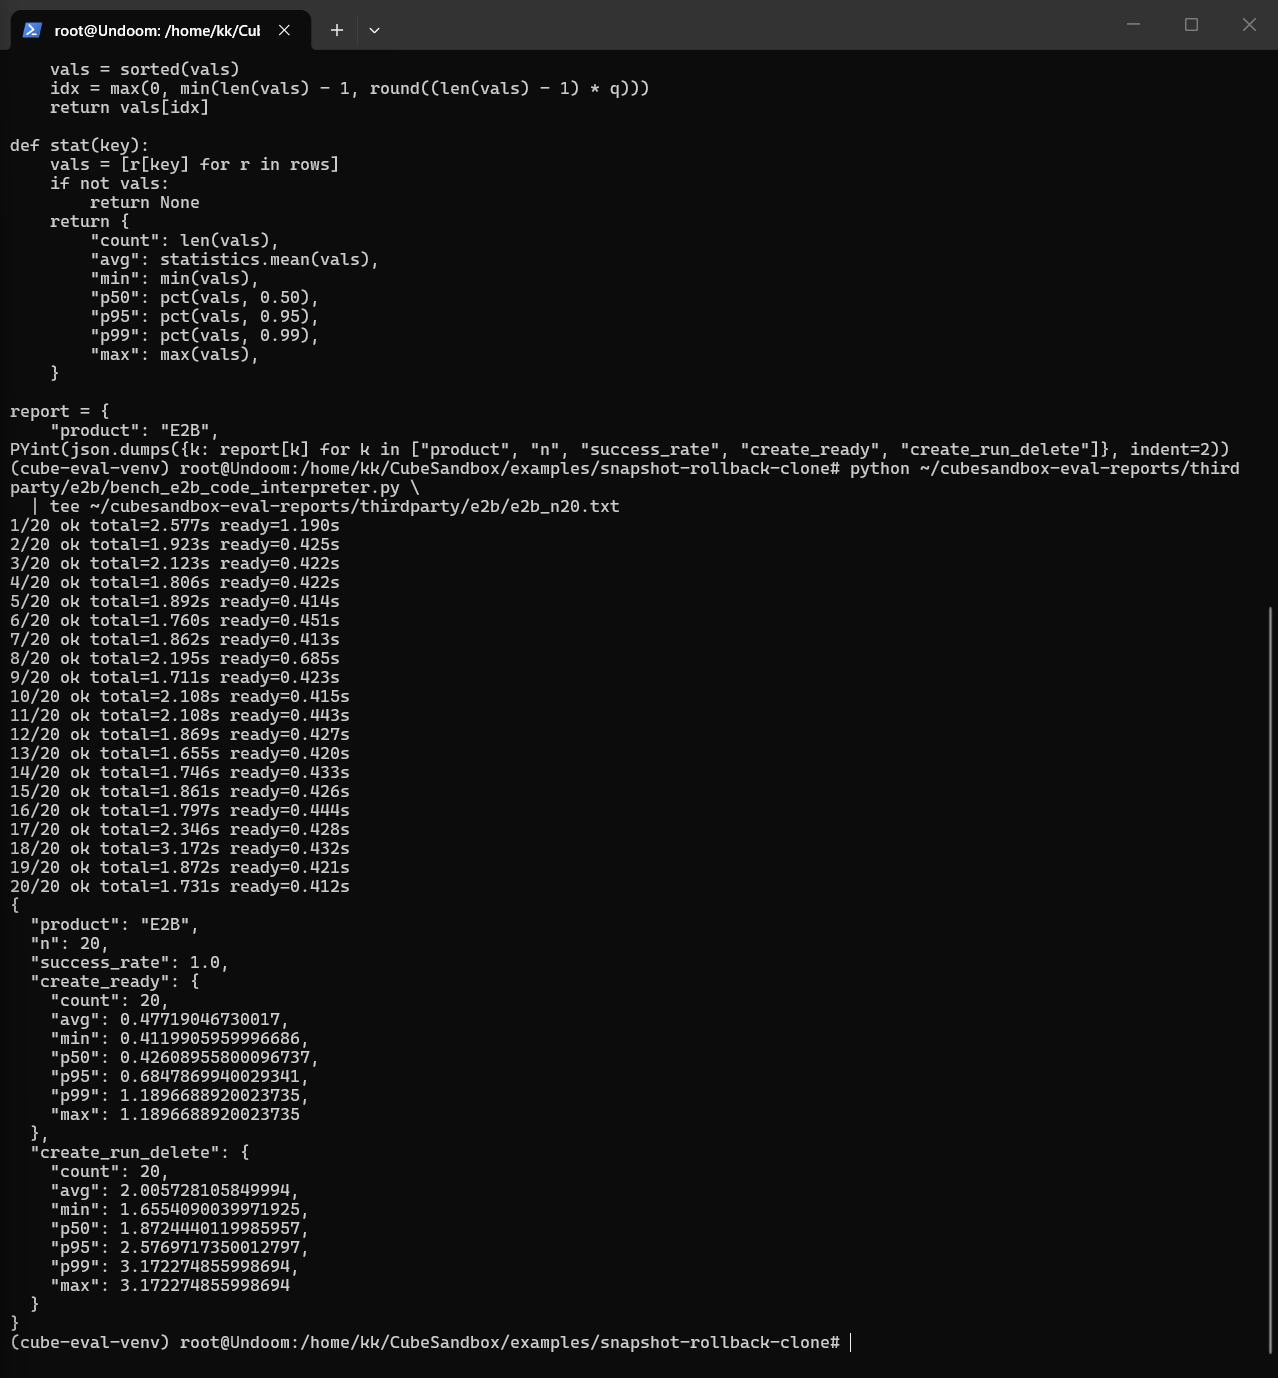
实测显示,E2B端到端延迟约2-5秒(含网络传输)。其优势在于:
- 零运维:无需关心底层基础设施
- 快速集成:标准SDK开箱即用
但存在明显短板:
- 数据出境:代码需经第三方服务器
- 定制受限:无法修改底层行为
- 成本不可控:按调用量计费
传统VM:安全但笨重
QEMU/KVM完整虚拟机提供最强隔离,但启动时间通常2-10秒,内存开销达数百MB至数GB,完全无法满足Agent高频短任务需求。
综合选型指南
场景化推荐矩阵
| 业务场景 | 推荐方案 | 关键理由 |
|---|---|---|
| 可信脚本执行 | Docker | 生态成熟,资源开销最小 |
| 快速原型验证 | E2B/Daytona | 免运维,API即服务 |
| 合规内网部署 | CubeSandbox | 自托管+强隔离+数据不出域 |
| AI多分支试错 | CubeSandbox | 快照/克隆能力提升10倍+效率 |
| 极致安全要求 | CubeSandbox>传统VM | 平衡隔离强度与性能 |
CubeSandbox适用边界
尽管优势显著,CubeSandbox仍有明确适用边界:
- 部署门槛:需KVM/XFS支持,不适合纯容器环境
- 生态成熟度:相比Docker十年积累仍处早期
- 长时任务:定位临时执行环境,非长期服务容器
架构设计亮点剖析
KVM MicroVM的战略选择
放弃容器路线而选择MicroVM,体现了对安全隔离的极致追求。独立内核设计从根本上规避了容器逃逸风险,为不可信代码执行建立可靠防线。
E2B SDK兼容的生态智慧
通过兼容E2B接口协议,CubeSandbox实现了零代码迁移——用户只需修改API地址即可切换。这极大降低了 adoption barrier,加速生态整合。
内置网络策略引擎
CubeVS虚拟交换机与CubeEgress代理的组合,在tap设备层实现网络控制,确保沙箱内代码无法绕过策略。支持:
- 完全断网模式
- 精细化白名单/黑名单
- 凭据注入(避免明文密钥暴露)
结论:安全与效率的再平衡
AI Agent的普及将不可信代码执行从边缘需求变为基础设施标配。本文评测表明:
- Docker仍是可信脚本的最佳选择
- 托管服务适合快速验证但牺牲数据主权
- CubeSandbox在自托管场景中实现了安全、性能与功能的最优平衡
特别是其MicroVM架构与状态管理能力,为AI多轮试错、自动化修复等高级场景提供了不可替代的基础设施支持。对于正在构建AI Agent系统的团队,CubeSandbox值得纳入核心架构考量。
注:所有本地实测数据基于WSL2环境,生产部署请以官方裸金属/PVM基准为准。不同方案的测试环境存在客观差异,横向对比需注意数据口径一致性。