自主智能体如何破解复杂疾病?多组学与多模态融合的AI新范式
近年来,人工智能在生物医学领域的渗透已从辅助诊断迈向科研全流程重构。2025至2026年,自主智能体(Autonomous Agents)成为技术跃迁的核心载体——它们不再局限于回答问题或生成文本,而是具备规划、工具调用、数据解析乃至驱动实验设计的能力。这一转变在复杂疾病研究中尤为关键,因为诸如癌症、阿尔茨海默病、自身免疫性疾病等往往涉及多层次的分子机制与临床表型,单一数据源难以揭示其全貌。
复杂疾病的本质在于其异质性与动态性。同一类疾病在不同患者身上可能由完全不同的基因突变、表观遗传修饰或微环境信号驱动。传统研究范式依赖人工假设驱动,效率低下且易受认知偏见影响。而自主智能体通过整合多组学(multi-omics)与多模态(multi-modal)数据,有望构建更完整的疾病图谱,实现从“相关性发现”到“因果机制推断”的跨越。
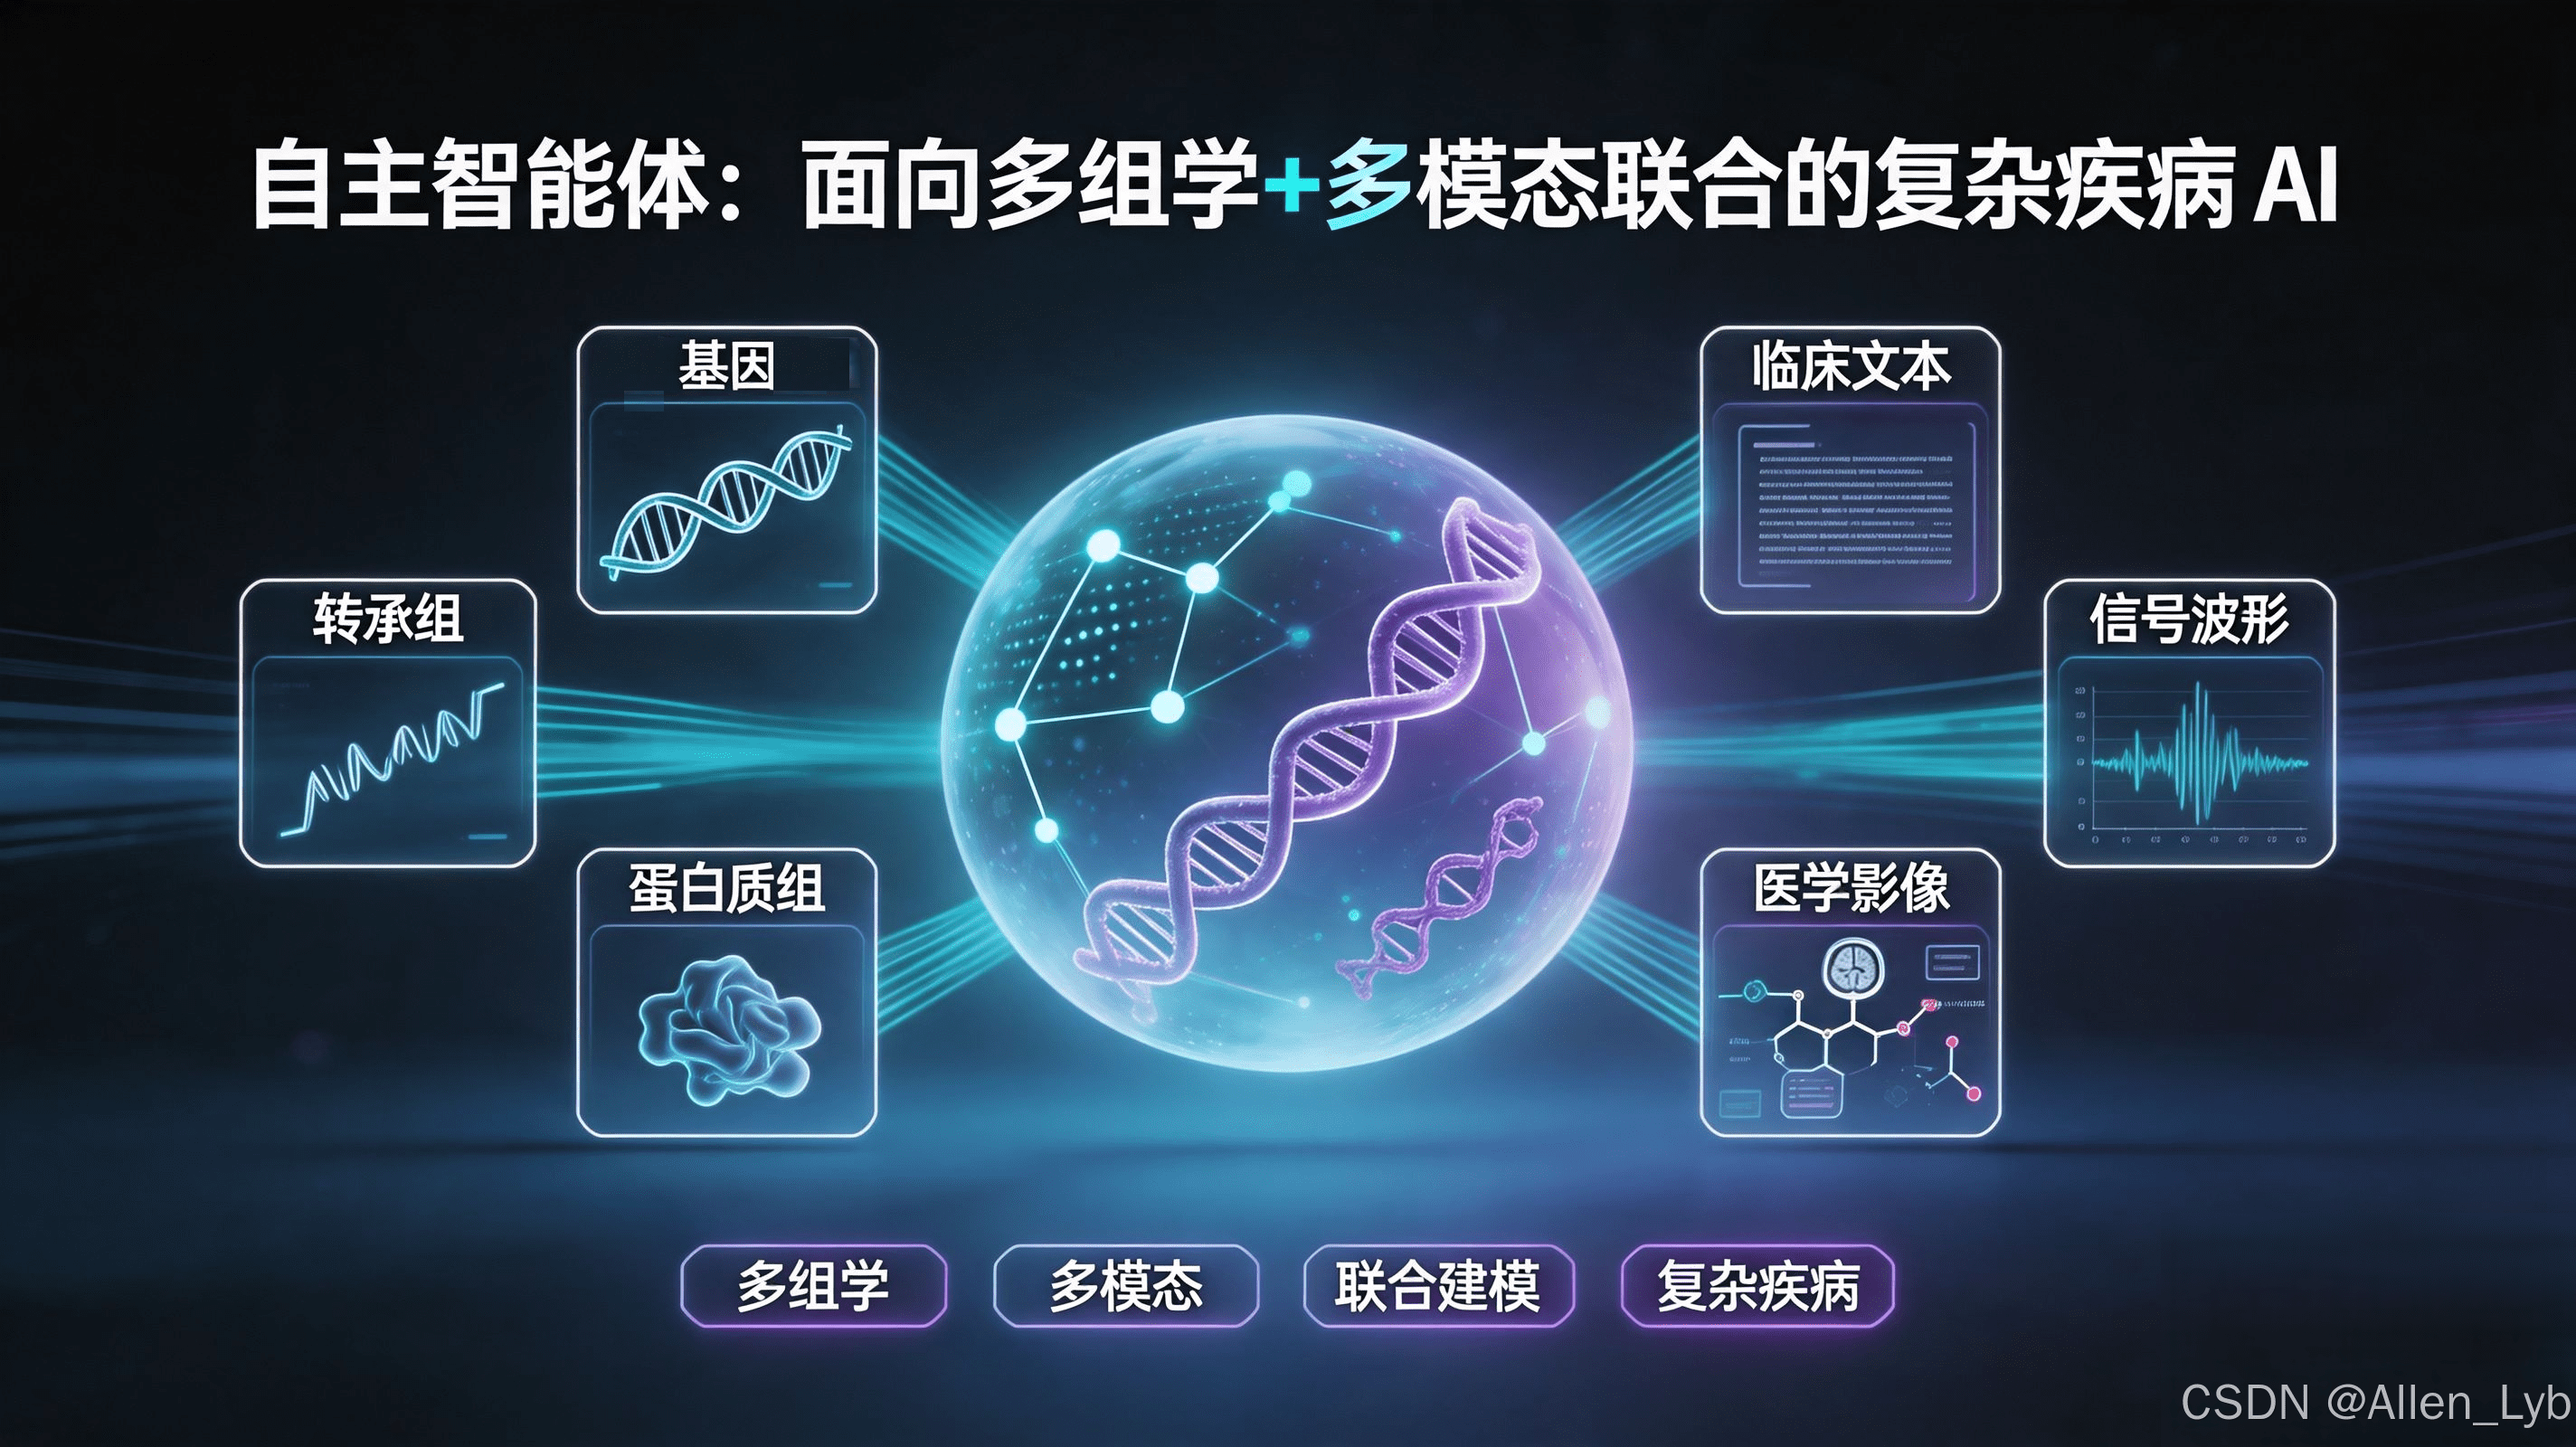
多组学涵盖基因组、转录组、表观组、蛋白组、代谢组等多个分子层面,而多模态则包括医学影像(如MRI、CT)、电子健康记录(EHR)、病理切片、可穿戴设备数据等临床信息。两者的联合分析要求AI系统不仅具备强大的表示学习能力,还需解决数据异构性、尺度差异与缺失模式不一致等挑战。例如,单细胞RNA测序数据维度高达数万,而影像数据则是高分辨率像素矩阵,二者在语义空间上天然割裂。
在此背景下,新一代自主智能体展现出三大核心能力:跨模态对齐、因果推理引导与工具链集成。以Google推出的Co-Scientist为例,该系统可自动检索PubMed文献、调用GEO数据库中的公共组学数据集,并结合用户提供的临床队列进行差异表达分析。更重要的是,它能基于初步结果提出新假说——例如“某非编码RNA可能通过调控染色质可及性影响T细胞耗竭”,并自动生成CRISPR筛选实验方案供湿实验验证。
类似地,斯坦福大学开发的Biomni系统构建了一个覆盖人类细胞类型的虚拟细胞基座模型(Virtual Cell Foundation Model)。该模型在预训练阶段融合了来自Human Cell Atlas、TCGA、GTEx等数十个大型项目的多组学数据,并通过对比学习实现跨模态嵌入。在零样本迁移任务中,Biomni可预测特定药物对罕见细胞亚群的影响,准确率在部分基准上接近专家水平。然而值得注意的是,多项独立评测显示,其在小样本场景下的泛化能力仍不稳定,尤其当训练数据与目标疾病存在显著分布偏移时,性能常低于传统线性混合模型。
这种“能力被高估”的现象并非孤例。2026年FDA发布的《AI/ML-Based Software as a Medical Device》更新清单中,尚无一款产品基于生成式AI或大语言模型(LLM)。获批系统多为规则引擎或浅层机器学习模型,用于心电图分类、糖尿病视网膜病变筛查等结构化任务。这反映出监管机构对黑箱模型的谨慎态度——尤其在涉及治疗决策时,可解释性与鲁棒性仍是硬性门槛。
自主智能体的临床转化路径因此呈现“科研先行、诊疗滞后”的特征。在药物发现领域,如FutureHouse的Robin系统已能自动设计PROTAC分子并预测其降解效率,大幅缩短先导化合物优化周期。但在直接面向患者的诊疗环节,AI仍处于辅助角色。例如,在肿瘤多学科会诊(MDT)中,智能体可整合患者全组学数据与最新临床指南,生成个性化治疗建议,但最终决策权始终由医生掌握。
阻碍规模化落地的核心瓶颈之一是数据基础设施的碎片化。尽管全球已有超过200个公共生物医学数据库,但格式不统一、元数据缺失、访问权限受限等问题严重制约了模型训练。更严峻的是,高质量的多模态配对数据极为稀缺——同一患者同时拥有单细胞测序、全外显子组、纵向影像和详细临床随访的数据集屈指可数。这导致许多宣称“端到端”的系统实际上依赖人工拼接数据管道,难以复现。
此外,评测标准的缺失加剧了技术泡沫。当前多数论文仅报告内部数据集上的AUC或准确率,缺乏跨中心、跨人群的外部验证。2025年启动的MAQC-VI(MicroArray Quality Control Phase VI)项目试图建立多组学AI的基准测试框架,但尚未覆盖生成式模型与自主智能体的行为评估。如何衡量一个智能体“提出好假说”的能力?目前仍无共识指标。
值得警惕的是,“AI接管科研”的叙事正在制造认知偏差。事实上,现有系统在物理实验执行环节仍完全依赖人类。无论是细胞培养、动物模型构建还是高通量筛选,机器人自动化平台虽有进展,但成本高昂且通用性有限。这意味着自主智能体目前仅完成了“干实验”闭环,真正的“干湿结合”仍需人机协同。
未来两年(2026–2028),突破点或将出现在三个方向:一是构建联邦式多模态数据湖,在保护隐私前提下实现跨机构数据协作;二是发展可解释的因果发现算法,使智能体不仅能关联变量,还能推断干预效应;三是推动监管沙盒机制,允许生成式AI在限定场景下开展前瞻性临床研究。
以阿尔茨海默病为例,理想中的自主智能体应能整合患者脑脊液蛋白组、PET淀粉样斑块成像、APOE基因型及认知量表,动态模拟疾病进展轨迹,并推荐最可能延缓神经退行的干预组合。这一愿景的实现,不仅需要算法创新,更依赖于数据生态、伦理框架与临床工作流的深度耦合。
综上所述,自主智能体在复杂疾病研究中展现出真实的能力跃迁,但其影响力仍被部分夸大。技术的成熟度曲线正处于“期望膨胀期”向“稳步爬升期”过渡的关键节点。唯有正视数据、评测与监管的现实约束,才能避免陷入新一轮的AI寒冬,真正推动精准医学从概念走向普惠实践。