端侧大模型突破百万Token上下文:星火X2.5双子星开源背后的国产化路径
近年来,大模型的发展呈现出明显的“两极分化”趋势:一端是千亿甚至万亿参数的超大规模云端模型,追求极致性能;另一端则是参数量压缩至数亿至数十亿级别的端侧模型,强调低延迟、高隐私与离线可用性。然而,端侧模型长期受限于上下文长度——多数仅支持4K至32K Token,难以处理长文档、复杂指令或多轮深度交互。这一瓶颈在2026年9月被科大讯飞全资子公司词元星火打破:其开源的星火X2.5-4B与X2.5-1.7B两款端侧通用大模型,首次在端侧实现原生支持100万Token上下文窗口,标志着长上下文能力正式从云端下沉至终端设备。
长上下文不是“堆数据”,而是系统性工程突破
支持百万Token上下文并非简单地将训练数据拉长。传统Transformer架构在处理长序列时面临计算复杂度呈平方级增长的问题(O(n²)),导致显存占用剧增、推理速度骤降。星火X2.5系列采用混合注意力架构,结合稀疏注意力、滑动窗口与全局记忆机制,在保证关键信息不丢失的前提下大幅降低计算开销。据官方披露,该架构在100万Token输入下仍能维持亚秒级响应,且内存占用控制在消费级GPU可承受范围内。
更重要的是,模型在训练阶段就围绕长上下文场景进行专项优化。团队使用覆盖技术手册、法律条文、学术论文、小说全本等领域的千亿Token级高质量长文本数据进行预训练,确保模型不仅能“看到”全文,更能“理解”跨章节、跨段落的逻辑关联。例如,在产品售后场景中,用户上传整本300页的设备手册,模型可自动构建知识图谱,标注退换货规则、故障分类、例外条款等关键节点。当用户提问“购买10天后设备故障且使用过第三方耗材是否符合换货要求”时,模型能同时检索“退换货时效”“第三方配件免责条款”“故障责任判定”等多个章节内容,综合判断并给出结构化建议。即便后续追加“设备位于偏远地区”“曾存储家庭地图数据”等新条件,模型也能动态更新上下文状态,联动物流政策、数据清除义务、额外费用承担等规则持续推理。
这种能力的本质,是从“片段式问答”向“情境化决策”的跃迁。它不再依赖用户精准提炼问题,而是允许用户以自然、冗余甚至碎片化的方式输入信息,由模型完成信息整合与逻辑推演。这正是端侧智能迈向实用化的关键一步。
小参数模型如何“以小博大”?核心能力聚焦与工具调用协同
参数量仅为4B和1.7B的模型,为何能在多项任务上媲美甚至超越更大规模的云端模型?答案在于能力聚焦与工具增强的双重策略。
首先,星火X2.5系列并非追求通用泛化,而是针对四大高价值场景深度优化:智能体(Agent)协作、代码生成、数学推理、复杂指令遵循。在代码领域,X2.5-4B在HumanEval、MBPP等基准测试中表现接近7B~13B级别模型,尤其在算法实现与跨文件补全任务上优势显著。其秘诀在于训练数据中包含大量真实开源项目、LeetCode题解及API文档,并通过强化学习对代码正确性、可读性、效率进行多维奖励。
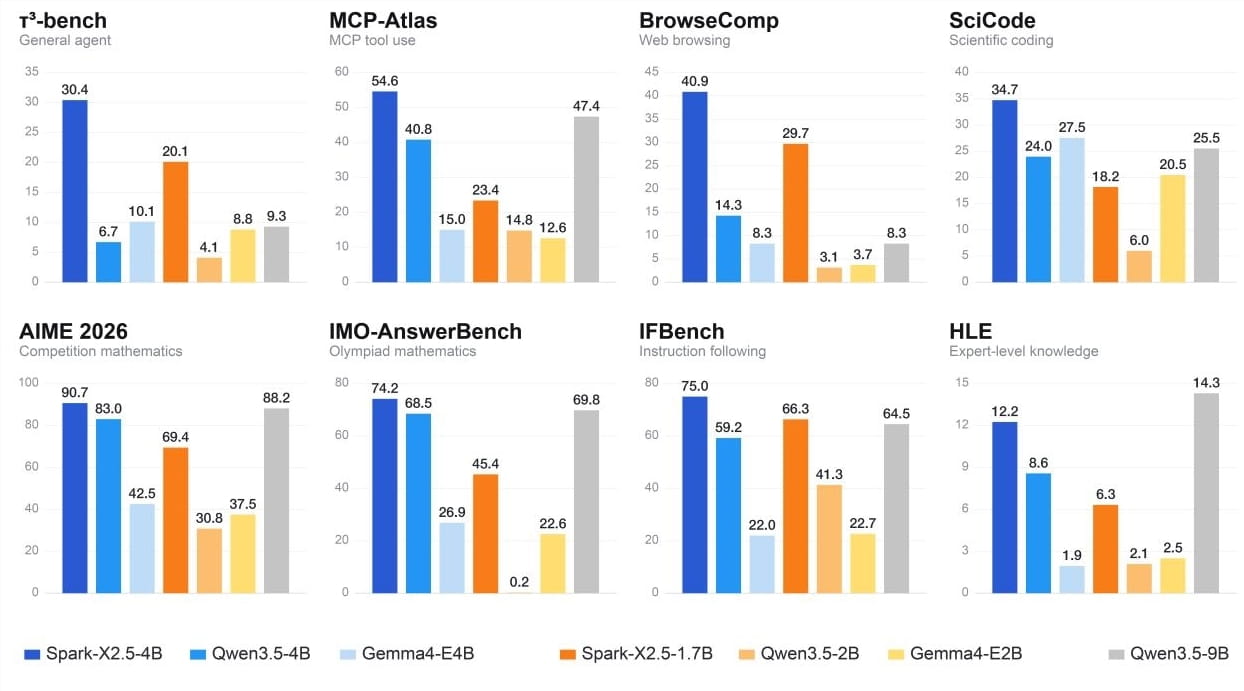
其次,模型内置轻量化工具调用框架,使其具备“动手”能力。在Domux智能家居测试集中,X2.5-1.7B需理解如“打开客厅主灯并调至暖光,同时关闭卧室所有插座”这类复合指令。模型不仅解析语义,还能生成标准化控制协议(如MQTT消息),直接驱动设备执行。实测端到端正确率达90.3%,平均响应时间仅0.85秒,证明小模型完全可在本地闭环完成复杂任务,无需回传云端。
在机器人场景中,这一能力更具颠覆性。传统服务机器人依赖预设脚本或云端决策,灵活性差且存在隐私风险。而部署X2.5模型的机器人可实时处理环境感知数据(如视觉、激光雷达)、用户语音指令及历史交互记录,在本体完成导航路径规划、物体抓取策略生成、多任务调度等决策。例如,当用户说“把茶几上的药瓶送到奶奶房间,并提醒她吃药”,机器人需识别“茶几”“药瓶”“奶奶房间”等实体,规划避障路径,操作机械臂抓取,并在送达后触发语音提醒——整个过程在边缘设备完成,延迟低于1秒。
全流程国产化:从算力底座到部署生态的自主可控
星火X2.5系列的另一重大意义在于其全程基于国产算力平台训练与部署。据披露,模型使用约20万亿Token的多样化数据完成预训练,并通过高质量监督微调(SFT)与强化学习(RLHF/DPO)持续优化。整个训练流程运行于搭载国产AI芯片的集群,未依赖任何境外算力资源。
在部署层面,模型展现出极强的硬件兼容性:不仅支持NVIDIA GPU,还全面适配华为昇腾、海光DCU、后摩智能等国产加速卡。通过vLLM、SGLang等推理引擎优化,可在不同硬件上实现高效推理。开发者可通过Ollama、LM Studio等工具一键部署,亦可使用LLaMA-Factory进行领域增量训练,快速定制行业模型。
这种“训练-推理-微调”全链路的国产化支持,极大降低了国内开发者使用先进大模型的技术门槛与合规风险。尤其在政务、金融、工业等对数据安全要求严苛的领域,端侧部署+国产芯片的组合提供了真正意义上的“数据不出域”解决方案。
开源生态与未来演进:端云协同的新范式
即日起,星火X2.5-4B与1.7B的模型权重已在Hugging Face与GitHub开源,配套提供完整训练代码、量化脚本与部署文档。同时,讯飞星辰MaaS平台已上线对应API,限时免费供开发者调用。这一举措有望激活国内端侧AI应用创新——从智能办公助手、车载语音系统到工业巡检机器人,均可基于此基础模型快速构建垂直应用。
值得注意的是,端侧长上下文并非要取代云端大模型,而是构建端云协同的新范式。简单任务、高频交互由端侧模型即时响应;复杂推理、知识更新则交由云端处理。例如,手机上的写作助手可利用X2.5-1.7B实时润色当前段落,同时将全文上传云端模型进行风格分析与大纲建议。两者通过上下文同步机制无缝衔接,兼顾效率与深度。
9月7日,科大讯飞还将发布旗舰版星火X2.5大模型,进一步强化代码与智能体能力。可以预见,随着端侧模型能力持续逼近云端,AI将真正从“中心化服务”走向“泛在智能”——每个设备都成为具备理解、决策与执行能力的智能节点,而百万Token上下文正是这一愿景的关键基石。
综上所述,星火X2.5双子星的开源不仅是技术参数的突破,更是国产AI生态在端侧智能化道路上的一次重要实践。它证明了小模型通过架构创新、场景聚焦与工具增强,完全有能力在本地环境中提供高价值智能服务。而全流程国产化支持,则为我国AI产业的自主可控与安全发展提供了坚实底座。