本地优先智能体如何重塑知识工作:Perplexity的Portable Computer深度解析
近年来,人工智能智能体(Agent)在知识工作领域的渗透速度远超预期。从自动撰写报告、数据分析到代码生成,智能体正逐步接管人类专家的部分认知劳动。然而,这一进程也暴露出两大核心矛盾:一是对闭源大模型API的高度依赖导致推理成本飙升;二是用户私有数据频繁上传至云端,引发严重的隐私与知识产权风险。在此背景下,Perplexity提出的“本地优先”(Local-First)智能体架构——Portable Computer,提供了一条兼顾性能、成本与安全的新路径。
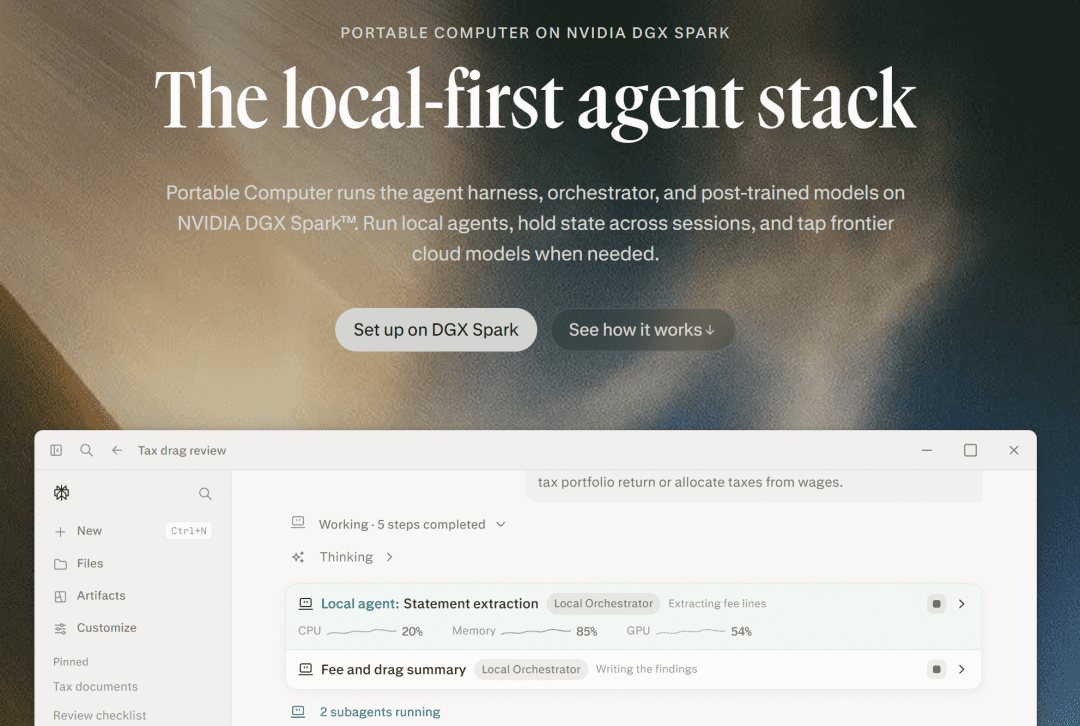
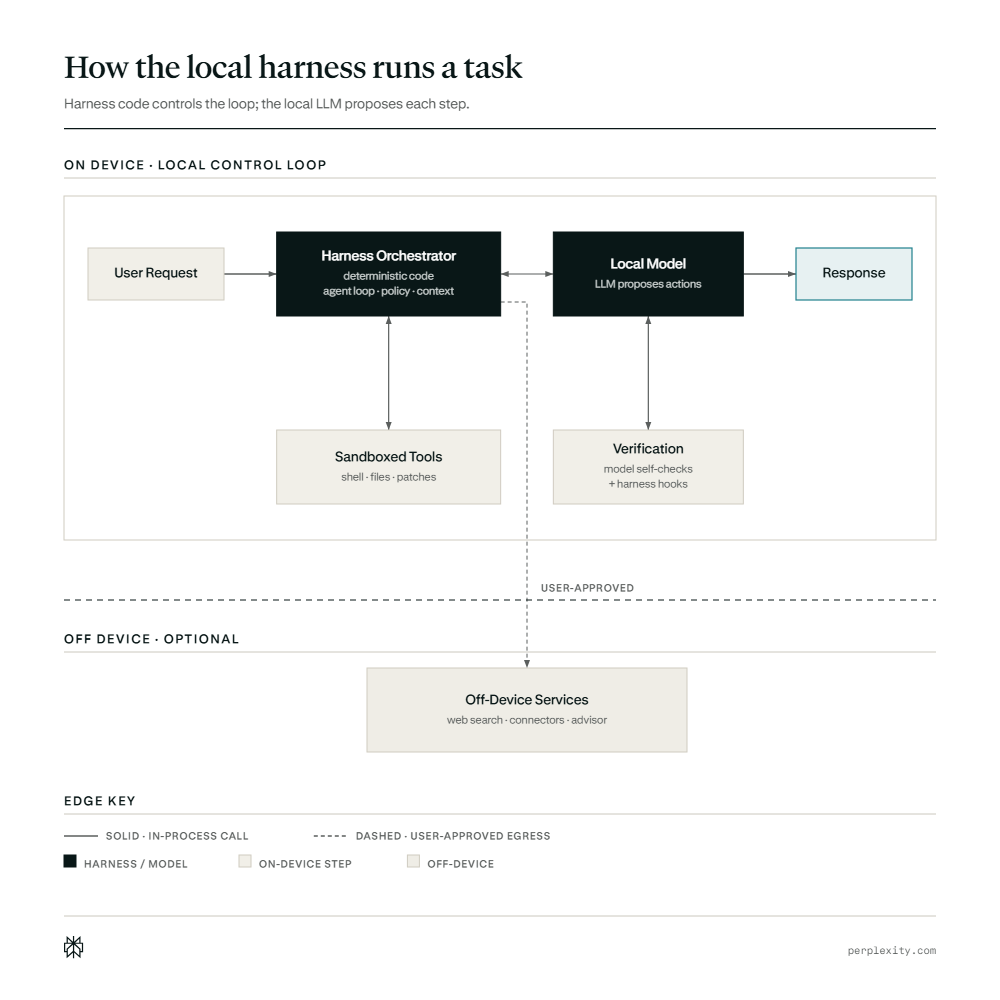
Portable Computer的核心理念在于:将智能体的主干运行于用户本地设备,仅在必要时按需调用外部服务。这意味着模型推理、对话历史、文件处理等敏感操作全部在设备边界内完成,而网络搜索、云模型顾问等功能则作为可选插件,在用户明确授权后才激活。这种设计从根本上解决了数据外泄问题,同时大幅降低长期使用成本——毕竟本地GPU推理几乎不产生持续性费用。
实现这一愿景的关键,在于对模型与框架的协同优化。传统开源智能体框架如Hermes或Pi,虽具备良好的通用性,但其设计假设基于前沿大模型的强大能力:长上下文理解、复杂工具调用、多步规划等。然而,即便如Qwen 3.8 27B这类参数量达270亿的“小模型”,在本地硬件上运行时,其可靠性仍无法与云端千亿级模型相提并论。若强行套用通用框架,极易因上下文过载、工具误用或逻辑断裂而导致任务失败。
Perplexity的应对策略是重构整个技术栈以适配本地模型的能力边界。其框架设计围绕四大原则展开:上下文效率、连接器轻量化、自我验证与沙盒执行。
首先是上下文效率。尽管Qwen 3.8 27B宣称支持26万token的上下文窗口,但实测表明,当输入长度超过10万token时,模型性能显著下降。因此,Portable Computer采用极简系统提示(system harness),仅保留核心指令与基础工具集。其余功能——如研究、数据可视化、文档生成等——被封装为“技能模块”(skills),按需动态加载。当对话轨迹过长时,框架会自动触发上下文压缩机制,对历史信息进行摘要,确保模型始终聚焦于有效信息窗口内。
其次,连接器被重构为命令行工具。传统智能体常通过MCP(Model Context Protocol)服务器接入Gmail、GitHub等服务,但MCP的庞大工具定义会迅速耗尽宝贵上下文空间。Perplexity将高频使用的连接器转换为简洁的CLI命令,配合定制化技能脚本,既保留功能性,又极大节省token开销。例如,查询日历事件不再需要传递完整的API schema,而只需执行pplx-calendar list --today这样的轻量指令。
第三是自我验证机制。智能体在执行关键步骤后,会主动或被动地触发验证流程。例如,当生成一段代码后,模型可调用本地测试框架运行单元测试;或当提取PDF表格数据时,自动比对原始图像与OCR结果的一致性。这种“执行-验证”闭环虽增加少量计算开销,却显著提升最终输出的可靠性,有效弥补本地模型在复杂推理上的不足。
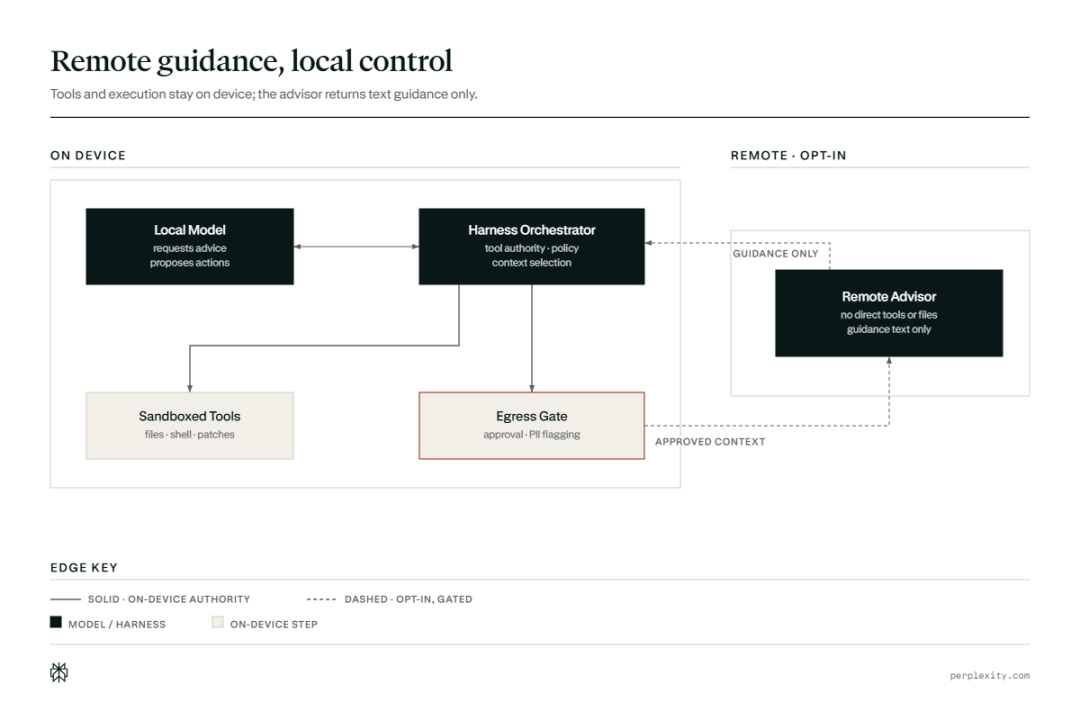
最后,也是最关键的安全保障——沙盒执行。所有工具调用均在操作系统级沙箱中运行,严格限制文件访问、网络请求和进程权限。若设备不支持沙箱(如某些Linux发行版),框架将直接禁用工具执行功能,而非降级为无保护模式。这与Hermes等框架默认以用户权限直接运行命令的做法形成鲜明对比,从根本上杜绝了恶意指令或错误操作对系统的破坏风险。
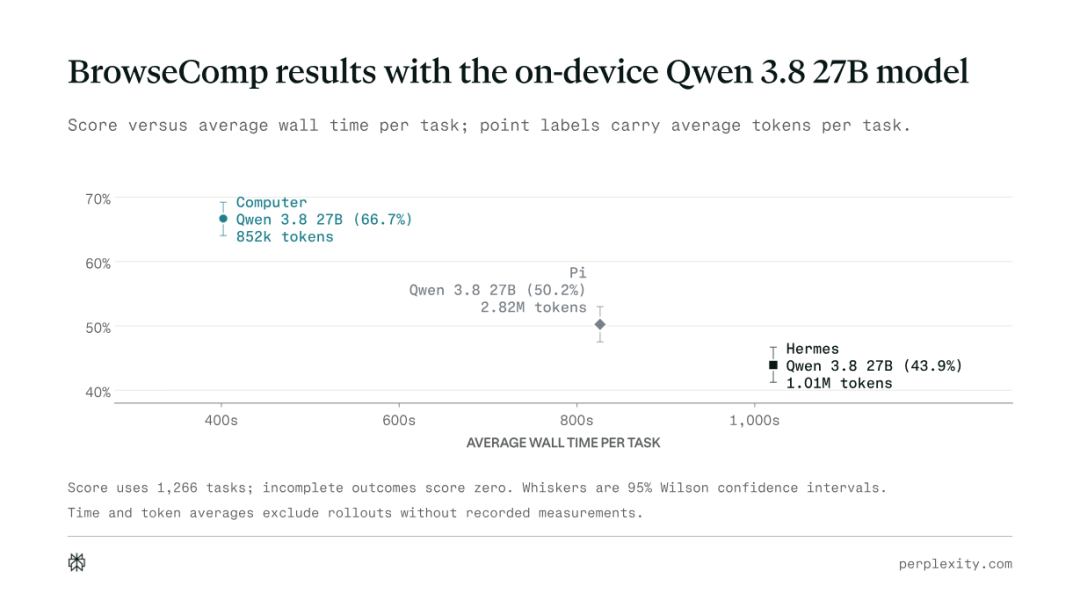
在上述框架支撑下,Portable Computer在多项基准测试中展现出显著优势。以网络搜索能力为例,Perplexity基于自研搜索引擎构建了Search as Code接口,并在1266个BrowseComp任务上进行评估。结果显示,Computer准确率达66.7%,远超Pi(50.2%)和Hermes(43.9%)。更值得注意的是效率指标:Computer平均每任务耗时402秒、消耗85.2万token,而Pi高达826秒和282万token——后者token消耗竟是前者的3.3倍。这意味着在同等硬件条件下,Computer可支持更长时间、更复杂的连续任务。
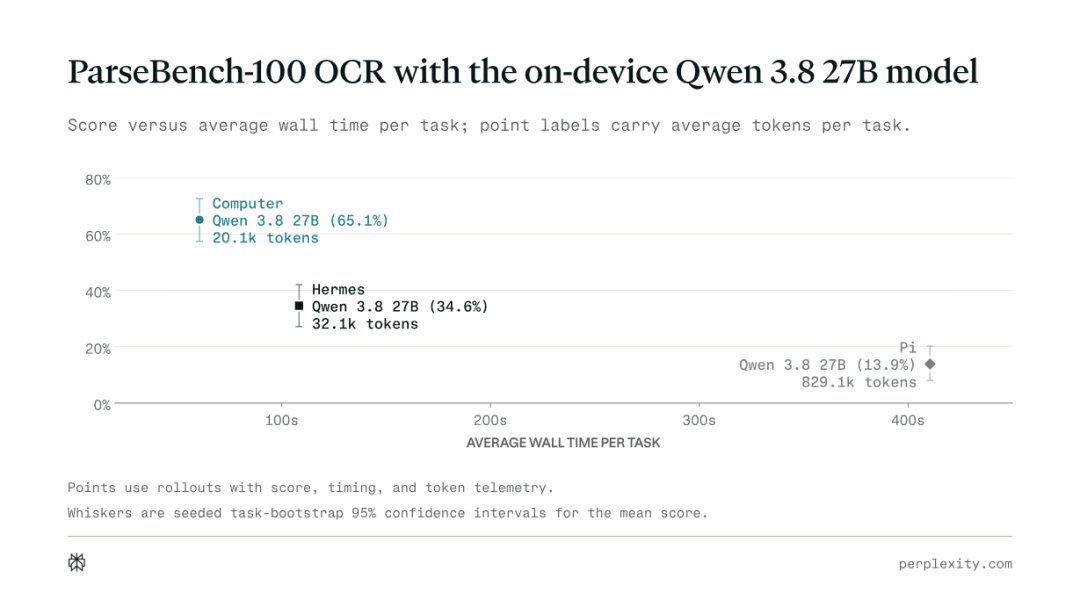
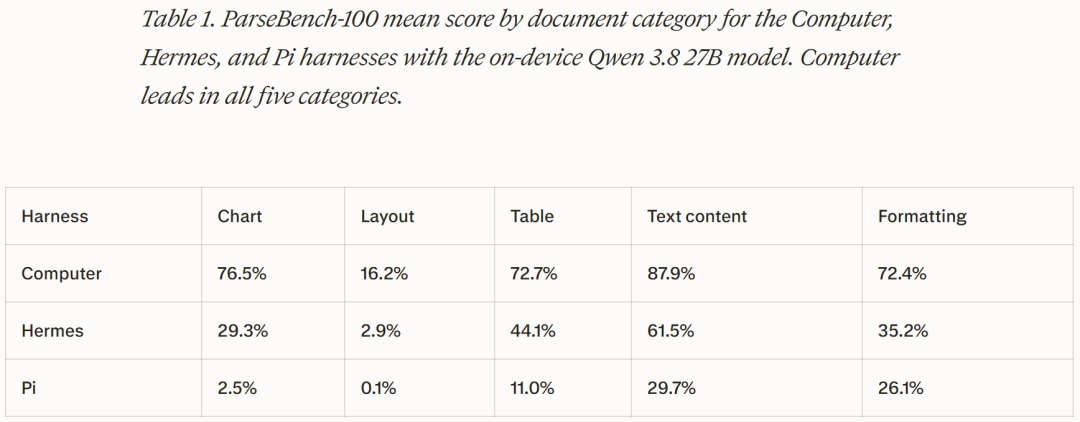
在多模态文档理解方面,优势更为突出。ParseBench-100测试涵盖图表、表格、布局等五类文档,要求模型结合视觉与文本信息进行结构化解析。Portable Computer平均得分65.1%,而Hermes仅34.6%,Pi更是低至13.9%。尤其在图表理解任务中,Computer凭借原生多模态能力,能准确识别坐标轴、图例与数据趋势,而其他框架因缺乏图像输入支持,几乎无法完成任务。此外,Computer每任务仅需60.6秒和2万token,效率远超对手。
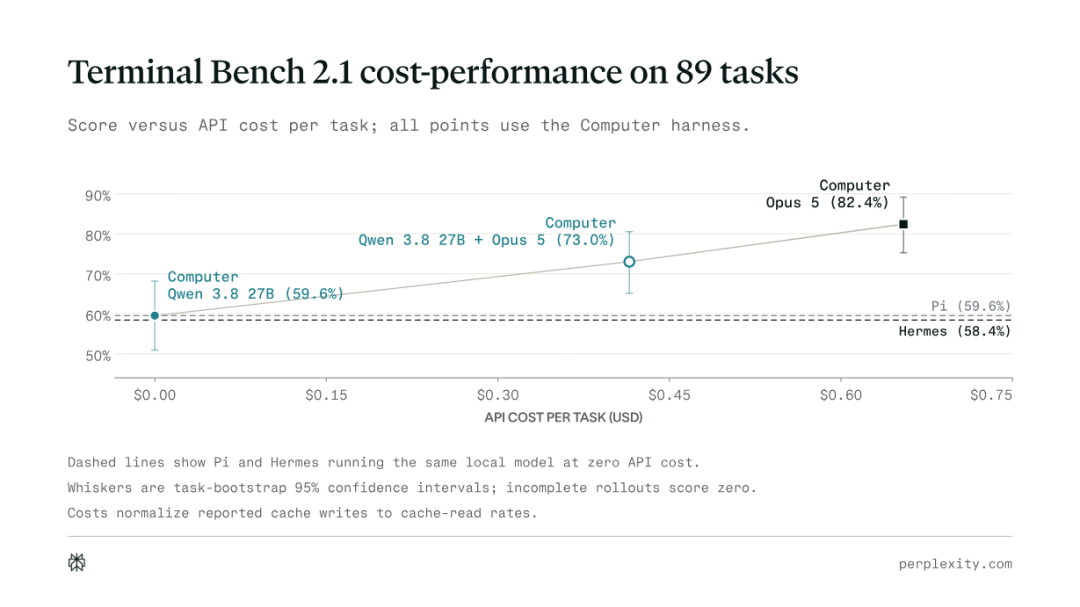
当然,本地模型并非万能。面对极端复杂的软件工程任务(如Terminal Bench 2.1中的89个编码挑战),Qwen 3.8 27B单独运行时得分仅为59.6%,远低于Claude Opus 5的82.4%。为此,Perplexity引入顾问升级机制:本地模型可在规划受阻、结果存疑或多次失败时,请求云端更强模型提供指导。但该过程严格受控——系统会先筛选上下文,标记PII(个人身份信息),并向用户展示即将外传的数据内容。用户可手动批准或设置自动策略。测试表明,启用顾问后,Computer得分提升至73.0%,每次调用成本约0.415美元,约为纯云端方案(0.65美元)的64%,却弥补了约60%的性能差距。这种“本地为主、云端为辅”的混合模式,为用户提供了灵活的成本-性能权衡空间。
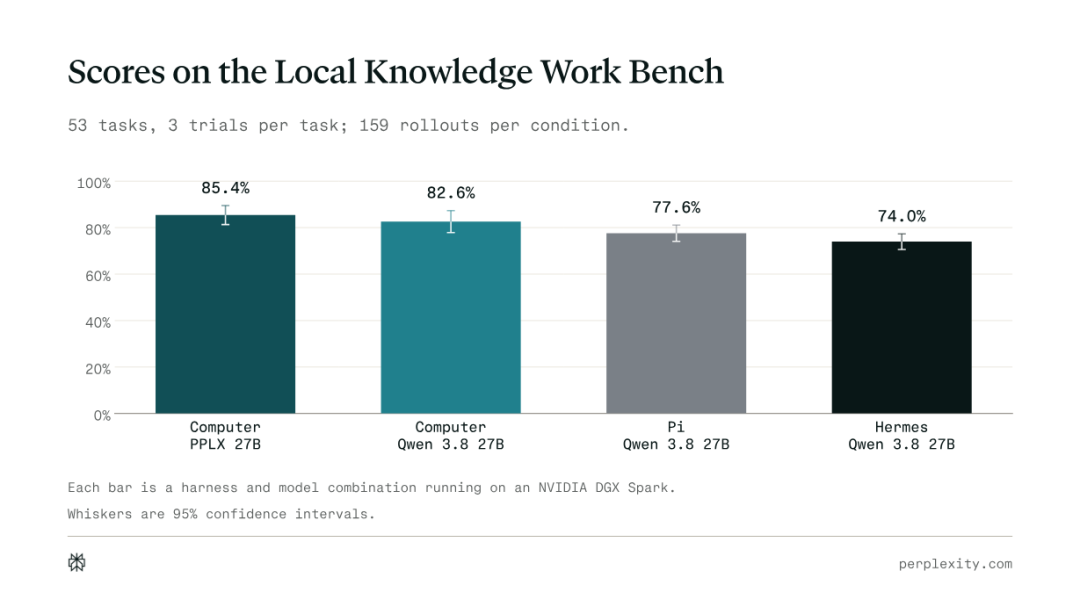
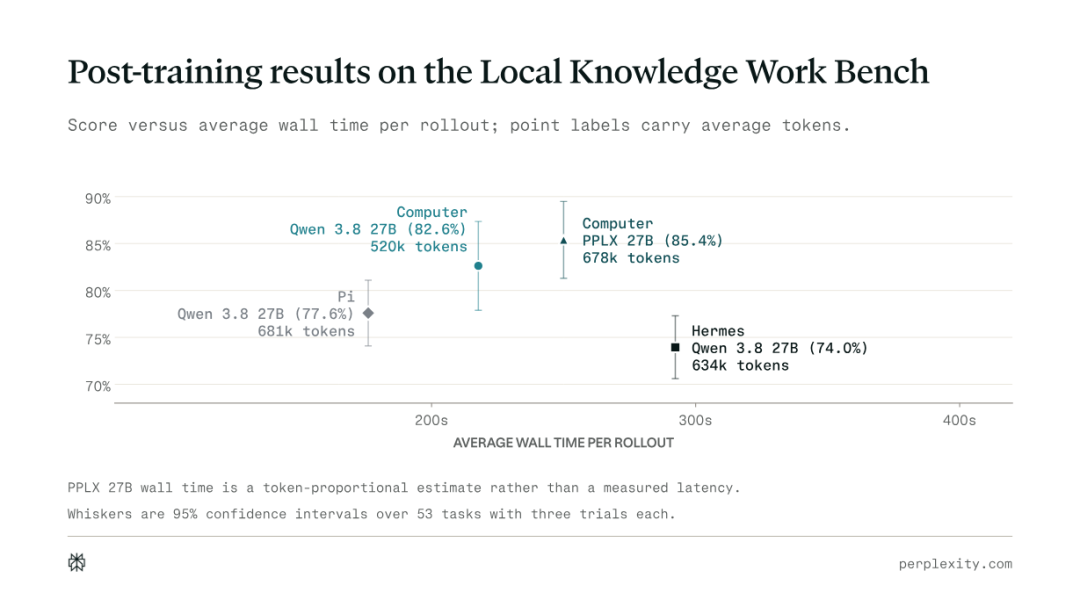
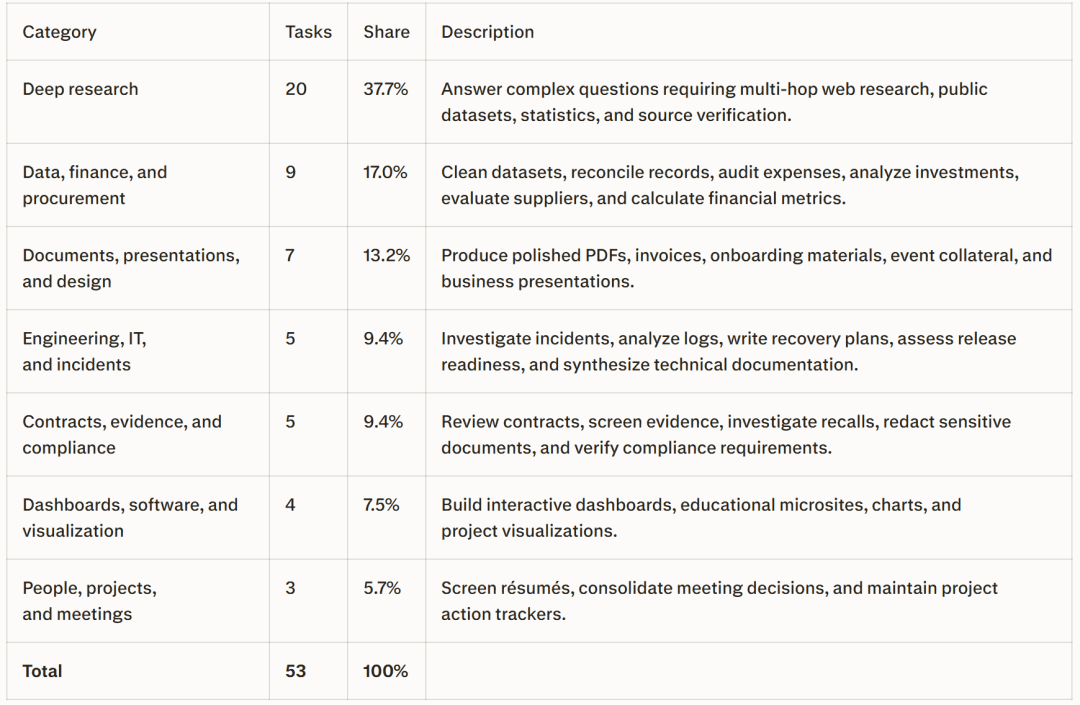
为进一步释放本地模型潜力,Perplexity还实施了针对性后训练。他们构建了包含53个任务的“本地知识工作台”(Local Knowledge Work Bench),覆盖研究、写作、编程等七大场景,并基于此合成训练数据。训练分两阶段:先通过拒绝采样微调(rejection sampling fine-tuning)筛选最优轨迹,再以强化学习优化策略。由此诞生的PPLX 27B模型,在相同框架下将任务完成率从82.6%提升至85.4%,虽token消耗略有增加,但整体仍优于通用框架+基础模型的组合。
综上所述,Portable Computer的成功并非单纯依赖模型规模,而是源于对“本地约束”这一前提的深刻理解与系统性响应。它证明了:在合理架构下,开源大模型完全有能力承担真实世界中的知识工作负载。随着NVIDIA DGX Spark、Mac Studio M5 Ultra等高性能本地硬件的普及,以及Qwen、Nemotron等模型的持续进化,AI智能体的重心正从云端向终端迁移。这不仅是一次技术演进,更是一场关于数据主权与计算民主化的范式转移——用户终于可以掌控自己的AI助手,而不必将其核心能力外包给遥远的服务器集群。