混合线性注意力大模型中的激活尖峰与平台:Full Attention如何塑造深层计算节奏?
近年来,随着大语言模型对计算效率与建模能力的双重需求日益增长,混合线性注意力架构(Hybrid Linear Attention, HLA)逐渐成为主流选择。这类模型在大部分层中采用计算高效的线性注意力(Linear Attention),仅在少数关键层插入全注意力(Full Attention)以保留长程依赖建模能力。Qwen3.5、Kimi Linear、Nemotron-H 和 Zamba 等前沿模型均采用了此类设计。然而,一个关键问题长期未被深入探讨:当 Full Attention 层被稀疏地嵌入线性注意力骨干中时,它们如何影响前后层的内部表示动态?特别是,这些“少数但关键”的 Full Attention 层是否会在模型深层留下可识别的计算痕迹?
一项由 StartLux 联合清华大学、中国科学院大学、香港大学、悉尼大学及哥伦比亚大学共同完成的研究,首次系统性地回答了这一问题。研究团队提出以 Massive Activations(MAs,即显著偏离均值的极端激活值)作为探针,追踪其在模型深度方向上的演化轨迹。通过对五种线性注意力骨干(RetNet、HGRN、GLA、DeltaNet、Gated DeltaNet)、六种混合比例(从纯线性到纯 Full Attention)、五个数据域以及12个公开 HLA 模型(参数量跨度达1.2B至397B)的全面分析,研究揭示了两种核心激活形态:注意力前尖峰(Pre-Attention Spikes, PAS)与尖峰间平台(Inter-Spike Plateaus, ISP)。
注意力前尖峰:Full Attention 尚未登场,激活已冲上峰值
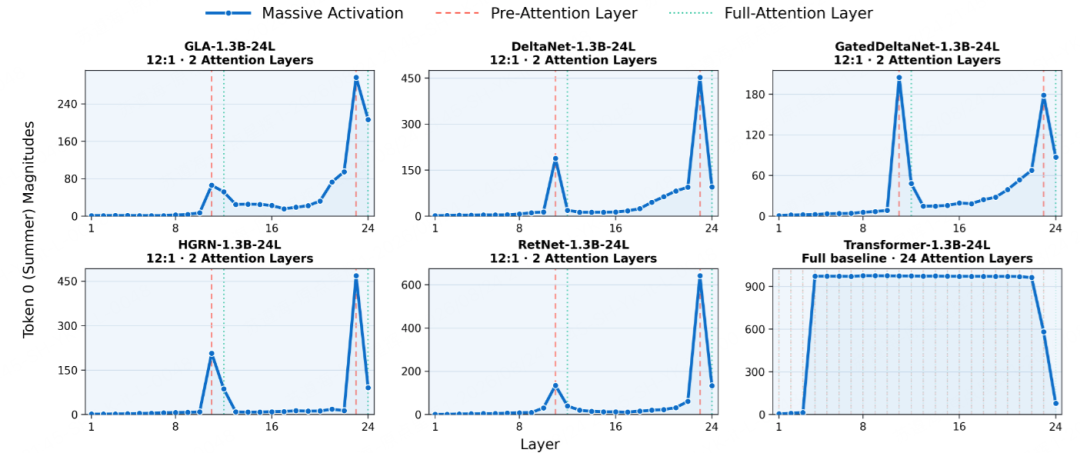
研究者首先定义了一个全局性的“注意力汇点”(Attention Sink)——即在所有 Full Attention 头中被最多关注的 token。随后,他们固定该 token,沿模型深度追踪其在各层中的 Massive Activations。令人惊讶的是,在所有测试的线性注意力骨干中,与该 Sink 相关的 MAs 总是在 Full Attention 层的前一层 达到局部最大值。这一现象被命名为“注意力前尖峰”(PAS)。
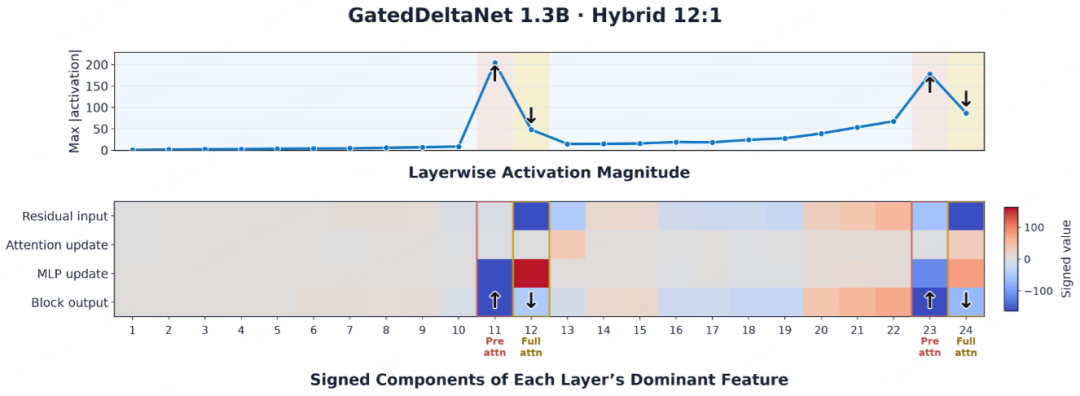
例如,在一个1.3B参数、混合比例为12:1(即每12层线性注意力后插入1层 Full Attention)的 M-A-P 模型中,无论采用 RetNet 还是 GDN 骨干,PAS 均稳定出现在 Full Attention 前一层。统计显示,在五个不同数据域中,PAS 出现在正确位置的比例高达 99.4%–100%,远超随机选择层位的期望值(约9.1%)。这表明 PAS 并非偶然噪声,而是由架构本身决定的结构性特征。
更关键的是,PAS 的形成 先于 Full Attention 的实际计算。换言之,Full Attention 层尚未开始处理输入,其上游残差流中已预先“写入”了极端激活值。这一发现挑战了传统认知——即 Full Attention 的作用仅限于其自身层内。实际上,它的存在已在前一层激活动态中留下了“预告式”印记。
从孤立尖峰到连续平台:混合密度重塑激活的时间形态
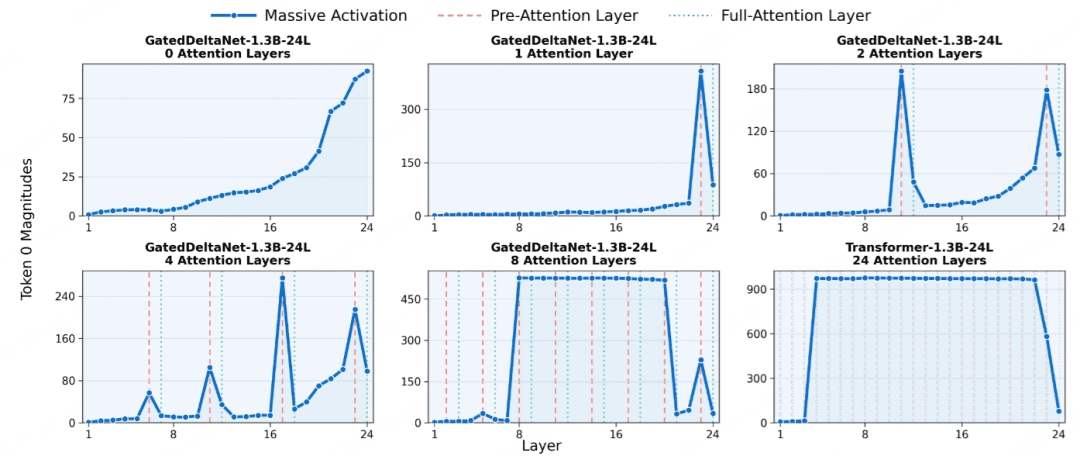
当研究者固定模型骨干,仅改变 Full Attention 的插入频率时,另一种形态浮现:尖峰间平台(ISP)。在 Full Attention 极其稀疏的配置下(如24:1),PAS 表现为彼此隔离的孤峰;但随着 Full Attention 密度增加(如6:1或3:1),相邻 PAS 之间的 MAs 不再完全衰减,而是在中间的线性注意力层中维持高位,形成连接两个尖峰的“平台”。
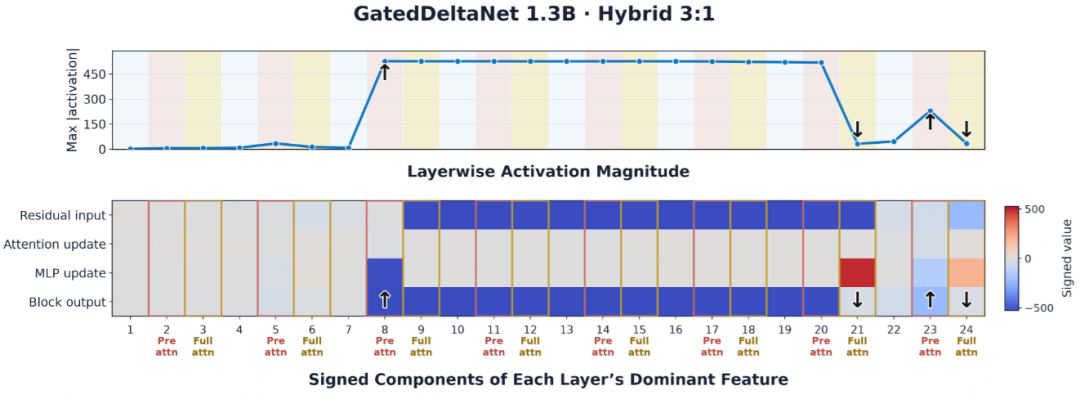
定量分析进一步验证了这一趋势。以1.3B模型为例,当混合比例从12:1提升至3:1,RetNet 架构的“尖峰间保留分数”(即后一 PAS 与前一 PAS 之间 MAs 的保持程度)从18.8%跃升至85.4%;HGRN 则从7.2%增至92.5%。在全部20组相邻密度对比中,均观察到 Full Attention 越密集,ISP 越显著 的一致规律。
这意味着,混合比例不仅是效率与性能的权衡参数,更是 塑造模型内部激活“时间形态” 的关键变量。稀疏配置下,离群激活短暂而局部;密集配置下,它们得以在层间持续传播,形成跨越多个线性层的稳定平台。这一发现将混合架构的设计维度从静态层类型选择,拓展至动态激活传播的调控。
跨模型验证:节拍稳定,振幅可变
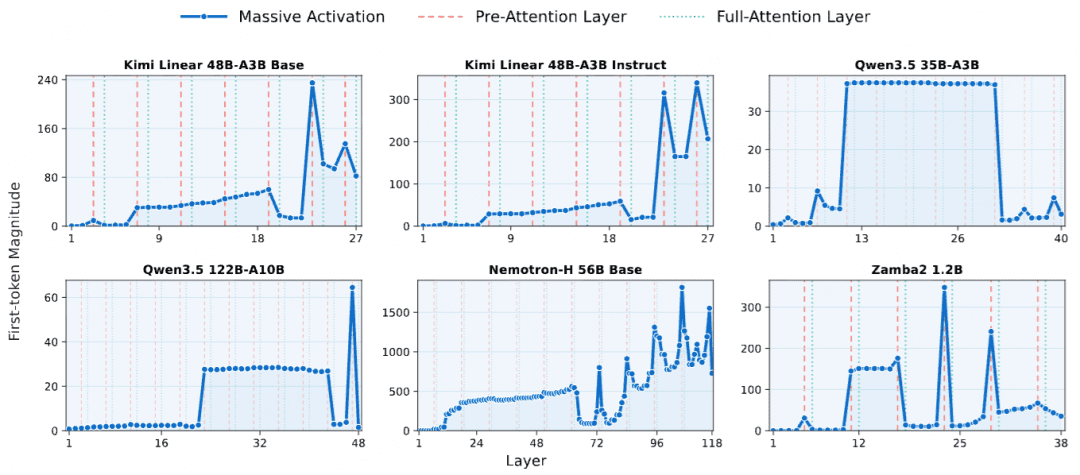
为检验上述规律的普适性,研究团队分析了 Kimi Linear、Qwen3.5、Nemotron-H 和 Zamba2 等12个公开 HLA 模型。尽管这些模型在训练数据、优化目标和具体实现上存在差异,但 PAS 与 ISP 的层间位置始终与 Full Attention 的排布严格对齐。
有趣的是,不同模型间的 绝对激活幅值差异显著——例如,Qwen3.5 的尖峰高度并不随参数量单调增长;Nemotron-H 与 Zamba2(后者融合了状态空间模型 SSM)也展现出类似的激活组织模式。这表明,激活的“节拍”(即何时出现尖峰或平台)比“音量”(即激活大小)更具架构鲁棒性。即使输入数据域变化导致峰值高低波动,PAS 与 ISP 的出现位置和覆盖区间仍保持高度稳定。
这一发现暗示,混合架构的内部计算节奏具有某种“拓扑不变性”——只要 Full Attention 的插入位置固定,其引发的跨层激活模式就会以可预测的方式展开,不受模型规模或训练细节的剧烈干扰。
训练早期即已写入:动态模式非后期涌现
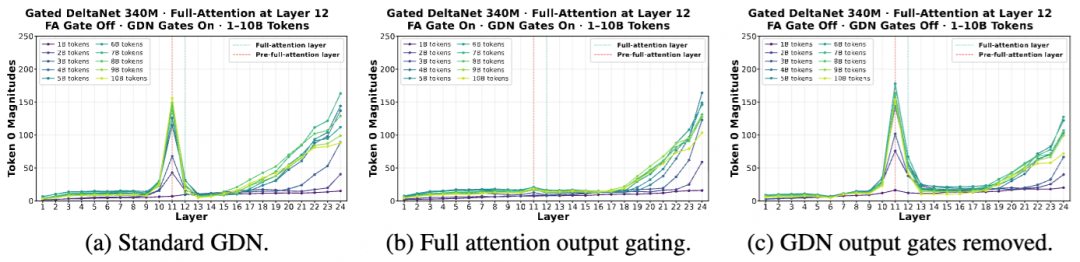
为探究 PAS 与 ISP 是训练后期偶然形成,还是早期即已确立,研究者从头训练了340M和1.3B的 GDN 模型,并追踪其预训练过程中的激活演化。结果表明,PAS 在训练极早期就已出现:340M模型在10亿 token 后即可观测到清晰尖峰;1.3B模型在100亿 token 时形成稳定 PAS,并始终与 Full Attention 位置对齐。
更关键的是,当人为调整 Full Attention 的插入层位时,PAS 会随之移动。这直接证明了 Full Attention 的位置是 PAS 形成的因果驱动因素,而非相关性巧合。同样,ISP 也在训练早期显现,并随训练推进逐步强化。
此外,研究者进行了两组门控干预实验:一是在 Full Attention 输出端添加逐元素门控,二是移除 GDN 原有的输出门控。结果显示,前者显著压低 PAS/ISP 的幅值,但 不破坏其层间组织结构;后者仅带来温和放大。这表明,Full Attention 的排布是 MA 动力学的“节拍器”,而门控机制主要调节激活的传播强度,而非节奏本身。
统一解释框架:“写入—汇聚—消除”生命周期
基于上述观察,研究者提出一个统一的三阶段模型来解释 PAS 与 ISP 的生成机制:写入(write)—汇聚(sink)—消除(cancel)。
在 PAS 场景中,这一过程高度局域化:
- 写入:Full Attention 前一层在特定 token-特征坐标上生成极端激活值;
- 汇聚:进入 Full Attention 层后,该 token 因携带强信号而成为 Attention Sink,吸引大量后续 query 的注意力;
- 消除:同一坐标随即出现符号相反的大更新,迅速抵消此前写入的离群值,导致激活快速回落,形成尖锐峰值。
而在 ISP 场景中,消除阶段被延迟。极端值写入后,抵消更新并未立即发生,而是推迟到更深的层。因此,MAs 得以穿越多个线性注意力层持续存在,形成连接相邻 PAS 的平台。随着 Full Attention 密度增加,消除延迟缩短,平台逐渐填平低谷;在纯 Full Attention 极限下,PAS 与 ISP 的区分消失,恢复为传统 Transformer 中横跨中间层的稳定高激活状态。
由此,PAS、ISP 与传统 Full Attention 模型中的持续激活构成一条 连续的形态谱系,其演化由“消除时机”这一单一变量组织。这一框架不仅解释了混合架构中的激活动态,也为理解不同注意力机制的交互提供了新视角。
为混合架构绘制内部计算地图
这项研究的意义远超现象描述。它首次为混合线性注意力大模型绘制了一张 内部计算动态地图,揭示了架构选择如何深刻影响模型深层的信息流。
首先,Full Attention 的插入位置不仅是功能选择,更是节奏设定。它决定了 MAs 在何处“爆发”,进而影响前后多层的表示分布。其次,混合密度调控离群激活的“寿命”——稀疏配置下激活短暂,密集配置下则持久传播。最后,线性注意力的具体实现(如门控机制)虽不改变节奏,但可调节激活强度,为量化与压缩提供调控接口。
这些发现对实际应用具有重要启示。例如,在模型压缩中,可针对 PAS 出现的层位采用更高精度的量化策略;在推理优化中,可预测 ISP 区间以动态调整计算资源分配。更重要的是,该研究为未来混合架构设计提供了新原则:不仅要考虑“在哪里用 Full Attention”,还要思考“它会如何扰动整个深度的激活生态”。
综上所述,这项工作不仅揭示了混合线性注意力模型中隐藏的跨层动态规律,更将架构设计从静态组件拼接提升至动态系统调控的新层次。随着 HLA 架构在工业界广泛应用,对这类内部计算节奏的理解,将成为下一代高效大模型研发的关键基石。