大发现模型LDM:科学发现中的开放式实验设计新范式
在当代科学研究中,一个核心挑战是如何在庞大、开放且实验成本高昂的设计空间中高效地决定“下一步该做什么实验”。这一问题远非简单的参数调优,而是一种面向不确定性的序贯决策过程——研究者需要在已有知识的基础上,不断提出新假设、生成新候选,并依据有限的实验反馈动态调整探索方向。近年来,尽管大语言模型(LLM)在代码生成、分子设计等领域展现出强大潜力,但其内在的生成偏好往往与真实实验价值脱节;而传统的贝叶斯优化(Bayesian Optimization, BO)虽能基于后验不确定性进行审慎选择,却难以突破预设的搜索边界。正是在这一背景下,伦敦大学学院汪军教授团队提出了大发现模型(Large Discovery Models, LDMs),为科学发现提供了一种全新的递归式基础模型架构。
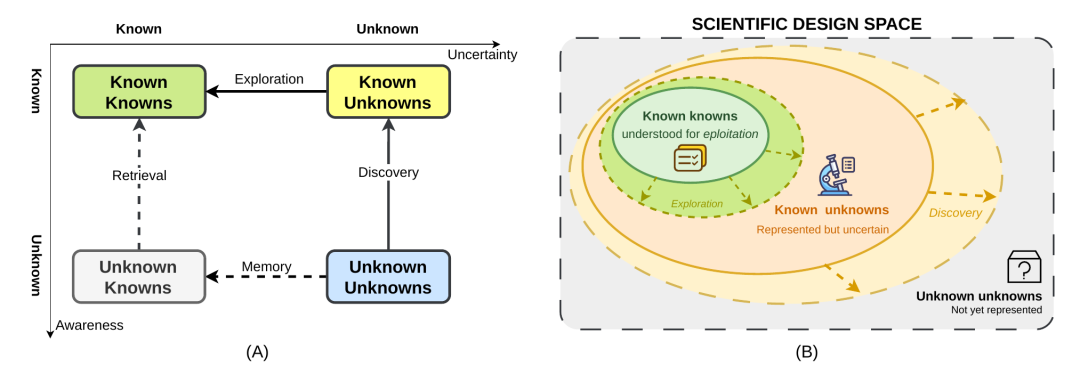
LDM的核心思想在于将科学发现建模为一个双时间尺度的学习系统:一方面,通过生成式基础模型在开放空间中持续拓展候选方案的边界;另一方面,借助高斯过程(Gaussian Process, GP)构建经验驱动的奖励信号,评估每个候选的实验价值。这种架构不仅实现了对已知区域的精细优化(exploitation)和对当前表示范围内不确定区域的探索(exploration),更重要的是引入了第三维度——发现(discovery)。所谓“发现”,是指当现有搜索空间趋于饱和时,模型能够主动重构表示空间,将原本“未知的未知”纳入可搜索范围,从而开启全新的研究路径。
为了理解LDM的必要性,我们需要重新审视科学发现的认知结构。研究团队提出了一个“认知矩阵”框架:第一象限是“已知的已知”,即性能已被充分验证的候选集合,适合利用策略;第二象限是“已知的未知”,即已被纳入搜索但性能尚不明确的区域,适合探索策略;而第三象限——“未知的未知”——则完全超出当前模型的表征能力。传统优化方法止步于前两者,而LDM的目标正是激活第三象限。例如,在抗体设计中,最优序列可能属于一个从未被采样的氨基酸基序家族;在神经网络训练中,性能突破可能依赖于一种尚未被提出的优化机制。LDM通过生成模型提出结构新颖的候选,再由GP判断其是否值得投入昂贵的实验资源,从而实现从“生成”到“发现”的跃迁。
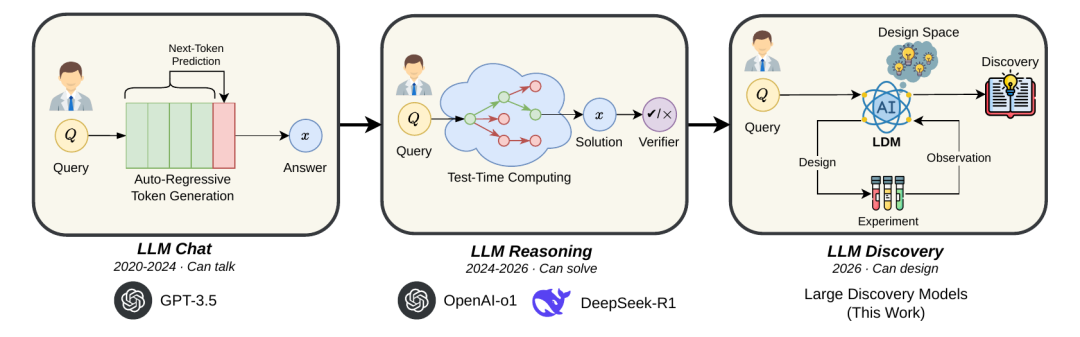
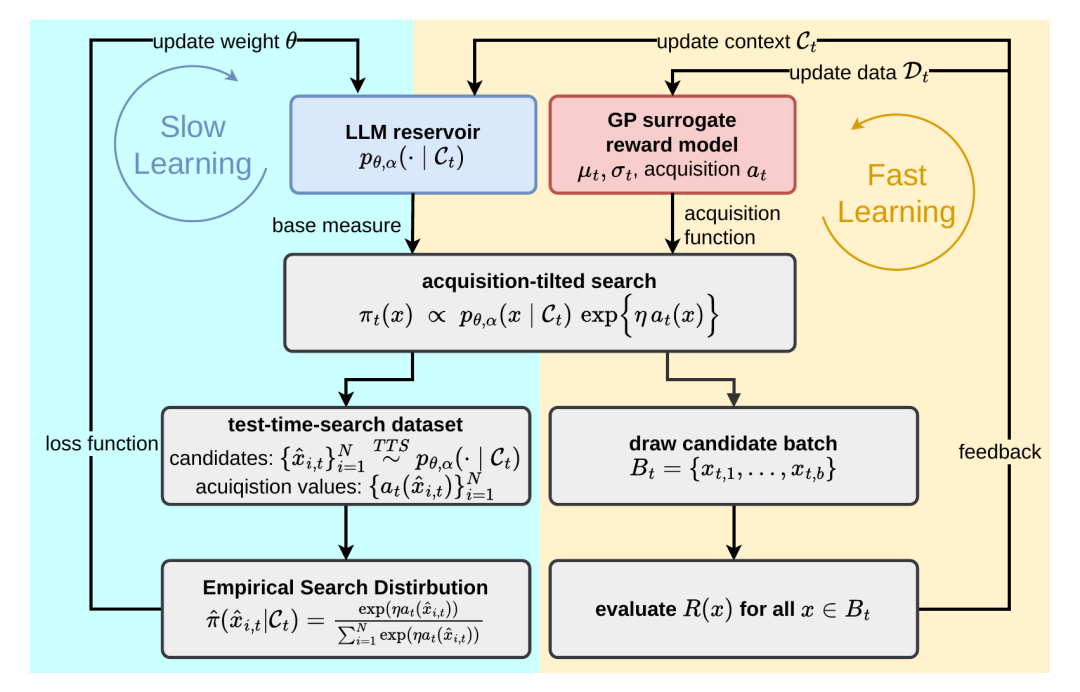
LDM的架构包含两个紧密耦合的闭环:快学习闭环与慢学习闭环。快闭环负责单次任务内的实时迭代。每一轮中,大语言模型基于当前实验上下文(如历史结果、失败案例、反思日志)生成一批开放式候选——这些候选可以是Python训练脚本、蛋白质CDRH3序列或SMILES分子字符串。随后,高斯过程代理模型利用所有已观测的实验数据,为每个候选计算采集函数值(如UCB、EI或多目标EHVI),该值综合反映了预期性能与信息增益。最终,系统选择采集值最高的若干候选进行真实(或仿真)实验,并将新结果更新至数据集与上下文,进入下一轮循环。这一过程确保了实验预算始终投向最具潜力的方向,而非仅依赖语言流畅度或生成似然。
慢学习闭环则着眼于跨轮次的能力沉淀。LDM不仅记录实验结果,还保存测试时搜索(Test-time Search, TTS)过程中的中间状态,包括候选提案、推理链和对应的采集函数值。研究团队据此构造加权监督微调(SFT)数据集:采集值越高的候选,其生成过程在训练中被赋予更高权重。通过这种方式,模型学习的不是静态的“最优答案”,而是如何基于历史反馈提出高价值新方向的元策略。例如,在Auto-Research任务中,模型逐渐学会在平台期主动引入新机制(如Muon优化器或n-gram记忆),而非在现有参数空间内反复微调。这种能力甚至可迁移至未见过的任务——在跨任务实验中,仅用代码和分子数据微调的模型,在抗体设计任务上仍表现出色,证明“研究策略”本身具有泛化性。
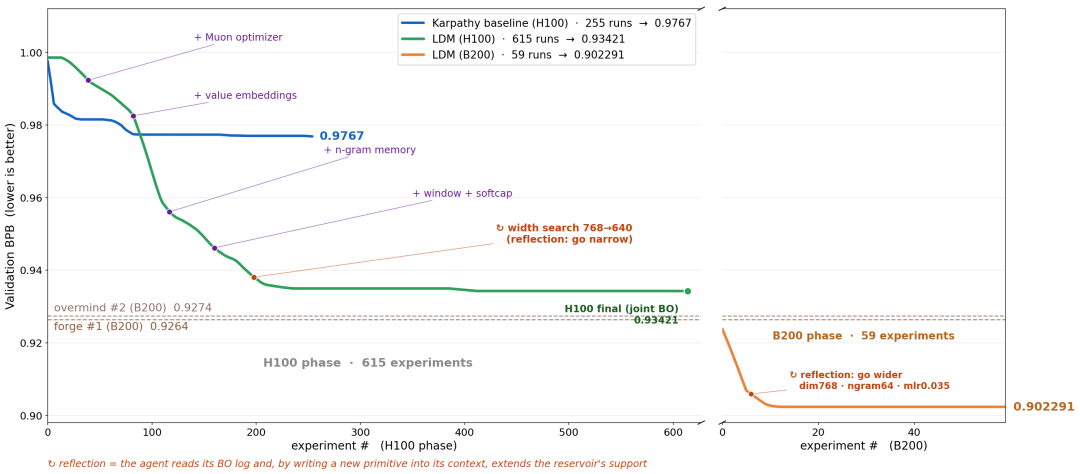
LDM在三大异构任务中展现了其通用性与有效性。首先是Auto-Research:任务要求在固定硬件和训练时长下,通过修改NanoGPT的train.py脚本最小化验证集BPB(bits per byte)。LDM不仅实现了比纯LLM反思方案2.4倍的BPB降幅,更关键的是其搜索轨迹呈现出明显的“机制跃迁”特征——从初始的AdamW调参,逐步引入value embeddings、layer scaling等新组件,最终在B200硬件上将BPB降至0.902,登顶排行榜。这表明LDM并非在固定空间内优化,而是动态重构了有效参数空间。
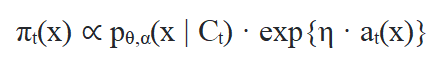
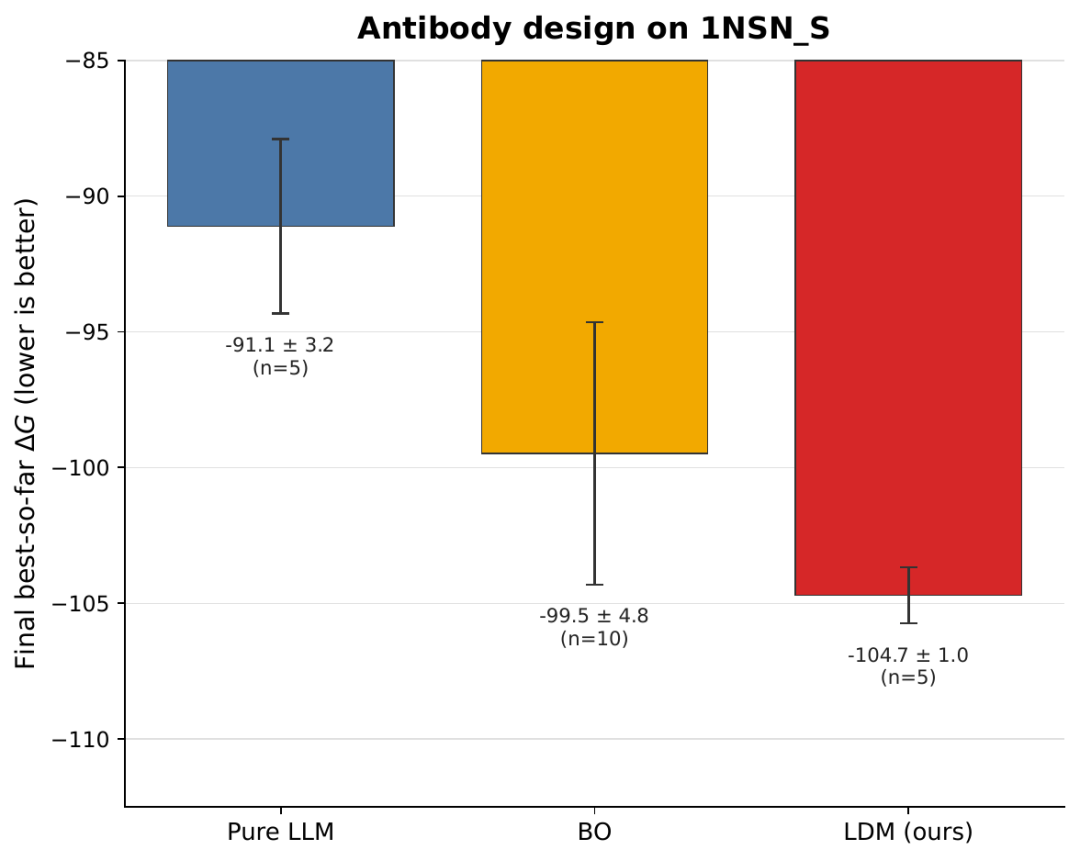
在抗体设计任务中,LDM面对的是高达20¹¹的CDRH3序列组合空间。针对五种抗原,各分配200次评估预算,以结合能为指标。结果显示,LDM平均降低结合能18.2%。其成功源于生成模型与GP的互补:LLM提供局部序列变异的先验(如保守位点约束),避免GP在全空间盲目搜索;而GP则纠正LLM因领域数据稀缺导致的生成偏差,引导其跳出局部最优基序。值得注意的是,对于抗原1H0D_C,LDM表现不佳——因其最优解依赖特定芳香/疏水motif,而模型缺乏蛋白结构先验。这一失败恰恰揭示了LDM的边界:它迁移的是决策策略,而非领域知识本身。
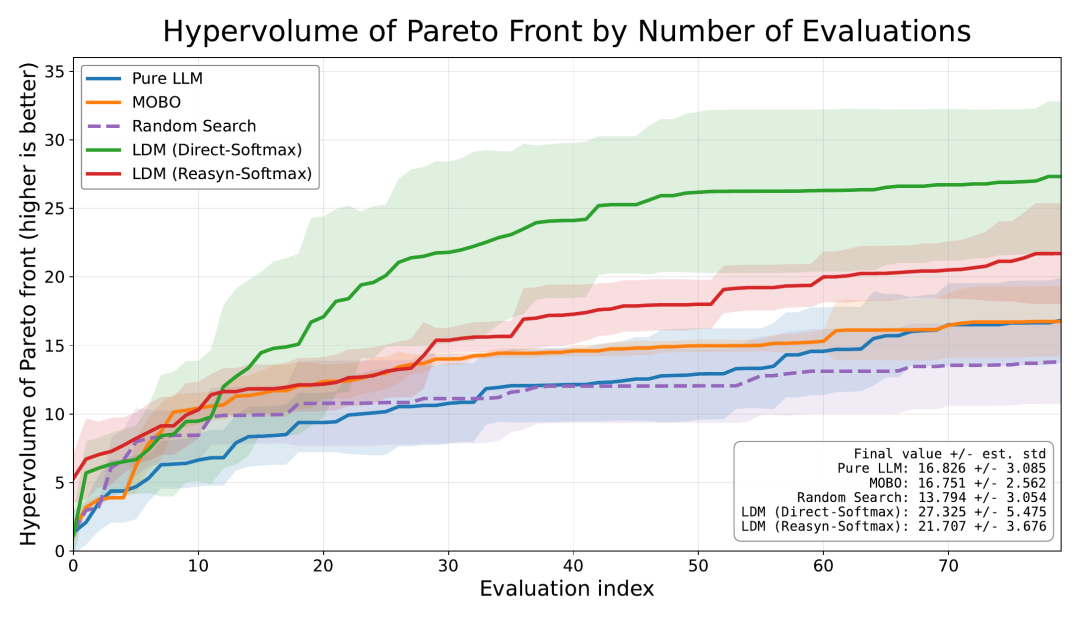
第三项任务是多目标分子优化,需同时提升KRAS G12D对接评分与神经网络预测活性。在开放SMILES空间中,传统BO易困于单一化学骨架。LDM通过生成模型提出跨骨架候选(如从苯环切换至杂环体系),再由多目标GP评估其Pareto支配性。80次评估后,其超体积指标比纯LLM提升62.4%,比多目标BO提升63.1%,证明其能有效扩张Pareto前沿。
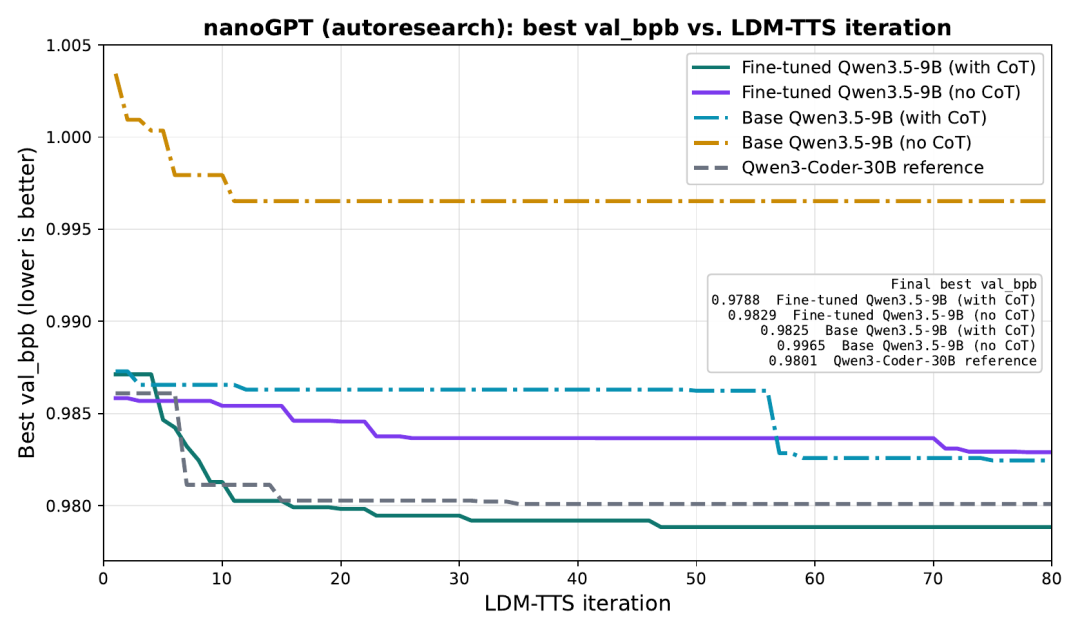
慢闭环的蒸馏效果同样令人瞩目。研究团队将高采集值轨迹蒸馏至Qwen3.5-9B模型,发现其在Auto-Research任务上的表现甚至超越了30B参数的专用代码模型。这说明LDM学到的不是具体代码片段,而是“何时引入新机制”“如何平衡探索与利用”的高阶推理能力。这种能力通过带推理链的微调得以固化,使小模型也能做出高质量提案。
当然,LDM仍面临挑战。当前实验多依赖仿真评估器,距离真实湿实验仍有差距;高斯过程在极高维或非平稳场景下的可扩展性也需改进。未来工作或将探索替代代理模型(如神经过程)、多模态表征对齐,以及与机器人实验平台的集成。但无论如何,LDM已为“自动化科学家”提供了关键范式:科学发现不仅是生成与验证,更是一种在认知边界上不断外推的递归过程。通过快慢双环的协同,LDM让AI从“聪明的生成器”迈向“有策略的研究者”,为AI for Science开辟了新路径。