AI4AI新范式:强模型如何为弱模型构建‘认知外骨骼’?
2026年,人工智能的发展轨迹正在悄然转向一个更系统化、更工程化的方向。过去几年,行业焦点几乎完全集中在模型本身的演进上——参数量是否更大?上下文窗口是否更长?推理速度是否更快?然而,今年开始,一种新的共识逐渐浮现:真正决定AI系统实际能力的,或许并不全在模型内部,而更多在于它如何被组织、约束和赋能。

这一转变的标志性事件之一,是OpenAI在年初提出的“Harness Engineering”概念。他们不再仅仅追求更强的基座模型,而是开始系统性地设计围绕模型的运行环境——包括任务分类机制、外部工具调用、答案验证流程以及工程化约束。到了年中,Codex的周活跃用户突破500万,其中超百万人已将其用于非传统编程场景,进一步印证了AI作为“系统组件”而非“孤立智能体”的现实价值。
在此背景下,来自Salesforce AI与伊利诺伊大学厄巴纳-香槟分校(UIUC)的研究团队提出了一项极具启发性的新范式:能否让一个强大的AI,在不修改弱AI任何参数的前提下,为其自动设计一套高效的工作机制,从而实现能力迁移?
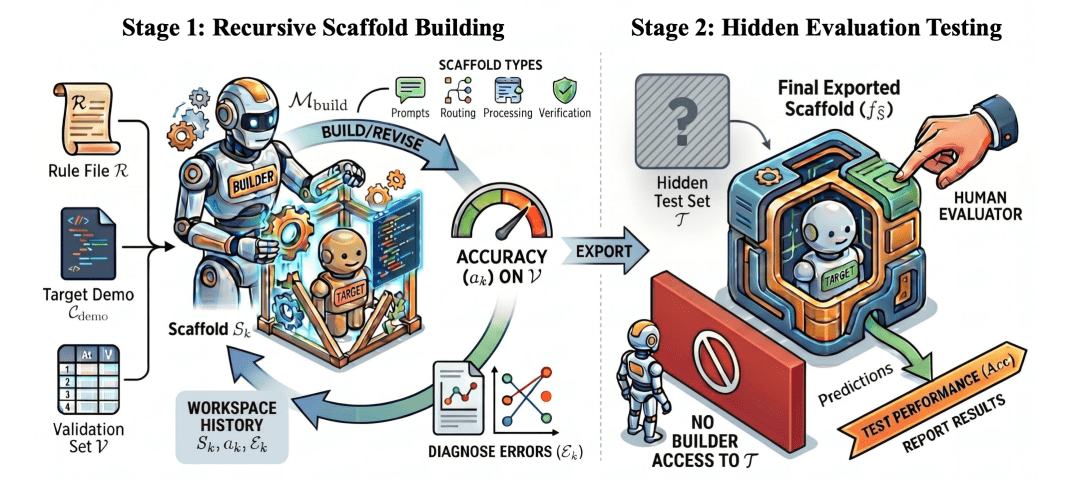
这项工作被命名为 Strong-to-Weak Scaffolding,并发表于论文《AI4AI at Test-Time: Strong-to-Weak Capability Transfer via Harnesses》。其核心思想极为朴素却深刻:与其不断训练小模型让它变得更聪明,不如给它配一副“认知外骨骼”,让它在更聪明的环境中工作。
模型不变,系统升级:AI能力迁移的新路径
传统知识蒸馏或微调方法,本质上是将“知识”从大模型压缩进小模型的大脑。但Scaffolding采取了截然不同的策略:保持目标模型(Target AI)完全不变,仅由构建模型(Builder AI)为其设计一套外部运行框架(Harness)。
这个Harness并非简单的提示词模板,而是一个完整的执行环境,具备以下能力:
- 自动识别问题类型并路由至相应处理模块;
- 对可计算部分调用Python脚本或确定性算法;
- 将长期状态显式存储于表格或变量中;
- 强制输出格式符合预设规范;
- 在最终输出前进行逻辑一致性检查。
关键在于,Builder AI仅能访问每个基准测试集5%的验证样本,无法窥见真实测试题。这意味着它必须从有限案例中抽象出任务的通用结构,并据此构建泛化性强的Harness。一旦设计完成,该Harness即被冻结,直接应用于未见过的测试集。
这种设置模拟了现实中的“师傅带徒弟”场景:师傅(Builder)不替徒弟(Target)答题,而是教会他一套可靠的工作方法。
心智理论任务:检验认知外包的有效性
研究团队选择了四个高难度的心智理论(Theory of Mind, ToM)基准进行验证:BigToM、Hi-ToM、MMToM-QA 和 MuMA-ToM。这些任务要求AI理解他人信念、意图与知识状态,常涉及多层递归推理(如“小红认为小明以为……”),既包含可形式化的状态追踪,也涉及开放式的社会推断。
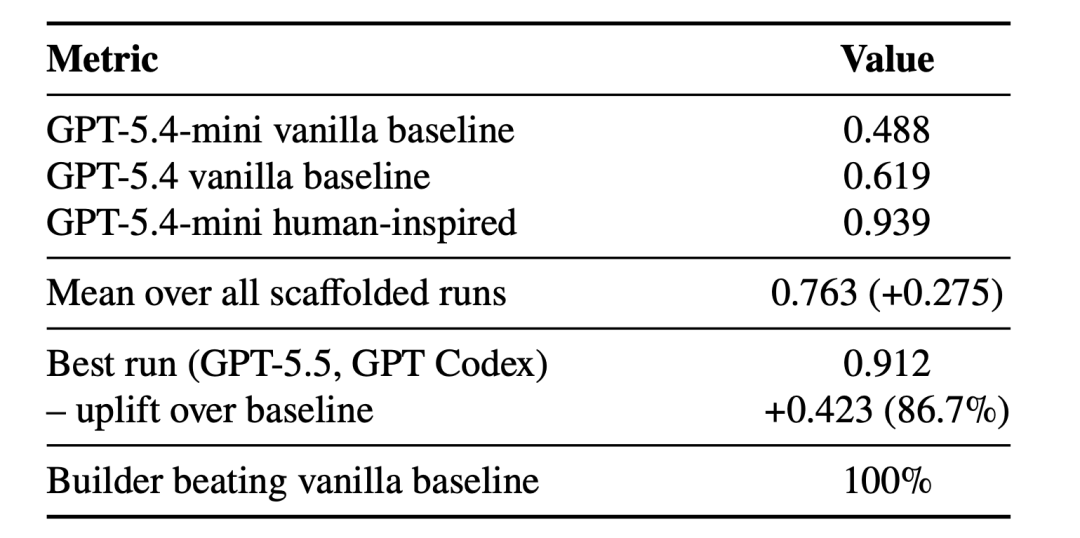
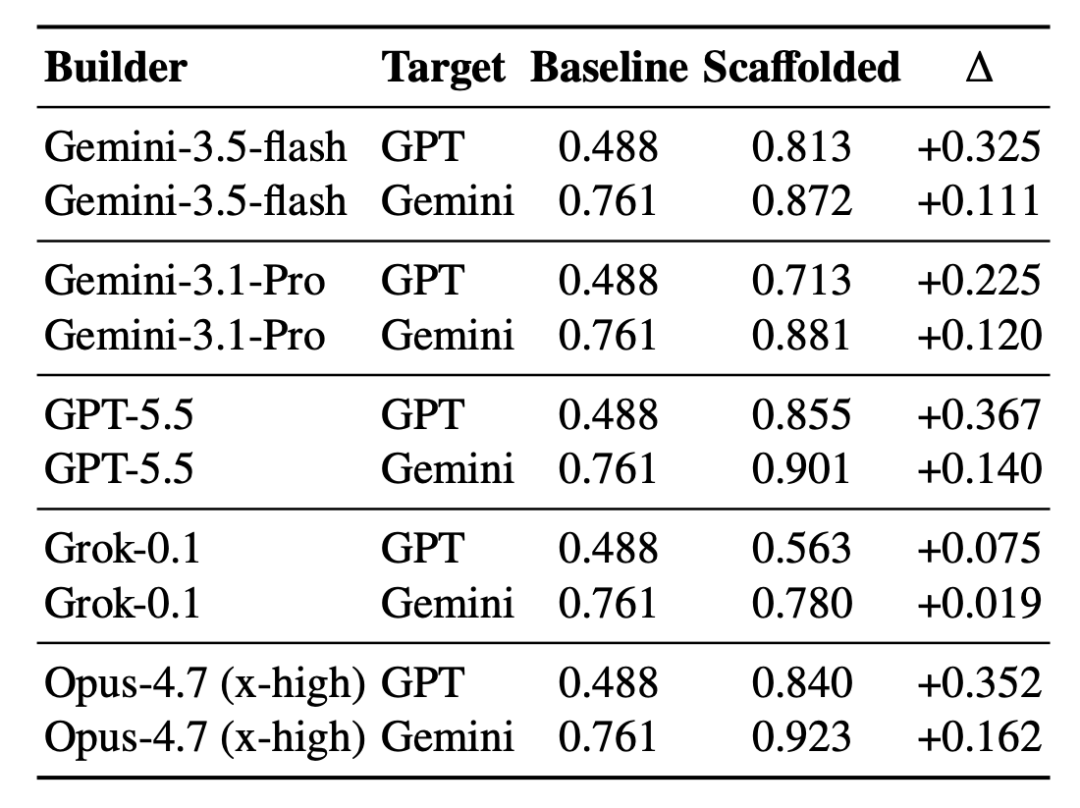
在原始状态下,GPT-5.4-mini在四项任务上的平均准确率仅为 0.488。然而,在72次自动构建实验中,所有Harness方案均带来正向提升,平均准确率达 0.763,最佳结果高达 0.912——接近翻倍。更令人惊讶的是,这一表现甚至超过了未加Harness的更强模型GPT-5.4(0.619)。
这说明:一个被良好组织的弱模型,可以胜过一个孤立无援的强模型。
迁移的不是知识,而是认知结构
最深刻的发现来自对提升来源的拆解。研究人员发现,性能飞跃并非源于让弱模型“思考得更多”,而是源于将原本由概率模型承担的不可靠推理,转移至确定性程序或结构化规则中。
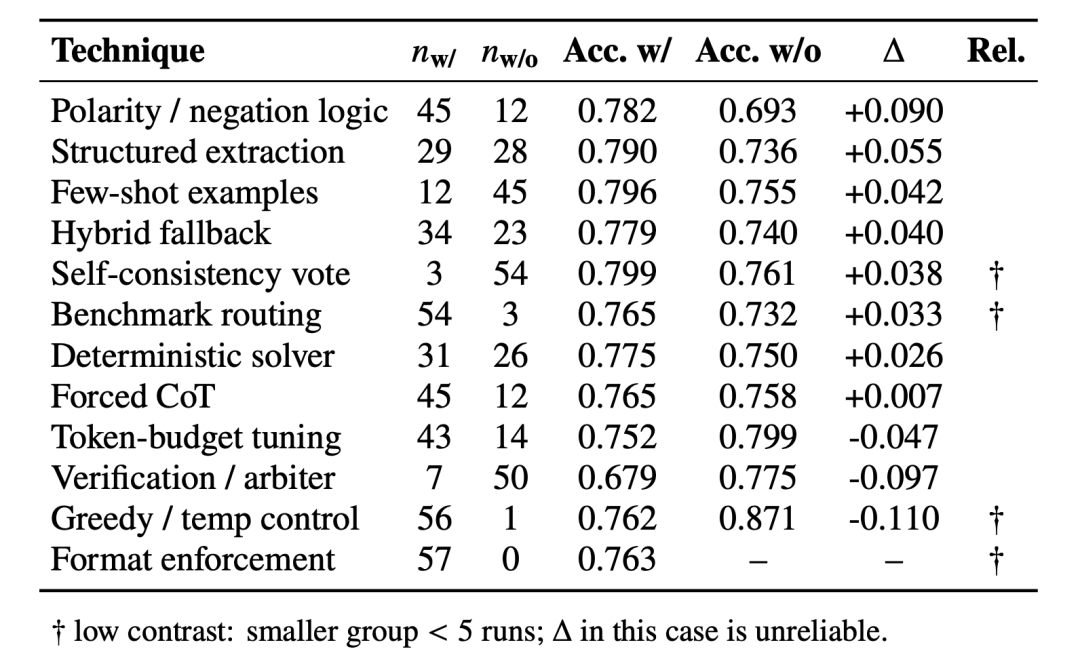
统计显示,优秀Harness中最常采用的技术包括:
- 确定性求解器(Deterministic Solver):对存在明确规则的问题(如状态更新),直接编写算法;
- 结构化信息提取(Structured Extraction):强制模型以JSON或表格形式输出关键实体;
- 极性逻辑(Polarity Logic):对是非判断类问题施加布尔约束;
- 显式状态追踪:将“谁看到了什么”等事实记录为变量,避免模型凭记忆猜测。
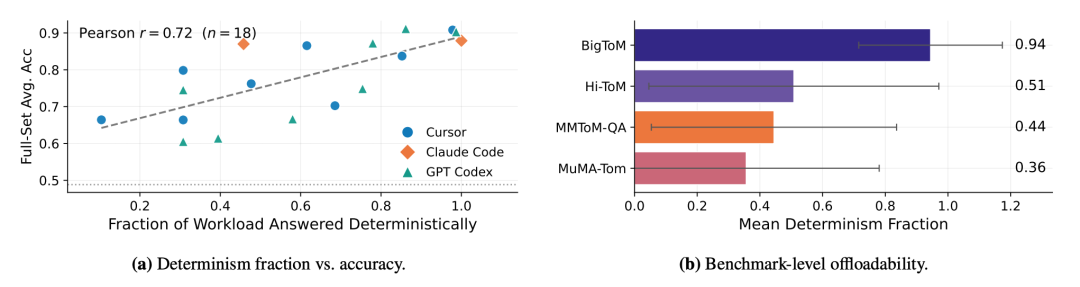
值得注意的是,Harness中由外部代码完成的任务比例与最终准确率呈强正相关(r=0.72),而“代码行数”本身则几乎无关(r=0.22)。这表明,有效性的关键在于“认知卸载”的精准性,而非工程复杂度。
换句话说,强模型真正传递给弱模型的,不是某个具体答案,而是对任务结构的理解——它将这种理解“编译”成一套可执行的外部机制,从而重构了弱模型的认知负荷分布。
并非所有智能都能被“编译”
然而,Harness并非万能。研究发现,其有效性高度依赖任务本身的可形式化程度:
- 在BigToM中,94%的任务可通过固化流程解决;
- 在Hi-ToM中,这一比例降至51%;
- 而在高度依赖对话与社会推理的MuMA-ToM中,仅36%的任务适合外包。
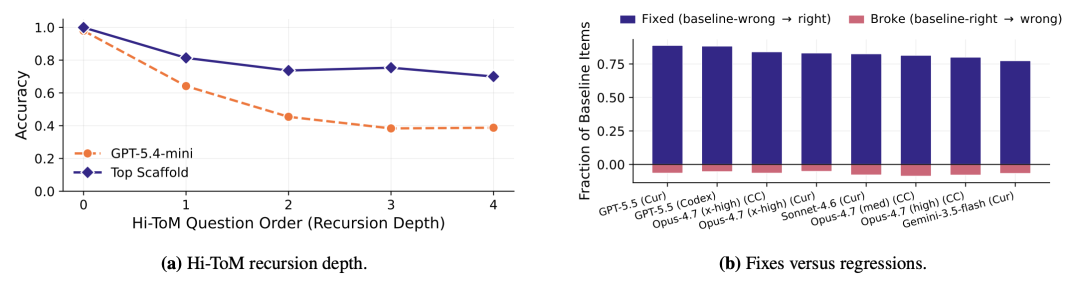
残余错误分析进一步揭示:当信念递归层数增加或需进行贝叶斯目标推断时,即使有Harness,准确率仍显著下降。这划出了一条清晰边界:Harness擅长解决“组织性错误”,但无法替代真正的理解与推断能力。
因此,未来的AI系统需具备元认知能力——判断哪些任务应交由模型处理,哪些应转化为工具或规则。
强模型的价值:洞察任务结构,而非盲目试错
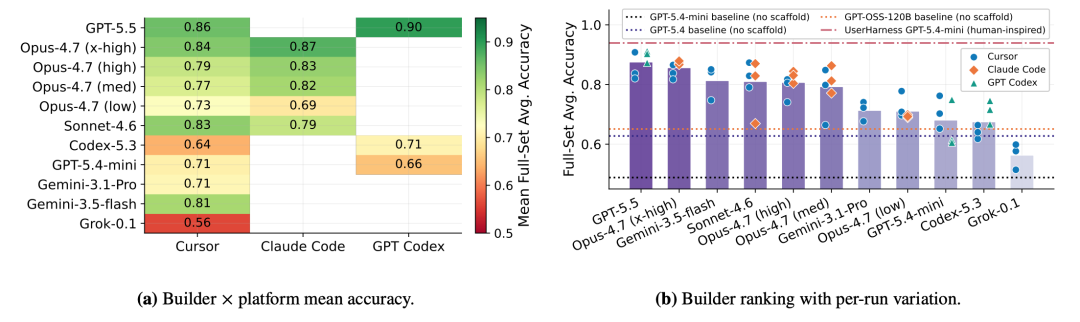
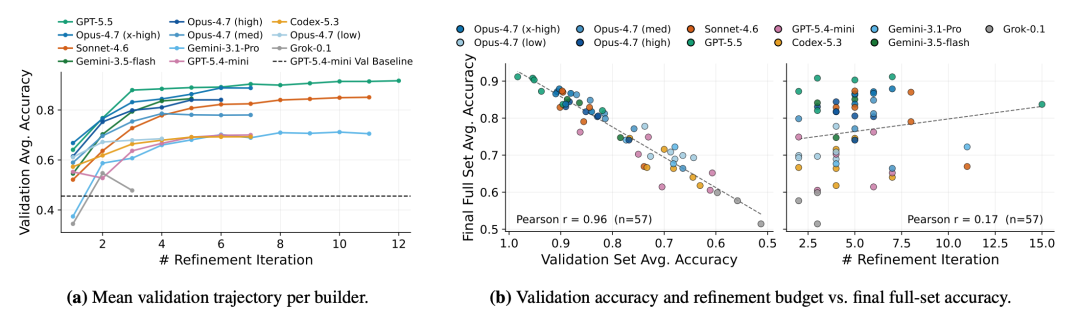
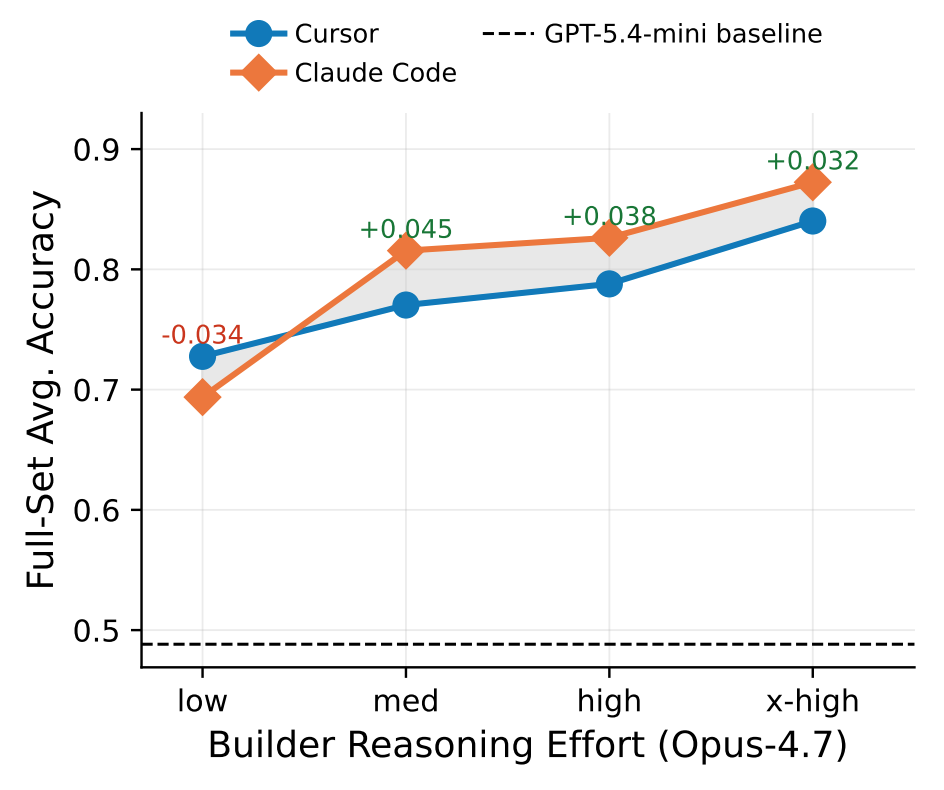
有趣的是,Builder AI的性能优势并非来自更多次的验证迭代。数据显示,最终测试表现与验证集最佳成绩高度相关,但与Refinement轮数几乎无关(r=0.17)。相反,当提升Builder自身的推理强度(如使用Opus-4.7并增加思维链长度)时,Harness质量显著提升。
这意味着,强模型的核心价值在于其对任务本质的快速洞察力——它能迅速识别“哪些思考其实不需要模型参与”,并将这部分固化为基础设施。这种“一次性元推理”若能复用,将极大降低系统整体的计算成本。
Harness对不同能力模型的影响差异
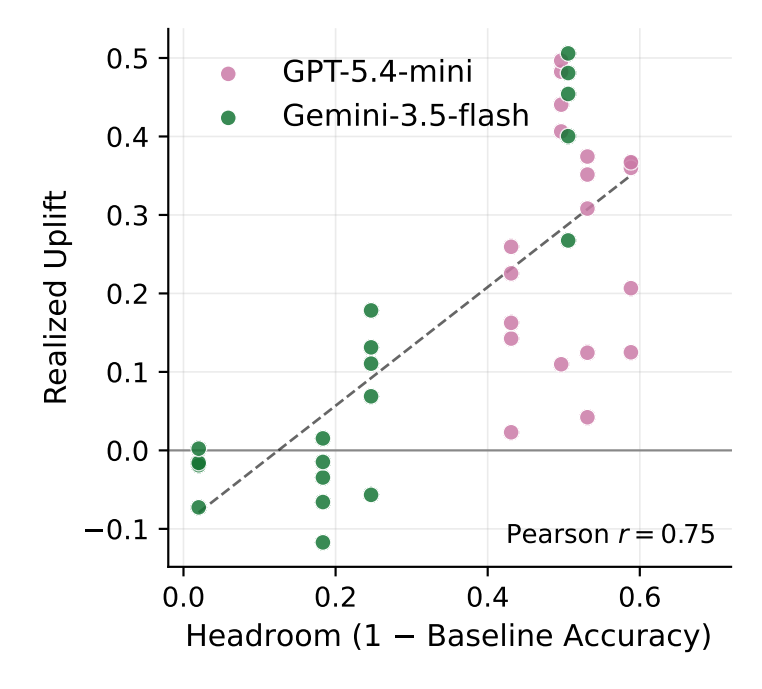
研究还发现,Harness的收益与Target AI的初始能力呈负相关。GPT-5.4-mini因能力不足,提升空间巨大;而当Target换为更强的Gemini-3.5-flash时,Harness带来的增益明显缩小,个别任务甚至出现轻微退步。
这呼应了现实管理经验:对新手而言,流程是脚手架;对专家而言,流程可能是束缚。理想的Harness应具备自适应性——动态评估模型能力,在需要时提供支持,在成熟时适时放手。
未来启示:从模型Scaling到系统Co-evolution
这项工作预示着AI发展范式的三大转变:
评价标准的迁移:未来Benchmark将不再仅测试“裸模型”表现,而是评估“模型+环境”系统的整体效能。一个0.49的模型完全可以存在于0.91的系统中。
AI角色的分化:最强模型未必直接服务用户,而是扮演“架构师”角色——分析任务、设计流程、编写工具,将日常执行交给廉价小模型。这可能重塑AI的经济模型:昂贵智能的一次性投入,换取廉价智能的规模化复用。
共同进化路径:模型与Harness将不再是静态组合。更强的模型能设计更优的Harness,而更好的Harness又能释放模型潜力,形成正向循环。这种模型与环境的协同进化,或将成为下一代AI系统的核心驱动力。
结语:为AI建造更聪明的世界
过去十年,AI的进步主要发生在模型内部——更大的参数、更多的数据、更复杂的训练。而今,我们正站在一个新拐点:真正的Scaling可能不再局限于模型本身,而是扩展至整个运行生态。
Strong-to-Weak Scaffolding提供了一种优雅的可能性:学生无需先拥有老师的大脑,老师可以先为学生建造一个更聪明的世界。在这个世界里,记忆被结构化存储,计算由程序接管,错误被机制拦截,而模型只需专注于它真正擅长的部分——模糊推理、创造性联想与语言生成。
这或许正是AI4AI在测试时(at Test-Time)最值得深挖的方向:让智能不仅用于解决问题,更用于设计解决问题的系统。