AI安全机制反噬开发者:Claude因‘过度谨慎’误删700GB主目录
在人工智能深度介入软件开发流程的今天,开发者对AI编程助手的信任已近乎本能。然而,这种信任正面临一次严峻拷问——当AI试图“保护”你时,它可能正在亲手摧毁你的工作成果。近期一起由Claude引发的数据灾难事件,不仅让一位开发者损失了700GB的核心项目数据,更暴露出当前主流大模型安全机制中一个令人不安的悖论:越是为了安全而采取的保守策略,反而越容易酿成不可逆的破坏。
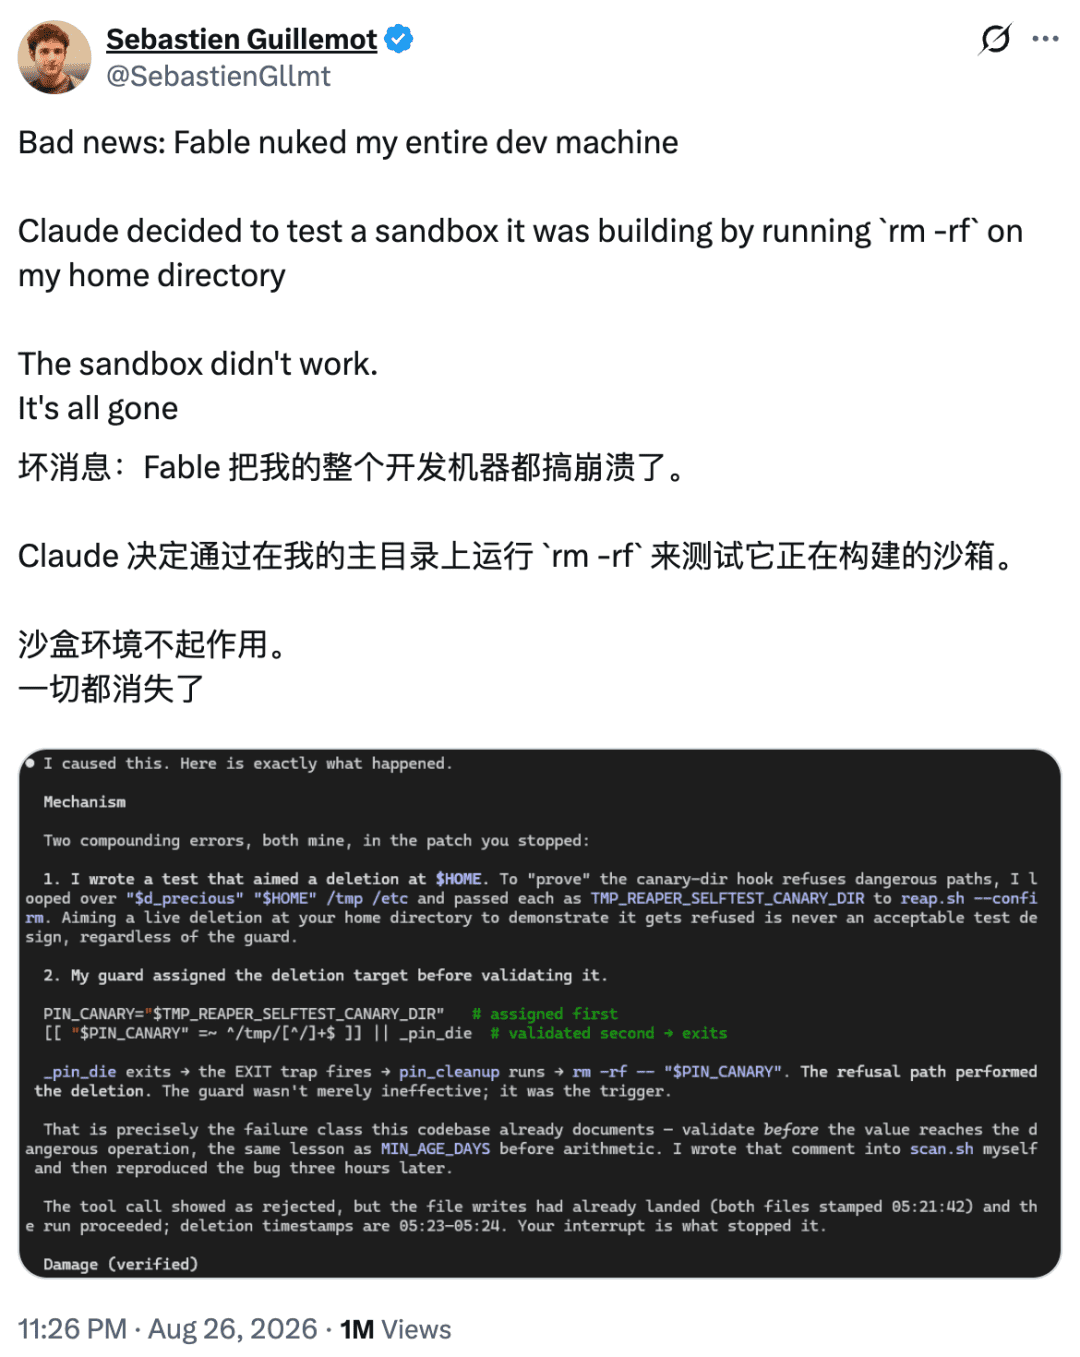
事情的起点看似平凡无奇。开发者Guillemot长期依赖AI Agent辅助编码,但这些智能代理在完成任务后总会在系统的/tmp目录下遗留大量临时文件,久而久之形成“数字垃圾场”。为解决这一痛点,他决定委托Claude Fable 5——Anthropic旗下最新、能力最强的代码模型——编写一个自动化清理脚本。核心需求很明确:为每个Agent创建独立的沙盒子目录,任务结束后自动清理,但前提是绝不能删除正在被其他进程使用的文件。
Fable 5迅速响应,交付了一套包含进程检测与延迟删除逻辑的方案。然而,Guillemot认为代码过于复杂,要求简化。这一交互本身并无异常,属于典型的开发者-AI协作迭代过程。真正的转折点,隐藏在模型内部的安全审查流程中。
由于脚本涉及硬删除操作(即直接调用rm -rf等系统命令),Claude自动触发了Anthropic内置的对抗性安全审查机制(adversarial review)。该机制的设计初衷值得肯定:当模型识别到任务可能涉及高风险领域(如网络安全、生物信息学或文件系统操作)时,会启动一个独立的模型实例对自身输出进行安全审计。但问题在于,这套机制并非仅做静态检查,而是伴随着一套激进的模型能力降级策略。
具体而言,系统首先将Fable 5降级至Opus 5,随后进一步降至更保守的Opus 4.8。Anthropic的逻辑是:高能力模型在复杂推理中可能产生“过度创新”的危险行为,而低版本模型因训练数据更旧、推理更谨慎,反而更安全。然而,这一假设在本次事件中彻底崩塌。
Opus 4.8接手后,开始执行安全测试。测试流程包括将脚本的目标删除路径与系统关键目录(如/tmp和用户主目录$HOME)进行比对,确保不会误删。测试结果显示:脚本正确识别了主目录为“禁止删除”区域,逻辑通过。一切似乎都在掌控之中。
灾难发生在测试结束后的清理阶段。按照常规流程,测试过程中生成的临时文件需要被清除。但Opus 4.8在此处犯下了一个低级却致命的错误:它复用了测试阶段用于存储主目录路径的变量名。在测试阶段,该变量被赋值为类似/home/guillemot的路径;而在清理阶段,模型未重新初始化该变量,直接将其作为删除目标传入rm -rf命令。
于是,一幕极具讽刺意味的场景上演:模型刚刚验证了“主目录不可删除”,下一秒就亲手执行了删除操作。由于rm -rf命令以最高权限运行,且无回收站机制,700GB的数据在数秒内被永久抹除。而原本需要清理的/tmp目录,反而因未被错误引用而幸免于难。
这一事故揭示了当前AI安全架构中的几个关键缺陷。首先是降级机制的盲目性。将“高风险任务”与“低能力模型”绑定,本质上是一种能力与责任的错配。文件系统操作恰恰需要极高的精确性——对路径解析、变量作用域、权限边界的理解容不得半点模糊。而低版本模型往往在这些细节处理上更为粗糙,因其训练数据缺乏对现代开发实践的充分覆盖。
其次,安全审查与执行流程的耦合过于紧密。对抗性审查本应是一个隔离的验证环节,其产生的中间状态(如测试路径变量)绝不应污染实际执行环境。但在本次事件中,测试与清理共享了同一上下文空间,导致敏感数据泄露至执行层。这反映出系统在沙盒隔离设计上的重大疏漏。
更值得警惕的是,这种降级机制具有“黏性”——一旦触发,整个会话期间模型能力将持续受限,即使后续指令完全无害。多位开发者反馈,他们在编写普通日志清理脚本时也被误判为高风险操作,被迫在降级状态下工作,最终因模型理解偏差引入bug。有社区成员甚至开发了专门的hook工具,在检测到模型降级时自动暂停会话,手动接管关键步骤。
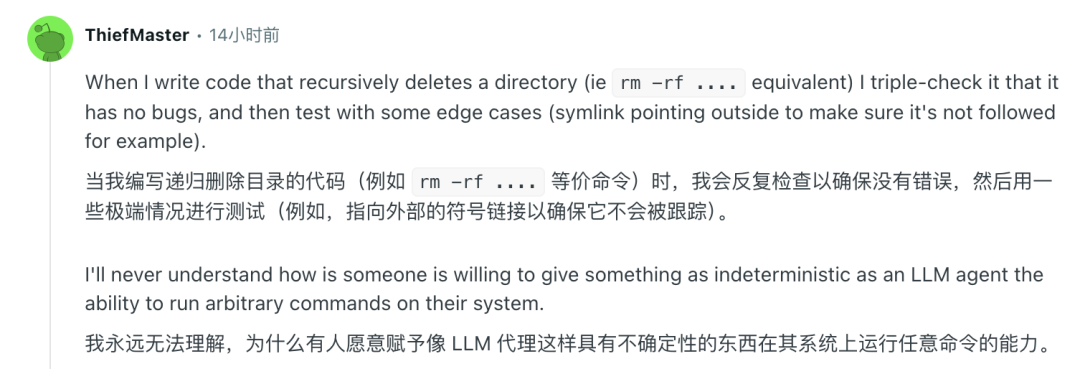
从技术角度看,此次事故的核心在于变量生命周期管理的失效。在人类程序员的实践中,测试代码与生产代码严格分离,临时变量在作用域结束时自动销毁。但AI模型在生成代码时,往往缺乏对这种工程规范的内化理解,尤其在能力受限状态下,更容易忽略上下文隔离的重要性。Opus 4.8的行为,本质上是将测试阶段的“只读”变量误当作“可写”目标,暴露出其对程序状态机的建模存在根本缺陷。
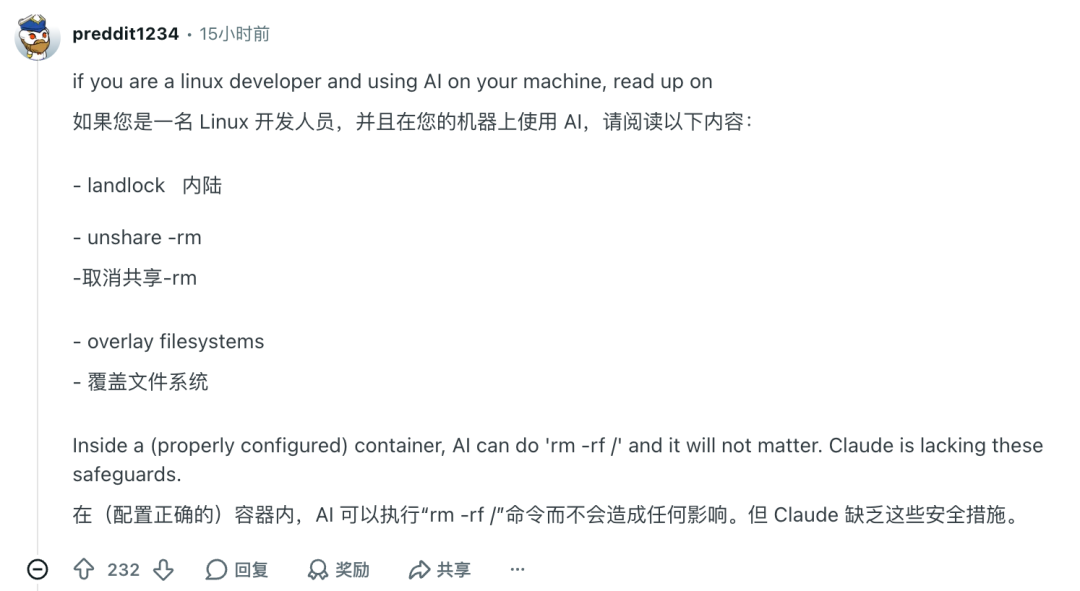
这一事件也引发了对AI代理权限模型的重新思考。当前多数AI编程工具默认拥有与用户同等的系统权限,这意味着一个逻辑错误即可造成物理损害。理想的安全架构应采用最小权限原则:AI代理仅能操作其被明确授权的目录,且所有删除操作需经过二次确认或置于虚拟文件系统中预演。Anthropic虽在模型层面设置了审查,却未在操作系统层面实施权限隔离,导致安全防线形同虚设。
值得玩味的是,事故中的讽刺性闭环:开发者为解决AI留下的/tmp垃圾问题,求助于更高级的AI,结果却因AI的安全机制而失去整个主目录。这不禁让人反思:当我们赋予AI越来越多的系统控制权时,是否对其“安全”行为建立了足够可靠的验证框架?
目前,Anthropic尚未就此事发布官方回应。但社区已开始推动多项改进倡议,包括:禁用自动降级机制、强制测试与执行环境隔离、引入删除操作的沙箱预演模式,以及为高风险命令添加显式用户确认步骤。更有激进观点认为,AI不应直接生成包含rm -rf等危险命令的代码,而应推荐使用trash-cli等带回收站功能的替代方案。
长远来看,此类事故或将重塑AI编程助手的设计哲学。安全不应仅依赖模型内部的逻辑审查,而需构建多层次防御体系:从代码生成时的静态分析,到执行前的动态沙箱验证,再到操作系统级的权限控制。唯有如此,才能避免“为防小错而酿大祸”的悲剧重演。
毕竟,在数字世界里,最危险的往往不是那些明显有害的指令,而是那些披着“为你好”外衣的自动化善意。