额度博弈:Anthropic降档VS OpenAI重置,开发者该站哪边?
近期,人工智能编程助手(Coding Agent)领域的竞争焦点正悄然从“谁更聪明”转向“谁更省额度”。这一转变的背后,是开发者对实际使用成本与资源效率日益敏感的现实需求。就在同一个周末,Anthropic 和 OpenAI 几乎同步发布了关于各自 Coding Agent 额度策略的重大调整,但方向却大相径庭,引发社区激烈讨论。
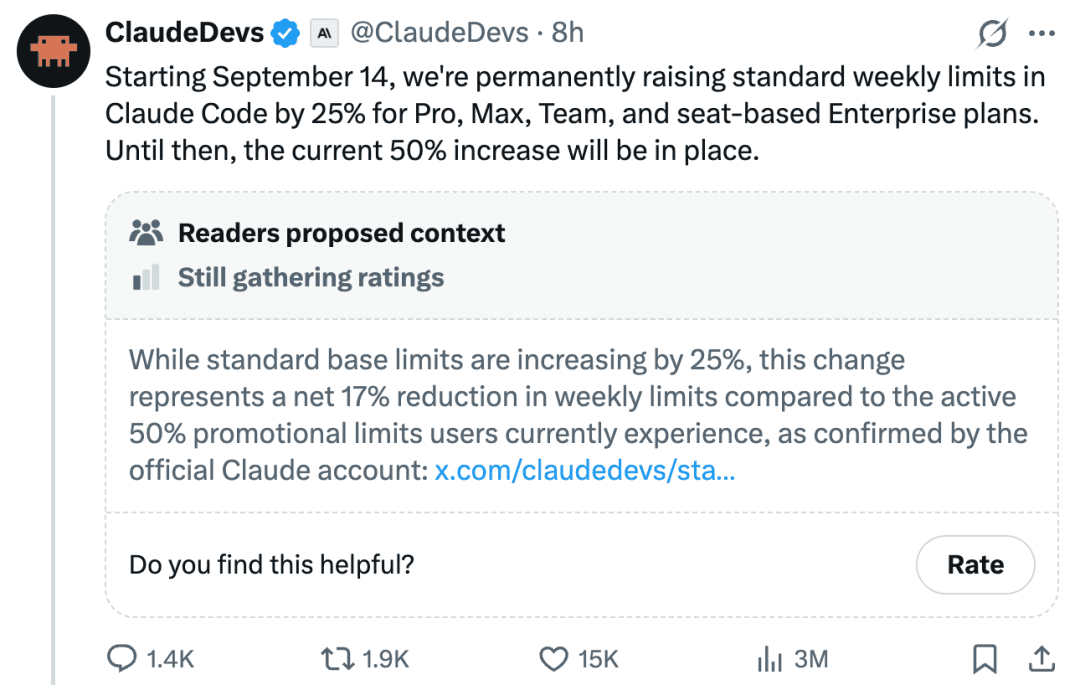
Anthropic 的公告看似利好:自9月14日起,Claude Code 的“标准每周额度”将永久提升25%,覆盖 Pro、Max、Team 及按席位计费的 Enterprise 套餐。然而,细心的用户很快发现,当前所有用户正处于一轮 临时 +50% 的周额度优惠期。这意味着,所谓“永久加量25%”,实际上是相对于历史基准而言;若与当下实际可用额度相比,用户每周将 净减少约17% 的资源。
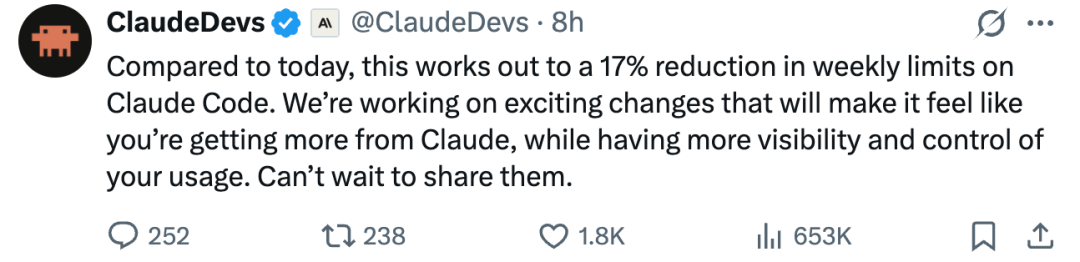
Anthropic 并未回避这一事实,反而在公告中坦率承认:“与今天相比,您的周额度将减少17%。”其解释是,过去几个月的临时扩容是为了收集用户行为数据,以探索“未来能够可持续提供多少服务”。这种表述虽显务实,却难掩用户被“温水煮青蛙”的感受——先给甜头,再收回部分,最后包装成“永久福利”。
相比之下,OpenAI 的做法显得更具用户导向。Codex 负责人 Tibo(Thibault Sottiaux)宣布,为所有 Codex 和 ChatGPT Work 付费用户 重置使用额度,并强调团队已修复数千份用户报告中指出的“偷偷吃掉额度”的问题。据官方测算,修复后,同样的额度可支持比之前多10%至50%的实际使用量。这意味着用户不仅获得了“清零重启”的机会,还实质上获得了性能优化带来的隐性增益。
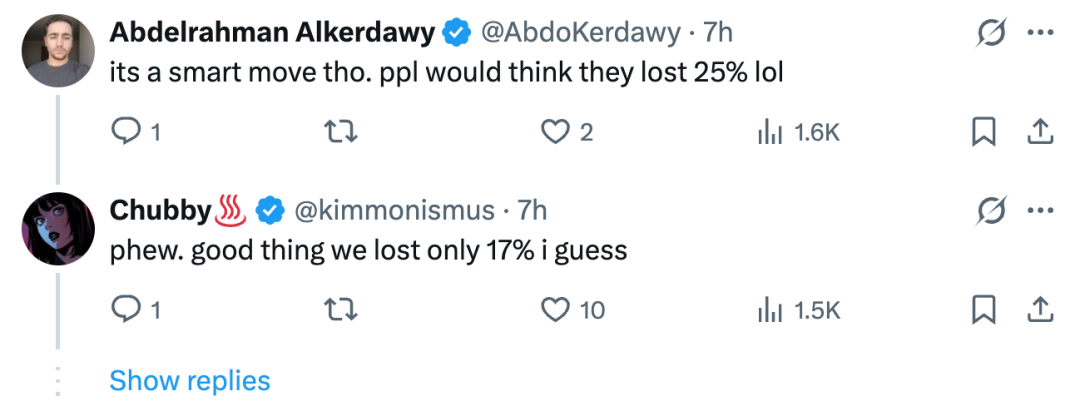
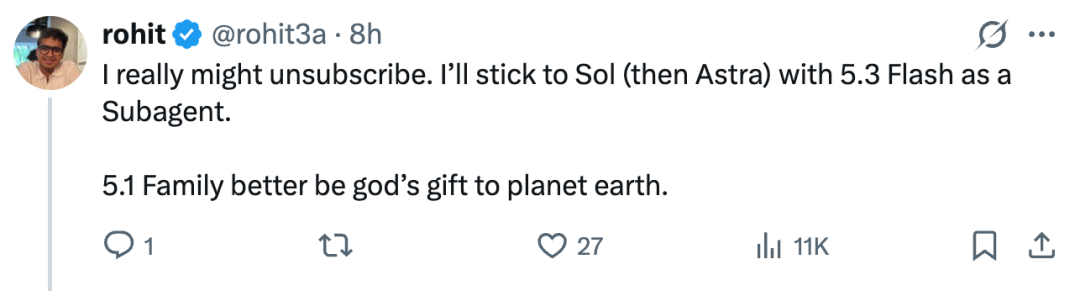
这种差异迅速在开发者社区发酵。有用户调侃 Anthropic 的话术:“他们说‘永久加量25%’,但没告诉你基准已经变了。”另一条评论则讽刺道:“呼,还好我们只损失了17%。”更有开发者直言考虑迁移至 OpenAI 或 Google 的模型生态:“如果你们在额度上如此反复,那接下来的 Claude 5.1 系列最好强得离谱,否则我真没理由继续订阅。”
从产品策略角度看,Anthropic 的调整反映了一种典型的“测试-收敛”路径:通过短期激励获取真实使用数据,再据此设定长期服务边界。这在技术探索初期无可厚非,但问题在于,当用户已将临时额度纳入日常开发节奏后,突然回调极易引发信任危机。尤其对于依赖持续集成、自动化测试或长时间 Agent 协作的团队而言,额度波动直接影响交付稳定性。
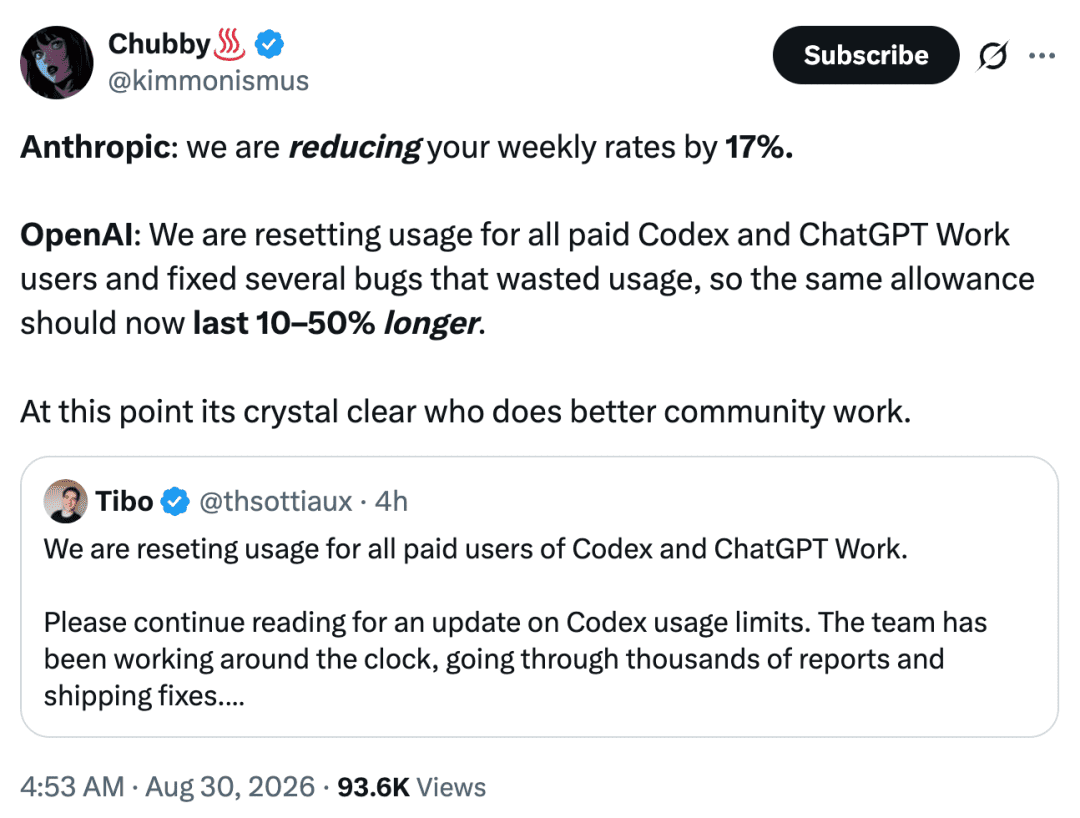
而 OpenAI 的重置+优化组合拳,则更贴近开发者对“确定性”的渴求。修复“偷吃额度”的 Bug 本身,就是对资源透明度的回应。许多用户曾抱怨,在复杂任务中,Agent 调用工具链、生成中间代码、回溯错误等操作会无预警地快速消耗额度,却难以追踪具体去向。此次修复不仅提升了资源利用效率,也间接增强了用户对系统行为的可控感。
值得注意的是,这一轮额度博弈背后,是 Coding Agent 使用模式的根本性演变。早期,Agent 主要用于单次代码补全或简单调试;如今,它已演变为可连续工作数小时、协调多个子 Agent、调用外部 API 甚至参与 CI/CD 流程的“数字员工”。在此场景下,模型的智能程度固然重要,但 资源消耗的可预测性与经济性 已成为同等甚至更重要的考量维度。
例如,一个典型的现代开发工作流可能包含:主 Agent 分析需求 → 拆解为子任务 → 启动多个子 Agent 并行生成模块 → 调用测试工具验证 → 自动修复失败用例 → 整合输出。这一过程可能触发数十次模型调用,每次调用的 token 消耗、工具调用成本、上下文长度等因素叠加,极易导致额度超支。若平台无法提供清晰的消耗明细或优化建议,用户将陷入“黑箱焦虑”。
正因如此,Anthropic 在公告末尾预告将推出“新的使用机制”,让用户“感觉获得更多”并“更清楚地看到和控制额度消耗”。这暗示其已意识到透明度缺失的问题,但能否兑现承诺仍需观察。相比之下,OpenAI 此次通过技术手段直接提升单位额度效能,属于“做实事”而非“画饼”。
从商业模型看,两家公司也面临不同压力。Anthropic 作为相对年轻的 AI 公司,需在算力成本与用户体验间寻找平衡点。其 Claude 系列模型参数规模庞大,推理成本高昂,长期维持 +50% 额度确实难以为继。而 OpenAI 背靠微软 Azure 的强大基础设施,且 Codex 已运行多年,优化空间更大,有能力通过工程改进释放效率红利。
但这并不意味着 Anthropic 的策略完全错误。关键在于沟通方式与过渡安排。若能在宣布回调前提供详细的消耗分析工具,或允许用户选择保留部分临时额度(哪怕付费),或许能缓解反弹情绪。目前的做法更像是“先斩后奏”,容易让用户产生被剥夺感。
长远来看,Coding Agent 的竞争将不再局限于模型能力排行榜,而是进入“全栈体验”时代——包括额度管理、错误恢复、工具集成、成本可视化等多个维度。谁能率先构建 高效、透明、可预测 的使用环境,谁就能赢得开发者的心智份额。
事实上,已有迹象表明,开发者开始将“额度性价比”纳入选型标准。GitHub Copilot 虽未公开详细额度机制,但其与 VS Code 深度集成、按月订阅无硬性限制的模式,使其在轻量级场景中仍具优势。而新兴平台如 Cursor、Continue 等,则通过本地模型+云模型混合架构,让用户在敏感任务中优先使用本地资源,从而规避云端额度限制。
回到本次事件,Anthropic 与 OpenAI 的对比,本质上是一场关于“用户信任”的实验。前者试图通过数据驱动设定长期边界,后者则选择以技术优化回馈用户忠诚。短期内,OpenAI 的做法显然更受欢迎;但长期而言,Anthropic 若能兑现其“新机制”承诺,建立更精细的额度控制系统,仍有机会扳回一城。
对开发者而言,这场博弈提醒我们:在拥抱 AI 编程助手的同时,必须建立对资源消耗的主动管理意识。建议采取以下措施:
- 定期审查额度使用报告:关注哪些任务类型消耗最快,是否存在异常调用;
- 设置使用阈值告警:避免月末突然额度耗尽影响项目进度;
- 评估混合方案:关键任务使用高额度平台,常规任务切换至低成本或本地模型;
- 参与社区反馈:推动平台提供更细粒度的消耗明细与优化建议。
最终,AI 编程助手的价值不应仅由“能写多少行代码”衡量,更应体现在“每一分额度能创造多少价值”上。当 Agent 成为开发流水线的常规组件,资源效率将成为与代码质量同等重要的指标。而这场始于额度的博弈,或许正是行业走向成熟的第一步。