Mac成AI训练新宠?苹果与英伟达争夺桌面智能体算力战场
近年来,人工智能的发展路径正经历一场静默却深刻的结构性转变。过去几年,行业焦点几乎全部集中在超大规模数据中心、万卡级GPU集群和千亿参数模型的训练上。然而,2026年的一个意外现象打破了这一叙事:顶级AI实验室开始大规模采购原本面向消费者的苹果Mac设备——尤其是体积小巧、价格亲民的Mac mini和高性能的Mac Studio。据《The Information》披露,OpenAI在过去几个月内购入数万台此类设备,用于开发能够自主操作电脑的“计算机使用智能体”(Computer-Using Agent)。这一举动不仅令人惊讶,更揭示了一个正在成型的新范式:AI算力的部署重心,正从遥远的数据中心向每一张办公桌、每一个家庭机房悄然迁移。
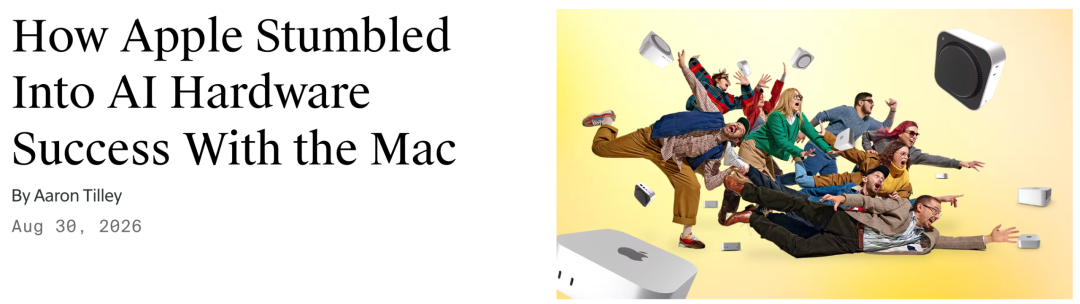
这种转变的核心驱动力,来自于智能体技术对“真实操作系统环境”的刚性需求。当前最先进的AI智能体,如OpenAI正在研发的系统,不再满足于仅通过API调用完成任务。它们需要像人类一样,在图形用户界面(GUI)中点击按钮、拖拽文件、切换应用、填写表单,甚至处理复杂的多步骤工作流。这类操作无法在纯模拟环境中可靠复现——界面渲染差异、权限机制、后台进程干扰等因素都会导致训练数据失真。因此,研究团队迫切需要大量可并行运行、可快速重置、且完全真实的macOS实例作为训练沙盒。而Mac mini凭借其低功耗、无风扇设计(部分型号)、紧凑体积和完整的macOS原生支持,意外成为理想载体。
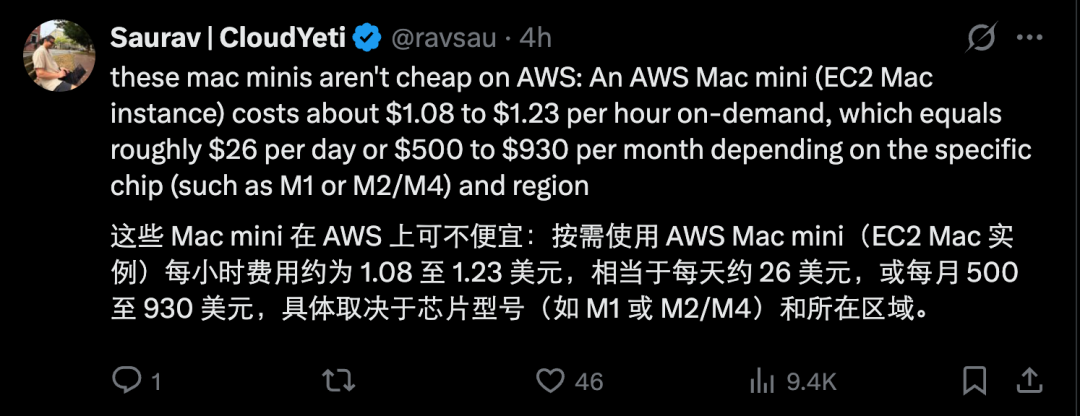
值得注意的是,这并非意味着AI主模型训练已从英伟达GPU集群转向苹果芯片。事实上,OpenAI和Anthropic仍严重依赖数据中心级加速器进行大规模参数更新。Mac在此扮演的角色更接近“交互执行层”:负责生成高质量的操作轨迹、验证智能体行为的正确性、执行轻量级本地推理,以及进行后训练阶段的微调与评测。这种分工体现了AI系统架构的分层化趋势——底层由GPU集群处理高密度计算,上层由本地设备处理与真实世界交互的“最后一公里”问题。
苹果M系列芯片的独特架构为此类任务提供了天然优势。其统一内存架构(Unified Memory Architecture)允许CPU、GPU和神经网络引擎共享同一块高速内存池,避免了传统PC中独立显卡需频繁在系统内存与显存之间搬运数据的瓶颈。最新发布的M5 Ultra Mac Studio最高可配置512GB统一内存,带宽高达1.2TB/s。这意味着即便是经过量化压缩的百亿级大模型,也能完整加载到单机内存中,实现低延迟、高吞吐的本地推理。此外,Mac Studio的主动散热设计使其能够长时间维持高负载运行,远优于多数轻薄笔记本的被动散热方案。
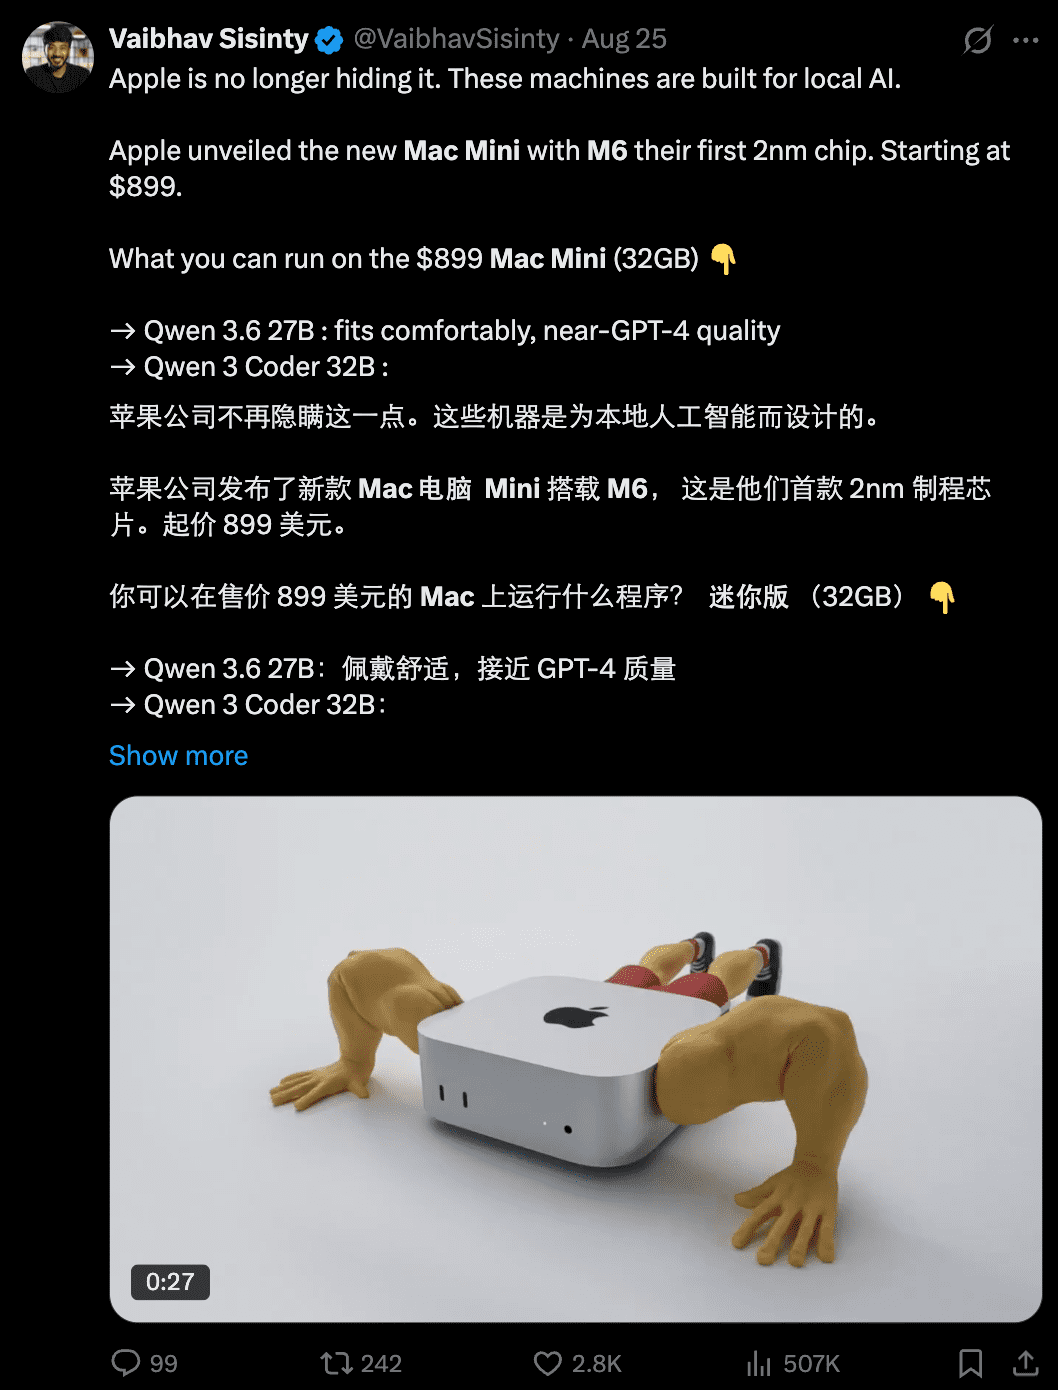
更关键的是,苹果正迅速将这一偶然需求转化为战略方向。2026年8月发布的新款M6 Mac mini和M5 Ultra Mac Studio,其营销重点已明显从“家庭娱乐”或“创意工作站”转向“设备端AI”和“多机集群推理”。官方明确鼓励开发者在Mac上本地运行、微调甚至部署大模型。这种定位转变直接反映在价格上:M6 Mac mini在中国起售价达6999元,相较2024年M4版本的4499元上涨约56%。虽然芯片迭代是因素之一,但高容量内存和存储模组的成本飙升同样推高了整机定价。市场数据显示,配备64GB或更高内存的Mac mini在2026年上半年多次出现数周乃至数月的交付延迟,企业客户订单排期显著拉长。
苹果的财务表现印证了这一转型的成功。2026财年第三季度,Mac业务收入达103.52亿美元,同比增长28.7%,增速远超iPhone、iPad等其他硬件品类。尽管Mac在美国整体销量占比仍不高,但在高内存配置机型中,企业与开发者采购比例急剧上升。一位前苹果企业AI产品营销经理坦言,公司最初并未预料到Mac会在企业AI市场走红,相关工程支持和开发者生态建设滞后。直到今年6月,苹果才在Apple Park举办闭门企业活动,邀请Anthropic联合创始人等关键客户参与,将Mac mini作为核心展示产品。
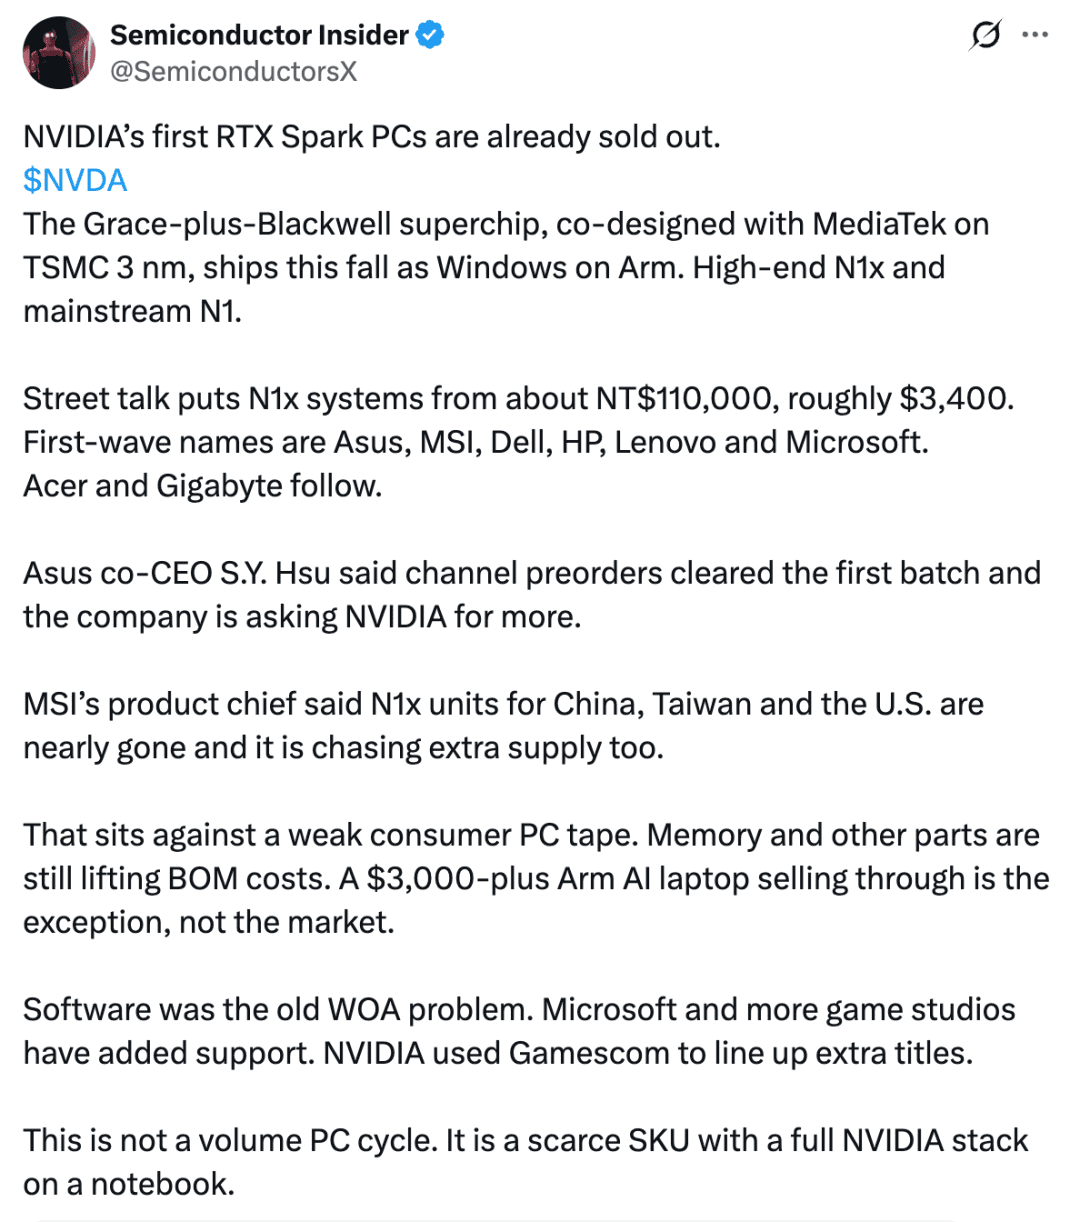
然而,苹果并非唯一瞄准这一赛道的巨头。英伟达的反应同样迅速且更具针对性。从早期的DGX Spark到2026年推出的RTX Spark平台,英伟达正将数据中心级AI算力“微型化”,集成Grace CPU与Blackwell GPU,提供高达1 PFLOP的AI性能和128GB统一内存。RTX Spark被明确定义为“面向个人智能体的新型PC”,首批笔记本和紧凑台式机计划于秋季上市。尽管尚未正式发售,华硕和微星的首批配额已被渠道客户抢订一空,两家厂商正紧急向英伟达申请更多供应。
这场桌面AI竞赛的本质,是两种技术路线的对决。苹果依托其封闭但高度优化的软硬件一体化生态,提供低功耗、高能效比和原生操作系统环境,特别适合需要长期稳定运行的智能体任务。而英伟达则凭借CUDA、TensorRT等成熟工具链,以及与Windows生态的深度整合,在开发者友好性和模型兼容性上占据优势。双方争夺的核心场景高度重叠:本地大模型推理、智能体行为执行、强化学习轨迹采集、模型轻量微调及自动化评测。
但这场竞赛也暴露出整个AI硬件生态的脆弱性。无论是数据中心还是桌面终端,都对高带宽、大容量内存提出前所未有的需求。AI训练集群消耗海量HBM显存,而本地智能体则依赖大容量LPDDR5或DDR5系统内存。上游DRAM和NAND闪存产能短期内难以跟上双重需求爆发,导致价格持续攀升。2026年,主流DDR5内存模组价格较2024年上涨超过40%,高端服务器级DRAM涨幅更为惊人。这种供需失衡最终传导至终端产品,不仅推高Mac和RTX Spark设备售价,也使得普通消费者升级电脑的成本大幅增加。
更深远的影响在于,AI硬件的部署逻辑正在重构。过去十年,“云优先”是绝对主流,所有复杂计算都被推向远程数据中心。但智能体时代要求AI必须贴近用户的真实数字环境——访问本地文件、操作专属软件、响应个性化工作流。这种“边缘智能”需求催生了新的算力层级:介于云端超算与手机端轻量模型之间的“桌面AI节点”。这些设备既非传统PC,也非服务器,而是专为持续人机协作设计的新型基础设施。
未来,我们或许会看到更多混合部署模式:大型模型在云端训练,智能体策略在桌面设备上执行与优化,关键数据保留在本地以保障隐私与安全。苹果与英伟达的竞争,本质上是在争夺这一中间层的定义权。谁能在性能、能效、生态和成本之间找到最佳平衡点,谁就可能主导下一代AI交互范式。
可以预见,随着智能体技术从实验室走向实际应用,对本地AI硬件的需求将持续增长。Mac mini的走红并非偶然,而是技术演进与市场需求交汇的必然结果。这场始于几万台迷你电脑的采购潮,正在撬动整个半导体、操作系统和AI开发生态的深层变革。而普通用户很快会发现,自己书桌上的那台电脑,或许早已不再是单纯的生产力工具,而是通往通用人工智能的关键入口。