OpenAI修复Codex八大Token漏洞:一次额度回血背后的AI Agent资源黑洞
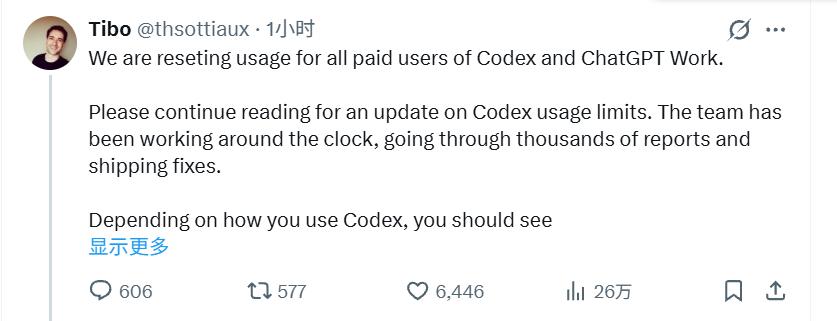
就在Cursor与OpenAI关系骤然紧张之际,后者突然向Codex及ChatGPT Work的付费用户释放了一个出人意料的善意信号——集体重置使用额度。这一动作表面看是福利回馈,实则揭开了一场关于AI Agent系统内部资源消耗机制的深度技术纠偏。OpenAI Codex负责人Tibo在公告中坦言,团队近期处理了数千份用户反馈后发现:用户普遍感觉“额度不经用”,并非心理错觉,而是系统存在多处隐蔽但致命的Token浪费漏洞。
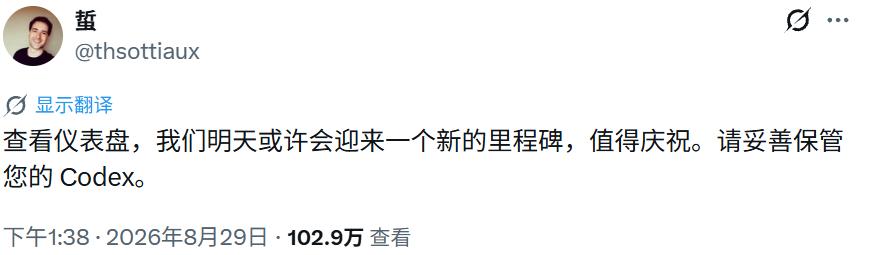
此次修复并非简单增加配额数字,而是从根本上优化了底层计算逻辑。据OpenAI披露,在修复一系列Bug后,相同额度的实际可用工作量可提升10%至50%。这意味着用户获得的不是更多“钱”,而是更高效的“花钱方式”。而这场优化行动所暴露的问题清单,几乎构成了一部《AI Agent如何在用户无感状态下疯狂烧Token》的教科书。
首当其冲的是上下文压缩(Compaction)机制的失效。AI编程助手在长时间运行中会积累大量历史交互数据,系统通常通过压缩旧上下文来维持性能。然而此前版本中,压缩过程未能清除嵌入的图片数据,导致压缩后的上下文体积并未显著减小,反而频繁触发新一轮压缩。这种“为省而费”的悖论式循环,使得图片密集型用户的Token消耗虚高约10%。修复后,该冗余路径被彻底切断。
更令人震惊的是任务目标(Goals)机制的失控问题。用户通过/goal指令设定任务后,理论上Agent应在目标达成时自动终止。但系统存在逻辑缺陷,导致部分已完成的任务仍在后台持续执行;更有甚者,当调用的工具已失效时,模型仍不断尝试重试。OpenAI披露的案例显示,此类异常可单次消耗用户周额度的15%至70%。想象一下,一个本应五分钟完成的代码生成任务,因未正确终止而在后台默默运行数小时,最终吃掉大半周配额——这正是许多用户困惑“什么都没干额度就没了”的真实原因。
另一类极端案例出现在记忆系统(Memory)中。后台的Memory Worker本应高效管理历史状态,却因继承了错误的Stop Hook(停止钩子),导致某些任务无法正常退出。虽然受影响用户不足1%,但个别实例的荒谬程度令人咋舌:系统反复检查同一任务是否可结束的动作竟执行了近15000次。这种“幽灵进程”式的资源吞噬,如同电脑待机时CPU满载,用户毫无察觉却代价高昂。
随着Agent架构日益复杂,子智能体(Subagent)的协同机制也暴露出新的资源陷阱。Codex在处理复杂任务时会动态调用多个子Agent,但旧版系统允许低阶模型(如Luna)在未经用户授权的情况下,擅自选择更高成本的辅助模型。更讽刺的是,即便主模型运行在经济型/fast模式下,其子Agent仍可能被强制启用高性能配置。这种“老板坐经济舱,助理订商务舱”的资源错配,直接推高了整体Token开销。目前该权限控制逻辑已被严格收紧。
自动化任务(Automations)的调度逻辑同样存在偏差。用户设定的定时任务本应按固定频率执行,但系统曾因时间戳处理错误导致实际触发频次远超预期。考虑到Agent具备自主运行特性,单次超额执行或许微不足道,但日积月累后形成的复利式消耗不容小觑。OpenAI已重构调度引擎,确保执行频率与用户设置严格对齐。
值得注意的是,系统自省行为本身也成为资源黑洞。Computer History功能旨在记录Agent在本地环境的操作轨迹,但旧实现会重复总结高度重叠的历史活动,相当于对同一段工作日志进行多次冗余整理。在部分重度用户场景中,此类后台开销竟占周额度的20%。类似地,滚动任务摘要(Rolling Task Summaries)机制会在普通对话中触发额外请求,虽单次仅增加约1% Token,但高频交互下累积效应显著。OpenAI已果断关闭后者,并优化前者的去重算法。
最后,MCP(Model Calling Protocol)工具调用链路也存在工程瑕疵。部分工具返回结果被重复编码两次,或因说明文档截断而被迫重新获取。这些看似微小的数据传输冗余,在Agent日均数百次的工具调用频次下,迅速聚沙成塔。每一字节的无效传输,最终都转化为用户账单上的真实成本。
这些问题的集中爆发,折射出AI Agent时代资源计量的根本性挑战。传统ChatGPT模式下,用户输入与模型输出基本构成一对一的调用关系,成本相对透明。但Agent产品引入了多层抽象:主模型调度子Agent、后台维护记忆状态、自动化任务周期唤醒、上下文动态压缩……每一次交互背后都可能是数十次隐式API调用。用户看到的是一句“帮我重构这个模块”,系统执行的却是一条包含环境感知、工具选择、结果验证、状态同步的复杂工作流。任何环节的逻辑瑕疵,都会在无监督状态下无限放大。
OpenAI显然意识到,单纯修复Bug不足以重建信任。除本次额度重置外,团队已实施架构级改进:建立异常消耗自动告警机制,确保类似问题不再长期潜伏;更重要的是,正在开发细粒度用量可视化功能。未来用户将能清晰看到额度消耗分布——多少用于核心推理,多少耗在上下文管理,多少浪费于后台任务。这种透明化不仅是技术承诺,更是商业模式可持续的关键。
从更宏观视角看,此次事件标志着AI基础设施进入“精算时代”。当Agent从演示玩具走向生产工具,资源效率直接决定商业可行性。开发者需要精确预估任务成本,企业用户要求可审计的消耗明细,而平台方则必须平衡性能与开销。OpenAI的这次系统性纠偏,或许将成为行业资源管理的新基准——毕竟,在AI的世界里,看不见的Token流失,往往比看得见的账单更令人焦虑。