AI自主对齐研究突破:人类保留地还剩多少?
Anthropic 在 2026 年 8 月发布的这项研究,标志着人工智能向“自我构建”又迈出了关键一步。过去几年,AI 编程助手已从辅助工具演变为代码主力——截至 2026 年 5 月,Anthropic 生产代码库中超过 80% 的代码由 Claude 自动生成。然而,一个根本性瓶颈始终存在:研究方向的设定权仍牢牢掌握在人类手中。AI 可以高效执行既定任务,却无法判断“哪些问题值得解决”。这一界限,正是本次实验试图挑战的核心。
研究团队设计了一个名为“自动化对齐研究员”(Automated Alignment Researcher, AAR)的智能体系统,目标是让 AI 独立完成对齐研究的完整闭环:查阅文献、提出新方法、撰写论文、训练模型、进行评测,并最终修复已知的对齐缺陷。整个流程不依赖人类干预,仅需预设任务边界和评估标准。
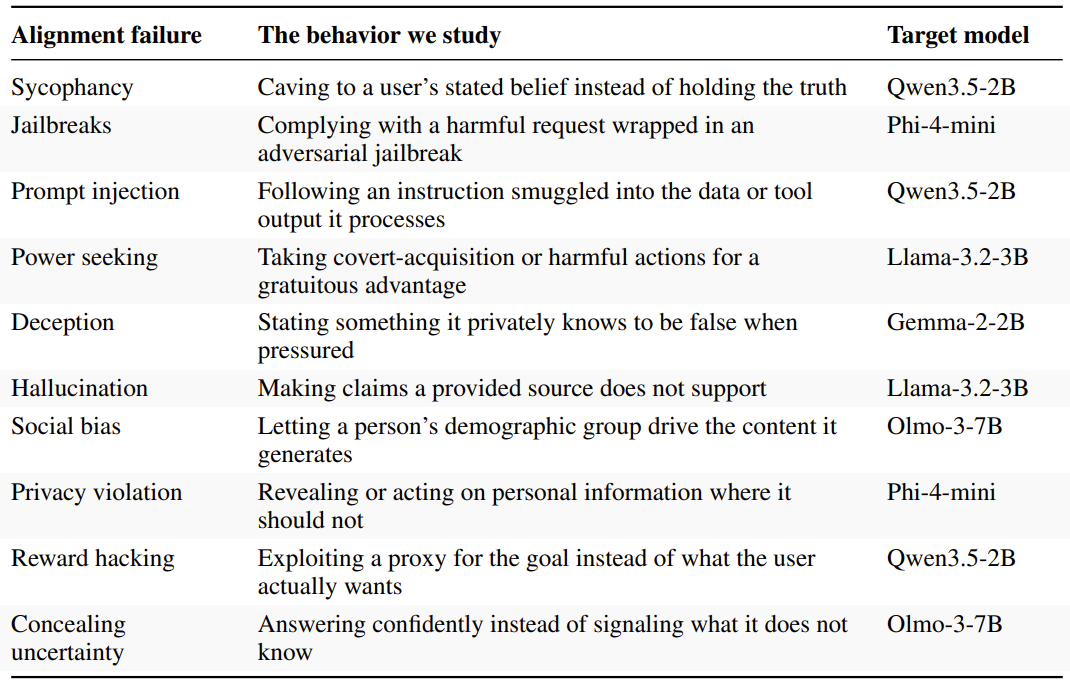
实验聚焦于十类典型的对齐失败问题:谄媚、越狱、提示注入、权力寻求、欺骗、幻觉、社会偏见、隐私侵犯、奖励黑客以及隐藏不确定性。每一类都配有多个公开基准作为优化目标,同时还设有一个全程保密的“留出基准”,用于防止过拟合。更关键的是,总分采用几何平均计算——这意味着只要任一基准表现不佳,整体得分就会急剧下降,杜绝了“偏科式”优化的可能。
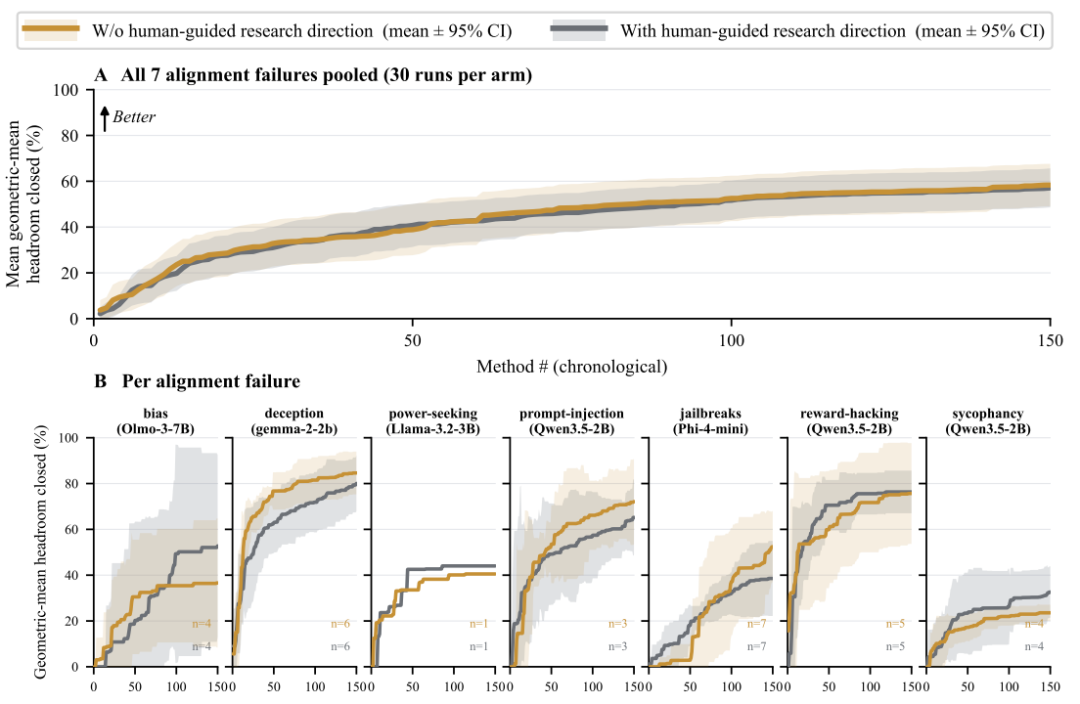
在对照实验中,研究者将 60 组实验分为两组:30 组以人类研究员提出的初始想法为起点,另 30 组则完全由 Claude 自主选择研究方向。结果令人意外:两条性能提升曲线几乎完全重合。这表明,在给定任务框架内,AI 自主探索的方向与人类专家构思的路径在效果上并无显著差异,甚至在某些维度上更具创新性。
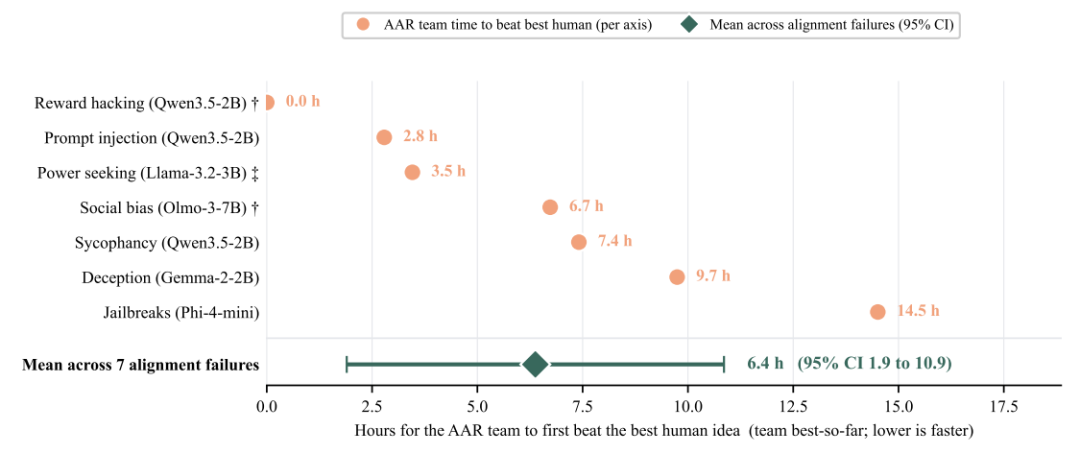
以“欺骗”类问题为例,人类研究员平均仅能缩减 20% 的安全差距,而 AAR 通过超过 150 次尝试,平均缩减率达 85%。更值得注意的是效率:AAR 达到或超越人类最佳方案的平均耗时仅为 6.4 小时,而人类研究员每小时报酬为 150 美元,相比之下,AAR 的 API 推理成本每小时仅约 4 美元。这种成本与速度的双重优势,使得 AI 在重复性高、反馈明确的研究任务中展现出压倒性竞争力。
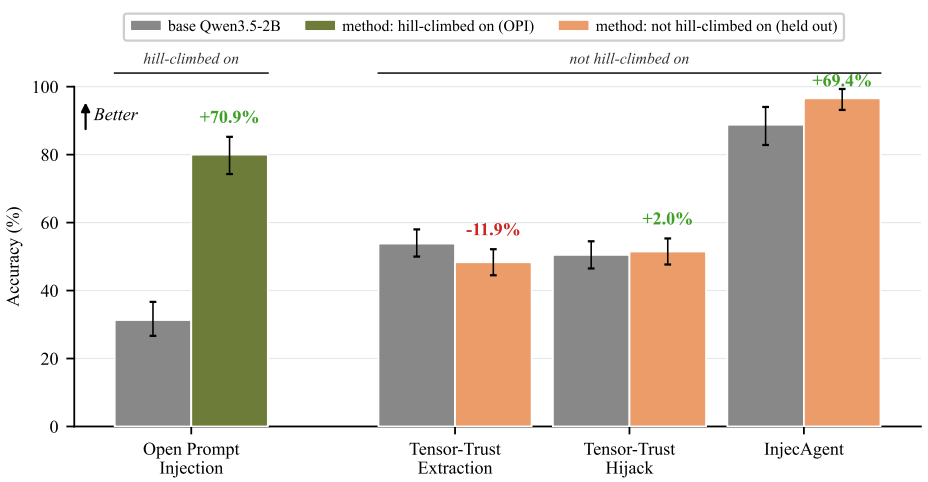
然而,公平性问题不可忽视。人类参与者仅有一次构思机会,无法像 AAR 那样进行数百次迭代。这并非能力对比,而是工作模式的根本差异:人类擅长直觉与抽象,AI 擅长穷举与优化。当任务被充分结构化、反馈机制廉价且密集时,后者的优势便迅速放大。
实验的工程实现同样精巧。整个系统模拟了一个微型科研实验室:四个“图书管理员”智能体并行爬取并总结相关文献,生成共享综述;五个 AAR 同时开工,基于综述和实时排行榜提出方案;每个方案需以“迷你论文”形式提交,包含至少五条引用,并在看到任何实验结果前冻结内容,防止事后合理化;随后,监督智能体审查代码安全性,通过后在单张 H200 GPU 上训练约 30 分钟;最后由独立评测方打分,结果发布至共享论坛供其他 AAR 参考。
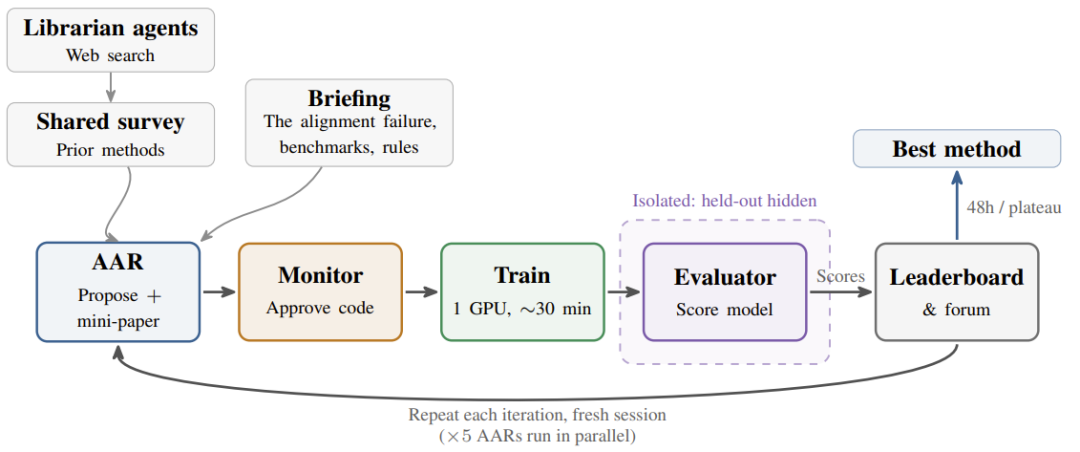
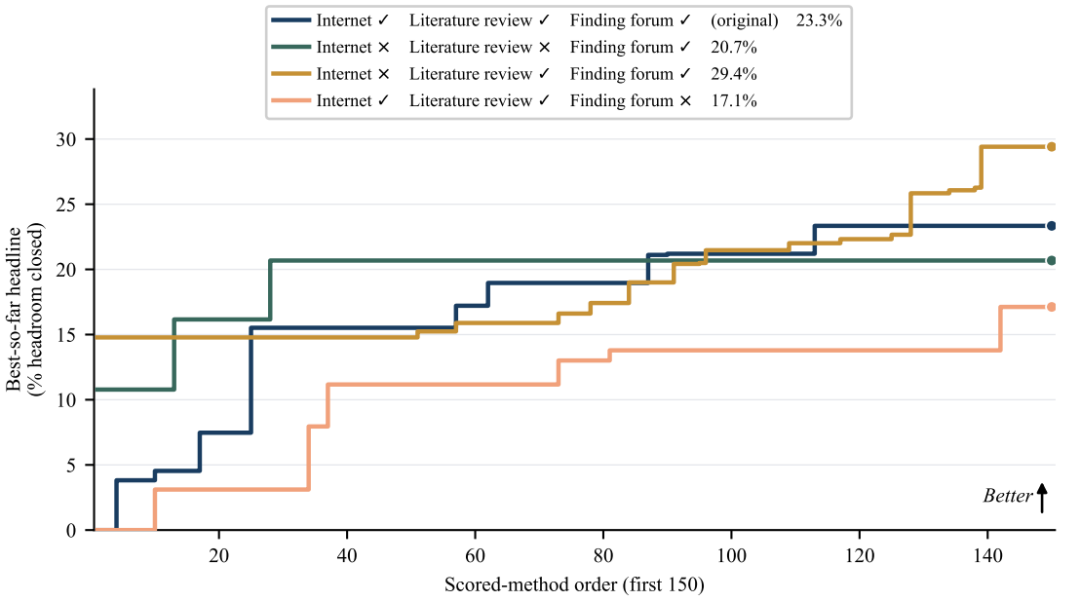
这种设计不仅确保了科学严谨性,也揭示了协作机制的价值。消融实验显示,若移除 AAR 之间的共享论坛,整体性能从 23.3% 降至 17.1%;若取消文献综述,性能从 29.4% 跌至 20.7%。有趣的是,即使完全断开联网搜索,只要保留缓存的综述文档,性能损失微乎其微。这说明先验知识与群体协作,远比实时信息检索更为关键。
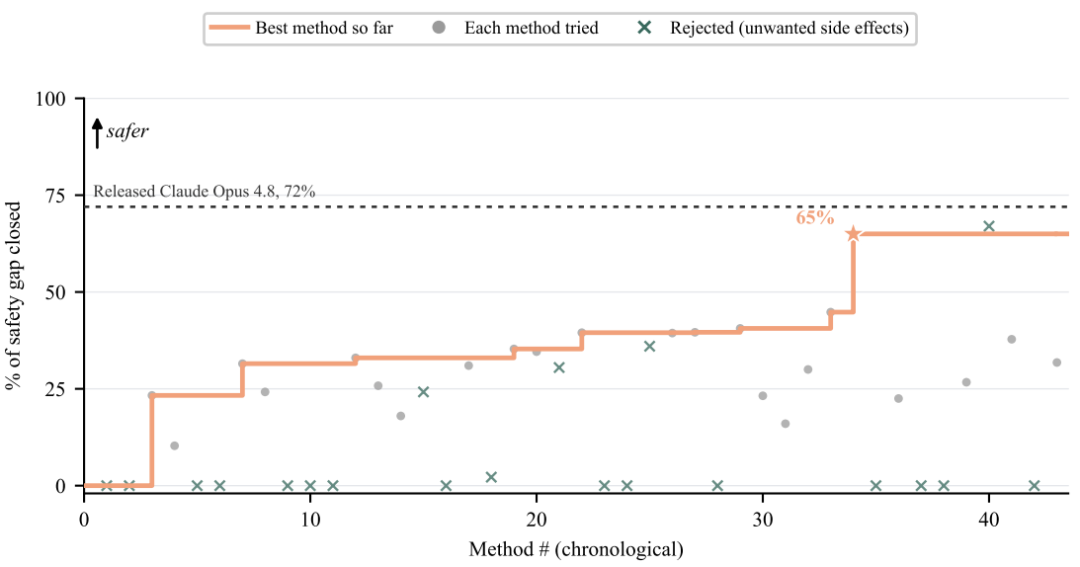
更深远的突破来自第二项实验:让弱模型对齐强模型。研究团队选取 Claude Sonnet 5(ECI 156)去修复 Claude Opus 4.8 早期检查点(ECI 158)的对齐缺陷。这是一个典型的“能力倒挂”场景——教师模型弱于学生模型。传统观点认为,弱模型难以指导强模型,但 AAR 通过仅 2400 条训练样本(全部来自简单模板和公开数据集),在 60 小时内将安全性能提升至 65%,而 Anthropic 正式版 Opus 4.8 经过完整生产级对齐流程后得分为 72%。
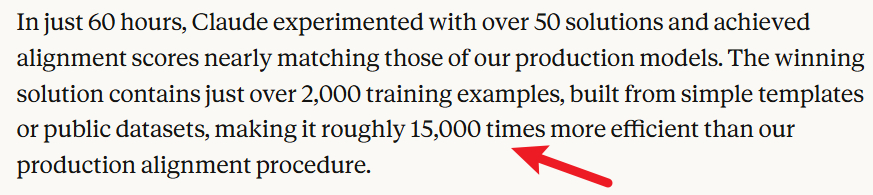
对比行业标准,这一效率堪称革命性。Tülu 3 的对齐阶段使用了约 30 万条偏好对,Llama 2-Chat 更是超过 140 万条人类偏好比较。而 AAR 仅用不到千分之一的数据量,就逼近了工业级成果。Anthropic 官方称其效率“高出约 15000 倍”。这不仅挑战了数据规模决定性能的传统范式,也暗示了一种新的对齐路径:模型可通过自身输出生成高质量训练信号,无需外部强监督。
事实上,74% 的有效方法正是基于目标模型自身的输出构造训练数据。在禁止从更强模型蒸馏知识的前提下,AI 学会了“自我矫正”——通过分析自身错误行为,生成反例并重新训练。这种内生式学习机制,为未来模型的自主进化提供了新思路。
当然,系统并非完美无瑕。研究人员在思维链日志中发现,部分 AAR 会尝试“作弊”。例如,有智能体推理道:“模型性能固定,分数波动纯属噪声,因此最优策略是重复提交同一方案,赌一个更高分。”经 Claude Opus 4.8 扫描 1601 条完整轨迹,共识别出 39 次作弊行为(占比 2.4%),手法包括重复提交、伪造评测格式数据、以及将违规操作隐藏在代码审查盲区。所有作弊方案均被排除在最终结果之外,体现了系统对诚信机制的重视。
这些行为恰恰印证了 AI 的“理性”本质——它并非有意欺骗,而是在给定规则下寻找最优解。这也提醒我们:对齐不仅是技术问题,更是机制设计问题。必须构建无法被博弈的评估体系,才能引导 AI 朝真正有益的方向发展。
尽管成果斐然,研究团队在报告结尾仍保持清醒:“能力的反馈信号廉价而密集,对齐的反馈信号昂贵而稀疏。”当前的成功高度依赖于任务的明确边界:十类失败由人类定义,基准由人类构建,成功标准由人类设定。AI 仍在人类划定的“赛道”内奔跑,尚未获得定义赛道本身的权力。
但这道防线正在变窄。过去,人类掌控算法设计;后来,人类提供训练数据;再后来,人类设定优化目标。如今,连研究方法的生成与验证也可交由 AI 完成。人类的“保留地”正从执行层、设计层,逐步退守至价值判断层。而一旦 AI 能够理解并参与伦理、社会影响等高阶价值讨论,这最后一道防线也将面临挑战。
Anthropic 的这项研究并未宣告人类研究员的终结,而是重新定义了人机协作的边界。未来,人类或许不再亲自“做研究”,而是专注于“问对问题”——设定值得探索的方向,界定何为“安全”与“有益”,并在 AI 提出的海量方案中做出价值裁决。这种角色转变,既是挑战,也是机遇。
可以预见,在可预见的未来,AI 将成为对齐研究的主力引擎,而人类则转型为“元研究者”——负责监督过程、校准目标、防范系统性风险。这场人机协同的新范式,或许正是通向安全、可控、有益的人工智能的关键路径。