腾讯混元Hy4 preview开源:770B参数MoE架构如何重塑生产力场景?
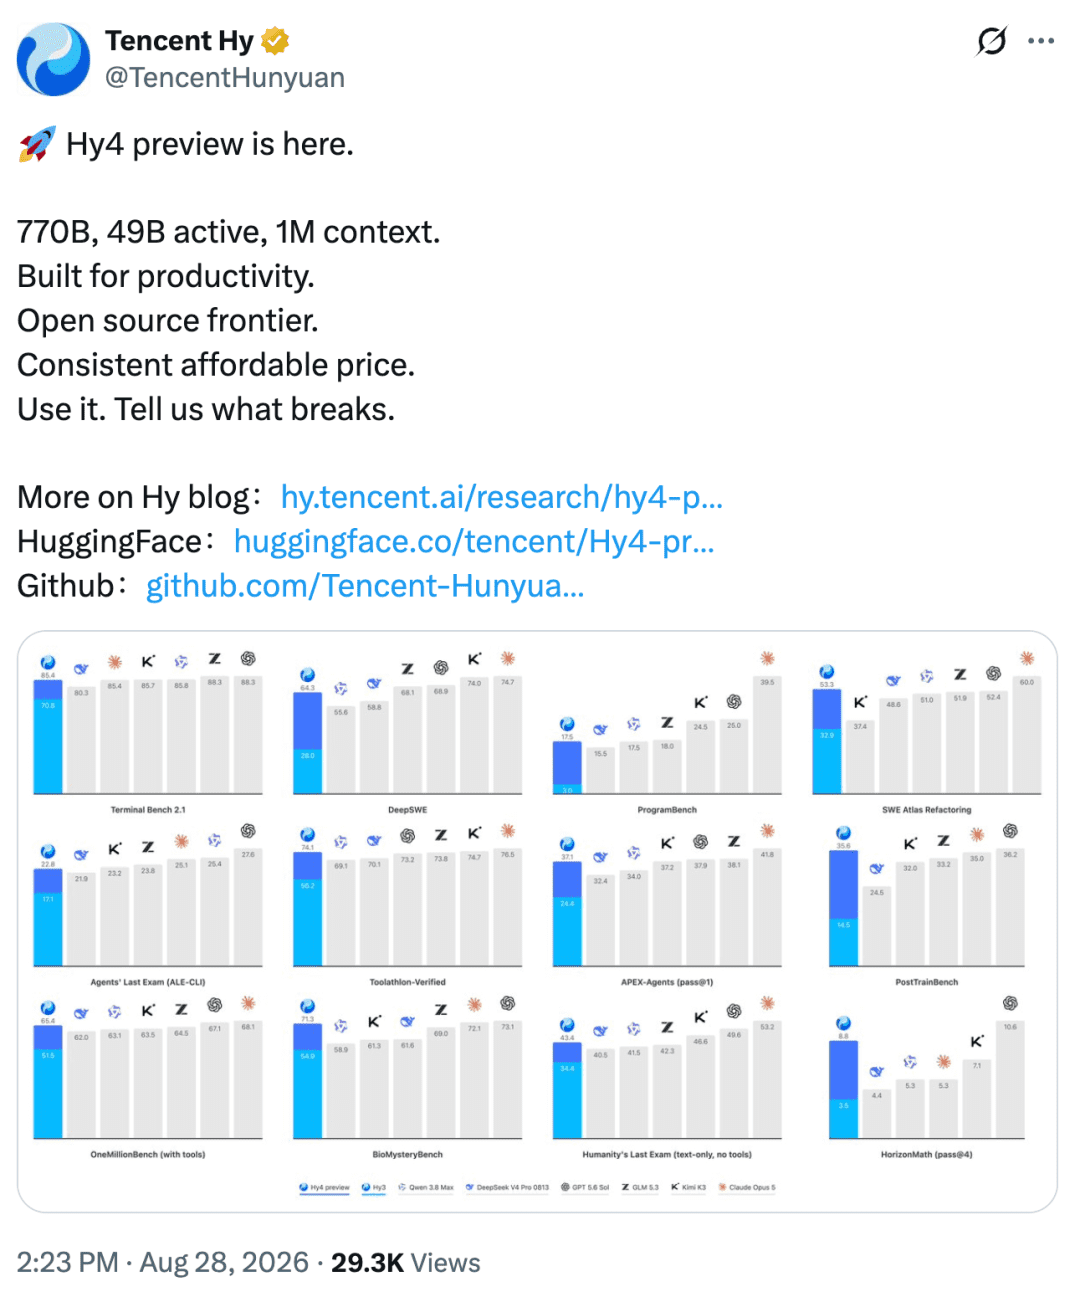
近日,腾讯混元正式发布并开源其新一代大语言模型 Hy4 preview,标志着国产大模型在技术规模与应用深度上迈入新阶段。该模型以 7700亿总参数、单次推理激活490亿参数、支持100万token上下文 的硬核配置,迅速跻身全球开源大模型第一梯队。更值得关注的是,Hy4 preview并非单纯追求参数堆砌,而是围绕 代码、办公、游戏、科研 四大高价值生产力场景进行定向优化,展现出强烈的工程落地导向。
架构革新:MoE设计平衡容量与效率
Hy4 preview的核心在于其精心设计的 混合专家(Mixture of Experts, MoE)架构。模型主干共78层,其中除首层为标准稠密前馈网络外,其余77层均采用MoE结构。每一MoE层包含 256个路由专家 和 1个共享专家,每个输入token在推理时动态选择 8个路由专家 + 共享专家 进行计算。这种设计巧妙地实现了“大容量”与“低计算开销”的统一:总参数高达770B,但单次前向传播仅需激活约49B参数,极大缓解了显存压力与推理延迟。
为进一步提升长上下文处理效率,Hy4 preview引入多项底层创新:
- Gated DSA注意力机制:在传统稀疏注意力基础上增加门控机制,动态调节注意力权重,提升对关键信息的聚焦能力;
- IndexCache跨层索引复用:在多层注意力计算中复用稀疏索引结构,减少重复计算,显著降低长序列处理的内存占用;
- iHC残差通路扩展:增强深层网络中的信息流动,缓解梯度消失问题,确保78层深度下的训练稳定性;
- 原生MTP推测解码:内置多步推测解码模块,加速自回归生成过程,提升端到端吞吐量。
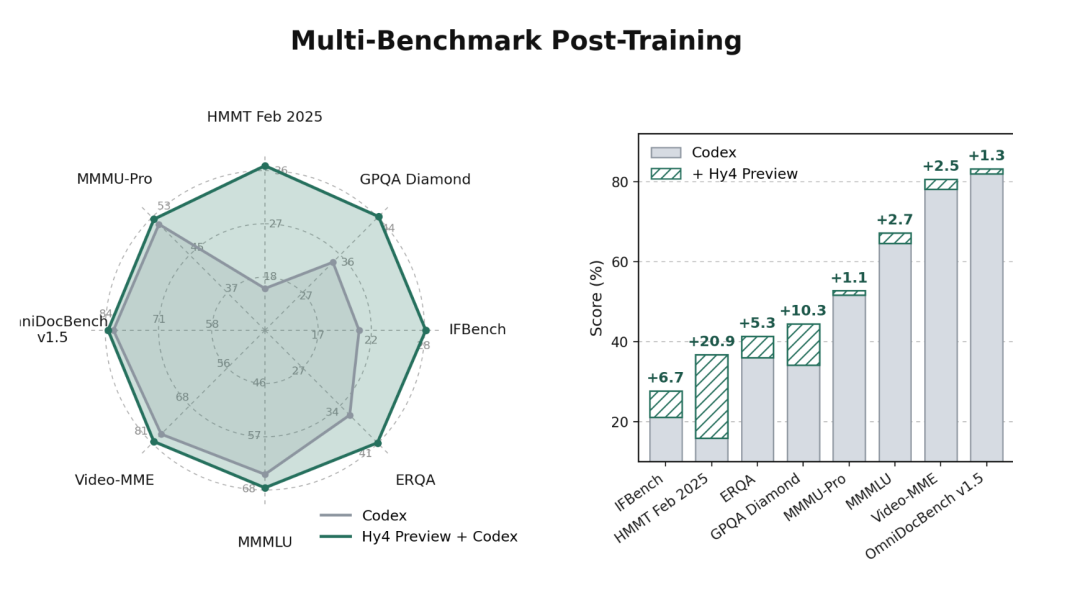
这些技术协同作用,使得Hy4 preview在保持超大模型容量的同时,实现了 端到端吞吐较基线提升31.8% 的工程突破,为高并发、低延迟的生产环境部署奠定基础。
场景深耕:从代码到科研的全链路赋能
腾讯明确将Hy4 preview定位为“为生产力而生”的模型,其训练数据与评估体系深度融入真实业务场景。值得注意的是,此次训练首次引入 软件工程、游戏、金融、安全等领域的内部专家 参与高质量数据共建,形成“专家定义标准—模型学习—产品验证—反馈回流”的闭环迭代机制。
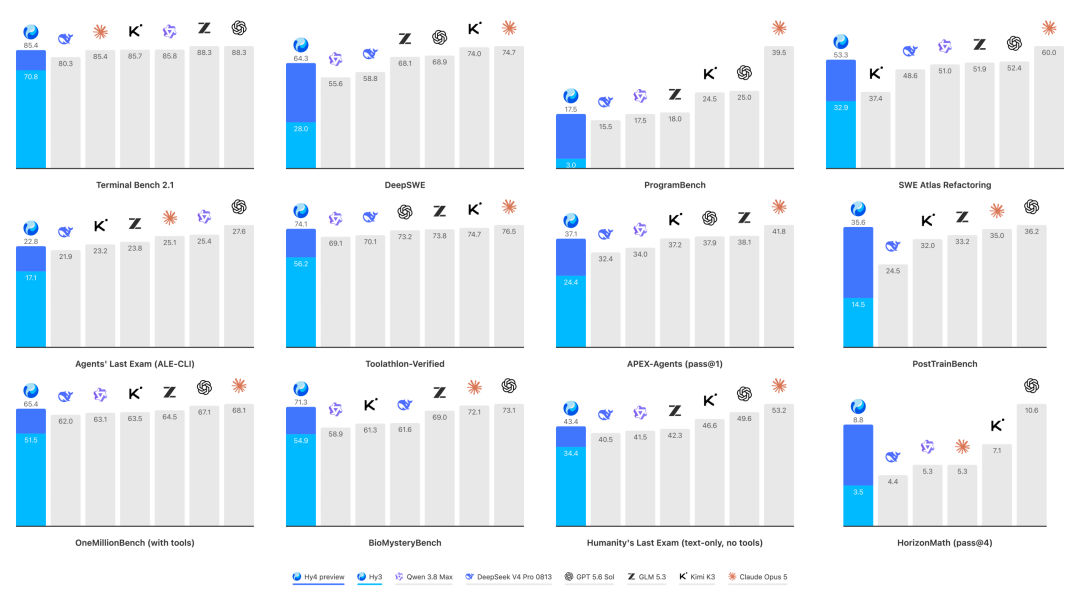
在软件工程领域,Hy4 preview不再局限于单文件代码补全,而是具备处理长程开发任务的能力。例如,给定一个模糊需求(如“实现一个支持实时协作的Markdown编辑器”),模型可自动规划技术栈、生成前后端代码、编写单元测试,并优化UI交互细节。其在Terminal-Bench 2.1基准上的得分从Hy3的70.8跃升至85.4,DeepSWE(深度软件工程评估)更是从28.0飙升至64.3,显示出对复杂工程逻辑的理解力质变。
复杂办公场景的升级同样显著。传统办公AI往往只能处理单一文档,而Hy4 preview能跨多个文件(如合同、财报、会议纪要)提取、比对、整合信息,执行财务建模、市场分析等任务,并自动生成结构化报告、PPT或Excel表格。这种“多源信息融合+智能产出”的能力,直击企业知识工作者的核心痛点。
游戏开发方面,模型展现出从概念到原型的快速转化能力。用户只需描述玩法(如“做一个类似《星露谷物语》的农场模拟游戏,加入天气系统和NPC好感度”),Hy4 preview即可在Unity或Unreal引擎环境中生成可运行的基础项目,包括场景搭建、角色控制、UI界面等,并支持多轮交互式迭代完善。
在科学研究领域,Hy4 preview覆盖AI算法设计、分子动力学模拟、凝聚态物理建模乃至形式化数学证明等高难度任务。其在BioMysteryBench(生物谜题基准)得分从54.9提升至71.3,GPQA Diamond(高难度科学问答)也小幅提升至92.3,表明其在专业领域知识推理上的扎实进步。
开源生态与商业化路径并行
腾讯此次采取“开源+云服务+产品集成”三位一体的策略,加速Hy4 preview的生态渗透。模型权重及FP8量化版本已通过 Apache 2.0许可证 在Hugging Face和GitHub开放,允许商业使用与二次开发。开发者可直接下载部署,或通过腾讯云TokenHub、第三方平台OpenRouter调用API。
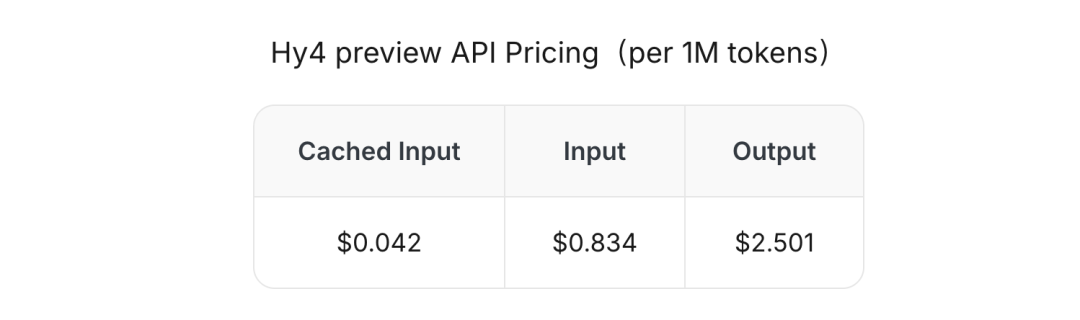
API定价策略清晰透明:输入每百万tokens 6元,输出每百万tokens 18元,缓存命中输入仅需0.3元/百万tokens,对高频读取场景极为友好。同时,腾讯旗下WorkBuddy(智能办公助手)和CodeBuddy(编程助手)开启为期两周的限时免费体验,降低用户尝试门槛。
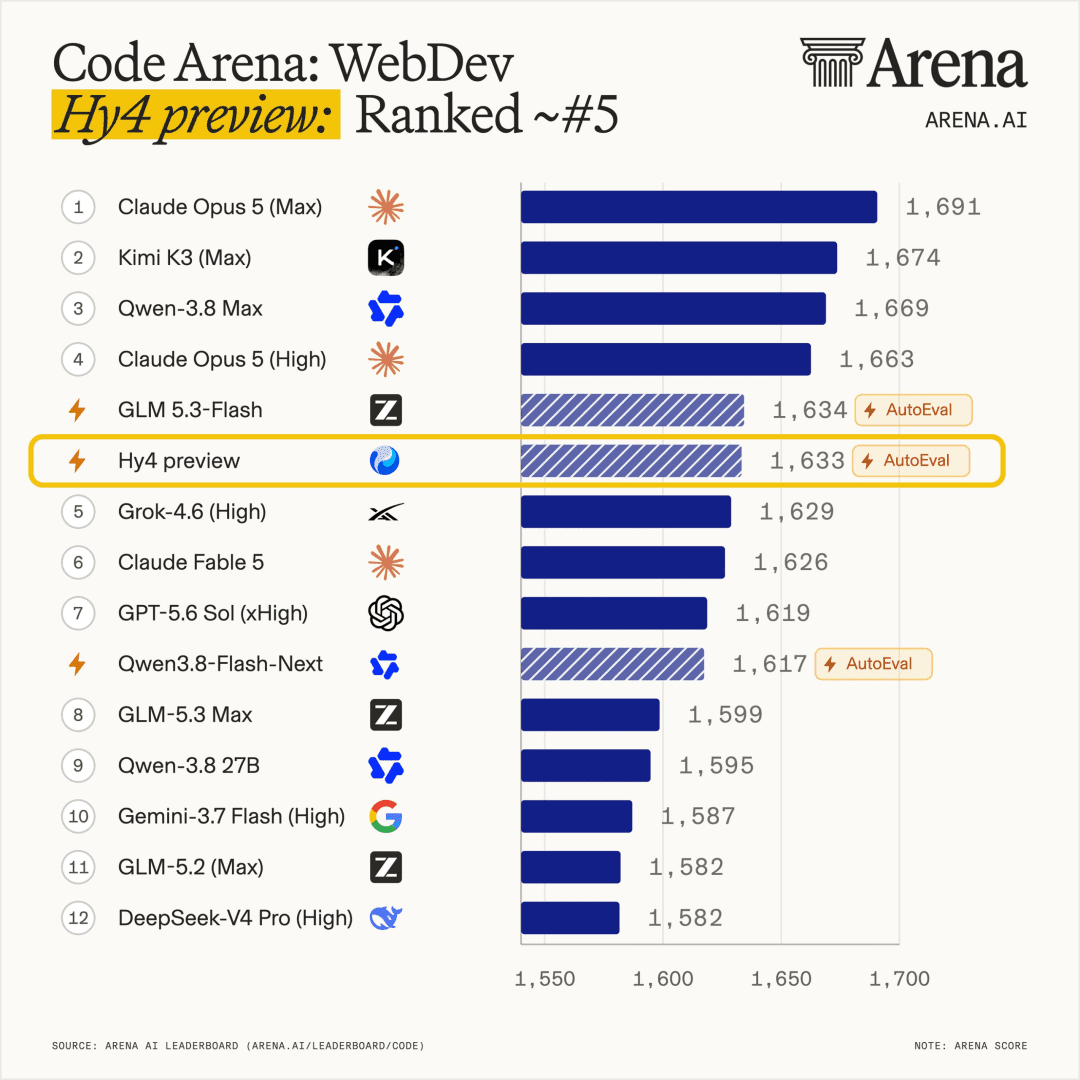
在权威评测平台Arena.ai的Code Arena: WebDev榜单中,Hy4 preview以1633分暂列第5(AutoEval模式),在开源模型中稳居前三,相较Hy3的第31名实现跨越式进步。这一成绩不仅验证了其技术实力,也为开发者提供了可靠的选型参考。
实测表现:专家盲测评分超越竞品
为客观评估Hy4 preview的实际工作效能,腾讯组织了163名内部领域专家,对203个真实工程任务进行双盲测试。评分标准涵盖任务完成度、代码质量、逻辑严谨性、用户体验等多个维度,满分为4分。结果显示,Hy4 preview平均得分为2.99分,略高于智谱GLM-5.3的2.92分和月之暗面Kimi K3的2.94分。尽管差距看似微小,但在高分段竞争中,0.05分的领先往往意味着对边缘案例和复杂约束的更好处理能力。
这一结果印证了腾讯“场景驱动、反馈闭环”研发范式的有效性——模型不再是在静态数据集上刷榜的“考试机器”,而是能在真实工作流中持续创造价值的“生产力伙伴”。
展望:大模型进入“精耕细作”时代
Hy4 preview的发布,折射出大模型发展范式的转变:从早期的“参数军备竞赛”转向“架构创新+场景深耕+工程优化”的综合竞争。770B参数固然亮眼,但真正决定模型价值的,是它能否在具体任务中替代或增强人类劳动。
腾讯通过将内部专家知识注入训练流程,打通产品与模型的反馈链路,使Hy4 preview在垂直领域能力上实现“know-how”的沉淀。这种“产业Know-How × 大模型”的融合模式,或将成为下一阶段国产大模型突围的关键路径。
随着Hy4 preview的开源,开发者社区有望在其基础上孵化出更多垂直应用,进一步丰富中文大模型生态。而对于企业用户而言,一个既能本地部署、又可通过API灵活调用,且在核心生产力场景经过实测验证的开源模型,无疑提供了极具吸引力的技术选项。